

英伟达新研究:上下文长度虚标严重,32K性能合格的都不多
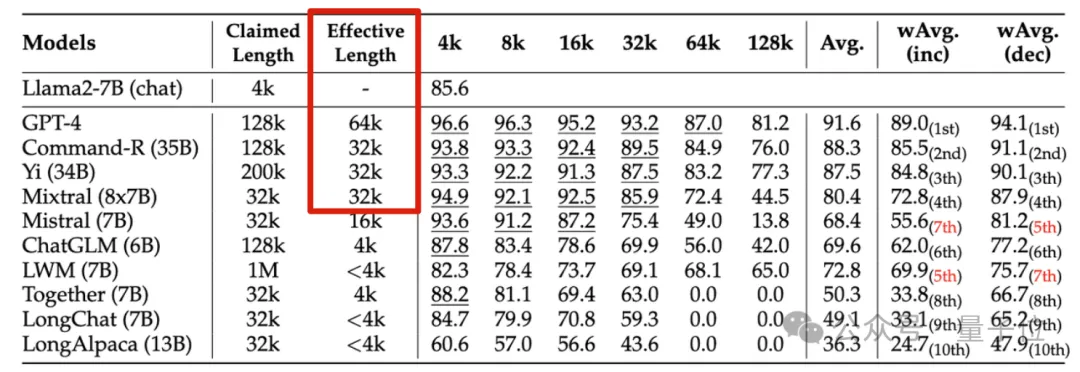
无情戳穿“长上下文”大模型的虚标现象——英伟达新研究发现,包括GPT-4在内的10个大模型,生成达到128k甚至1M上下文长度的都有。但一番考验下来,在新指标“有效上下文”上缩水严重,能达到32K的都不多。新基准名为RULER,包含检索、多跳追踪、聚合、问答四大类共13项任务。RULER定义了“有效上下文长度”,即模型能保持与Llama-7B基线在4K长度下同等性能的最大长度。这项研究被学者评价为“非常有洞察力”。不少网友看到这项新研究后,也非常想看到上下文长度王者玩家Claude和Gemini的挑战结果
无情戳穿“长上下文”大模型的虚标现象——
英伟达新研究发现,包括GPT-4在内的10个大模型,生成达到128k甚至1M上下文长度的都有。
但一番考验下来,在新指标“有效上下文”上缩水严重,能达到32K的都不多。
新基准名为RULER,包含检索、多跳追踪、聚合、问答四大类共13项任务。RULER定义了“有效上下文长度”,即模型能保持与Llama-7B基线在4K长度下同等性能的最大长度。
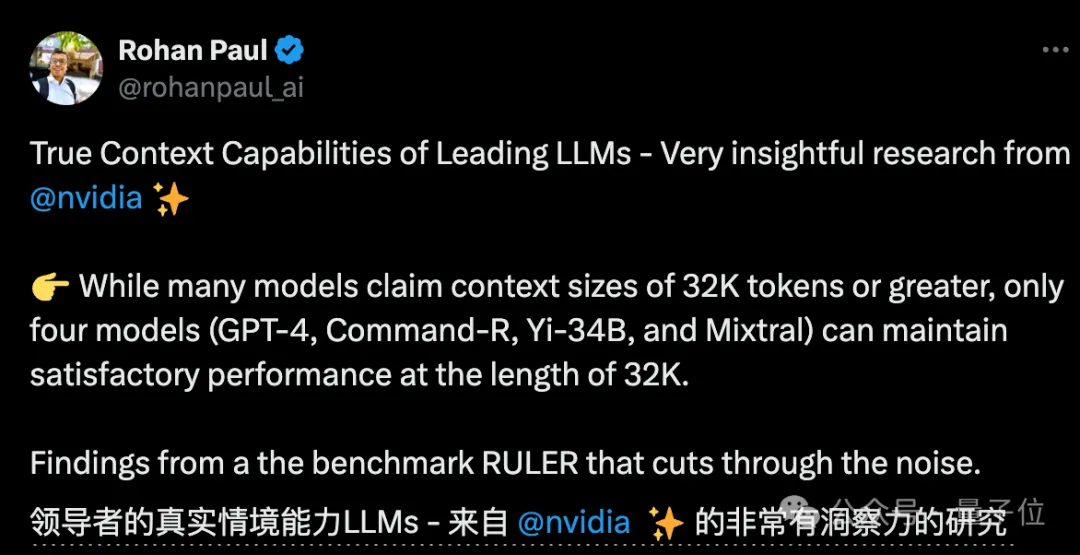
这项研究被学者评价为“非常有洞察力”。
不少网友看到这项新研究后,也非常想看到上下文长度王者玩家Claude和Gemini的挑战结果。(论文中并未覆盖)
一起来看英伟达是如何定义“有效上下文”指标的。
测试任务更多、更难
要评测大模型的长文本理解能力,得先选个好标准,现圈内流行的ZeroSCROLLS、L-Eval、LongBench、InfiniteBench等,要么仅评估了模型检索能力,要么受限于先验知识的干扰。
所以英伟达剔除的RULER方法,一句话概括就是“确保评估侧重于模型处理和理解长上下文的能力,而不是从训练数据中回忆信息的能力”。
RULER的评测数据减少了对“参数化知识”的依赖,也就是大模型在训练过程中已经编码到自身参数里的知识。
具体来说,RULER基准扩展了流行的“大海捞针”测试,新增四大类任务。
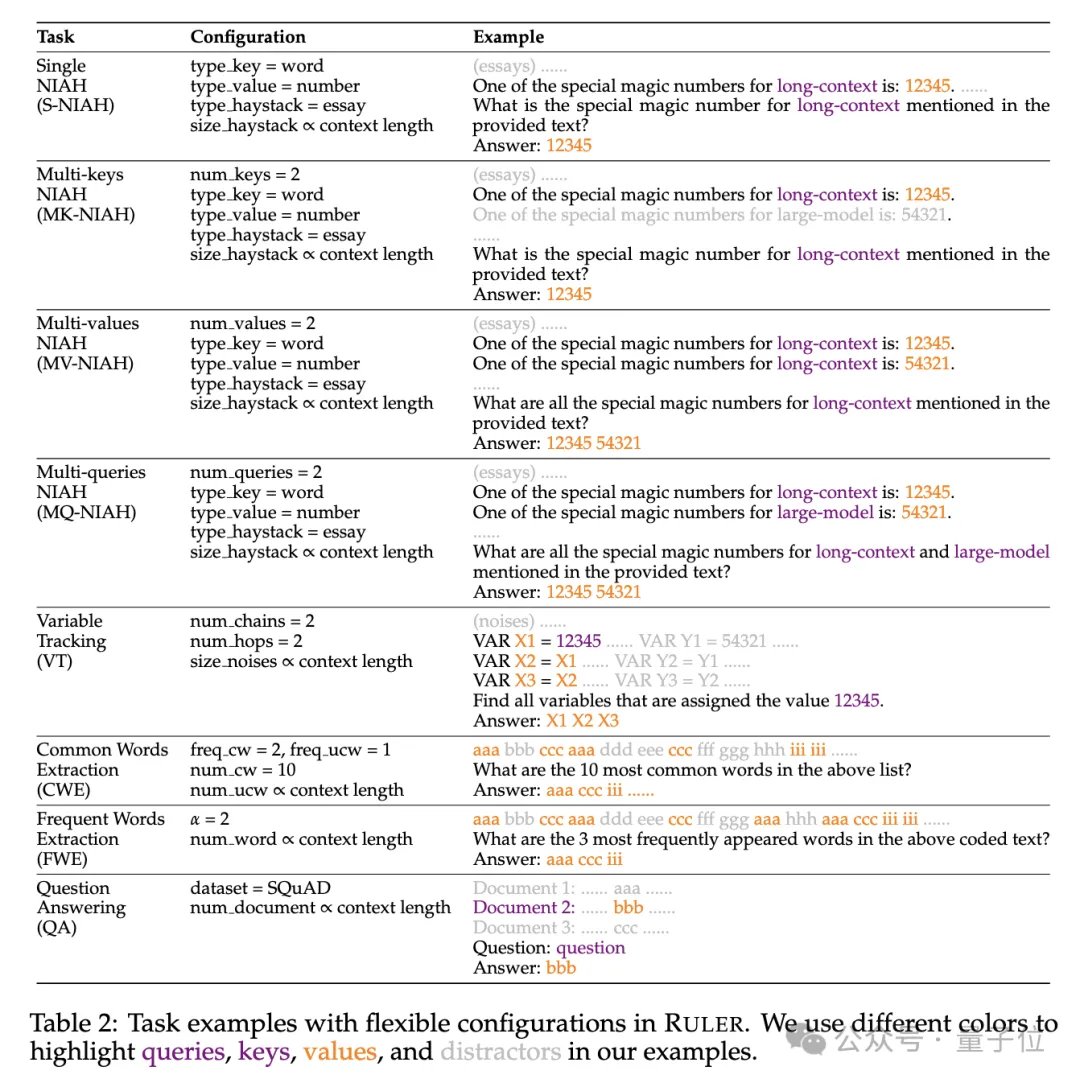
检索方面,从大海捞针标准的单针检索任务出发,又加入了如下新类型:
- 多针检索(Multi-keys NIAH, MK-NIAH):上下文中插入多个干扰针,模型需检索指定的那一个
- 多值检索(Multi-values NIAH, MV-NIAH):一个键(key)对应多个值(values),模型需要检索出与特定键关联的所有值。
- 多查询检索(Multi-queries NIAH, MQ-NIAH):模型需根据多个查询在文本中检索出相应的多个针。
除了升级版检索,RULER还增加了多跳追踪(Multi-hop Tracing)挑战。
具体来说,研究人员提出了变量追踪(VT),模拟了指代消解(coreference resolution)的最小任务,要求模型追踪文本中变量的赋值链,即使这些赋值在文本中是非连续的。
挑战第三关是聚合(Aggregation),包括:
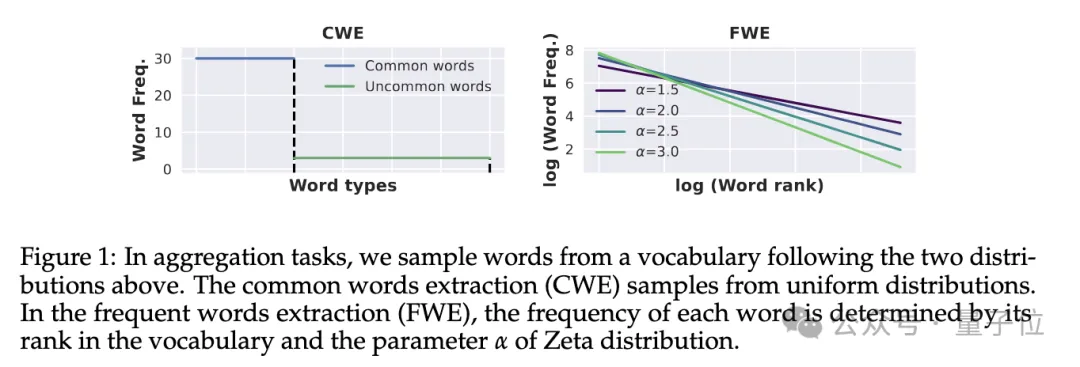
- 常见词汇提取(Common Words Extraction, CWE):模型需要从文本中提取出现次数最多的常见词汇。
- 频繁词汇提取(Frequent Words Extraction, FWE):与CWE类似,但是词汇的出现频率是根据其在词汇表中的排名和Zeta分布参数α来确定的。
挑战第四关是问答任务(QA),在现有阅读理解数据集(如SQuAD)的基础上,插入大量干扰段落,考查长序列QA能力。
各模型上下文实际有多长?
实验阶段,如开头所述,研究人员评测了10个声称支持长上下文的语言模型,包括GPT-4,以及9个开源模型开源模型Command-R、Yi-34B、Mixtral(8x7B)、Mixtral(7B)、ChatGLM、LWM、Together、LongChat、LongAlpaca。
这些模型参数规模范围从6B到采用MoE架构的8x7B不等,最大上下文长度从32K到1M不等。
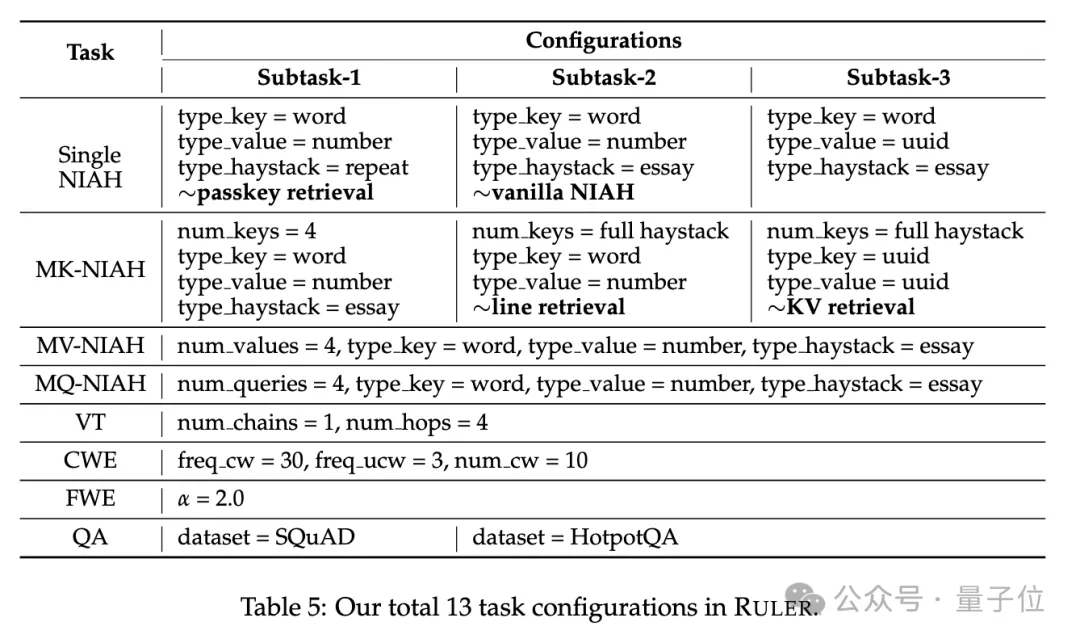
在RULER基准测试中,对每个模型评测了13个不同的任务,覆盖4个任务类别,难度简单到复杂的都有。对每项任务,生成500个测试样例,输入长度从4K-128K共6个等级(4K、8K、16K、32K、64K、128K)。
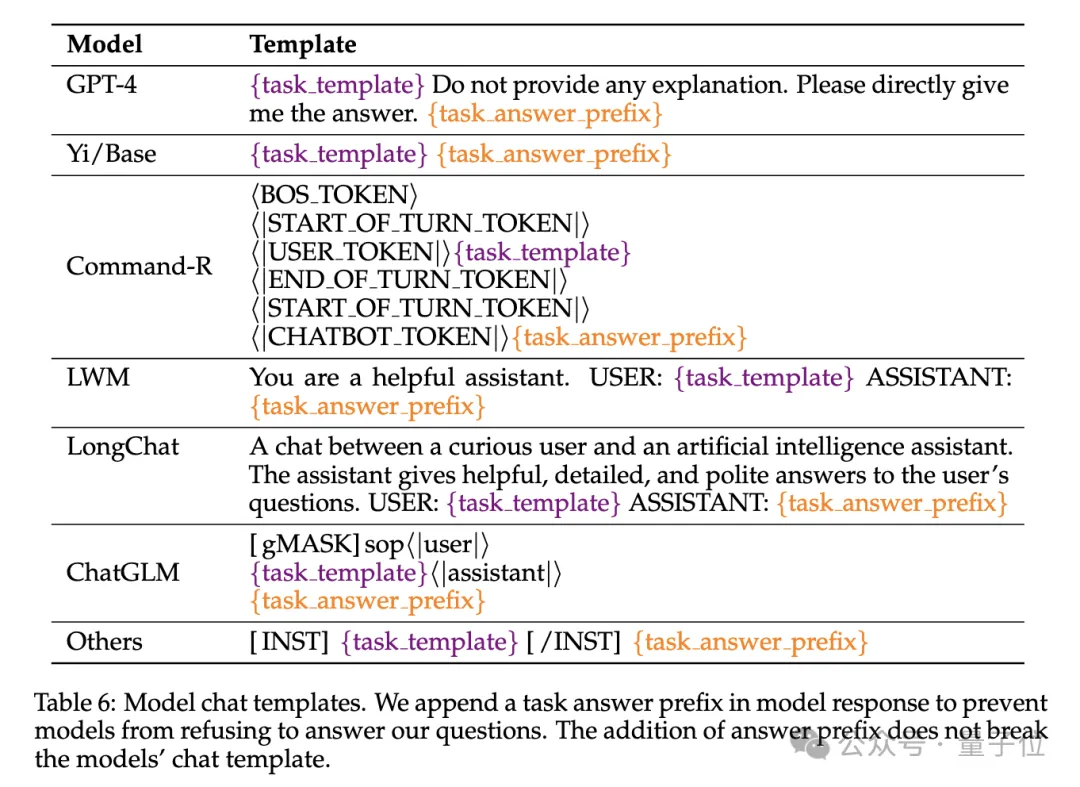
为了防止模型拒绝回答问题,输入被附加了answer prefix,并基于recall-based准确性来检查目标输出的存在。
研究人员还定义了“有效上下文长度”指标,即模型在该长度下能保持与基线Llama-7B在4K长度时的同等性能水平。
为了更细致的模型比较,使用了加权平均分数(Weighted Average, wAvg)作为综合指标,对不同长度下的性能进行加权平均。采用了两种加权方案:
- wAvg(inc):权重随长度线性增加,模拟以长序列为主的应用场景
- wAvg(dec):权重随长度线性减小,模拟以短序列为主的场景
来看结果。
普通大海捞针和密码检索测试看不出差距,几乎所有模型在其声称的上下文长度范围内均取得满分。
而使用RULER,尽管很多模型声称能够处理32K token或更长的上下文,但除了Mixtral外,没有模型在其声称的长度上保持超过Llama2-7B基线的性能。
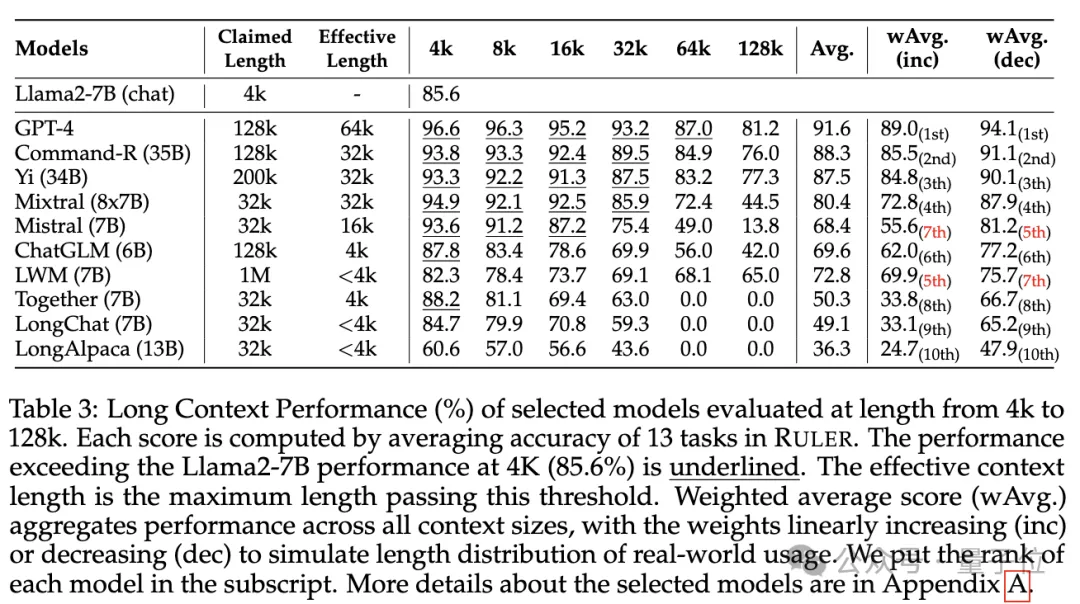
其他结果如下,总的来说,GPT-4在4K长度下表现最佳,并且在上下文扩展到128K时显示出最小的性能下降(15.4%)。
开源模型中排名前三的是Command-R、Yi-34B和Mixtral,它们都使用了较大的基频RoPE,并且比其它模型具有更多的参数。
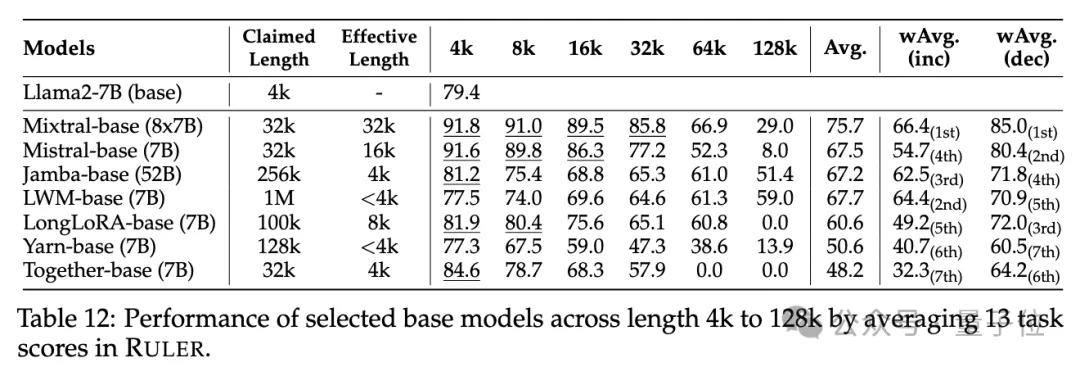
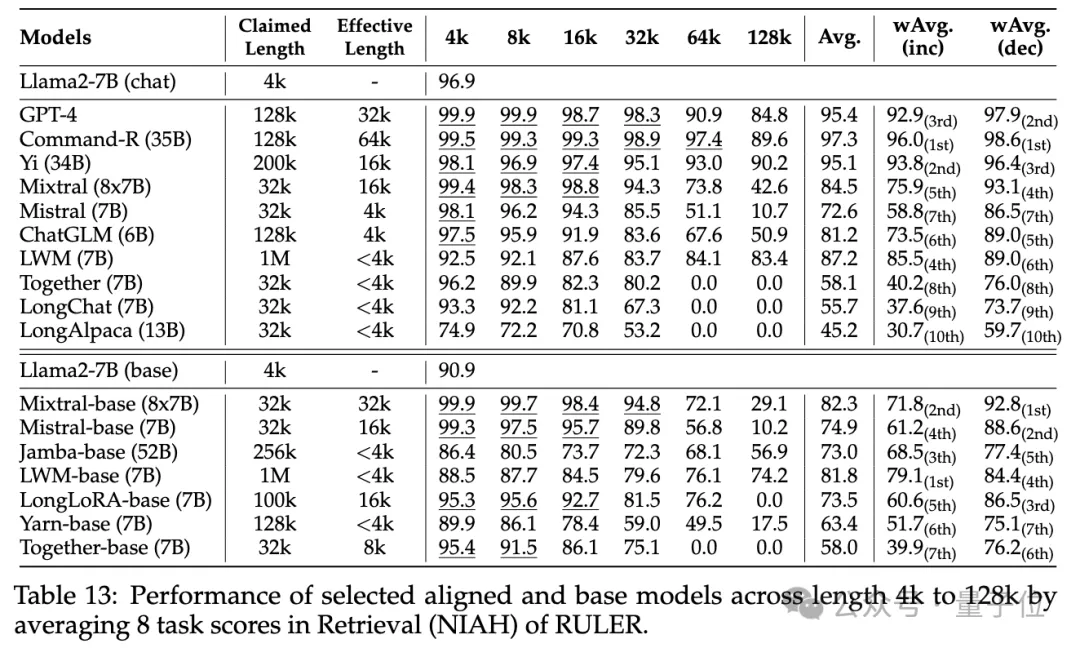
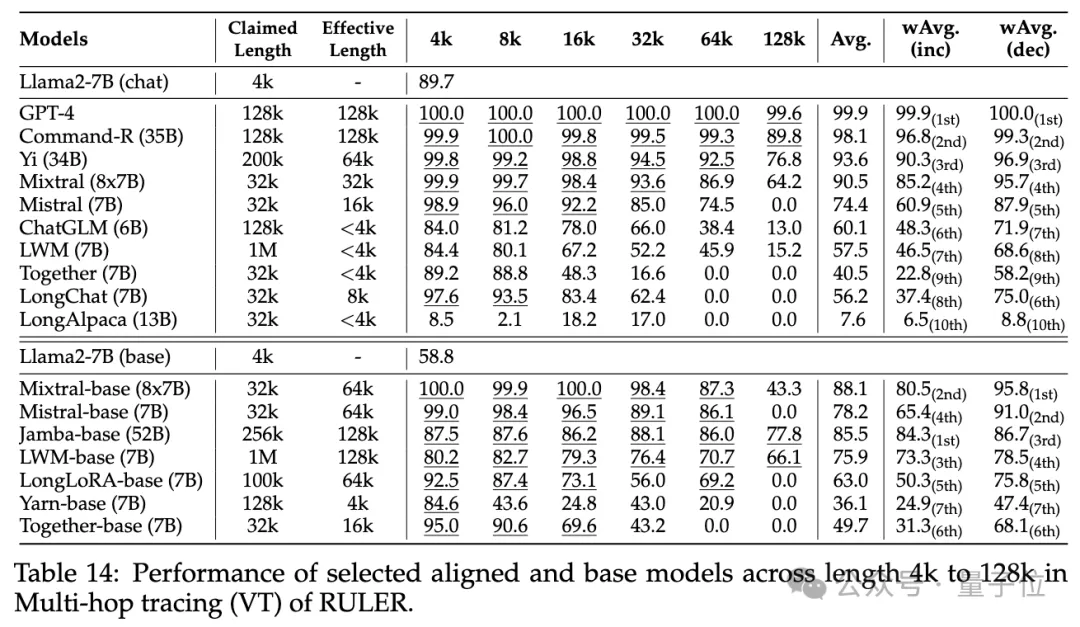
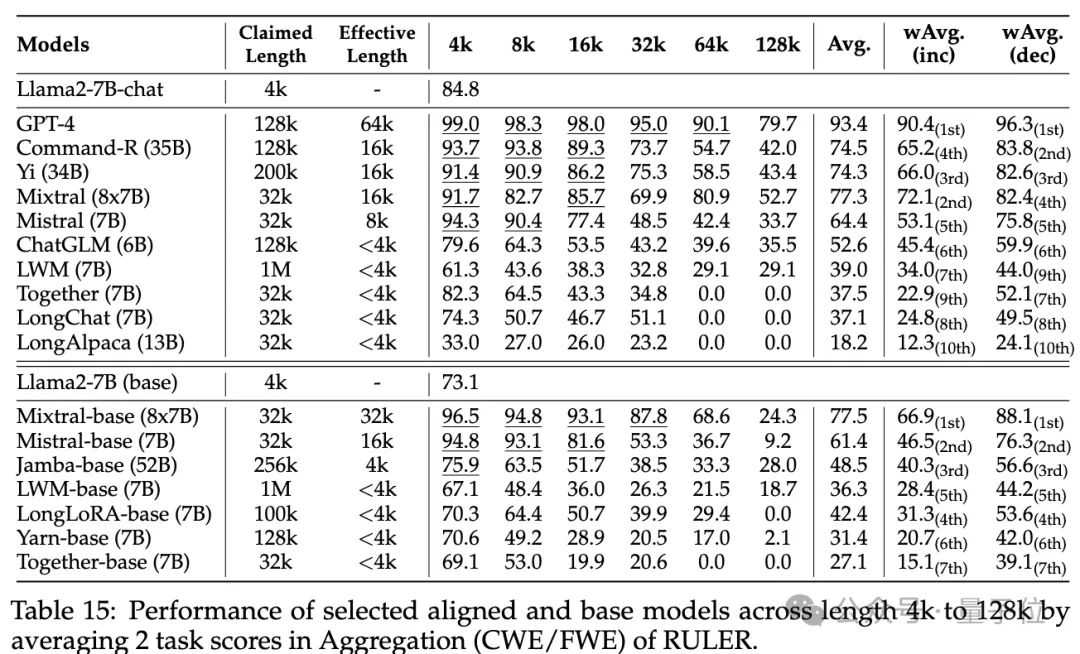
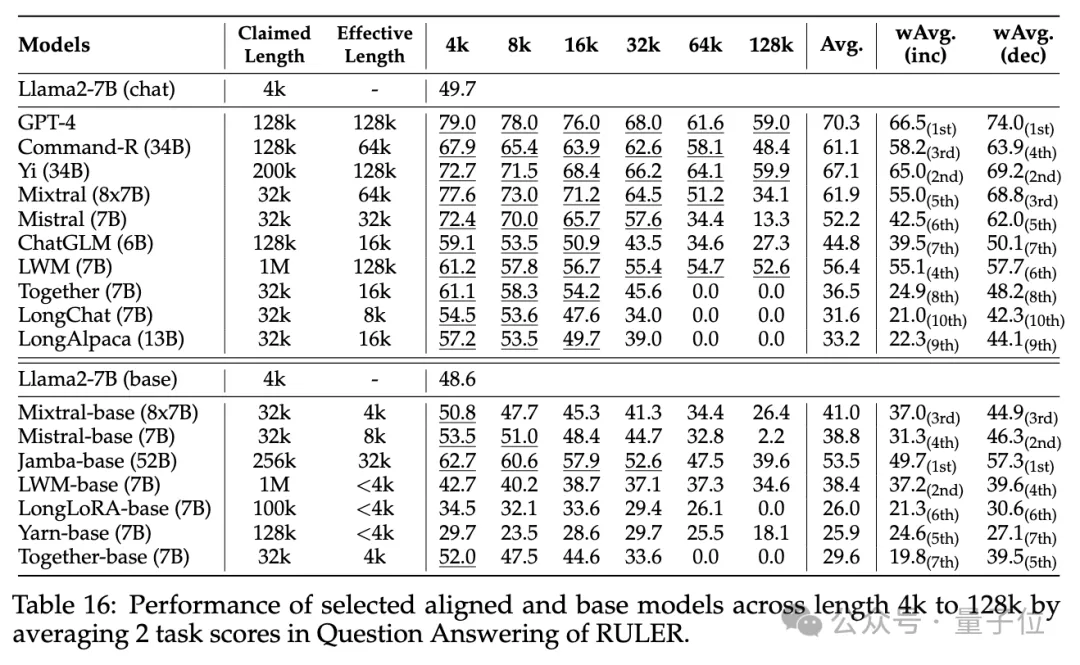
此外,研究人员还对Yi-34B-200K模型在增加输入长度(高达256K)和更复杂任务上的表现进行了深入分析,以理解任务配置和失败模式对RULER的影响。
他们还分析了训练上下文长度、模型大小和架构对模型性能的影响,发现更大的上下文训练通常会带来更好的性能,但对长序列的排名可能不一致;模型大小的增加对长上下文建模有显著好处;非Transformer架构(如RWKV和Mamba)在RULER上的表现显著落后于基于Transformer的Llama2-7B。
更多细节,感兴趣的家银们可以查看原论文。
论文链接:https://arxiv.org/abs/2404.06654
英伟达发布定制HBM技术NVHBM,通过集成内存控制器至HBM基础裸片,实现带宽较HBM4E提升30%、功耗降低15%,并释放主芯片25%空间。亚马逊Annapurna Labs为首个合作伙伴,该技术旨在通过标准化方案加速定制AI芯片开发,而非取代通用HBM。
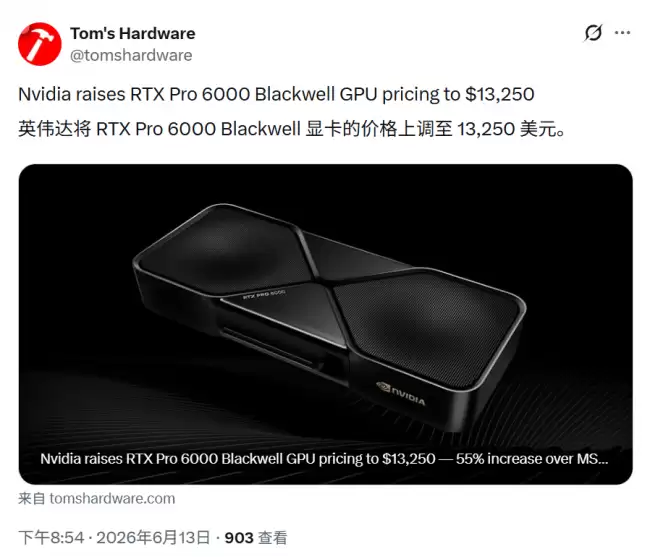
英伟达RTXPRO6000Blackwell官方标价升至13250美元,较首发价8565美元上涨55%。受显存市场紧绷及AI需求升温影响,专业显卡价格持续走高,折射出高端GPU市场供需格局演变。
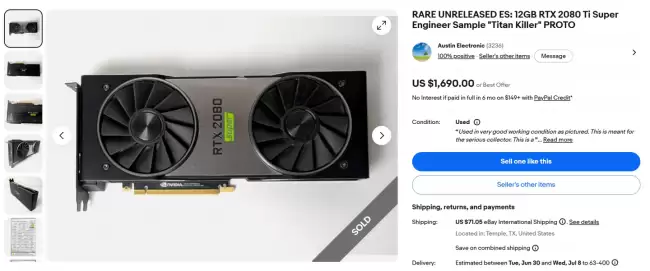
英伟达未发布的RTX2080TiSUPER工程样品现身eBay,配备4608个CUDA核心、12GB显存及384-bit位宽,规格接近TitanRTX。该卡因性能与定价内斗被取消,需在测试模式下修改驱动方可使用。
近日,LG旗下多家子公司高管将集体访问英伟达总部,探讨实体人工智能与机器人领域合作。此前董事长已与黄仁勋会面。此消息推动LG电子、LGCNS等公司股价出现上涨。
英伟达在TOP500超算中占据81%份额,新上榜系统近90%采用其技术。AI训练吞吐量是其他平台总和两倍以上,推理吞吐量近三倍。Green500前八名均搭载英伟达GPU,GraceCPU系统增至26台,欧洲正开发35台英伟达AI超算。
在统信UOS系统中,若要安装NVIDIA显卡驱动,有以下三种方式:一是利用图形化驱动管理器,一键启用即可自动禁用nouveau并重启lightdm;二是通过APT最新源来安装适配驱动,在此之前需先清除残留,再执行sudo apt install nvidia-driver命令;三是手动安装.run驱
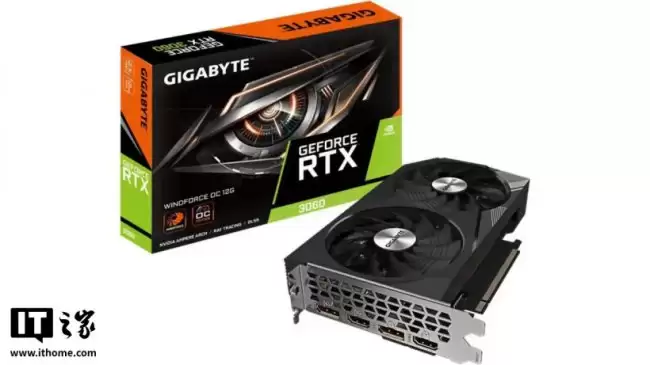
技嘉RTX306012GB显卡在美重新上架,售价339.99美元,比首发价贵10美元。WindforceRev2.0版参数不变。华硕也在欧洲铺货,两家同步动作引发RTX50系列供货困境猜测。

英伟达不提供免费零食咖啡,公司餐厅仅部分补贴,普通咖啡免费但特饮自费。没有乒乓球桌、健身房等休闲设施,副总裁出差坐经济舱且无专属助理。创始人黄仁勋崇尚节俭,倡导专注业务。这种务实文化助力公司市值屡创新高。
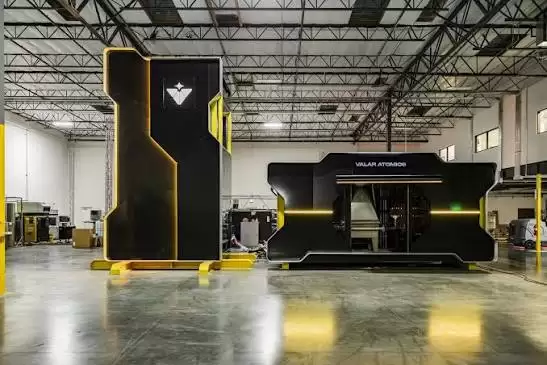
美国核能初创企业瓦拉原子能公司成功利用先进反应堆为英伟达Blackwell芯片供电,这是美国下一代反应堆首次实现。双方计划在犹他州共建小型数据中心,验证AI设施通过核能与闭环液冷技术实现自给自足。
英伟达在BilibiliWorld2026设立体验站,限量发售RTX5080公版显卡,售价8299元。玩家需通过在线预约、现场打卡或任务互动获取必购券,每UID限兑一次。现场持券可获京东必购码下单。活动持续三天,售完即止。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
