

7B?13B?175B?解读大模型的参数
大模型也是有大有小的,它们的大小靠参数数量来度量。GPT-3就有175亿个参数,而Grok-1更是不得了,有314亿个参数。当然,也有像Llama这样身材苗条一点的,参数数量只有70亿到700亿之间。这里说的70B可能不是指训练数据的数量,而是指模型中那些密密麻麻的参数。这些参数就像是一个个小小的“脑细胞”,越多就能让模型更聪明,更能理解数据中那些错综复杂的关系。有了这些“脑细胞”,模型在处理任务时可能会表现得更好。然而,很多时候这些参数,尤其是在大规模的模型中,会带来一些问题。这些“脑细胞”在处理任务时
大模型也是有大有小的,它们的大小靠参数数量来度量。GPT-3就有175亿个参数,而Grok-1更是不得了,有314亿个参数。当然,也有像Llama这样身材苗条一点的,参数数量只有70亿到700亿之间。
这里说的70B可能不是指训练数据的数量,而是指模型中那些密密麻麻的参数。这些参数就像是一个个小小的“脑细胞”,越多就能让模型更聪明,更能理解数据中那些错综复杂的关系。有了这些“脑细胞”,模型在处理任务时可能会表现得更好。 然而,很多时候这些参数,尤其是在大规模的模型中,会带来一些问题。这些“脑细胞”在处理任务时可能会互相影响,导致模型难以理解数据中那些复杂的关系。有了这些“脑细胞”,模型在处理任务时可能会表现得更好。 因此,在处理任务时,我们需要找到一种方式来管理这些参数之间的关系。一种常用的方法是通过正则化
这些大模型的参数就像是模型内部的“建筑师”,通过复杂的算法和训练过程,一点一滴地搭建起这个庞大的语言世界。每个参数都有它的作用,它们共同协作,让模型能够更准确地理解我们的语言,并给出更合适的回答。
那么,大模型中的参数是怎样构成的呢?
1. 大模型中的参数
大模型参数是其“内部零件”,这些零件各有各的用途,通常包括但不限于以下几类:
- 权重(Weights):权重就像神经网络里的“电线”,连接着各个神经元。它们负责调整信号传递时的“音量”,让重要的信息传得更远,不那么重要的信息就小声点。比如在全连接层里,权重矩阵W就是一张“地图”,告诉我们哪些输入特征和输出特征关系最密切。
- 偏置(Biases):偏置就像是神经元的“小助手”,负责给神经元的响应定个基准。有了它,神经元就知道自己该在什么水平上活跃了。
- 注意力机制的参数(Attention Parameters):在基于Transformer的模型中,这些参数就像是“指南针”,告诉模型哪些信息最值得关注。它们包括查询矩阵、键矩阵和值矩阵等,就像是在一大堆信息中找出最关键的“线索”。
- 嵌入矩阵(Embedding Matrices):在处理文本数据时,嵌入矩阵就是模型的“字典”。每一列都代表一个词汇,用一个数来表示这个词。这样,模型就能理解文本的意思了。
- 隐藏状态初始化参数(Initial Hidden State Parameters):这些参数就是用来设置模型最初的隐藏状态的,就像是给模型定个基调,让它知道从哪里开始“思考”。
- ......
这些参数一般会使用4种表达和存储的格式:
- Float: 32比特的浮点数,即4字节
- Half/BF16: 16比特的浮点数,即2字节
- Int8: 8比特的整数,即1字节
- Int4: 4比特的整数,即0.5字节
一般来说,参数的数量是影响大模型性能的主要因素。例如,13B-int8模型通常优于同一体系结构的7B-BF16模型。
2. 大模型参数对内存的需求
对于工程师而言,面对的是大模型训练或推理时会使用多少的内存资源。尽管V100(具备32GB的GPU内存)或A100(具备40GB的GPU内存)非常强大,大模型仍然无法在单个GPU上进行训练,例如使用Tensorflow或PyTorch。
2.1 训练阶段的内存需求
在模型训练期间,主要体现为模型状态和活动过程对内存的存储需求。模型状态包括由优化器状态、梯度和参数组成的张量。活动过程中包括在正向通道中创建的任何张量,这些张量是在反向通道中梯度计算所必需的。 为了优化内存使用,可以考虑以下几个方面: 1. 减少模型参数的数量:可以通过减小模型规模或使用稀疏矩阵等技术来减少参数的数量,并降低内存使用。 2. 优化器状态的存储:可以选择只存储必要的优化器状态,而不是保存全部状态。可以根据需要选择性地更新和存储优化器状态。 3. 修改张量的数据类型:
在训练的任何时候,对于每个模型参数,总是需要有足够的 GPU 内存来存储:
- 模型参数复制的字节数x
- 梯度复制的字节数y
- 优化器状态一般为12个字节,主要是参数、方差等的拷贝,会将所有优化器状态保存在 FP32中,以保持稳定训练并避免数值异常。
这意味着,训练时需要如下内存来存储所有的模型状态和过程数据:(x+y+12 ) * model_size
2.2 推理阶段的内存需求
推理阶段利用预先训练好的 LLM 完成文本生成或翻译等任务。在这里,内存需求通常较低,主要的影响因素:
- 有限的上下文: 推理通常处理较短的输入序列,需要较少的内存来存储与较小的文本块相关的激活。
- 无反向传播: 在推理过程中,LLM 不需要保留反向传播的中间值,这是一种用于训练调整参数的技术。这消除了大量的内存开销。
推理阶段所需的内存不会高于相同参数计数和类型的训练阶段所需内存的四分之一。例如,对于一个7B的模型而言,大体上,使用浮点精度需要28GB内存,使用BF16精度需要14GB内存,使用int8精度需要7GB内存。这个粗略的估计方式可以相应地应用到其他版本的模型。
另外,当根据特定任务调整 LLM 时,微调需要更高的内存占用。微调通常包括更长的训练序列来捕捉目标任务的细微差别。当 LLM 处理更多的文本数据时,这将导致更大的激活。反向传播过程需要存储用于梯度计算的中间值,这些中间值用于在训练期间更新模型的权重。与推理相比,这增加了大量的内存负担。
2.3 基于Transformer的大模型的内存估算
具体而言, 对应基于Transformer的大模型,尝试计算一下训练时所需的内存,其中设:
- l :transformer的层数
- a:attention 的head 数量
- b:批次大小
- s:序列长度
- h:隐藏层的维度大小
- p:精度
这里, bshp = b * s * h * p 代表了输入数据量的大小。在transformer 的线性层部分,大概需要9bshp+bsh 的空间来用于后面的激活。在attention 部分,self-attention 可以表达为:softmax((XQ)(XK)^T)XV
那么,XQ,XK,XV均需bshp大小的空间。在标准self-attention中,乘法(XQ) * (XK) ^ T 的结果只是一个包含 logit 的 b * s * s 矩阵。然而在实践中,由于使用了多头注意力机制,需要为每个头都要建立一个单独的 s * s 存储空间。这意味着需要 abssp 字节的空间,而存储 softmax 的输出也同样需要 abssp 字节。在 softmax 之后还一般需要额外的 abss 字节来存储掩码,所以 attention部分需要2abssp+abss的存储空间。
此外,transformer中还有两个Norm layer,每个仍需bshp的存储空间,共2个bshp。
所以,基于Transformer 的大模型训练所需内存大约为:L(9bshp+bsh+2abssp+abss +2bshp) = Lbshp[16+2/p+(as/h)(2+1/p)]
解释一下,训练基于Transformer 的大模型所需内存大约是:模型的层数 x 训练批次的大小 x 序列长度 x 隐藏层的维度 x 精度 x 大于16的整数
这或许就是基于Transfromer的大模型参数对训练时内存需求的一个理论下界。
3. 大模型参数对GPU 的需求
有了大模型参数对内存的要求, 可以进一步估算大模型在训练和推理中所需的GPU数量。但由于GPU数量估算依赖的参数稍多,有人(Dr. Walid Soula,https://medium.com/u/e41a20d646a8)给出了一个粗略估算的简单公式, 在工程上同样有一定的参考意义。
 图片
其中,
- Model’s parameters in billions 是以B为单位的模型参数数量;
- 18是训练期间不同组件的内存占用因子;
- 1.25 代表了激活过程所需的内存数量因子,激活是随着模型处理输入数据而变化的动态数据结构。
- GPU Size in GB是可用的 GPU 内存总量
举个实际的例子,假设使用的是 NVIDIA RTX 4090 GPU,它有24GB 的 VRAM,计算一下训练‘ Llama3 7B’模型所需的 GPU 数量,大约为 :
GPU 的总数≈(7 * 18 * 1.25)/24,大约等于7
对于推理而言, 可以简化为训练阶段的1/8~1/9 , 当然,这些只是一般意义的粗略估计。
4. 由大模型参数到分布式训练
理解大模型参数的组成及其对内存和GPU的需求,有助于深入掌握分布式训练在工程实践中所面临的挑战。
采用专为分布式训练设计的框架,例如TensorFlow或PyTorch,可以显著简化分布式训练策略的实施过程,这些框架提供了丰富的工具和API。通过运用梯度累积等技术在更新模型前,或利用梯度压缩等技术减少节点间的数据交换量,可以有效降低通信成本。确定分布式训练的最佳批次大小(即前文提到的参数b)至关重要;b值过小可能增加通信开销,而过大则可能导致内存不足。
LLMOps的重要性日益凸显。定期监控为分布式训练配置的性能指标,调整超参数、分区策略和通信设置以优化性能,是提升训练效率的关键。实施模型的检查点机制并在发生故障时进行有效的恢复,可以确保训练过程在无需从头开始的情况下继续进行。
换句话说,大模型的训练/推理本质上是一个复杂的分布式系统架构工程挑战,例如:
- 通信开销:在执行梯度计算和数据更新时,通信所需时间可能会影响整体的加速效果。
- 同步复杂性:多台机器并行训练时,同步的复杂性需要谨慎设计。
- 容错与资源管理:单点故障对模型训练和推理的影响,以及CPU与GPU的资源分配与调度策略。
- ......
然而,实际上大多数工程师可能并不直接参与具体的训练工作,而是关注在构建应用时可以如何利用大模型的参数。
 图片
5. 大模型应用中使用的参数
这里主要关注在使用大模型输出文本时,可以配置的三个参数:Temperature、Top-K和Top-P。
Temperature参数通常被误解为仅控制模型创造性的开关,但其实它更深层的作用是调节概率分布的“软性”。当Temperature值设置较高时,概率分布变得更柔和、均匀,这促使模型生成更多样化、具创造性的输出。反之,较低的Temperature值会使分布更尖锐,峰值更明显,从而倾向于产生与训练数据类似的输出。
Top-K参数用于限制模型在每个步骤中输出最可能的Top-K个标记,通过这种方式可以减少输出中的不连贯或无意义内容。这种策略在维持输出的最有可能的一致性与允许一定程度的创造性抽样之间形成平衡。
Top-P是另一种解码方法,它根据设定的P值(0≤P≤1)来选择一组累积概率超过P值的最小单词集合作为输出。这种方法使得选中的单词数量能够根据下一个单词的概率分布动态地增加或减少。特别地,当P值为1时,Top-P会选择所有单词,相当于从整个分布中抽样,从而产生更加多样的输出;而当P值为0时,Top-P仅选择概率最高的单词,类似于贪婪解码,使输出更加集中和一致。
这三个参数共同作用,影响模型的行为。例如,当设置Temperature=0.8、Top-K=36以及Top-P=0.7时,模型首先基于上下文计算整个词汇表的完整非规范化对数概率分布。Temperature=0.8意味着每个对数概率除以0.8,这在归一化前有效地增加了模型对其预测的信心。Top-K=36表示选择具有最高频比例对数概率的36个标记。接着,Top-P=0.7在这个Top-K=36集合中应用过滤,按概率从高到低保持排序,直到累积概率达到0.7。最后,将这个过滤后的集合重新归一化,用于后续的采样过程。
6. 小结
在工程实践中,理解大模型的参数是有意义的。参数在大模型中起着决定性的作用,它们定义了大模型的行为、性能、实现的成本以及对资源的需求。在工程上理解大模型的参数,就是要把握模型的复杂度、性能和能力之间的关系。从存储和计算的视角合理配置和优化这些参数,可以在实际应用中更好地选择和优化模型,以适应不同的任务需求和资源限制。
【参考资料】
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models ,https://arxiv.org/pdf/1910.02054v3.pdf
- Reducing Activation Recomputation in Large Transformer Models,https://arxiv.org/pdf/2205.05198.pdf
- https://timdettmers.com/2023/01/30/which-gpu-for-deep-learning/
- https://blog.eleuther.ai/transformer-math/

近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
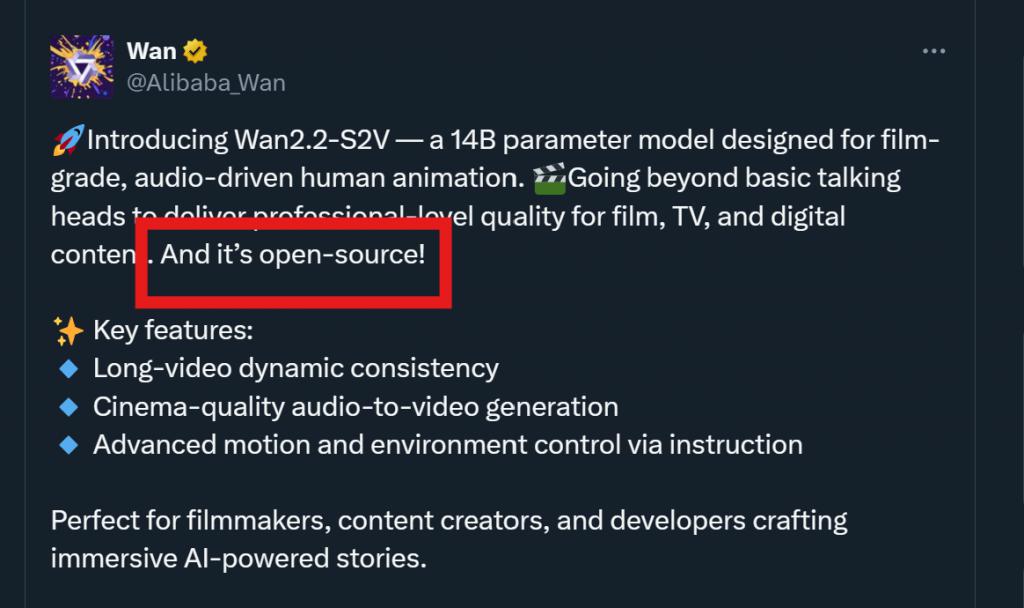
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音

5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
针对PhpStorm打开大文件卡顿的问题,可通过以下方法解决:1.禁用不必要的插件和语法检查以减少资源占用;2.调整JVM内存参数提升性能;3.使用轻量级工具如VSCode、SublimeText或命令行处理大文件;4.设置忽略特定类型文件自动打开避免误操作。通过优化配置与合理使用工具相结合,可有效缓解PhpStorm在处理大文件时的卡顿问题。

大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型

中国电信此前宣布将推出全新一代麦芒AI手机。根据最新消息,中国电信麦芒40手机的发布会——“麦芒40上市暨星小辰终端智能体发布会”将于6月25日下午14:30正式举行。CNMO得知,已有数码博主提前曝光了麦芒40的详细配置信息。麦芒40消息称,麦芒40将内置小艺与电信星小辰双AI系统,能够实时识别通话内容,有效防范电信诈骗。该机配备X键,支持一键拨打天通卫星电话。由于是电信自有品牌产品,麦芒40还将赠送一年期的天通卫星通信权益,包含50分钟卫星通话时长和

升级Win11后卡顿常见原因包括驱动不兼容、后台进程占用资源及系统设置未优化,解决方法如下:1.确认系统更新完成,避免后台进程占用资源;2.前往官网更新显卡驱动以确保最新;3.通过任务管理器禁用不必要的启动项;4.调整系统视觉效果为“最佳性能”或关闭特效;5.清理磁盘空间并检查硬盘健康状况;6.若问题持续可尝试重置系统。此外,针对CPU占用高可检查任务管理器中的异常进程或禁用部分系统服务,游戏卡顿时建议关闭后台程序、调整电源计划及检查硬件温度,确保散热良好以维持稳定性能。

强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足







Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
