

怎么使用Python构建电影推荐系统
导入数据导入和合并数据集并创建PandasDataFrameMovieLens20M数据集自1995年以来超过2000万的电影评级和标记活动。#usecols允许选择自己选择的特征,并通过dtype设定对应类型movies_df=pd.read_csv('movies.csv',usecols=['movieId','title'],dtype={'movieId':'int32','title':'s
导入数据
导入和合并数据集并创建 Pandas DataFrame
MovieLens 20M 数据集自 1995 年以来超过 2000 万的电影评级和标记活动。
# usecols 允许选择自己选择的特征,并通过dtype设定对应类型
movies_df=pd.read_csv('movies.csv',
usecols=['movieId','title'],
dtype={'movieId':'int32','title':'str'})
movies_df.head()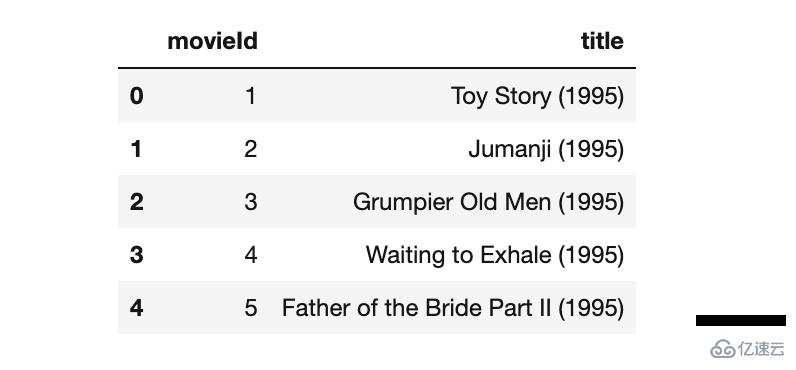
ratings_df=pd.read_csv('ratings.csv',
 usecols=['userId', 'movieId', 'rating','timestamp'],
 dtype={'userId': 'int32', 'movieId': 'int32', 'rating': 'float32'})
ratings_df.head()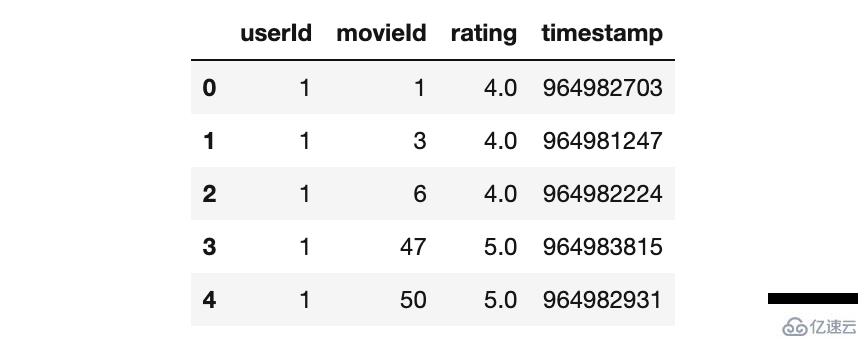
检查是否存在任何空值以及两个数据中的条目数。
# 检查缺失值
movies_df.isnull().sum()
movieId 0
title 0
dtype: int64
ratings_df.isnull().sum()
userId 0
movieId 0
rating 0
timestamp 0
dtype: int64
print("Movies:",movies_df.shape)
print("Ratings:",ratings_df.shape)
Movies: (9742, 2)
Ratings: (100836, 4)
合并列上的数据帧 'movieId'
# movies_df.info()
# ratings_df.info()
movies_merged_df=movies_df.merge(ratings_df, on='movieId')
movies_merged_df.head()
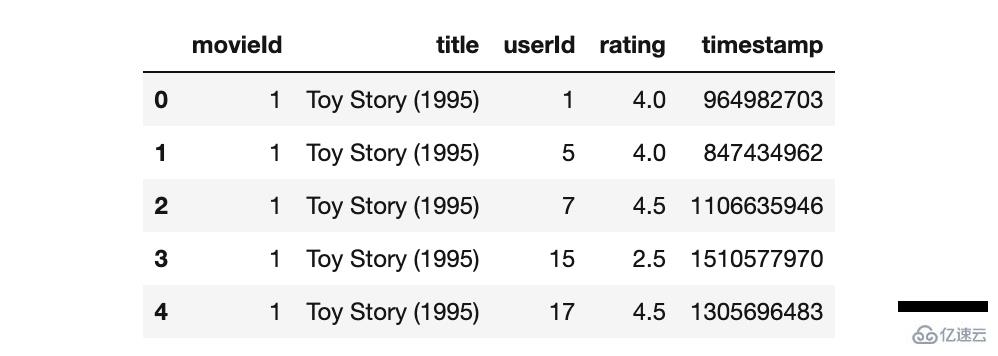
现在已经成功合并了导入的数据集。
添加衍生特征
添加必要的特征来分析数据。
通过按电影标题对用户评分进行分组来创建'Average Rating' & 'Rating Count'列。
movies_average_rating=movies_merged_df.groupby('title')['rating']
 .mean().sort_values(ascending=False)
.reset_index().rename(columns={'rating':'Average Rating'})
movies_average_rating.head()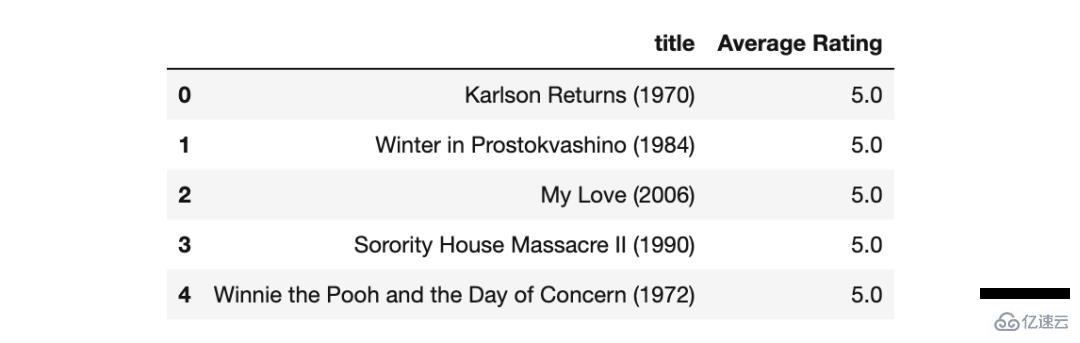
movies_rating_count=movies_merged_df.groupby('title')['rating']
.count().sort_values(ascending=True)
 .reset_index().rename(columns={'rating':'Rating Count'}) #ascending=False
movies_rating_count_avg=movies_rating_count.merge(movies_average_rating, on='title')
movies_rating_count_avg.head()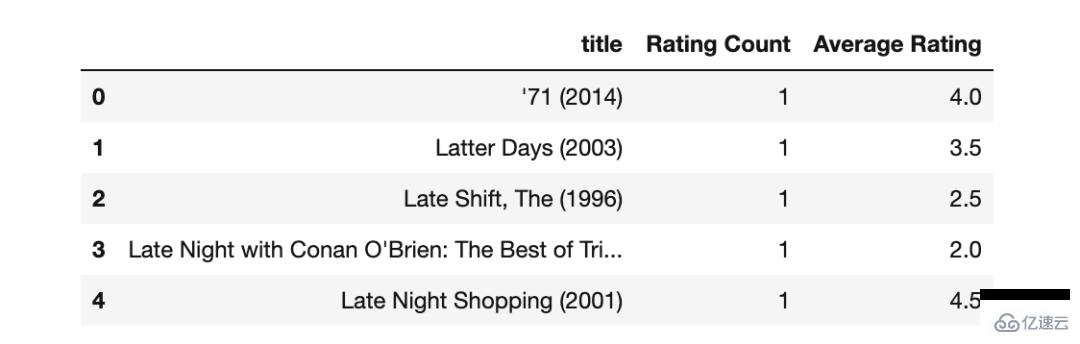
目前已经创建了 2 个新的衍生特征。
数据可视化
使用 Seaborn 可视化数据:
经过分析发现,许多电影在近 10 万用户评分的数据集上都有完美的 5 星平均评分。这表明存在异常值,我们需要通过可视化进一步确认。
多部电影的评分比较单一,建议设置一个评分门槛值,以便产生有价值的推荐。
使用 seaborn & matplotlib 可视化数据,以便更好地观察和分析数据。
将新创建的特征绘制直方图,并查看它们的分布。设置 bin 大小为80,该值的设置需要具体分析,并合理设置。
# 导入可视化库
import seaborn as sns
import matplotlib.pyplot as plt
sns.set(font_scale = 1)
plt.rcParams["axes.grid"] = False
plt.style.use('dark_background')
%matplotlib inline

# 绘制图形
plt.figure(figsize=(12,4))
plt.hist(movies_rating_count_avg['Rating Count'],bins=80,color='tab:purple')
plt.ylabel('Ratings Count(Scaled)', fontsize=16)
plt.savefig('ratingcounthist.jpg')

plt.figure(figsize=(12,4))
plt.hist(movies_rating_count_avg['Average Rating'],bins=80,color='tab:purple')
plt.ylabel('Average Rating',fontsize=16)
plt.savefig('avgratinghist.jpg')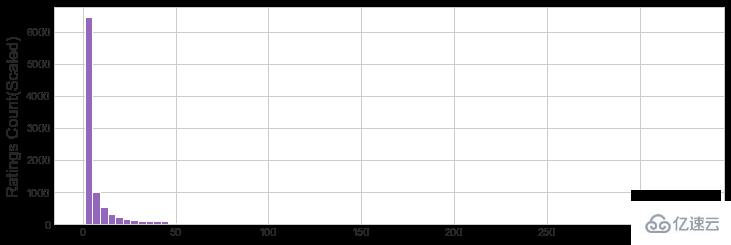
图1 Average Rating直方图
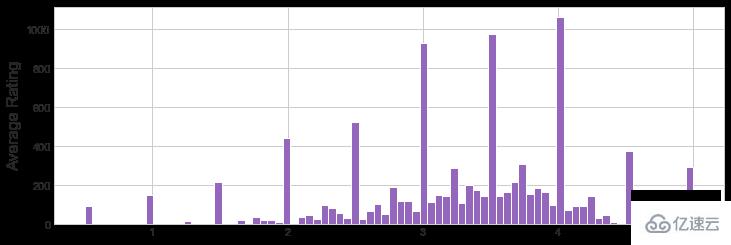
图2 Rating Count的直方图
现在创建一个joinplot二维图表,将这两个特征一起可视化。
plot=sns.jointplot(x='Average Rating',
 y='Rating Count',
 data=movies_rating_count_avg,
 alpha=0.5,
 color='tab:pink')
plot.savefig('joinplot.jpg')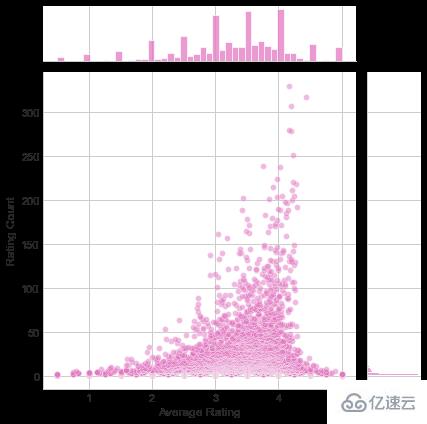
Average Rating和Rating Count的二维图
分析
图1证实了,大部分电影的评分都是较低的。除了设置阈值之外,我们还可以在这个用例中使用一些更高百分比的分位数。
直方图 2 展示了“Average Rating”的分布函数。
数据清洗
运用describe()函数得到数据集的描述统计值,如分位数和标准差等。
pd.set_option('display.float_format', lambda x: '%.3f' % x)
print(rating_with_RatingCount['Rating Count'].describe())
count 100836.000 mean58.759 std 61.965 min1.000 25% 13.000 50% 39.000 75% 84.000 max329.000 Name: Rating Count, dtype: float64
设置阈值并筛选出高于阈值的数据。
popularity_threshold = 50
popular_movies= rating_with_RatingCount[
rating_with_RatingCount['Rating Count']>=popularity_threshold]
popular_movies.head()
# popular_movies.shape
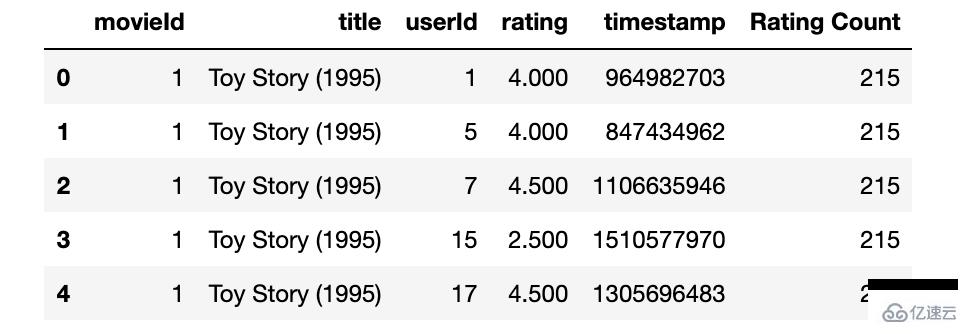
至此已经通过过滤掉了评论低于阈值的电影来清洗数据。
创建数据透视表
创建一个以用户为索引、以电影为列的数据透视表
为了稍后将数据加载到模型中,需要创建一个数据透视表。并设置'title'作为索引,'userId'为列,'rating'为值。
import os
movie_features_df=popular_movies.pivot_table(
index='title',columns='userId',values='rating').fillna(0)
movie_features_df.head()
movie_features_df.to_excel('output.xlsx')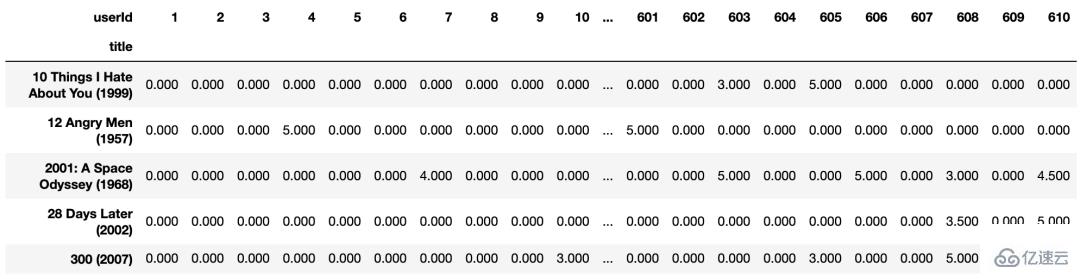
接下来将创建的数据透视表加载到模型。
建立 kNN 模型
建立 kNN 模型并输出与每部电影相似的 5 个推荐
使用scipy.sparse模块中的csr_matrix方法,将数据透视表转换为用于拟合模型的数组矩阵。
from scipy.sparse import csr_matrix
movie_features_df_matrix = csr_matrix(movie_features_df.values)
最后,使用之前生成的矩阵数据,来训练来自sklearn中的NearestNeighbors算法。并设置参数:metric = 'cosine', algorithm = 'brute'
from sklearn.neighbors import NearestNeighbors
model_knn = NearestNeighbors(metric = 'cosine',
 algorithm = 'brute')
model_knn.fit(movie_features_df_matrix)
现在向模型传递一个索引,根据'kneighbors'算法要求,需要将数据转换为单行数组,并设置n_neighbors的值。
query_index = np.random.choice(movie_features_df.shape[0])
distances, indices = model_knn.kneighbors(movie_features_df.iloc[query_index,:].values.reshape(1, -1),
n_neighbors = 6)
最后在 query_index 中输出出电影推荐。
for i in range(0, len(distances.flatten())):
if i == 0:
print('Recommendations for {0}:n'
.format(movie_features_df.index[query_index]))
else:
print('{0}: {1}, with distance of {2}:'
.format(i, movie_features_df.index[indices.flatten()[i]],
distances.flatten()[i]))
Recommendations for Harry Potter and the Order of the Phoenix (2007): 1: Harry Potter and the Half-Blood Prince (2009), with distance of 0.2346513867378235: 2: Harry Potter and the Order of the Phoenix (2007), with distance of 0.3396233320236206: 3: Harry Potter and the Goblet of Fire (2005), with distance of 0.4170845150947571: 4: Harry Potter and the Prisoner of Azkaban (2004), with distance of 0.4499547481536865: 5: Harry Potter and the Chamber of Secrets (2002), with distance of 0.4506162405014038:

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



