

利用大语言模型增强网络抓取:一种现代化的方法
想了解更多AIGC的内容,请访问:51CTOAI.x社区https://www.51cto.com/aigc/本文将探讨大语言模型(LLMs)与网络抓取的集成,以及如何利用LLMs高效地将复杂的HTML转换为结构化的JSON。作为一名数据工程师,我的职业生涯可追溯至2016年。那时,我的主要职责是利用自动化工具从不同网站上获取海量数据,这个过程被称为“网络抓取”。网络抓取通常是从网站的HTML代码中提取所需数据。在构建相关应用程序时,我不得不深入研究HTML代码,努力寻找最佳的抓取解决方案。我所面临的主要
想了解更多AIGC的内容,请访问:
51CTO AI.x社区
https://www.51cto.com/aigc/
本文将探讨大语言模型(LLMs)与网络抓取的集成,以及如何利用LLMs高效地将复杂的HTML转换为结构化的JSON。
作为一名数据工程师,我的职业生涯可追溯至2016年。那时,我的主要职责是利用自动化工具从不同网站上获取海量数据,这个过程被称为“网络抓取”。网络抓取通常是从网站的HTML代码中提取所需数据。
在构建相关应用程序时,我不得不深入研究HTML代码,努力寻找最佳的抓取解决方案。我所面临的主要挑战之一是应对网站的频繁变化:例如,我所抓取的亚马逊页面每一到两周就会发生结构上的变化。
随着我开始阅读有关大语言模型(LLMs)的文献,我突然意识到:能否利用LLMs来规避我之前在网页结构化数据方面所遇到的种种问题?让我们探讨一下,看看是否能够实现这一目标。
网络抓取工具和技术
在网络抓取领域,工具和技术的选择至关重要。在这方面,我主要使用的工具包括Requests、BeautifulSoup和Selenium。每种工具都有不同的用途,适用于各自不同类型的网络环境。 Requests是一个功能强大的HTTP库,用于发送网络请求和处理响应。它提供了简洁的API,使得发送HTTP请求变得非常简单。对于大多数简单的抓取任务来说,Requests是一个非常方便的选择。 BeautifulSoup是一个用于解析HTML和XML文件的库。它可以将网页内容解析为树状结构,然后通过选择器表达式
- Requests 是一个基于Python的HTTP库,旨在简化HTTP请求的发送和响应的接收,通常被用于获取可由BeautifulSoup解析的HTML内容。
- BeautifulSoup 则是一款基于Python的HTML/XML解析库,它能够构建解析树,方便开发者访问页面中的各种元素。通常情况下,BeautifulSoup会与其他库(如Requests或Selenium)结合使用,对从这些库获取的HTML源代码进行解析。
- Selenium 主要应用于包含大量JavaScript的网站。与BeautifulSoup不同的是,Selenium除了能分析HTML代码外,还能通过模拟用户操作(如点击和滚动)与网站进行交互。这有助于从动态网站中获取数据。
在网络抓取过程中,这三种工具是必不可少的利器。然而,它们也带来了一定的挑战:由于网站布局和结构的变化,开发者不得不不定期更新代码、标签和元素,这无疑增加了长期维护的复杂性。
什么是大语言模型(LLMs)?
大语言模型(LLMs)被视为下一代计算机程序,它们可以通过阅读和分析海量文本数据进行学习。在当今时代,LLMs具备了以人类般的叙述方式进行写作的惊人能力,使其成为处理语言和理解人类语言的高效工具。这种出色的能力在需要深入把握文本上下文的场景中表现尤为突出。
将LLMs集成入网络抓取
在网络抓取实施过程中,LLMs可以带来极大优化。我们只需将网页的HTML代码输入到LLM中,LLM即可提取出其中所涉及的对象。因此,这种策略有助于简化维护,原因在于即使标记结构发生了变化,内容本身通常也会固定不变。
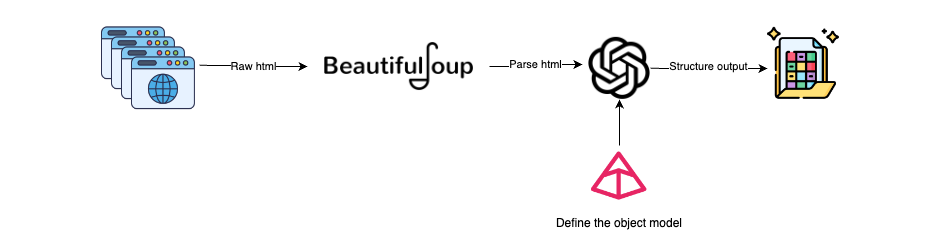
将大语言模型(LLMs)集成入网络抓取的工作流程大致如下:
获取HTML:使用Selenium或Requests等工具获取网页的HTML内容。其中,Selenium适用于处理包含JavaScript的动态页面内容,而Requests则更适合静态页面。
解析HTML:使用BeautifulSoup,我们可以将HTML解析为文本,从而去除HTML中的噪音数据(页脚、页眉等)。
创建Pydantic模型:定义需抓取数据对象的Pydantic模型。这一步确保了待抓取数据的类型和结构符合预定义的模式。
为LLMs生成提示:设计一个提示语,明确告知LLM应该提取哪些信息。
LLM处理:使用LLM模型读取HTML内容,理解其语义,并根据数据处理和结构化的指令进行操作。
结构化数据的输出:LLM将以Pydantic模型定义的结构化对象形式提供输出。
上述工作流程有助于利用LLMs将HTML(非结构化数据)转化为结构化数据,从而解决了网页源HTML设计不规范或动态修改所带来的问题。
LangChain与BeautifulSoup和Pydantic的集成
以下是我们选择的静态网页示例,目标是从中抓取所有列出的活动,并以结构化的方式呈现。
这种方法首先从静态网页中提取原始HTML,并在LLM处理之前对其进行清理。
from bs4 import BeautifulSoupimport requestsdef extract_html_from_url(url):try:# Fetch HTML content from the URL using requestsresponse = requests.get(url)response.raise_for_status()# Raise an exception for bad responses (4xx and 5xx)# Parse HTML content using BeautifulSoupsoup = BeautifulSoup(response.content, "html.parser")excluded_tagNames = ["footer", "nav"]# Exclude elements with tag names 'footer' and 'nav'for tag_name in excluded_tagNames:for unwanted_tag in soup.find_all(tag_name):unwanted_tag.extract()# Process the soup to maintain hrefs in anchor tagsfor a_tag in soup.find_all("a"):href = a_tag.get("href")if href:a_tag.string = f"{a_tag.get_text()} ({href})"return ' '.join(soup.stripped_strings)# Return text content with preserved hrefsexcept requests.exceptions.RequestException as e:print(f"Error fetching data from {url}: {e}")return None当我们从网页中进行数据抓取时,下一步是定义需要从网页中抓取的 Pydantic 对象。我们需要创建两个对象:
Activity:这是一个 Pydantic 对象,用于表示与活动相关的所有元数据,其中指定了属性和数据类型。我们已将某些字段标记为可选,以防它们在所有活动中均不可用。为属性提供描述、示例和任何元数据将有助于更好地定义。
ActivityScraper:这是基于 Activity 的 Pydantic 封装。该对象的目的是确保 LLM 理解需要从多个活动中抓取数据。
from pydantic import BaseModel, Fieldfrom typing import Optionalclass Activity(BaseModel):title: str = Field(description="The title of the activity.")rating: float = Field(description="The average user rating out of 10.")reviews_count: int = Field(description="The total number of reviews received.")travelers_count: Optional[int] = Field(description="The number of travelers who have participated.")cancellation_policy: Optional[str] = Field(description="The cancellation policy for the activity.")description: str = Field(description="A detailed description of what the activity entails.")duration: str = Field(description="The duration of the activity, usually given in hours or days.")language: Optional[str] = Field(description="The primary language in which the activity is conducted.")category: str = Field(description="The category of the activity, such as 'Boat Trip', 'City Tours', etc.")price: float = Field(description="The price of the activity.")currency: str = Field(description="The currency in which the price is denominated, such as USD, EUR, GBP, etc.")class ActivityScrapper(BaseModel):Activities: list[Activity] = Field("List of all the activities listed in the text")最后,我们来看一下 LLM 的配置。我们将使用 LangChain 库,该库提供了一个出色的工具包,可帮助您入门。
其中一个关键组件是 PydanticOutputParser。它将把我们的对象转换为指令(如提示中所示),并解析 LLM 的输出,以获取相应的对象列表。
from langchain.prompts import PromptTemplatefrom langchain.output_parsers import PydanticOutputParserfrom langchain_openai import ChatOpenAIfrom dotenv import load_dotenvload_dotenv()llm = ChatOpenAI(temperature=0)output_parser = PydanticOutputParser(pydantic_object = ActivityScrapper)prompt_template = """You are an expert making web scrapping and analyzing HTML raw code.If there is no explicit information don't make any assumption.Extract all objects that matched the instructions from the following html{html_text}Provide them in a list, also if there is a next page link remember to add it to the object.Please, follow carefulling the following instructions{format_instructions}"""prompt = PromptTemplate(template=prompt_template,input_variables=["html_text"],partial_variables={"format_instructions": output_parser.get_format_instructions})chain = prompt | llm | output_parser在这一步中,您需要调用链式模型并检索结果。
url = "https://www.civitatis.com/es/budapest/"html_text_parsed = extract_html_from_url(url)activites = chain.invoke(input={"html_text": html_text_parsed})activites.Activities这就是抓取出来的数据,整个网页抓取耗时46 秒。
[Activity(title='Paseo en barco al anochecer', rating=8.4, reviews_count=9439, travelers_count=118389, cancellation_policy='Cancelación gratuita', description='En este crucero disfrutaréis de las mejores vistas de Budapest cuando se viste de gala, al anochecer. El barco es panorámico y tiene partes descubiertas.', duration='1 hora', language='Español', category='Paseos en barco', price=21.0, currency='€'), Activity(title='Visita guiada por el Parlamento de Budapest', rating=8.8, reviews_count=2647, travelers_count=34872, cancellation_policy='Cancelación gratuita', description='El Parlamento de Budapest es uno de los edificios más bonitos de la capital húngara. Comprobadlo vosotros mismos en este tour en español que incluye la entrada.', duration='2 horas', language='Español', category='Visitas guiadas y free tours', price=27.0, currency='€') ...]
演示和完整代码库
我创建了一个使用Streamlit的快速演示,可以在此处访问。
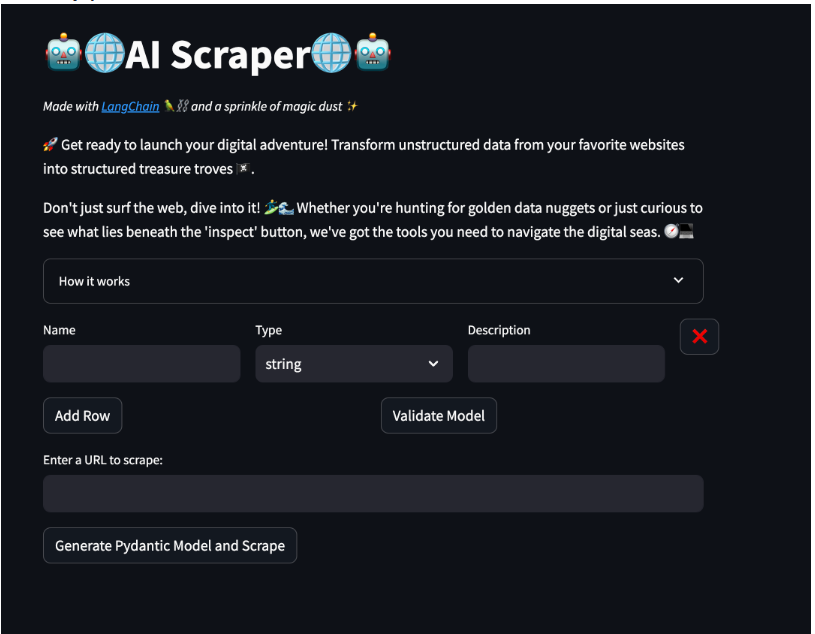
在这个演示中,您将了解有关模型的详细信息。您可以根据需要添加多行文本,并为每个属性指定名称、类型和描述。这将自动生成一个Pydantic模型,用于在网页抓取组件中使用。
接下来的部分允许您输入一个URL地址,并通过点击网页上的按钮来抓取所有数据。当抓取完成后,会出现一个下载按钮,允许您以JSON格式下载数据。
请随意尝试!
结论
当处理非结构化数据时,LLM确实为从非结构化数据(如网站、PDF等)中高效提取数据提供了新的可能性。自动化网络抓取不仅可以节省时间,还可以确保检索到的数据质量。
然而,将原始HTML发送给LLM可能会增加令牌成本并降低效率。这是因为HTML通常包含各种标签、属性和内容,导致成本迅速上升。
因此,在使用LLM作为网络数据提取器时,预处理和清理HTML是关键的一步。我们应该删除所有不必要的元数据和非实际使用的信息,以保持合理的成本。
总之,选择正确的工具对于正确的工作至关重要!
译者介绍
刘涛,51CTO社区编辑,某大型央企系统上线检测管控负责人。
原文标题:Enhancing Web Scraping With Large Language Models: A Modern Approach,作者:Nacho Corcuera
链接:https://dzone.com/articles/enhancing-web-scraping-with-large-language-models。
想了解更多AIGC的内容,请访问:
51CTO AI.x社区
https://www.51cto.com/aigc/
深入解析大模型中的Token与Tokenizer工作机制,通过BPE分词示例说明文字如何转化为数字编号,澄清上下文长度与字数的区别,帮助用户准确评估模型处理长文本的实际能力。
想了解更多AIGC的内容,请访问:51CTOAI.x社区https://www.51cto.com/aigc/本文介绍了如何使用简单的大语言模型(LLM)调用来显著改善语义搜索结果的质量。找到适合的AI模型来构建工作流程很困难。由于不同平台上有众多的模型可用,因此不可知道从哪里入手,或者如何找到最适合您特定需求的模型。这就是我打算用AIModels.fyi解决的问题,这是唯一用来发现和比较网上的AI模型的搜索引擎。该网站提供一个简单的前提:用自然语言描述问题,然后详细列出可能会解决问题的AI模型。比如说,
译者|布加迪审校|重楼在AI领域,科技巨头们一直在竞相构建越来越庞大的语言模型,如今出现了一个令人惊讶的新趋势:小就是大。随着大语言模型(LLM)方面的进展出现了停滞的迹象,研究人员和开发人员日益开始将注意力转向小语言模型(SLM)。这种紧凑、高效、适应性强的AI模型正在挑战“越大越好”这个观念,有望改变我们对待AI开发的方式。LLM是否开始停滞?Vellum和HuggingFace最近发布的性能比较结果表明,LLM之间的性能差距在迅速缩小。这个趋势在多项选择题、推理和数学问题等特定任务中体现得尤为明显;
大语言模型(LLMs)在语言理解和各种推理任务中展现出令人印象深刻的性能。然而,它们在人类认知的关键一面——空间推理上,仍然未被充分研究。人类具有通过一种被称为心灵之眼的过程创造看不见的物体和行为的心智图像的能力,从而使得对未见世界的想象成为可能。受到这种认知能力的启发,研究人员提出了“思维可视化”(VisualizationofThought,VoT)。VoT旨在通过可视化其推理迹象来引导LLMs的空间推理,从而引导后续的推理步骤。研究人员将VoT应用于多跳空间推理任务,包括自然语言导航、视觉导航以及二
编译|星璇出品|51CTO技术栈(微信号:blog51cto)在过去的两年里,我更多地参与了使用大型语言模型(LLMs)的生成AI项目,而非传统的系统。我开始怀念无服务器云计算。它们的应用范围广泛,从增强对话AI到为各行各业提供复杂的分析解决方案,以及其他许多功能。许多企业将这些模型部署在云平台上,因为公共云提供商已经提供了现成的生态系统,而且这是阻力最小的路径。然而,这并不便宜。云还提供了其他好处,如可扩展性、效率和高级计算能力(按需提供GPU)。在公共云平台上部署LLM的过程有一些鲜为人知的秘密,它们
译者|布加迪审校|重楼提示注入攻击是一种网络安全威胁,专门针对基于人工智能(AI)的系统,包括聊天机器人、虚拟助理及其他基于AI的界面。当攻击者以某种方式操纵AI模型的输入,导致模型执行意外操作或泄露敏感信息时,就会发生这类攻击。这种操纵可以诱骗AI将恶意输入解释为合法的命令或查询。随着消费者和组织使用大语言模型(LLM)的现象急剧增多,以及这些技术的功能日益完善,提示注入威胁大幅增加。开放Web应用程序安全项目(OWASP)向来专注于Web应用程序、移动应用程序和API的安全,如今该项目采取了一项引人注
谷歌近日发布新闻稿,宣布推出ASPIRE训练框架,专为大语言模型设计。该框架旨在提升AI模型的选择性预测能力。谷歌提到,当下大语言模型在自然语言理解和生成内容方面发展迅速,已被用于构建各种创新应用,但要应用于高风险决策类场合依然不妥。这是由于模型预测具有不确定性及“幻觉”可能,因此谷歌开发了一款ASPIRE训练框架,为系列模型引入了“可信度”机制,即——模型会输出一系列答案,每个答案都会具有正确概率评分。▲图源谷歌新闻稿(下同)在技术层面,该训练框架可划分为三个阶段:特定任务调整、答案采样和自我评估学习。
译者|布加迪审校|重楼大家都想利用生成式AI和大语言模型的力量,但这里有一个难题。让AI满足很高的期望需要高质量的实用数据,这正是许多组织的不足之处。麦肯锡最近一份由JoeCaserta和KayvaunRowshankish共同撰写的报告指出,许多组织要求用生成式AI做点什么。然而,这种压力伴随着其他问题:如果贵企业的数据还没有为生成式AI做好准备,贵企业也就没有为生成式AI做好准备。报告作者建议,IT和数据管理员需要对生成式AI的数据含义有一个清晰的认识。数据可能通过应用编程接口或企业自己的模型借助原先

作者|RahulPradhan来源|https://www.infoworld.com/article/3708254/addressing-ai-hallucinations-with-retrieval-augmented-generation.html人工智能有望成为当代最具影响力的技术。最近在transformer技术和生成式人工智能方面取得的进展已经展示了其大规模释放创新和独创性的潜力。然而,生成式人工智能并非没有挑战——这些挑战甚至可能会严重阻碍这一变革性技术的应用和价值创造。随着生成式人工智
ChatGPT回答问题时,是一个字一个字弹出的,给人一种在认真思考的感觉。这段对话的基本内容是:问:大语言生成式模型是如何工作的答:大型语言生成模型(如GPT-3)是基于深度学习技术的神经网络模型。这些模型通常使用一种称为"Transformer"的架构,该架构在自然语言处理领域取得了巨大的成功。下面是大型语言生成模型的工作原理概述:...省略一段...生成文本:一旦模型经过训练,就可以使用它来生成文本。给定一个初始文本或提示,模型会根据已经学到的概率分布生成下一个单词,然后使用生成的单词作为输入,并继续





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



