

ChatGPT是如何做到一个字一个字输出的?
ChatGPT回答问题时,是一个字一个字弹出的,给人一种在认真思考的感觉。这段对话的基本内容是:问:大语言生成式模型是如何工作的答:大型语言生成模型(如GPT-3)是基于深度学习技术的神经网络模型。这些模型通常使用一种称为"Transformer"的架构,该架构在自然语言处理领域取得了巨大的成功。下面是大型语言生成模型的工作原理概述:...省略一段...生成文本:一旦模型经过训练,就可以使用它来生成文本。给定一个初始文本或提示,模型会根据已经学到的概率分布生成下一个单词,然后使用生成的单词作为输入,并继续
ChatGPT回答问题时,是一个字一个字弹出的,给人一种在认真思考的感觉。
这段对话的基本内容是:
问:大语言生成式模型是如何工作的
答:大型语言生成模型(如GPT-3)是基于深度学习技术的神经网络模型。这些模型通常使用一种称为"Transformer"的架构,该架构在自然语言处理领域取得了巨大的成功。下面是大型语言生成模型的工作原理概述:
... 省略一段 ...
生成文本:一旦模型经过训练,就可以使用它来生成文本。给定一个初始文本或提示,模型会根据已经学到的概率分布生成下一个单词,然后使用生成的单词作为输入,并继续生成下一个单词,以此类推,直到达到所需的文本长度或生成终止符号。
... 省略一段 ...
大语言模型,Large Language Model,简称LLM。
从模型的视角来看,LLM每进行一次推理生成一个token,直到达到文本长度限制或生成终止符。
从服务端的视角来看,生成的token需要通过HTTPS协议逐个返回到浏览器端。
Client-Server 模式下,常规的交互方式是client端发送一次请求,接收一次响应。显然,这无法满足ChatGPT回复问题的场景。
其次,我们可能想到websocket,它依赖HTTP实现握手,升级成WebSocket。不过WebSocket需要client和server都持续占用一个socket,server侧成本比较高。
ChatGPT使用的是一种折衷方案: server-sent event(简称SSE). 我们从OpenAI的 API 文档可以发现这一点:
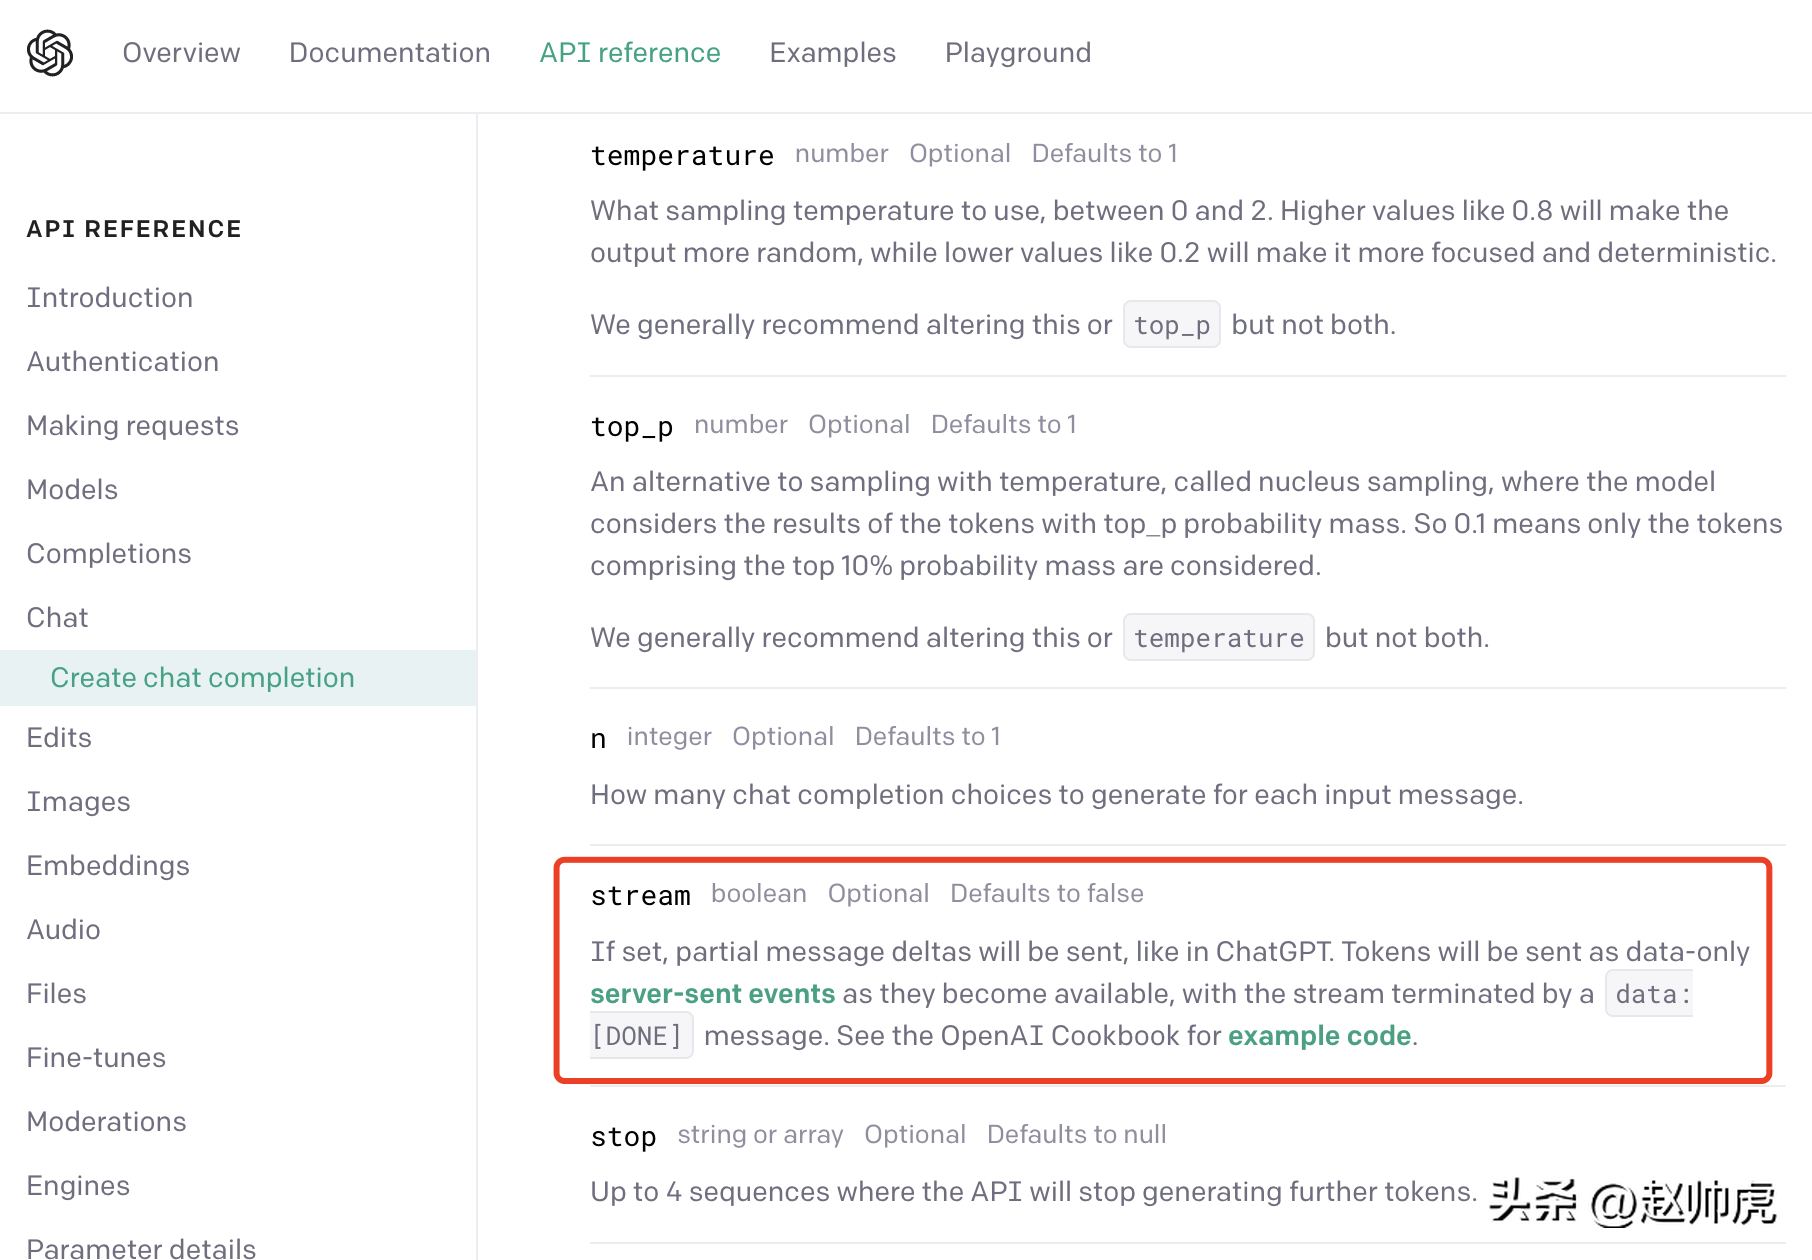
SSE 模式下,client只需要向server发送一次请求,server就能持续输出,直到需要结束。整个交互过程如下图所示:
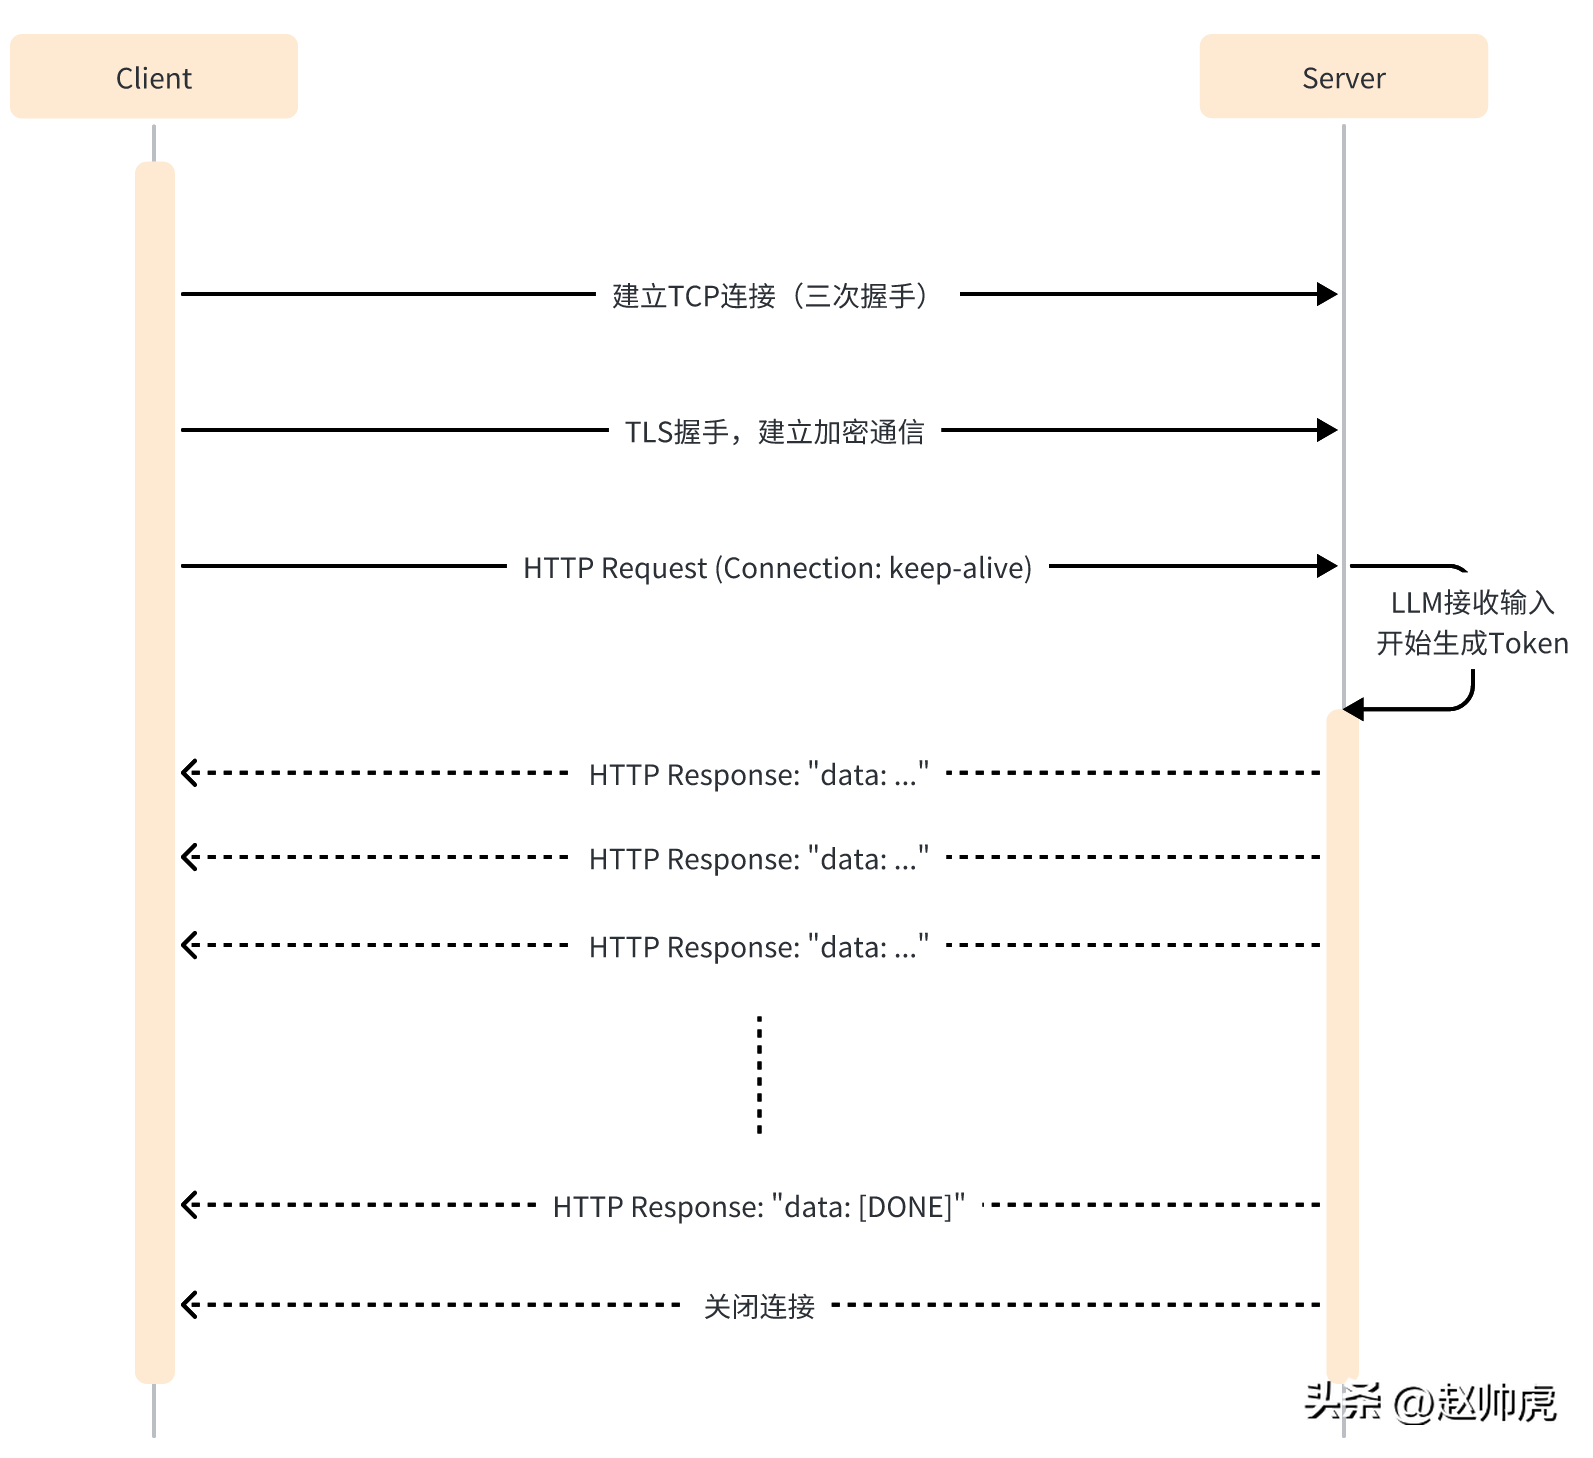
SSE仍然使用HTTP作为应用层传输协议,充分利用HTTP的长连接能力,实现服务端推送能力。
从代码层面来看,SSE模式与单次HTTP请求不同的点有:
- client端需要开启 keep-alive,保证连接不会超时。
- HTTP响应的Header包含 Content-Type=text/event-stream,Cache-Cnotallow=no-cache 等。
- HTTP响应的body一般是 "data: ..." 这样的结构。
- HTTP响应里可能有一些空数据,以避免连接超时。
以 ChatGPT API 为例,在发送请求时,将stream参数设置为true就启用了SSE特性,但在读取数据的SDK里需要稍加注意。
在常规模式下,拿到 http.Response 后,用 ioutil.ReadAll 将数据读出来即可,代码如下:
func main() {payload := strings.NewReader(`{"model": "gpt-3.5-turbo","messages": [{"role": "user", "content": "大语言生成式模型是如何工作的"}],"max_tokens": 1024,"temperature": 1,"top_p": 1,"n": 1,"stream": false}`)client := &http.Client{}req, _ := http.NewRequest("POST", "https://api.openai.com/v1/chat/completions", payload)req.Header.Add("Content-Type", "application/json")req.Header.Add("Authorization", "Bearer ")resp, err := client.Do(req)if err != nil {fmt.Println(err)return}defer resp.Body.Close()body, _ := ioutil.ReadAll(resp.Body)fmt.Println(string(body))} 执行大概耗费20s+,得到一个完整的结果:
{"id": "chatcmpl-7KklTf9mag5tyBXLEqM3PWQn4jlfD","object": "chat.completion","created": 1685180679,"model": "gpt-3.5-turbo-0301","usage": {"prompt_tokens": 21,"completion_tokens": 358,"total_tokens": 379},"choices": [{"message": {"role": "assistant","content": "大语言生成式模型通常采用神经网络来实现,具体工作流程如下:\n\n1. 数据预处理:将语料库中的文本数据进行预处理,包括分词、删除停用词(如“的”、“了”等常用词汇)、去重等操作,以减少冗余信息。\n\n2. 模型训练:采用递归神经网络(RNN)、长短期记忆网络(LSTM)或变种的Transformers等模型进行训练,这些模型都具有一定的记忆能力,可以学习到语言的一定规律,并预测下一个可能出现的词语。\n\n3. 模型应用:当模型完成训练后,可以将其应用于实际的生成任务中。模型接收一个输入文本串,并预测下一个可能出现的词语,直到达到一定长度或遇到结束符号为止。\n\n4. 根据生成结果对模型进行调优:生成的结果需要进行评估,如计算生成文本与语料库文本的相似度、流畅度等指标,以此来调优模型,提高其生成质量。\n\n总体而言,大语言生成式模型通过对语言的规律学习,从而生成高质量的文本。"},"finish_reason": "stop","index": 0}]}如果我们将 stream 设置为 true,不做任何修改,请求总消耗28s+,体现为很多条 stream 消息:
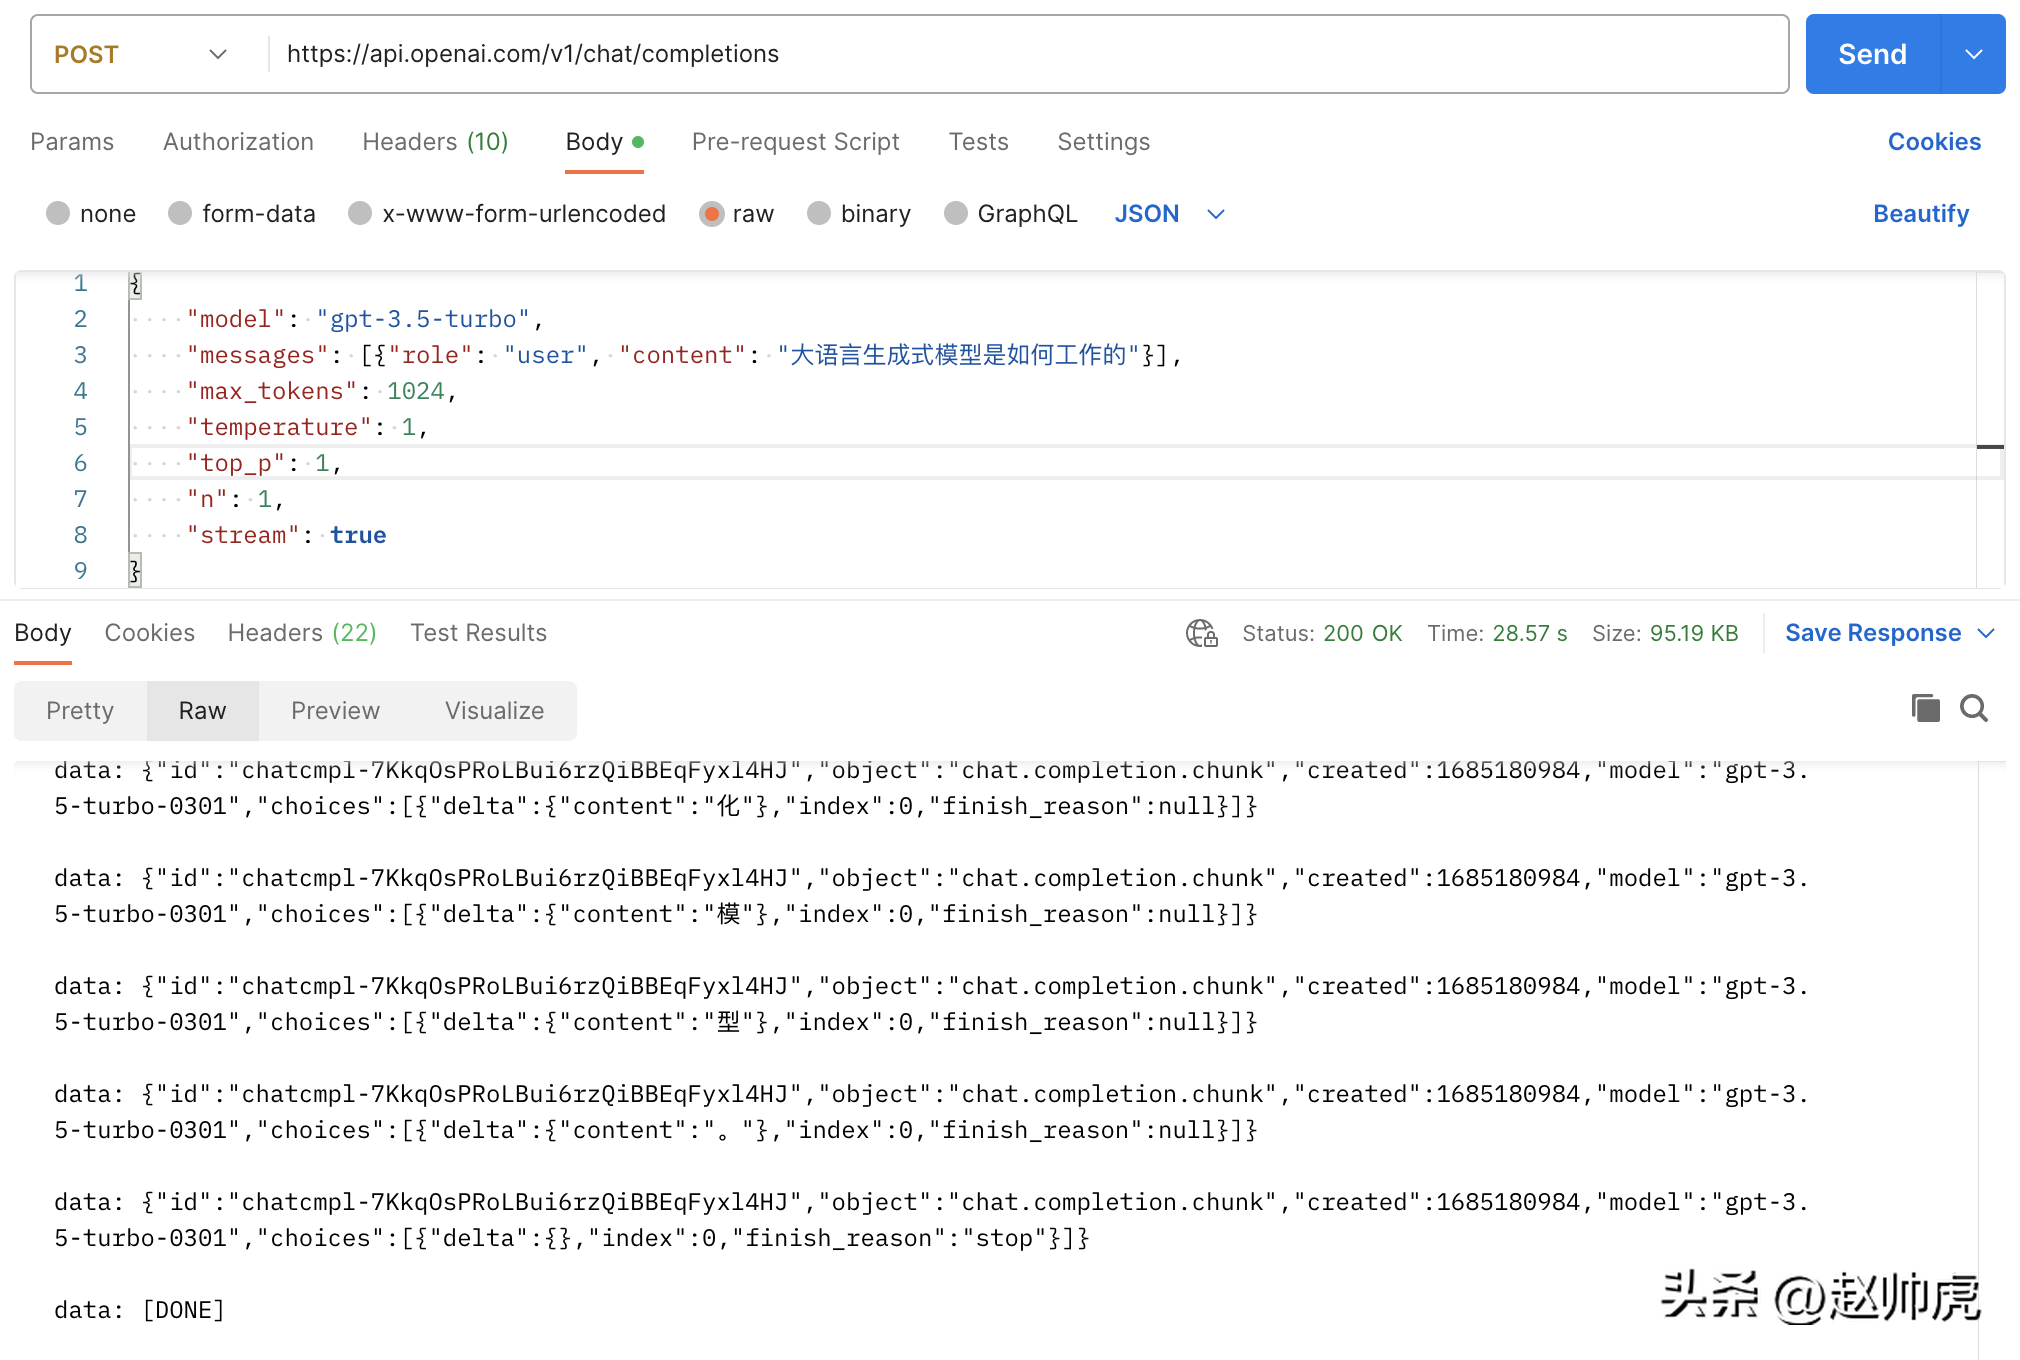
上面这张图是一张Postman调用 chatgpt api的图,走的就是 ioutil.ReadAll 的模式。为了实现stream读取,我们可以分段读取 http.Response.Body。下面是这种方式可行的原因:
- http.Response.Body 的类型是 io.ReaderCloser,底层依赖一个HTTP连接,支持stream读。
- SSE 返回的数据通过换行符\n进行分割
所以修正的方法是通过bufio.NewReader(resp.Body)包装起来,并在一个for-loop里读取, 代码如下:
// stream event 结构体定义type ChatCompletionRspChoiceItem struct {Deltamap[string]string `json:"delta,omitempty"` // 只有 content 字段Indexint `json:"index,omitempty"`Logprobs *int`json:"logprobs,omitempty"`FinishReason string`json:"finish_reason,omitempty"`}type ChatCompletionRsp struct {IDstring`json:"id"`Objectstring`json:"object"`Created int `json:"created"` // unix secondModel string`json:"model"`Choices []ChatCompletionRspChoiceItem `json:"choices"`}func main() {payload := strings.NewReader(`{"model": "gpt-3.5-turbo","messages": [{"role": "user", "content": "大语言生成式模型是如何工作的"}],"max_tokens": 1024,"temperature": 1,"top_p": 1,"n": 1,"stream": true}`)client := &http.Client{}req, _ := http.NewRequest("POST", "https://api.openai.com/v1/chat/completions", payload)req.Header.Add("Content-Type", "application/json")req.Header.Add("Authorization", "Bearer "+apiKey)req.Header.Set("Accept", "text/event-stream")req.Header.Set("Cache-Control", "no-cache")req.Header.Set("Connection", "keep-alive")resp, err := client.Do(req)if err != nil {fmt.Println(err)return}defer resp.Body.Close()reader := bufio.NewReader(resp.Body)for {line, err := reader.ReadBytes('\n')if err != nil {if err == io.EOF {// 忽略 EOF 错误break} else {if netErr, ok := err.(net.Error); ok && netErr.Timeout() {fmt.Printf("[PostStream] fails to read response body, timeout\n")} else {fmt.Printf("[PostStream] fails to read response body, err=%s\n", err)}}break}line = bytes.TrimSuffix(line, []byte{'\n'})line = bytes.TrimPrefix(line, []byte("data: "))if bytes.Equal(line, []byte("[DONE]")) {break} else if len(line) > 0 {var chatCompletionRsp ChatCompletionRspif err := json.Unmarshal(line, &chatCompletionRsp); err == nil {fmt.Printf(chatCompletionRsp.Choices[0].Delta["content"])} else {fmt.Printf("\ninvalid line=%s\n", line)}}}fmt.Println("the end")}看完client端,我们再看server端。现在我们尝试mock chatgpt server逐字返回一段文字。这里涉及到两个点:
- Response Header 需要设置 Connection 为 keep-alive 和 Content-Type 为 text/event-stream。
- 写入 respnose 以后,需要flush到client端。
代码如下:
func streamHandler(w http.ResponseWriter, req *http.Request) {w.Header().Set("Connection", "keep-alive")w.Header().Set("Content-Type", "text/event-stream")w.Header().Set("Cache-Control", "no-cache")var chatCompletionRsp ChatCompletionRsprunes := []rune(`大语言生成式模型通常使用深度学习技术,例如循环神经网络(RNN)或变压器(Transformer)来建模语言的概率分布。这些模型接收前面的词汇序列,并利用其内部神经网络结构预测下一个词汇的概率分布。然后,模型将概率最高的词汇作为生成的下一个词汇,并递归地生成一个词汇序列,直到到达最大长度或遇到一个终止符号。在训练过程中,模型通过最大化生成的文本样本的概率分布来学习有效的参数。为了避免模型产生过于平凡的、重复的、无意义的语言,我们通常会引入一些技巧,如dropout、序列扰动等。大语言生成模型的重要应用包括文本生成、问答系统、机器翻译、对话建模、摘要生成、文本分类等。`)for _, r := range runes {chatCompletionRsp.Choices = []ChatCompletionRspChoiceItem{{Delta: map[string]string{"content": string(r)}},}bs, _ := json.Marshal(chatCompletionRsp)line := fmt.Sprintf("data: %s\n", bs)fmt.Fprintf(w, line)if f, ok := w.(http.Flusher); ok {f.Flush()}time.Sleep(time.Millisecond * 100)}fmt.Fprintf(w, "data: [DONE]\n")}func main() {http.HandleFunc("/stream", streamHandler)http.ListenAndServe(":8088", nil)}在真实场景中,要返回的数据来源于另一个服务或函数调用,如果这个服务或函数调用返回时间不稳定,可能导致client端长时间收不到消息,所以一般的处理方式是:
- 对第三方的调用放到一个 goroutine 中。
- 通过 time.Tick 创建一个定时器,向client端发送空消息。
- 创建一个timeout channel,避免响应时间太久。
为了能够从不同的channel读取数据,select 是一个不错的关键字,比如这段演示代码:
// 声明一个 event channel// 声明一个 time.Tick channel// 声明一个 timeout channelselect {case ev := <-events:// send data eventcase <- timeTick:// send empty eventcase <-timeout:fmt.Fprintf(w, "[Done]\n\n")}小结一下
大语言模型生成响应整个结果的过程是比较漫长的,但逐token生成的响应比较快,ChatGPT将这一特性与SSE技术充分结合,一个字一个字地弹出回复,在用户体验上实现了质的提升。
纵观生成式模型,不管是LLAMA/小羊驼 (不能商用),还是Stable Diffusion/Midjourney。在提供线上服务时,均可利用SSE技术节省提升用户体验,节省服务器资源。
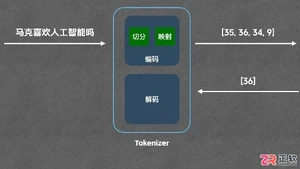
深入解析大模型中的Token与Tokenizer工作机制,通过BPE分词示例说明文字如何转化为数字编号,澄清上下文长度与字数的区别,帮助用户准确评估模型处理长文本的实际能力。
想了解更多AIGC的内容,请访问:51CTOAI.x社区https://www.51cto.com/aigc/本文介绍了如何使用简单的大语言模型(LLM)调用来显著改善语义搜索结果的质量。找到适合的AI模型来构建工作流程很困难。由于不同平台上有众多的模型可用,因此不可知道从哪里入手,或者如何找到最适合您特定需求的模型。这就是我打算用AIModels.fyi解决的问题,这是唯一用来发现和比较网上的AI模型的搜索引擎。该网站提供一个简单的前提:用自然语言描述问题,然后详细列出可能会解决问题的AI模型。比如说,
想了解更多AIGC的内容,请访问:51CTOAI.x社区https://www.51cto.com/aigc/本文将探讨大语言模型(LLMs)与网络抓取的集成,以及如何利用LLMs高效地将复杂的HTML转换为结构化的JSON。作为一名数据工程师,我的职业生涯可追溯至2016年。那时,我的主要职责是利用自动化工具从不同网站上获取海量数据,这个过程被称为“网络抓取”。网络抓取通常是从网站的HTML代码中提取所需数据。在构建相关应用程序时,我不得不深入研究HTML代码,努力寻找最佳的抓取解决方案。我所面临的主要
译者|布加迪审校|重楼在AI领域,科技巨头们一直在竞相构建越来越庞大的语言模型,如今出现了一个令人惊讶的新趋势:小就是大。随着大语言模型(LLM)方面的进展出现了停滞的迹象,研究人员和开发人员日益开始将注意力转向小语言模型(SLM)。这种紧凑、高效、适应性强的AI模型正在挑战“越大越好”这个观念,有望改变我们对待AI开发的方式。LLM是否开始停滞?Vellum和HuggingFace最近发布的性能比较结果表明,LLM之间的性能差距在迅速缩小。这个趋势在多项选择题、推理和数学问题等特定任务中体现得尤为明显;
大语言模型(LLMs)在语言理解和各种推理任务中展现出令人印象深刻的性能。然而,它们在人类认知的关键一面——空间推理上,仍然未被充分研究。人类具有通过一种被称为心灵之眼的过程创造看不见的物体和行为的心智图像的能力,从而使得对未见世界的想象成为可能。受到这种认知能力的启发,研究人员提出了“思维可视化”(VisualizationofThought,VoT)。VoT旨在通过可视化其推理迹象来引导LLMs的空间推理,从而引导后续的推理步骤。研究人员将VoT应用于多跳空间推理任务,包括自然语言导航、视觉导航以及二
译者|布加迪审校|重楼提示注入攻击是一种网络安全威胁,专门针对基于人工智能(AI)的系统,包括聊天机器人、虚拟助理及其他基于AI的界面。当攻击者以某种方式操纵AI模型的输入,导致模型执行意外操作或泄露敏感信息时,就会发生这类攻击。这种操纵可以诱骗AI将恶意输入解释为合法的命令或查询。随着消费者和组织使用大语言模型(LLM)的现象急剧增多,以及这些技术的功能日益完善,提示注入威胁大幅增加。开放Web应用程序安全项目(OWASP)向来专注于Web应用程序、移动应用程序和API的安全,如今该项目采取了一项引人注
谷歌近日发布新闻稿,宣布推出ASPIRE训练框架,专为大语言模型设计。该框架旨在提升AI模型的选择性预测能力。谷歌提到,当下大语言模型在自然语言理解和生成内容方面发展迅速,已被用于构建各种创新应用,但要应用于高风险决策类场合依然不妥。这是由于模型预测具有不确定性及“幻觉”可能,因此谷歌开发了一款ASPIRE训练框架,为系列模型引入了“可信度”机制,即——模型会输出一系列答案,每个答案都会具有正确概率评分。▲图源谷歌新闻稿(下同)在技术层面,该训练框架可划分为三个阶段:特定任务调整、答案采样和自我评估学习。
译者|布加迪审校|重楼大家都想利用生成式AI和大语言模型的力量,但这里有一个难题。让AI满足很高的期望需要高质量的实用数据,这正是许多组织的不足之处。麦肯锡最近一份由JoeCaserta和KayvaunRowshankish共同撰写的报告指出,许多组织要求用生成式AI做点什么。然而,这种压力伴随着其他问题:如果贵企业的数据还没有为生成式AI做好准备,贵企业也就没有为生成式AI做好准备。报告作者建议,IT和数据管理员需要对生成式AI的数据含义有一个清晰的认识。数据可能通过应用编程接口或企业自己的模型借助原先

作者|RahulPradhan来源|https://www.infoworld.com/article/3708254/addressing-ai-hallucinations-with-retrieval-augmented-generation.html人工智能有望成为当代最具影响力的技术。最近在transformer技术和生成式人工智能方面取得的进展已经展示了其大规模释放创新和独创性的潜力。然而,生成式人工智能并非没有挑战——这些挑战甚至可能会严重阻碍这一变革性技术的应用和价值创造。随着生成式人工智
解析宇树科技营收增长但净利下降的原因,说明一加Ace 7 Pro 185Hz高刷的具体适用场景,并厘清Gemini 4 Carbon在长任务与代码安全方面的开放范围,提供准确的数据阅读方法。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



