

MySQL使用ReplicationConnection导致连接失效怎么解决
引言MySQL数据库读写分离,是提高服务质量的常用手段之一,而对于技术方案,有很多成熟开源框架或方案,例如:sharding-jdbc、spring中的AbstractRoutingDatasource、MySQL-Router等,而mysql-jdbc中的ReplicationConnection亦可支持。本文暂不对读写分离的技术选型做过多的分析,只是探索在使用druid作为数据源、结合ReplicationConnection做读写分离时,连接失效的原因,并找到一个简单有效的解决方案。问题背景由于历史
引言
MySQL数据库读写分离,是提高服务质量的常用手段之一,而对于技术方案,有很多成熟开源框架或方案,例如:sharding-jdbc、spring中的AbstractRoutingDatasource、MySQL-Router等,而mysql-jdbc中的ReplicationConnection亦可支持。
本文暂不对读写分离的技术选型做过多的分析,只是探索在使用druid作为数据源、结合ReplicationConnection做读写分离时,连接失效的原因,并找到一个简单有效的解决方案。
问题背景
由于历史原因,某几个服务出现连接失效异常,关键报错如下:
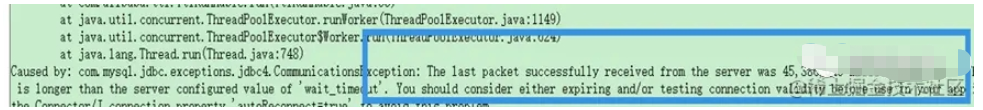
从日志不难看出,这是由于该连接长时间未和MySQL服务端交互,服务端已将连接关闭,典型的连接失效场景。
涉及的主要配置
jdbc配置
jdbc:mysql:replication://master_host:port,slave_host:port/database_name
druid配置
testWhileIdle=true(即,开启了空闲连接检查);
timeBetweenEvictionRunsMillis=6000L(即,对于获取连接的场景,如果某连接空闲时间超过1分钟,将会进行检查,如果连接无效,将抛弃后重新获取)。
附:DruidDataSource.getConnectionDirect中
处理逻辑如下:
if (testWhileIdle) {
    final DruidConnectionHolder holder = poolableConnection.holder;
    long currentTimeMillis             = System.currentTimeMillis();
    long lastActiveTimeMillis          = holder.lastActiveTimeMillis;
    long lastExecTimeMillis            = holder.lastExecTimeMillis;
    long lastKeepTimeMillis            = holder.lastKeepTimeMillis;
    if (checkExecuteTime
            && lastExecTimeMillis != lastActiveTimeMillis) {
        lastActiveTimeMillis = lastExecTimeMillis;
    }
    if (lastKeepTimeMillis > lastActiveTimeMillis) {
        lastActiveTimeMillis = lastKeepTimeMillis;
    }
    long idleMillis    = currentTimeMillis - lastActiveTimeMillis;
    long timeBetweenEvictionRunsMillis = this.timeBetweenEvictionRunsMillis;
    if (timeBetweenEvictionRunsMillis <= 0) {
        timeBetweenEvictionRunsMillis = DEFAULT_TIME_BETWEEN_EVICTION_RUNS_MILLIS;
    }
    if (idleMillis >= timeBetweenEvictionRunsMillis
            || idleMillis < 0 // unexcepted branch
            ) {
        boolean validate = testConnectionInternal(poolableConnection.holder, poolableConnection.conn);
        if (!validate) {
            if (LOG.isDebugEnabled()) {
                LOG.debug("skip not validate connection.");
            }
            discardConnection(poolableConnection.holder);
             continue;
        }
    }
}mysql超时参数配置wait_timeout=3600(3600秒,即:如果某连接超过一个小时和服务端没有交互,该连接将会被服务端kill)。 显而易见,基于如上配置,按照常规理解,不应该出现“The last packet successfully received from server was xxx,xxx,xxx milliseconds ago”的问题。(当然,当时也排除了人工介入kill掉数据库连接的可能)。
当“理所应当”的经验解释不了问题所在,往往需要跳出可能浮于表面经验束缚,来一次追根究底。那么,该问题的真正原因是什么呢?
本质原因
当使用druid管理数据源,结合mysql-jdbc中原生的ReplicationConnection做读写分离时,ReplicationConnection代理对象中实际存在master和slaves两套连接,druid在做连接检测时候,只能检测到其中的master连接,如果某个slave连接长时间未使用,会导致连接失效问题。
原因分析
mysql-jdbc中,数据库驱动对连接的处理过程
结合com.mysql.jdbc.Driver源码,不难看出mysql-jdbc中获取连接的主体流程如下:
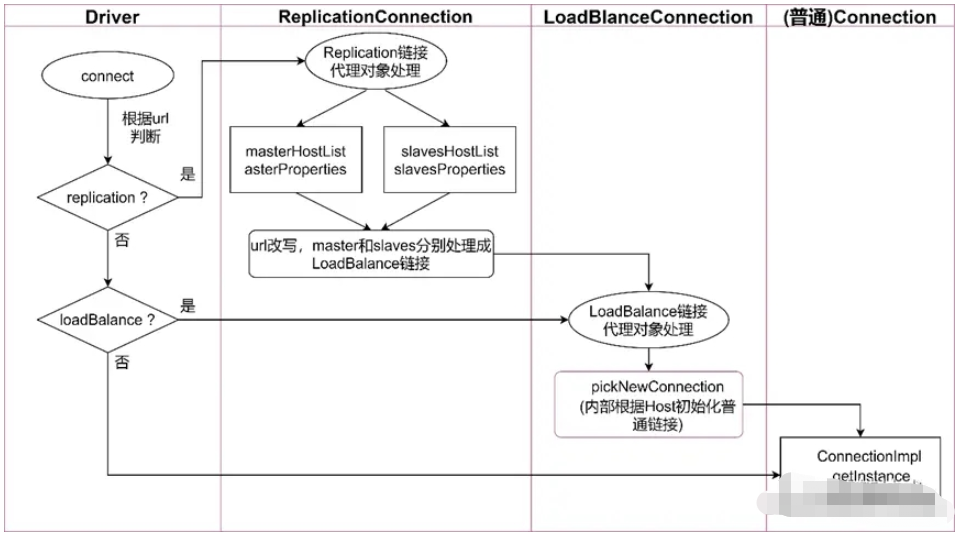
对于以“jdbc:mysql:replication://”开头配置的jdbc-url,通过mysql-jdbc获取到的连接,其实是一个ReplicationConnection的代理对象,默认情况下,“jdbc:mysql:replication://”后的第一个host和port对应master连接,其后的host和port对应slaves连接,而对于存在多个slave配置的场景,默认使用随机策略进行负载均衡。
ReplicationConnection代理对象,使用JDK动态代理生成的,其中InvocationHandler的具体实现,是ReplicationConnectionProxy,关键代码如下:
public static ReplicationConnection createProxyInstance(ListmasterHostList, Properties masterProperties, List slaveHostList, Properties slaveProperties) throws SQLException { ReplicationConnectionProxy connProxy = new ReplicationConnectionProxy(masterHostList, masterProperties, slaveHostList, slaveProperties); return (ReplicationConnection) java.lang.reflect.Proxy.newProxyInstance(ReplicationConnection.class.getClassLoader(), INTERFACES_TO_PROXY, connProxy); }
ReplicationConnectionProxy的重要组成
关于数据库连接代理,ReplicationConnectionProxy中的主要组成如下图:
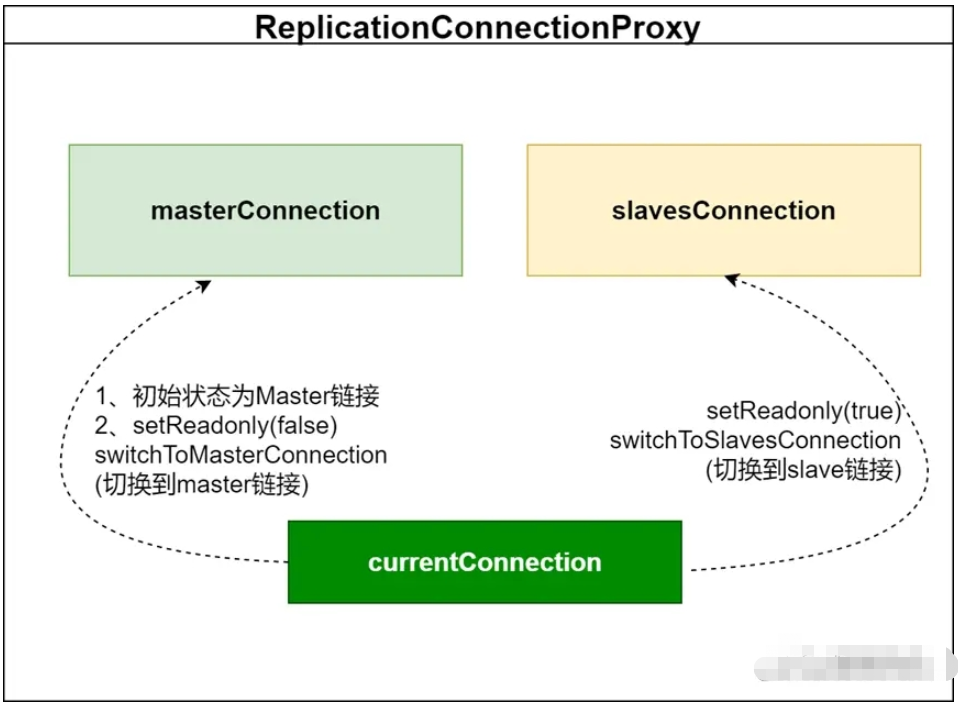
ReplicationConnectionProxy存在masterConnection和slavesConnection两个实际连接对象,currentConnetion(当前连接)可以切换成mastetConnection或者slavesConnection,切换方式可以通过设置readOnly实现。
业务逻辑中,实现读写分离的核心也在于此,简单来说:使用ReplicationConnection做读写分离时,只要做一个“设置connection的readOnly属性的”aop即可。
基于ReplicationConnectionProxy,业务逻辑中获取到的Connection代理对象,数据库访问时的主要逻辑是什么样的呢?
ReplicationConnection代理对象处理过程
对于业务逻辑而言,获取到的Connection实例,是ReplicationConnection代理对象,该代理对象通过ReplicationConnectionProxy和ReplicationMySQLConnection相互协同完成对数据库访问的处理,其中ReplicationConnectionProxy在实现 InvocationHandler的同时,还充当对连接管理的角色,核心逻辑如下图:
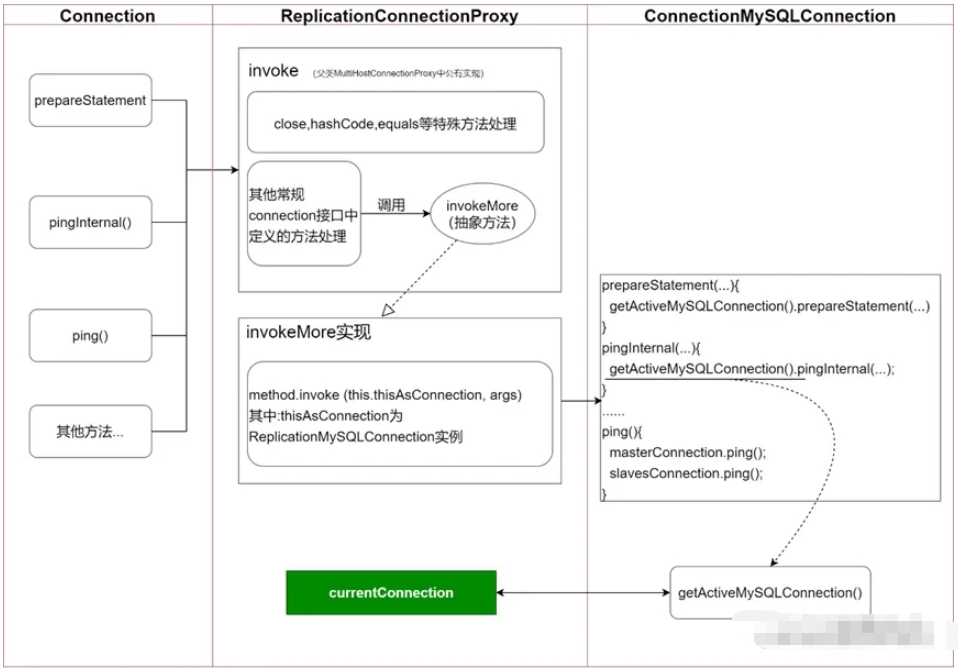
对于prepareStatement等常规逻辑,ConnectionMySQConnection获取到当前连接进行处理(普通的读写分离的处理的重点正是在此);此时,重点提及pingInternal方法,其处理方式也是获取当前连接,然后执行pingInternal逻辑。
对于ping()这个特殊逻辑,图中描述相对简单,但主体含义不变,即:对master连接和sleves连接都要进行ping()的处理。
图中,pingInternal流程和druid的MySQ连接检查有关,而ping的特殊处理,也正是解决问题的关键。
druid数据源对MySQ连接的检查
druid中对MySQL连接检查的默认实现类是MySqlValidConnectionChecker,其中核心逻辑如下:
public boolean isValidConnection(Connection conn, String validateQuery, int validationQueryTimeout) throws Exception {
    if (conn.isClosed()) {
        return false;
    }
    if (usePingMethod) {
        if (conn instanceof DruidPooledConnection) {
            conn = ((DruidPooledConnection) conn).getConnection();
        }
        if (conn instanceof ConnectionProxy) {
            conn = ((ConnectionProxy) conn).getRawObject();
        }
        if (clazz.isAssignableFrom(conn.getClass())) {
            if (validationQueryTimeout <= 0) {
                validationQueryTimeout = DEFAULT_VALIDATION_QUERY_TIMEOUT;
            }
            try {
                ping.invoke(conn, true, validationQueryTimeout * 1000);
            } catch (InvocationTargetException e) {
                Throwable cause = e.getCause();
                if (cause instanceof SQLException) {
                    throw (SQLException) cause;
                }
                throw e;
            }
            return true;
        }
    }
    String query = validateQuery;
    if (validateQuery == null || validateQuery.isEmpty()) {
        query = DEFAULT_VALIDATION_QUERY;
    }
    Statement stmt = null;
    ResultSet rs = null;
    try {
        stmt = conn.createStatement();
        if (validationQueryTimeout > 0) {
            stmt.setQueryTimeout(validationQueryTimeout);
        }
        rs = stmt.executeQuery(query);
        return true;
    } finally {
        JdbcUtils.close(rs);
        JdbcUtils.close(stmt);
    }
}
对应服务中使用的mysql-jdbc(5.1.45版),在未设置“druid.mysql.usePingMethod”系统属性的情况下,默认usePingMethod为true,如下:
public MySqlValidConnectionChecker(){
try {
        clazz = Utils.loadClass("com.mysql.jdbc.MySQLConnection");
        if (clazz == null) {
            clazz = Utils.loadClass("com.mysql.cj.jdbc.ConnectionImpl");
        }
        if (clazz != null) {
            ping = clazz.getMethod("pingInternal", boolean.class, int.class);
        }
        if (ping != null) {
            usePingMethod = true;
        }
    } catch (Exception e) {
        LOG.warn("Cannot resolve com.mysql.jdbc.Connection.ping method.  Will use 'SELECT 1' instead.", e);
    }
    configFromProperties(System.getProperties());
}
@Override
public void configFromProperties(Properties properties) {
    String property = properties.getProperty("druid.mysql.usePingMethod");
    if ("true".equals(property)) {
        setUsePingMethod(true);
    } else if ("false".equals(property)) {
        setUsePingMethod(false);
    }
}
同时,可以看出MySqlValidConnectionChecker中的ping方法使用的是MySQLConnection中的pingInternal方法,而该方法,结合上面对ReplicationConnection的分析,当调用pingInternal时,只是对当前连接进行检验。执行检验连接的时机是通过DrduiDatasource获取连接时,此时未设置readOnly属性,检查的连接,其实只是ReplicationConnectionProxy中的master连接。
此外,如果通过“druid.mysql.usePingMethod”属性设置usePingMeghod为false,其实也会导致连接失效的问题,因为:当通过valideQuery(例如“select 1”)进行连接校验时,会走到ReplicationConnection中的普通查询逻辑,此时对应的连接依然是master连接。
题外一问:ping方法为什么使用“pingInternal”,而不是常规的ping?
原因:pingInternal预留了超时时间等控制参数。
解决方式
调整依赖版本
服务中使用的mysql-jdbc版本为5.1.45,druid版本为1.1.20。经过对其他高版本依赖的了解,依然存在该问题。
修改读写分离实现
修改的工作量主要在于数据源配置和aop调整,但需要一定的整体回归验证成本,鉴于涉及该问题的服务重要性一般,暂不做大调整。
拓展mysql-jdbc驱动
基于原有ReplicationConnection的功能,拓展pingInternal调整为普通的ping,集成原有Driver拓展新的Driver。方案可行,但修改成本不算小。
基于druid,拓展MySQL连接检查
为简单高效解决问题,选择拓展MySqlValidConnectionChecker,并在druid数据源中加上对应配置即可。拓展如下:
public class MySqlReplicationCompatibleValidConnectionChecker extends MySqlValidConnectionChecker {
    private static final Log LOG = LogFactory.getLog(MySqlValidConnectionChecker.class);
    /**
     *
     */
    private static final long serialVersionUID = 1L;
    @Override
    public boolean isValidConnection(Connection conn, String validateQuery, int validationQueryTimeout) throws Exception {
        if (conn.isClosed()) {
            return false;
        }
        if (conn instanceof DruidPooledConnection) {
            conn = ((DruidPooledConnection) conn).getConnection();
        }
        if (conn instanceof ConnectionProxy) {
            conn = ((ConnectionProxy) conn).getRawObject();
        }
        if (conn instanceof ReplicationConnection) {
            try {
                ((ReplicationConnection) conn).ping();
                LOG.info("validate connection success: connection=" + conn.toString());
                return true;
            } catch (SQLException e) {
                LOG.error("validate connection error: connection=" + conn.toString(), e);
                throw e;
            }
        }
        return super.isValidConnection(conn, validateQuery, validationQueryTimeout);
    }
}
ReplicatoinConnection.ping()的实现逻辑中,会对所有master和slaves连接进行ping操作,最终每个ping操作都会调用到LoadBalancedConnectionProxy.doPing进行处理,而此处,可在数据库配置url中设置loadBalancePingTimeout属性设置超时时间。

详解Navicat导入数据库的标准步骤,涵盖SQL脚本执行与CSV数据导入两种核心场景。针对导入过程中常见的字符集乱码、主键冲突及外键约束错误,提供具体的设置方法与修复建议,确保数据迁移准确无误。

深入理解SQL PRIMARY KEY与UNIQUE约束的区别。文章从行标识与重复限制的目标出发,详解主键的非空特性、外键引用角色以及多数据库对NULL值的处理差异。结合users表实战示例,指导开发者如何根据字段稳定性与业务语义合理选择约束类型,避免设计误区。

刚开始设计关系型数据库?了解PRIMARY KEY、FOREIGN KEY、UNIQUE、NOT NULL、CHECK、DEFAULT等约束的作用、语法和排错方法。本文以PostgreSQL语法为主,结合用户订单场景,清晰展示如何防止脏数据并处理常见约束冲突。

深入解析SQL游标导致的死锁与资源未释放问题。通过PostgreSQL与MySQL语法对比,展示如何识别长事务持锁、分析锁等待链,并提供短事务提交、异常清理及批量处理的最佳实践,确保数据库连接与锁资源及时释放。

后端开发者在维护数据库时,常需对现有表添加主键、唯一或外键约束。若直接执行ADD CONSTRAINT,往往因存量数据不合规导致报错。本文详解操作前的数据清洗步骤、标准SQL语法及MySQL等特殊写法,帮助你在生产环境安全完成结构变更。

针对 SQL 初学者的分组统计实战指南。深入解析 GROUP BY 分组机制、WHERE 与 HAVING 的执行时机差异,以及 COUNT 函数对 NULL 值的处理逻辑。通过具体代码示例演示如何正确筛选聚合结果,并排查因 JOIN 连接导致的统计数据异常,提升报表准确性。

本文详细对比SQL Server和MySQL中游标的基本用法。从DECLARE声明到FETCH遍历,再到CLOSE关闭与DEALLOCATE/Handler清理,解析两者在语法结构、变量接收及异常处理上的核心差异。通过标准代码示例展示如何安全使用游标,避免资源泄漏,适用于需要进行数据库存储过程开发或跨平台迁移的开发者。
深入解析SQL中INNER JOIN与LEFT JOIN的核心区别。通过users和orders表实例,展示匹配行保留与NULL补位机制,重点讲解ON与WHERE子句中放置右表过滤条件的不同后果,提供防止LEFT JOIN退化的实战技巧及行数异常排查步骤。
深入理解 SQL CHECK 约束在 PostgreSQL、MySQL 等数据库中的实现差异。文章通过订单业务场景,讲解如何定义单列范围与多列逻辑约束,分析 NULL 值对布尔条件的影响,并提供修改已有表结构时的安全操作建议,帮助开发者构建更健壮的数据完整性防线。
后端开发中,如何正确使用 SQL 外键约束来维护订单与明细表的关系?本文通过 PostgreSQL 示例,深入讲解外键的创建语法、插入顺序要求,以及 ON DELETE CASCADE、RESTRICT、SET NULL 等策略的实际影响与风险控制,助你构建健壮的数据库结构。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



