

使用Python进行数据清洗的完整指南
你一定听说过这句著名的数据科学名言:在数据科学项目中,80%的时间是在做数据处理。如果你没有听过,那么请记住:数据清洗是数据科学工作流程的基础。机器学习模型会根据你提供的数据执行,混乱的数据会导致性能下降甚至错误的结果,而干净的数据是良好模型性能的先决条件。当然干净的数据并不意味着一直都有好的性能,模型的正确选择(剩余20%)也很重要,但是没有干净的数据,即使是再强大的模型也无法达到预期的水平。在本文中将列出数据清洗中需要解决的问题并展示可能的解决方案,通过本文可以了解如何逐步进行数据清洗。缺失
你一定听说过这句著名的数据科学名言:
在数据科学项目中, 80% 的时间是在做数据处理。
如果你没有听过,那么请记住:数据清洗是数据科学工作流程的基础。 机器学习模型会根据你提供的数据执行,混乱的数据会导致性能下降甚至错误的结果,而干净的数据是良好模型性能的先决条件。 当然干净的数据并不意味着一直都有好的性能,模型的正确选择(剩余 20%)也很重要,但是没有干净的数据,即使是再强大的模型也无法达到预期的水平。
在本文中将列出数据清洗中需要解决的问题并展示可能的解决方案,通过本文可以了解如何逐步进行数据清洗。
缺失值
当数据集中包含缺失数据时,在填充之前可以先进行一些数据的分析。 因为空单元格本身的位置可以告诉我们一些有用的信息。 例如:
- NA值仅在数据集的尾部或中间出现。 这意味着在数据收集过程中可能存在技术问题。 可能需要分析该特定样本序列的数据收集过程,并尝试找出问题的根源。
- 如果列NA数量超过 70–80%,可以删除该列。
- 如果 NA 值在表单中作为可选问题的列中,则该列可以被额外的编码为用户回答(1)或未回答(0)。
missingno这个python库就可以用于检查上述情况,并且使用起来非常的简单,例如下图中的白线是 NA:
import missingno as msno
msno.matrix(df)
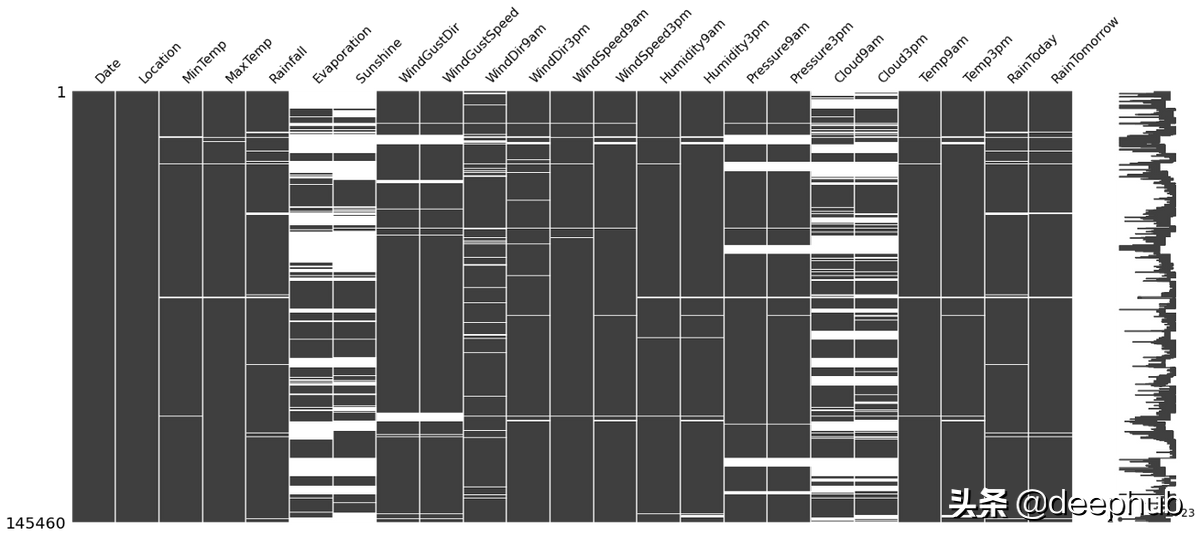
对于缺失值的填补计算有很多方法,例如:
- 平均,中位数,众数
- kNN
- 零或常数等
不同的方法相互之间有优势和不足,并且没有适用于所有情况的“最佳”技术。具体可以参考我们以前发布的文章
异常值
异常值是相对于数据集的其他点而言非常大或非常小的值。 它们的存在极大地影响了数学模型的性能。 让我们看一下这个简单的示例:
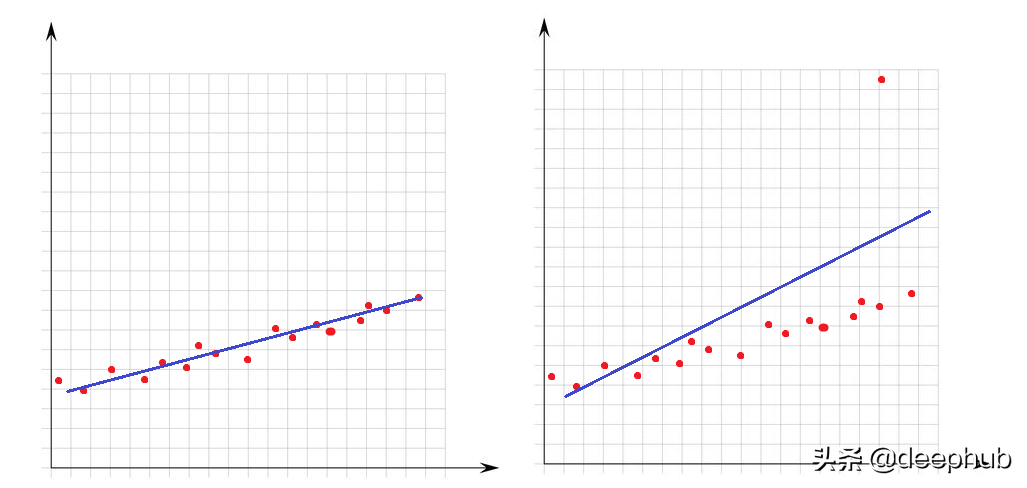
在左图中没有异常值,我们的线性模型非常适合数据点。 在右图中有一个异常值,当模型试图覆盖数据集的所有点时,这个异常值的存在会改变模型的拟合方式,并且使我们的模型不适合至少一半的点。
对于异常值来说我们有必要介绍一下如何确定异常,这就要从数学角度明确什么是极大或极小。
大于Q3+1.5 x IQR或小于Q1-1.5 x IQR都可以作为异常值。 IQR(四分位距) 是 Q3 和 Q1 之间的差 (IQR = Q3-Q1)。
可以使用下面函数来检查数据集中异常值的数量:
def number_of_outliers(df):

df = df.select_dtypes(exclude = 'object')

Q1 = df.quantile(0.25)
Q3 = df.quantile(0.75)
IQR = Q3 - Q1

return ((df < (Q1 - 1.5 * IQR)) | (df > (Q3 + 1.5 * IQR))).sum()
处理异常值的一种方法是可以让它们等于 Q3 或 Q1。 下面的lower_upper_range 函数使用 pandas 和 numpy 库查找其外部为异常值的范围, 然后使用clip 函数将值裁剪到指定的范围。
def lower_upper_range(datacolumn):
sorted(datacolumn)
Q1,Q3 = np.percentile(datacolumn , [25,75])
IQR = Q3 - Q1
lower_range = Q1 - (1.5 * IQR)
upper_range = Q3 + (1.5 * IQR)
return lower_range,upper_range

for col in columns:
lowerbound,upperbound = lower_upper_range(df[col])
df[col]=np.clip(df[col],a_min=lowerbound,a_max=upperbound)
数据不一致
异常值问题是关于数字特征的,现在让我们看看字符类型(分类)特征。 数据不一致意味着列的唯一类具有不同的表示形式。 例如在性别栏中,既有m/f,又有male/female。在这种情况下,就会有4个类,但实际上有两类。
这种问题目前没有自动处理的办法,所以需要手动进行分析。 pandas 的unique函数就是为了这个分析准备的,下面看一个汽车品牌的例子:
df['CarName'] = df['CarName'].str.split().str[0]
print(df['CarName'].unique())
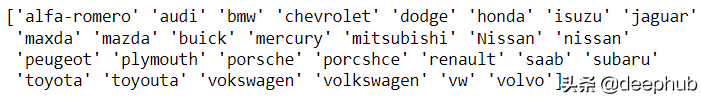
maxda-mazda, Nissan-nissan, porcshce-porsche, toyouta-toyota等都可以进行合并。
df.loc[df['CarName'] == 'maxda', 'CarName'] = 'mazda'
df.loc[df['CarName'] == 'Nissan', 'CarName'] = 'nissan'
df.loc[df['CarName'] == 'porcshce', 'CarName'] = 'porsche'
df.loc[df['CarName'] == 'toyouta', 'CarName'] = 'toyota'
df.loc[df['CarName'] == 'vokswagen', 'CarName'] = 'volkswagen'
df.loc[df['CarName'] == 'vw', 'CarName'] = 'volkswagen'
无效数据
无效的数据表示在逻辑上根本不正确的值。 例如,
- 某人的年龄是 560;
- 某个操作花费了 -8 小时;
- 一个人的身高是1200 cm等;
对于数值列,pandas的 describe 函数可用于识别此类错误:
df.describe()
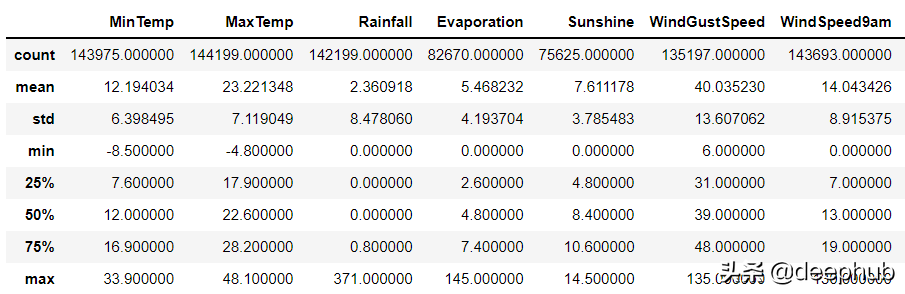
无效数据的产生原因可能有两种:
1、数据收集错误:例如在输入时没有进行范围的判断,在输入身高时错误的输入了1799cm 而不是 179cm,但是程序没有对数据的范围进行判断。
2、数据操作错误
数据集的某些列可能通过了一些函数的处理。 例如,一个函数根据生日计算年龄,但是这个函数出现了BUG导致输出不正确。
以上两种随机错误都可以被视为空值并与其他 NA 一起估算。
重复数据
当数据集中有相同的行时就会产生重复数据问题。 这可能是由于数据组合错误(来自多个来源的同一行),或者重复的操作(用户可能会提交他或她的答案两次)等引起的。 处理该问题的理想方法是删除复制行。
可以使用 pandas duplicated 函数查看重复的数据:
df.loc[df.duplicated()]
在识别出重复的数据后可以使用pandas 的 drop_duplicate 函数将其删除:
df.drop_duplicates()
数据泄漏问题
在构建模型之前,数据集被分成训练集和测试集。 测试集是看不见的数据用于评估模型性能。 如果在数据清洗或数据预处理步骤中模型以某种方式“看到”了测试集,这个就被称做数据泄漏(data leakage)。 所以应该在清洗和预处理步骤之前拆分数据:
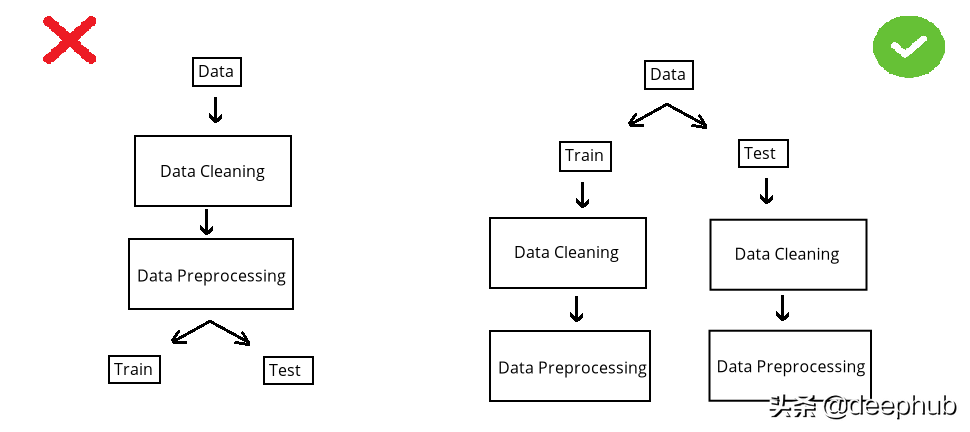
以选择缺失值插补为例。数值列中有 NA,采用均值法估算。在 split 前完成时,使用整个数据集的均值,但如果在 split 后完成,则使用分别训练和测试的均值。
第一种情况的问题是,测试集中的推算值将与训练集相关,因为平均值是整个数据集的。所以当模型用训练集构建时,它也会“看到”测试集。但是我们拆分的目标是保持测试集完全独立,并像使用新数据一样使用它来进行性能评估。所以在操作之前必须拆分数据集。
虽然训练集和测试集分别处理效率不高(因为相同的操作需要进行2次),但它可能是正确的。因为数据泄露问题非常重要,为了解决代码重复编写的问题,可以使用sklearn 库的pipeline。简单地说,pipeline就是将数据作为输入发送到的所有操作步骤的组合,这样我们只要设定好操作,无论是训练集还是测试集,都可以使用相同的步骤进行处理,减少的代码开发的同时还可以减少出错的概率。

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



