

MySQL如何给字符串字段加索引
假设,你现在维护一个支持邮箱登录的系统,用户表是这么定义的:createtableSUser(IDbigintunsignedprimarykey,emailvarchar(64),...)engine=innodb;由于要使用邮箱登录,所以业务代码中一定会出现类似于这样的语句:selectf1,f2fromSUserwhereemail='xxx';如果email这个字段上没有索引,那么这个语句就只能做全表扫描。1)那我可以在邮箱地址这个字段上面建索引吗?MySQL是支持前缀索引的,可以
假设,你现在维护一个支持邮箱登录的系统,用户表是这么定义的:
create table SUser(
 ID bigint unsigned primary key,
 email varchar(64),
 ...
 )engine=innodb;
由于要使用邮箱登录,所以业务代码中一定会出现类似于这样的语句:
select f1, f2 from SUser where email='xxx';
如果 email 这个字段上没有索引,那么这个语句就只能做全表扫描。
1)那我可以在邮箱地址这个字段上面建索引吗?
MySQL 是支持前缀索引的,可以定义字符串的一部分作为索引
2)如果创建索引的语句不指定前缀长度,那么会怎么样?
索引就会包含整个字符串
3)能举例来说明一下吗?
alter table SUser add index index1(email);
 或
 alter table SUser add index index2(email(6));
index1 索引里面,包含了每个记录的整个字符串
index2 索引里面,对于每个记录都是只取前 6 个字节
4)这两种不同的定义在数据结构和存储上有什么区别呢?
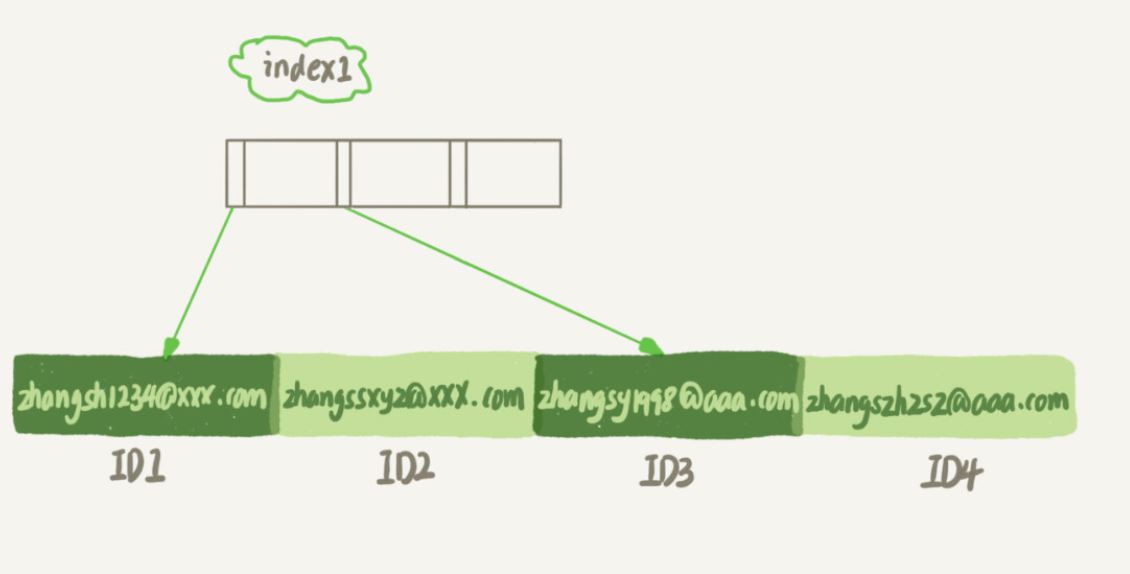
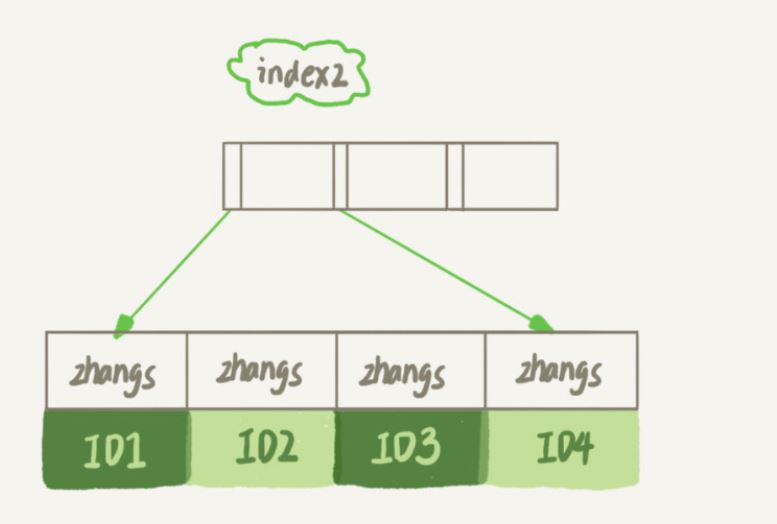
明显看出email(6) 这个索引结构占用的空间会更小
5)email(6) 这个索引结构有什么缺点吗?
可能会增加额外的记录扫描次数
6)下面这个语句,在这两个索引定义下分别是怎么执行的?
select id,name,email from SUser where email='zhangssxyz@xxx.com';
index1(即 email 整个字符串的索引结构),执行顺序
从 index1 索引树找到满足索引值是’zhangssxyz@xxx.com’的这条记录,取得 ID2 的值;
回表查到主键值是 ID2 的行,判断 email 的值是正确的,将这行记录加入结果集;
继续在index索引树的下一条记录,发现已经不满足 email='zhangssxyz@xxx.com’的条件了,循环结束。
这个过程中,只需要回主键索引取一次数据,所以系统认为只扫描了一行。
index2(即 email(6) 索引结构),执行顺序
从 index2 索引树找到满足索引值是’zhangs’的记录,找到的第一个是 ID1;
到主键上查到主键值是 ID1 的行,判断出 email 的值不是’zhangssxyz@xxx.com’,这行记录丢弃;
取 index2 上刚刚查到的位置的下一条记录,发现仍然是’zhangs’,取出 ID2,再到 ID 索引上取整行然后判断,这次值对了,将这行记录加入结果集;
重复上一步,直到在 idxe2 上取到的值不是’zhangs’时,循环结束。
在这个过程中,要回主键索引取 4 次数据,也就是扫描了 4 行。
7)通过上面的对比,能得出什么结论?
使用前缀索引后,可能会导致查询语句读数据的次数变多。
8)前缀索引真的一无是处吗?
如果我们定义的 index2 不是 email(6) 而是 email(7),那满足前缀’zhangss’的记录只有一个,直接就查到 ID2了,只扫描一行就结束了。
9)那么使用前缀索引有哪些注意事项?
长度选择合理
10)当要给字符串创建前缀索引时,我咋知道我该用多长的前缀索引呢?
统计索引上有多少个不同的值来判断要使用多长的前缀。
11)怎样统计索引上有多少个不同的值?
select count(distinct email) as L from SUser;
12)拿到了索引对应的有多少个不同的值之后下一步该做什么?
依次选取不同长度的前缀来看这个值
select
   count(distinct left(email,4))as L4,
   count(distinct left(email,5))as L5,
   count(distinct left(email,6))as L6,
   count(distinct left(email,7))as L7,
 from SUser;
然后,在 L4~L7 中,找出第一个不小于 L * 95% 的值,说明通过这个索引可以找出百分之95以上的数据。
13)前缀索引对覆盖索引的影响是什么?
下面这个 SQL 语句:
select id,email from SUser where email='zhangssxyz@xxx.com';
与前面例子中的 SQL 语句
select id,name,email from SUser where email='zhangssxyz@xxx.com';
相比,第一个语句只要求返回 id 和 email 字段。
如果使用 index1(即 email 整个字符串的索引结构)的话,查email的话就能得到ID,那就不用回表了,这个就是覆盖索引。
用 index2(即 email(6) 索引结构)的话,就不得不回到 ID 索引再去判断 email 字段的值。
14)那我把index2 的定义修改为 email(18) 的前缀索引不就行了?
这个18是你自己定义的,系统不知道18这个长度是否已经大于我的email长度,所以它还是会回表去查一下验证。
总而言之:使用前缀索引就用不上覆盖索引对查询性能的优化了
15)对于类似于邮箱这样的字段来说,使用前缀索引的效果可能还不错。但是,遇到身份证这种前缀的区分度不够好的情况时,我们要怎么办呢?
索引选取的要更长一些。
但是所以越长的话,占的磁盘空间更大,相同的一页能放下的索引值就变少了,反而会影响查询效率。
16)如果我们能够确定业务需求里面只有按照身份证进行等值查询的需求,还有没有别的处理方法呢?
既然正过来相同的多,那我就把它倒过来存。查询时候这样查
select field_list from t where id_card = reverse('input_id_card_string');使用 的时候用count(distinct) 方法去做个验证
使用 hash 字段。在表上再创建一个整数字段,来保存身份证的校验码,同时在这个字段上创建索引。
alter table t add id_card_crc int unsigned, add index(id_card_crc);
每次插入新记录的时候,都同时用 crc32() 这个函数得到校验码填到这个新字段。由于校验码可能存在冲突,也就是说两个不同的身份证号通过 crc32() 函数得到的结果可能是相同的,所以你的查询语句 where 部分要判断 id_card 的值是否精确相同。
select field_list from t where id_card_crc=crc32('input_id_card_string') and id_card='input_id_card_string'这样,索引的长度变成了 4 个字节(int类型),比原来小了很多
17)使用倒序存储和使用 hash 字段这两种方法有什么异同点?
相同点:都不支持范围查询
倒序存储的字段上创建的索引是按照倒序字符串的方式排序的,已经没有办法利用索引方式查出身份证号码在[ID_X, ID_Y]的所有市民了。同样地,hash 字段的方式也只能支持等值查询。
区别
从占用的额外空间来看,倒序存储方式在主键索引上,不会消耗额外的存储空间,而 hash 字段方法需要增加一个字段。当然,倒序存储方式使用 4 个字节的前缀长度应该是不够的,如果再长一点,这个消耗跟额外这个 hash 字段也差不多抵消了。
在 CPU 消耗方面,倒序方式每次写和读的时候,都需要额外调用一次 reverse 函数,而 hash 字段的方式需要额外调用一次 crc32() 函数。如果只从这两个函数的计算复杂度来看的话,reverse 函数额外消耗的 CPU 资源会更小些。
从查询效率上看,使用 hash 字段方式的查询性能相对更稳定一些。因为 crc32 算出来的值虽然有冲突的概率,但是概率非常小,可以认为每次查询的平均扫描行数接近 1。而倒序存储方式毕竟还是用的前缀索引的方式,也就是说还是会增加扫描行数。
案例:如果你在维护一个学校的学生信息数据库,学生登录名的统一格式是”学号 @gmail.com", 而学号的规则是:十五位的数字,其中前三位是所在城市编号、第四到第六位是学校编号、第七位到第十位是入学年份、最后五位是顺序编号。
18)系统登录的时候都需要学生输入登录名和密码,验证正确后才能继续使用系统。就只考虑登录验证这个行为的话,你会怎么设计这个登录名的索引呢?
一个学校每年预估2万新生,50年才100万记录,能节省多少空间,直接全字段索引。省去了开发转换及局限性风险,碰到超大量迫不得已再用后两种办法
实际操作上直接全字段索引就行了,一个学校数据库的数据量和查询压力都不会大到哪儿去。 如果单从优化数据表的角度: \1. 后缀@gmail可以单独一个字段来存,或者用业务代码来保证, \2. 城市编号和学校编号估计也不会变,也可以用业务代码来配置 \3. 然后直接存年份和顺序编号就行了,这个字段可以全字段索引

详解Navicat导入数据库的标准步骤,涵盖SQL脚本执行与CSV数据导入两种核心场景。针对导入过程中常见的字符集乱码、主键冲突及外键约束错误,提供具体的设置方法与修复建议,确保数据迁移准确无误。

深入理解SQL PRIMARY KEY与UNIQUE约束的区别。文章从行标识与重复限制的目标出发,详解主键的非空特性、外键引用角色以及多数据库对NULL值的处理差异。结合users表实战示例,指导开发者如何根据字段稳定性与业务语义合理选择约束类型,避免设计误区。

刚开始设计关系型数据库?了解PRIMARY KEY、FOREIGN KEY、UNIQUE、NOT NULL、CHECK、DEFAULT等约束的作用、语法和排错方法。本文以PostgreSQL语法为主,结合用户订单场景,清晰展示如何防止脏数据并处理常见约束冲突。

深入解析SQL游标导致的死锁与资源未释放问题。通过PostgreSQL与MySQL语法对比,展示如何识别长事务持锁、分析锁等待链,并提供短事务提交、异常清理及批量处理的最佳实践,确保数据库连接与锁资源及时释放。

后端开发者在维护数据库时,常需对现有表添加主键、唯一或外键约束。若直接执行ADD CONSTRAINT,往往因存量数据不合规导致报错。本文详解操作前的数据清洗步骤、标准SQL语法及MySQL等特殊写法,帮助你在生产环境安全完成结构变更。

针对 SQL 初学者的分组统计实战指南。深入解析 GROUP BY 分组机制、WHERE 与 HAVING 的执行时机差异,以及 COUNT 函数对 NULL 值的处理逻辑。通过具体代码示例演示如何正确筛选聚合结果,并排查因 JOIN 连接导致的统计数据异常,提升报表准确性。

本文详细对比SQL Server和MySQL中游标的基本用法。从DECLARE声明到FETCH遍历,再到CLOSE关闭与DEALLOCATE/Handler清理,解析两者在语法结构、变量接收及异常处理上的核心差异。通过标准代码示例展示如何安全使用游标,避免资源泄漏,适用于需要进行数据库存储过程开发或跨平台迁移的开发者。
深入解析SQL中INNER JOIN与LEFT JOIN的核心区别。通过users和orders表实例,展示匹配行保留与NULL补位机制,重点讲解ON与WHERE子句中放置右表过滤条件的不同后果,提供防止LEFT JOIN退化的实战技巧及行数异常排查步骤。
深入理解 SQL CHECK 约束在 PostgreSQL、MySQL 等数据库中的实现差异。文章通过订单业务场景,讲解如何定义单列范围与多列逻辑约束,分析 NULL 值对布尔条件的影响,并提供修改已有表结构时的安全操作建议,帮助开发者构建更健壮的数据完整性防线。
后端开发中,如何正确使用 SQL 外键约束来维护订单与明细表的关系?本文通过 PostgreSQL 示例,深入讲解外键的创建语法、插入顺序要求,以及 ON DELETE CASCADE、RESTRICT、SET NULL 等策略的实际影响与风险控制,助你构建健壮的数据库结构。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



