

Java中Object类的方法怎么用
ObjectDock 是一款为Windows系统增加美观实用的Dock栏的工具。界面整理和高频系统操作被放到一起考虑,桌面或窗口内容一多时,管理起来会更省心。
前言:Java的Object类的完整路径是java.lang.Object,是所有类的父类编译,当我们创建一个类时,如果没有明确继承一个父类,那么它就会自动继承Object,成为Object的子类(隐式继承)。Object类有九大常用方法,分别是getClass()、finalize()、toString()、equals()、hashcode()、wait()、notify()、notifyAll()和clone()。一、getClass()首先,getClass()方法用于获取一个对象的运行时类(Cl
前言:
Java的Object 类的完整路径是java.lang.Object ,是所有类的父类编译,当我们创建一个类时,如果没有明确继承一个父类,那么它就会自动继承 Object,成为 Object 的子类(隐式继承)。Object类有九大常用方法,分别是getClass()、finalize()、toString()、equals()、hashcode()、wait()、notify()、notifyAll()和clone()。
一、getClass()
首先,getClass()方法用于获取一个对象的运行时类(Class),进而通过返回的Class对象获取Person的相关信息,比如获取该类的构造方法、该类有哪些方法、该类有哪些成员变量等信息。不同VM针对Class做了不同的优化,所以getClass()的实现也并不相同:
// Java用native方法实现getClass()
public final native Class getClass();
// Android特殊的实现方式
private transient Class shadow$_klass_;
public final Class getClass() {
  return shadow$_klass_;
}
这是因为是Java默认的Hotspot虚拟机并没有开辟单独的Method Area空间,而是有GC Heap的老生代的Metaspace实现的。而Android采用ART VM,这才造成了这种差异。想深入了解不同VM的实现的运行时数据分区、ClassLoader和Class类要读很多书,本文不做过多讨论。
二、finalize()
finalize()是Object的protected方法,在发生GC时触发该方法,大致流程是当对象变成GC Roots不可达时,GC判断该对象是否覆盖了finalize()方法,若未覆盖,则直接将其回收。否则,若对象未执行过finalize()方法,将其放入F-Queue队列,由一低优先级线程执行该队列中对象的finalize()方法。执行finalize()方法完毕后,GC会再次判断该对象是否可达,若不可达,则进行回收;否则,对象“复活”。
子类可以override方法以实现(1)防止对象被回收、(2)防止对象不被回收。防止对象被回收只需让该对象与GC ROOTS之间存在可达链即可。我们重点看看FileInputStream、FileOutputStream、Connection等类怎么防止用户忘记释放资源呢,如下是FileInputStream的部分源码:
protected void finalize() throws IOException {
    // Android新增CloseGuard确保FlieInputStream回收更安全
    if (guard != null) {
        guard.warnIfOpen();
    }
// Java利用FileDescriptor确保FileInputStream不可达,可以被安全回收
    if ((fd != null) &&  (fd != FileDescriptor.in)) {
        close();
    }
}
三、toString()
toString()方法返回该对象的String表示,这也是连每个初级程序员都很熟悉的一个方法了。你仔细读过Java的源码,就知道很多类的toString()方法都是精雕细琢的,就像Integer的toString()方法,就针对Android做了一定适配:
public String toString() {
    return toString(this.value);
}
//返回指定十进制整数的String
public static String toString(int i) {
    if (i == Integer.MIN_VALUE)
        return "-2147483648";

    // small是Android特有的变量,用二维Array缓存较小(两位数)数字的String
    boolean negative = i < 0;
    boolean small = negative ? i > -100 : i < 100;
    if (small) {
        final String[] smallValues = negative ? SMALL_NEG_VALUES : SMALL_NONNEG_VALUES;

        if (negative) {
            i = -i;
            if (smallValues[i] == null) {
                smallValues[i] =
                    i < 10 ? new String(new char[]{'-', DigitOnes[i]})
                           : new String(new char[]{'-', DigitTens[i], DigitOnes[i]});
            }
        } else {
            if (smallValues[i] == null) {
                smallValues[i] =
                    i < 10 ? new String(new char[]{DigitOnes[i]})
                           : new String(new char[]{DigitTens[i], DigitOnes[i]});
            }
        }
        return smallValues[i];
    }
    int size = negative ? stringSize(-i) + 1 : stringSize(i);
    // getChars()方法略
    char[] buf = new char[size];
    getChars(i, size, buf);
    return new String(buf);
}
在实际开发中,复杂对象的toString()方法用Gson生成JSON来实现。
四、equals()和hashcode()
equals()方法和hashcode()方法,我要放在一起说。
// 其实Object方法默认的equals()也是比较引用是否相同
public boolean equals(Object obj) {
    return (this == obj);
}
一般来说==比较的是引用是否相同,而equals()则是需要重写来比较值是否相同。重写equals()要注意以下几点注意事项:
(1)对任意x,x.equals(x)一定返回true
(2)对任意x,y,如果x.equals(y)返回true,则y.equals(x)也一定返回true
(3)对任意x,y,z,如果x.equals(y)返回true,y.equals(z)也返回true,则x.equals(z)也一定返回true
(4)对任意x,y,如果对象中用于比较的信息没有改变,那么无论调用多少次x.equals(y),返回的结果应该保持一致,要么一直返回true,要么一直返回false
(5)对任意不是null的x,x.equals(null)一定返回false,如果两个对象equals()方法相等则它们的hashCode返回值一定要相同。我们先看一下String是如何实现equals()的:
//比较这个String和另一个对象,当且仅当那个对象不为null且与这个String有相同的字符排列顺序时返回true
public boolean equals(Object anObject) {
    if (this == anObject) {
        return true;
    }
    if (anObject instanceof String) {
        String anotherString = (String)anObject;
        int n = length();
        if (n == anotherString.length()) {
            int i = 0;
            while (n-- != 0) {
                if (charAt(i) != anotherString.charAt(i))
                        return false;
                i++;
            }
            return true;
        }
    }
    return false;
}
我们再看一下String是如何实现hashcode()的:
// 缓存String的hashcode()
private int hash; // 默认为0
public int hashCode() {
    int h = hash;
    final int len = length();
    if (h == 0 && len > 0) {
        for (int i = 0; i < len; i++) {
            h = 31 * h + charAt(i);
        }
        hash = h;
    }
    return h;
}
反之,如果两个对象的hashCode返回值相同,它们的equals()方法可以不返回true。这种情况叫做hash碰撞。HashMap处理hash碰撞的方法叫链地址法,除此以外hash碰撞还可以用ArrayMap采用的开放地址法解决,这些不在今天的话题讨论范围之内,不做赘述。
五、wait()、notify()和notifyAll()
wait()、notify()和notifyAll()三个方法实现了Java的wait-notify机制。
先看wait()方法,wait()方法用来让持有此对象的监视器的线程处于阻塞状态,有参数不同的三个同名方法:
// 无参方法的Java与Android实现方式没有区别
// 如果不在synchronized修饰的方法或代码块里调用,如果没有获取锁,则会抛出IllegalMonitorStateException 异常
// 如果当前线程在等待时被中断,则抛出InterruptedException异常
public final void wait() throws InterruptedException {
    wait(0);
}
// timeout是线程等待时间,时间结束则自动唤醒,单位ms
// Java默认的实现方式,native实现
public final native void wait(long timeout) throws InterruptedException;
// Android的特殊处理
public final void wait(long timeout) throws InterruptedException {
    wait(timeout, 0);
}
// nanos是更精确的线程等待时间,单位ns(1 ms == 1,000,000 ns)
// Java默认的实现方式
public final void wait(long timeout, int nanos) throws InterruptedException {
    if (timeout < 0) {
        throw new IllegalArgumentException("timeout value is negative");
    }
    if (nanos < 0 || nanos > 999999) {
        throw new IllegalArgumentException(
                "nanosecond timeout value out of range");
    }
    if (nanos > 0) {
        timeout++;
    }
    wait(timeout);
}
// Android的特殊处理,改为native实现
@FastNative
public final native void wait(long timeout, int nanos) throws InterruptedException;
ns是纳秒的意思,1s == 1,000,000,000ns,光速是世界上最快的速度,光在1ns时间内仅能传播0.3m。一般PC的CPU计算一道简单指令,比如2+3=5的时间为2~4ns。我们一般只用一个参数的wait()方法或者无参方法就足够了,第二个参数在现实开发中几乎用不到。
含参的wait()方法调用后,线程可以在等待时间结束后进入就绪状态(以下简称“唤醒”);无参的wait()方法调用后,则必须等待持有该对象监视器的线程主动调用notify()或notifyAll()方法后才能被唤醒。区别在于notify()方法唤醒在此对象监视器上等待的单个线程,如果所有线程都在此对象上等待,则会随机唤醒其中一个线程;而notifyAll()方法则唤醒在此对象监视器上等待的所有线程。
public final native void notify();
public final native void notifyAll();
wait()、notify()和notifyAll()都是final native方法,我们暂时不需要深入理解内部是怎样实现的,我们只要知道这就是Java的等待-通知(wait-notify)机制,学习它们的应用场景就好了。
打个比方:
(1)用人单位决定录用程序员的时间是不确定的,比如可能要面试好多人,需要综合考虑,不能及时反馈
(2)每个程序员面试结束后需要wait()
(3)用人单位综合考虑之后觉得最合适的程序员,让HR notify()
(4)最后被选中程序员高高兴兴去上班了,其他程序员就等着吧
在开发中,wait-notify机制的最广泛用途就是实现生产者/消费者模型,生产者/消费者模型能解决绝大多数并发问题,通过平衡生产线程和消费线程的工作能力来提高程序的整体处理数据的速度。
使用wait-notify机制的注意事项:
(1)wait()、notify()和notifyAll()必须在synchronized修饰的方法或代码块中使用
(2)在while循环里而不是if语句下使用wait(),确保在线程睡眠前后都检查wait()触发的条件(防止虚假唤醒)
(3)wait()方法必须在多线程共享的对象上调用
我们先定义注意(1)和(2)的一个生产者,往队列里添加元素:
// 生产者,有详细的注释
public class Producer implements Runnable{
    private Queue queue;
    private int maxSize;
    public Producer(Queue queue, int maxSize){
        this.queue = queue;
        this.maxSize = maxSize;
    }
    @Override
    public void run() {
        // 这里为了方便演示做了一个死循环,现实开发中不要这样搞
        while (true){
            //(1)wait()、notify()和notifyAll()必须在synchronized修饰的方法或代码块中使用
            synchronized (queue){
//(2)在while循环里而不是if语句下使用wait(),确保在线程睡眠前后都检查wait()触发的条件(防止虚假唤醒)
                while (queue.size() == maxSize){
                    try{
                        System.out.println("Queue is Full");
// 生产者线程进入等待状态,在此对象监视器上等待的所有线程(其实只有那个消费者线程)开始争夺锁
                        queue.wait();
                    }catch (InterruptedException ie){
                        ie.printStackTrace();
                    }
                }
                Random random = new Random();
                int i = random.nextInt();
                System.out.println("Produce " + i);
                queue.add(i);
// 唤醒这个Queue对象的等待池中的所有线程(其实只有那个消费者线程),等待获取对象监视器
                queue.notifyAll();
            }
        }
    }
}
再定义一个一模一样的消费者,除了从队列里移除元素之外,其他代码同上
// 消费者,注释略
public class Consumer implements Runnable{
    private Queue queue;
    private int maxSize;
    public Consumer(Queue queue, int maxSize){
        this.queue = queue;
        this.maxSize = maxSize;
    }

    @Override
    public void run() {
        while (true){
            synchronized (queue){
                while (queue.isEmpty()){
                    System.out.println("Queue is Empty");
                    try{
                        queue.wait();
                    }catch (InterruptedException ie){
                        ie.printStackTrace();
                    }
                }
                int v = queue.remove();
                System.out.println("Consume " + v);
                queue.notifyAll();
            }
        }
    }
}
最后编写符合(3)的测试代码:
public void test(){
    //(3)wait()方法必须在多线程共享的对象上调用
    // 这个队列就是给消费者、生产者两个线程共享的对象
    Queue queue = new LinkedList<>();
    int maxSize = 5;
    Producer p = new Producer(queue, maxSize);
    Consumer c = new Consumer(queue, maxSize);
    Thread pT = new Thread(p);
    Thread pC = new Thread(c);
// 生产者线程启动,获取锁
    pT.start();
// 消费者线程启动
    pC.start();
}
查看运行结果:
Produce 1604006010
Produce 1312202442
Produce -1478853208
Produce 1460408111
Produce 1802825495
Queue is Full
Consume 1604006010
Consume 1312202442
Consume -1478853208
Consume 1460408111
Consume 1802825495
Queue is Empty
除了以上介绍的用synchronized关键字配合Object的wait()/notity()实现,生产者-消费者模型还可以用Lock接口配合Condition的await()、signalAll()实现,此外还可以用BlockingQueue实现,但这些都不在本文的话题讨论范围之内,就不再赘述了。
六、clone()
Java语言的Object类实现了Cloneable接口,一个对象可以通过调用Clone()方法生成对象。需要注意的是,clone()方法并不是Cloneable接口里的,而是Object类里的,Cloneable是一个标识接口,标识这个类的对象是可被拷贝的,如果没有实现Cloneable接口却调用了clone()方法就会报错。
// protected native Object clone() throws CloneNotSupportedException;
protected Object clone() throws CloneNotSupportedException {
    if (!(this instanceof Cloneable)) {
        throw new CloneNotSupportedException("Class " + getClass().getName() + " doesn't implement Cloneable");
    }
    return internalClone();
}
// Native helper method for cloning.
private native Object internalClone();
对象除了new出来和clone()出来,还可以通过反射和反序列化两种方式产生,但这两种方式不在我们今天的话题讨论范围之内。
所谓原型模式,就是利用clone()生成对象的设计模式。需要提前了解一下深拷贝和浅拷贝的概念。Java中的数据类型分为基本类型和引用类型,在一个方法里的变量如果是基本类型的话,变量就直接存储在这个方法的栈帧里,例如int、long等;而引用类型则在栈帧里存储这个变量的指针,指向堆中该实体的地址,例如String、Array等。深拷贝和浅拷贝是只针对引用数据类型的
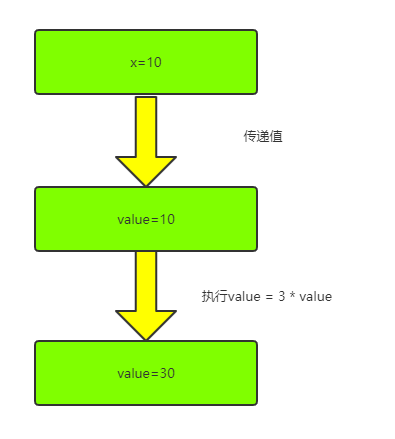
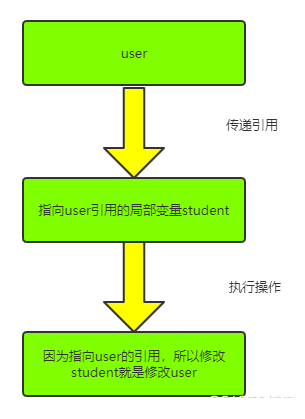
比如一个方法有一个基本类型参数和一个引用类型参数,在方法体里对参数重新赋值,会影响传入的引用类型参数,而不会影响基本类型参数,因为基本类型参数是值传递,而引用类型是引用传递。需要注意的是,较真来说Java只有值传递,因为Java的引用传递传的是引用类型对象在堆内存空间的地址,引用传递只是一种习惯性的说法,这个涉及到JVM和操作系统,不做过多讨论。
先定义一个用户类:
// 这是一个非常简单的用户类
public class User {
    private String name;
    private int age;
    public User(String name, int age) {
        this.name=name;
        this.age=age;
    }
    public String getName() {
        return name;
    }
    public void setName(String name) {
        this.name = name;
    }
    public int getAge() {
        return age;
    }
    public void setAge(int age) {
        this.age = age;
    }
    @Override
    public String toString() {
        return "User{name='" + name + ", age=" + age +'}';
    }
}
编写测试代码:
private int x=10;
public void updateValue(int value){
    value = 3 * value;
}
private User user= new User("唐茜靖",18);
public void updateUser(User student){
    student.setName("管晨辰");
    student.setAge(16);
}

public void test(){
    System.out.println("调用前x的值:"+x);
    updateValue(x);
    System.out.println("调用后x的值:"+x);
    System.out.println("调用前user的值:"+user.toString());
    updateUser(user);
    System.out.println("调用后user的值:"+user.toString());
}
Log打印结果如下:
调用前x的值:10 调用后x的值:10 调用前user的值:User{name='唐茜靖, age=18} 调用后user的值:User{name='管晨辰, age=16} |
传递基本类型的方法(updateValue())流程图:
传递引用类型的方法(updateUser())流程图:
但也有例外,比如String类型和<=127的Long类型虽然也是引用类型,却像基本类型一样不受影响,这是因为它们会先比较常量池维护的值,这涉及VM的内容,今天不做过多讨论。浅拷贝是在按位(bit)拷贝对象,这个对象有着原始对象属性值的一份精确拷贝。我们结合应用场景分析一下,还是刚才的User类,我们增加一个存放地址的内部类Address,我们需要用户信息可以被其他module查询,但是不允许它们被其他module修改,新增代码如下:
// 这是一个稍微复杂的、支持拷贝的用户类
public class User implements Cloneable {
// ……省略上文代码……
    private Address address;

    @NonNull
    @NotNull
    @Override
    public User clone() {
        try{
            return (User)super.clone();
        }catch (CloneNotSupportedException e) {
            e.printStackTrace();
        }
        return null;
    }

    public class Address{
        // 地市
        public String city;
        // 区县
        public String county;
        // 乡镇街道
        public String street;
    }
}
我们可以注意到Address还是指向以前的引用,浅拷贝会带来数据安全方面的隐患,这就到了需要深拷贝的时候了。对于有多层对象的,每个对象都需要实现 Cloneable 并重写 clone() 方法,才可以实现了对象的串行层层拷贝。就像这样:
// 这是一个更复杂的、支持深拷贝的用户类
public class User implements Cloneable {
    // ……省略上文代码……
    @NonNull
    @NotNull
    @Override
    public User clone() {
        try{
            User newUser = (User)super.clone();
            newUser.setName(this.name);
            newUser.setAddress(this.address.clone());
            return newUser;
        }catch (CloneNotSupportedException e) {
            e.printStackTrace();
        }
        return null;
    }

    public class Address implements Cloneable{
        // ……省略上文代码……
        @NonNull
        @NotNull
        @Override
        public Address clone() {
            try{
                Address newAddress = (Address)super.clone();
                newAddress.city = this.city;
                newAddress.county = this.county;
                newAddress.street = this.street;
                return newAddress;
            }catch (CloneNotSupportedException e) {
                e.printStackTrace();
            }
            return null;
        }
    }
}
至于彻底深拷贝几乎是不可能实现的,不但可能存在引用关系非常复杂的情况,也可能存在引用链的某一级上引用了一个没有实现Cloneable接口的第三方对象的情况。
最后总结一下,原型模式的用途之一是保护性拷贝,防止外部对只读对象进行修改,刚才我举的例子就是保护性拷贝。另一个重要用途则是解决构建复杂对象的资源消耗问题,提升创建对象的效率,这是因为clone()方法的原理是在内存中拷贝二进制流,比new一个对象的性能好很多,非常适用于需要在循环体内产生大量对象的时候。绝大多数设计模式都是牺牲性能提升开发效率的,原型模式是为数不多的牺牲开发效率提升性能的。
我们做一下new和clone的对比:
private User user= new User("唐茜靖",18);
public void testNew(){
    User user1 = new User("管晨辰",16);
}
public void testClone(){
    User user2 = user.clone();
}
通过ASM工具查看bytecode,可以对比出二者对栈资源的消耗:
// access flags 0x1

  public testNew()V

   ……省略……

    MAXSTACK = 4

    MAXLOCALS = 2


  // access flags 0x1

  public testClone()V

   ……省略……

    MAXSTACK = 1

    MAXLOCALS = 2
此外还需要注意一点,拷贝不会执行构造函数,所以有时候我们需要注意这个潜在的问题。幸好这个问题不是不可避免的,这是Android第五大组件Intent的clone()的实现,没有用拷贝:
@Override
public Object clone() {
    return new Intent(this);
} 

深入解析Java中局部变量未初始化编译报错与成员变量自动赋予默认值的机制差异,涵盖JVM内存分配、编译期确定性赋值检查与实际排查修复方案。

详细讲解在Java中获取当前系统时间并进行格式化输出的两种核心方案:基于Java 8全新日期时间API的DateTimeFormatter与传统遗留的SimpleDateFormat,包含完整代码示例、线程安全机制对比及生产选型建议。

深入解析Java中final变量与static final常量的定义、内存语义、初始化时机及合法赋值路径,涵盖编译期常量优化与实战避坑指南。


本文提供Java标准库HttpClient发起HTTP GET/POST请求并结合Jackson进行JSON数据反序列化与序列化的完整代码示例与工程实践指南。

详细分析Java递归调用出现StackOverflowError的原因,结合代码说明线程栈、栈帧和递归深度之间的关系,并介绍终止条件排查、迭代改写、减少栈帧开销以及通过-Xss调整JVM栈空间的方法。

针对Java中常见的NullPointerException(NPE),本文从堆栈日志定位、典型代码触发场景、具体修复代码对比到防御体系进行系统讲解,提供实用且易上手的排查与修复方案。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



