

Python中如何使用TensorFlow构建LSTM模型?
LSTM简介1、RNN的梯度消失问题在过去的时间里我们学习了RNN循环神经网络,其结构示意图是这样的:其存在的最大问题是,当w1、w2、w3这些值小于0时,如果一句话够长,那么其在神经网络进行反向传播与前向传播时,存在梯度消失的问题。0.925=0.07,如果一句话有20到30个字,那么第一个字的隐含层输出传递到最后,将会变为原来的0.07倍,相比于最后一个字的影响,大大降低。其具体情况是这样的:长短时记忆网络就是为了解决梯度消失的问题出现的。2、LSTM的结构原始RNN的隐藏层只有一个状态h,从头传递到
LSTM简介
1、RNN的梯度消失问题
在过去的时间里我们学习了RNN循环神经网络,其结构示意图是这样的:
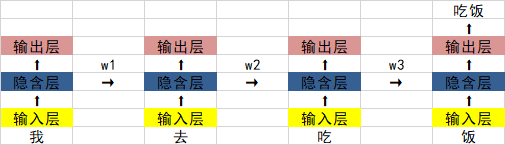
其存在的最大问题是,当w1、w2、w3这些值小于0时,如果一句话够长,那么其在神经网络进行反向传播与前向传播时,存在梯度消失的问题。
0.925=0.07,如果一句话有20到30个字,那么第一个字的隐含层输出传递到最后,将会变为原来的0.07倍,相比于最后一个字的影响,大大降低。
其具体情况是这样的:
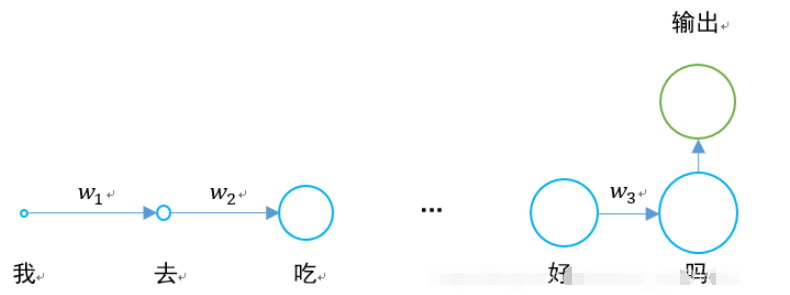
长短时记忆网络就是为了解决梯度消失的问题出现的。
2、LSTM的结构
原始RNN的隐藏层只有一个状态h,从头传递到尾,它对于短期的输入非常敏感。
如果我们再增加一个状态c,让它来保存长期的状态,问题就可以解决了。
对于RNN和LSTM而言,其两个step单元的对比如下。
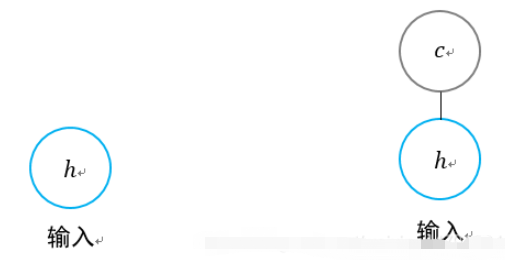
我们把LSTM的结构按照时间维度展开:
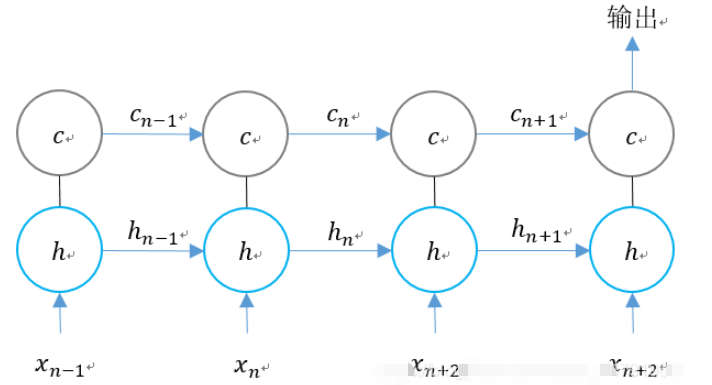
我们可以看出,在n时刻,LSTM的输入有三个:
1、当前时刻网络的输入值;
2、上一时刻LSTM的输出值;
3、上一时刻的单元状态。
LSTM的输出有两个:
1、当前时刻LSTM输出值;
2、当前时刻的单元状态。
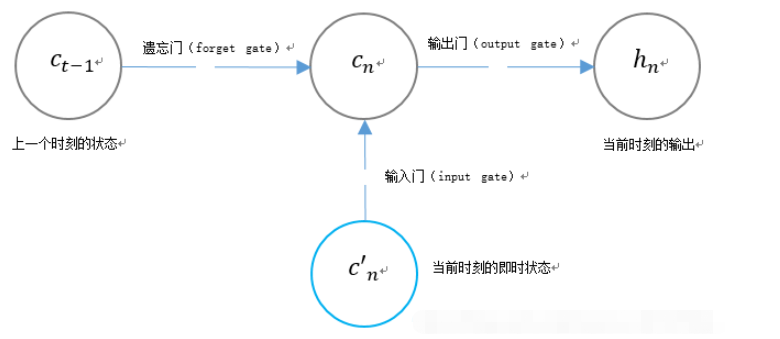
3、LSTM独特的门结构
LSTM用两个门来控制单元状态cn的内容:
1、遗忘门(forget gate),它决定了上一时刻的单元状态cn-1有多少保留到当前时刻;
2、输入门(input gate),它决定了当前时刻网络的输入c’n有多少保存到单元状态。
LSTM用一个门来控制当前输出值hn的内容:
输出门(output gate),它决定了当前时刻单元状态cn有多少输出。
tensorflow中LSTM的相关函数
tf.contrib.rnn.BasicLSTMCell
tf.contrib.rnn.BasicLSTMCell(
    num_units,
    forget_bias=1.0,
    state_is_tuple=True,
    activation=None,
    reuse=None,
    name=None,
    dtype=None
)
num_units:RNN单元中的神经元数量,即输出神经元数量。
forget_bias:偏置增加了忘记门。从CudnnLSTM训练的检查点(checkpoin)恢复时,必须手动设置为0.0。
state_is_tuple:如果为True,则接受和返回的状态是c_state和m_state的2-tuple;如果为False,则他们沿着列轴连接。False即将弃用。
activation:激活函数。
reuse:描述是否在现有范围中重用变量。如果不为True,并且现有范围已经具有给定变量,则会引发错误。
name:层的名称。
dtype:该层的数据类型。
在使用时,可以定义为:
lstm_cell = tf.contrib.rnn.BasicLSTMCell(self.cell_size, forget_bias=1.0, state_is_tuple=True)
在定义完成后,可以进行状态初始化:
self.cell_init_state = lstm_cell.zero_state(self.batch_size, dtype=tf.float32)
tf.nn.dynamic_rnn
tf.nn.dynamic_rnn(
    cell,
    inputs,
    sequence_length=None,
    initial_state=None,
    dtype=None,
    parallel_iterations=None,
    swap_memory=False,
    time_major=False,
    scope=None
)
cell:上文所定义的lstm_cell。
inputs:RNN输入。如果time_major==false(默认),则必须是如下shape的tensor:[batch_size,max_time,…]或此类元素的嵌套元组。如果time_major==true,则必须是如下形状的tensor:[max_time,batch_size,…]或此类元素的嵌套元组。
sequence_length:Int32/Int64矢量大小。用于在超过批处理元素的序列长度时复制通过状态和零输出。因此,它更多的是为了性能而不是正确性。
initial_state:上文所定义的_init_state。
dtype:数据类型。
parallel_iterations:并行运行的迭代次数。那些不具有任何时间依赖性并且可以并行运行的操作将是。这个参数用时间来交换空间。值>>1使用更多的内存,但花费的时间更少,而较小的值使用更少的内存,但计算需要更长的时间。
time_major:输入和输出tensor的形状格式。如果为真,这些张量的形状必须是[max_time,batch_size,depth]。如果为假,这些张量的形状必须是[batch_size,max_time,depth]。使用time_major=true会更有效率,因为它可以避免在RNN计算的开始和结束时进行换位。但是,大多数TensorFlow数据都是批处理主数据,因此默认情况下,此函数为False。
scope:创建的子图的可变作用域;默认为“RNN”。
在LSTM的最后,需要用该函数得出结果。
self.cell_outputs, self.cell_final_state = tf.nn.dynamic_rnn(
	lstm_cell, self.l_in_y, initial_state=self.cell_init_state, time_major=False)
返回的是一个元组 (outputs, state):
outputs:LSTM的最后一层的输出,是一个tensor。如果为time_major== False,则它的shape为[batch_size,max_time,cell.output_size]。如果为time_major== True,则它的shape为[max_time,batch_size,cell.output_size]。
states:states是一个tensor。state是最终的状态,也就是序列中最后一个cell输出的状态。一般情况下states的形状为 [batch_size, cell.output_size],但当输入的cell为BasicLSTMCell时,states的形状为[2,batch_size, cell.output_size ],其中2也对应着LSTM中的cell state和hidden state。
整个LSTM的定义过程为:
    def add_input_layer(self,):
        #X最开始的形状为(256 batch,28 steps,28 inputs)
        #转化为(256 batch*28 steps,128 hidden)
        l_in_x = tf.reshape(self.xs, [-1, self.input_size], name='to_2D')

        #获取Ws和Bs
        Ws_in = self._weight_variable([self.input_size, self.cell_size])
        bs_in = self._bias_variable([self.cell_size])

        #转化为(256 batch*28 steps,256 hidden)
        with tf.name_scope('Wx_plus_b'):
            l_in_y = tf.matmul(l_in_x, Ws_in) + bs_in

        # (batch * n_steps, cell_size) ==> (batch, n_steps, cell_size)
        # (256*28,256)->(256,28,256)
        self.l_in_y = tf.reshape(l_in_y, [-1, self.n_steps, self.cell_size], name='to_3D')

    def add_cell(self):
        #神经元个数
        lstm_cell = tf.contrib.rnn.BasicLSTMCell(self.cell_size, forget_bias=1.0, state_is_tuple=True)

        #每一次传入的batch的大小
        with tf.name_scope('initial_state'):
            self.cell_init_state = lstm_cell.zero_state(self.batch_size, dtype=tf.float32)

        #不是主列
        self.cell_outputs, self.cell_final_state = tf.nn.dynamic_rnn(
            lstm_cell, self.l_in_y, initial_state=self.cell_init_state, time_major=False)

    def add_output_layer(self):
        #设置Ws,Bs
        Ws_out = self._weight_variable([self.cell_size, self.output_size])
        bs_out = self._bias_variable([self.output_size])
        # shape = (batch,output_size)
        # (256,10)
        with tf.name_scope('Wx_plus_b'):
            self.pred = tf.matmul(self.cell_final_state[-1], Ws_out) + bs_out
全部代码
该例子为手写体识别例子,将手写体的28行分别作为每一个step的输入,输入维度均为28列。
import tensorflow as tf
from tensorflow.examples.tutorials.mnist import input_data
import numpy as np

mnist = input_data.read_data_sets("MNIST_data",one_hot = "true")

BATCH_SIZE = 256     # 每一个batch的数据数量
TIME_STEPS = 28      # 图像共28行,分为28个step进行传输
INPUT_SIZE = 28      # 图像共28列
OUTPUT_SIZE = 10     # 共10个输出
CELL_SIZE = 256      # RNN 的 hidden unit size,隐含层神经元的个数
LR = 1e-3            # learning rate,学习率

def get_batch():    #获取训练的batch
    batch_xs,batch_ys = mnist.train.next_batch(BATCH_SIZE)
    batch_xs = batch_xs.reshape([BATCH_SIZE,TIME_STEPS,INPUT_SIZE])
    return [batch_xs,batch_ys]

class LSTMRNN(object):  #构建LSTM的类
    def __init__(self, n_steps, input_size, output_size, cell_size, batch_size):
        self.n_steps = n_steps
        self.input_size = input_size
        self.output_size = output_size
        self.cell_size = cell_size
        self.batch_size = batch_size

        #输入输出
        with tf.name_scope('inputs'):
            self.xs = tf.placeholder(tf.float32, [None, n_steps, input_size], name='xs')
            self.ys = tf.placeholder(tf.float32, [None, output_size], name='ys')
        #直接加层
        with tf.variable_scope('in_hidden'):
            self.add_input_layer()
        #增加LSTM的cell
        with tf.variable_scope('LSTM_cell'):
            self.add_cell()
        #直接加层
        with tf.variable_scope('out_hidden'):
            self.add_output_layer()
        #计算损失值
        with tf.name_scope('cost'):
            self.compute_cost()
        #训练
        with tf.name_scope('train'):
            self.train_op = tf.train.AdamOptimizer(LR).minimize(self.cost)
        #正确率计算
        self.correct_pre = tf.equal(tf.argmax(self.ys,1),tf.argmax(self.pred,1))
        self.accuracy = tf.reduce_mean(tf.cast(self.correct_pre,tf.float32))

    def add_input_layer(self,):
        #X最开始的形状为(256 batch,28 steps,28 inputs)
        #转化为(256 batch*28 steps,128 hidden)
        l_in_x = tf.reshape(self.xs, [-1, self.input_size], name='to_2D')

        #获取Ws和Bs
        Ws_in = self._weight_variable([self.input_size, self.cell_size])
        bs_in = self._bias_variable([self.cell_size])

        #转化为(256 batch*28 steps,256 hidden)
        with tf.name_scope('Wx_plus_b'):
            l_in_y = tf.matmul(l_in_x, Ws_in) + bs_in

        # (batch * n_steps, cell_size) ==> (batch, n_steps, cell_size)
        # (256*28,256)->(256,28,256)
        self.l_in_y = tf.reshape(l_in_y, [-1, self.n_steps, self.cell_size], name='to_3D')

    def add_cell(self):
        #神经元个数
        lstm_cell = tf.contrib.rnn.BasicLSTMCell(self.cell_size, forget_bias=1.0, state_is_tuple=True)

        #每一次传入的batch的大小
        with tf.name_scope('initial_state'):
            self.cell_init_state = lstm_cell.zero_state(self.batch_size, dtype=tf.float32)

        #不是主列
        self.cell_outputs, self.cell_final_state = tf.nn.dynamic_rnn(
            lstm_cell, self.l_in_y, initial_state=self.cell_init_state, time_major=False)

    def add_output_layer(self):
        #设置Ws,Bs
        Ws_out = self._weight_variable([self.cell_size, self.output_size])
        bs_out = self._bias_variable([self.output_size])
        # shape = (batch,output_size)
        # (256,10)
        with tf.name_scope('Wx_plus_b'):
            self.pred = tf.matmul(self.cell_final_state[-1], Ws_out) + bs_out

    def compute_cost(self):
        self.cost =  tf.reduce_mean(
            tf.nn.softmax_cross_entropy_with_logits(logits = self.pred,labels = self.ys)
            )

    def _weight_variable(self, shape, name='weights'):
        initializer = np.random.normal(0.0,1.0 ,size=shape)
        return tf.Variable(initializer, name=name,dtype = tf.float32)

    def _bias_variable(self, shape, name='biases'):
        initializer = np.ones(shape=shape)*0.1
        return tf.Variable(initializer, name=name,dtype = tf.float32)


if __name__ == '__main__':
    #搭建 LSTMRNN 模型
    model = LSTMRNN(TIME_STEPS, INPUT_SIZE, OUTPUT_SIZE, CELL_SIZE, BATCH_SIZE)
    sess = tf.Session()

    sess.run(tf.global_variables_initializer())

    #训练10000次
    for i in range(10000):
        xs, ys = get_batch()  #提取 batch data
        if i == 0:
        #初始化data
            feed_dict = {
                    model.xs: xs,
                    model.ys: ys,
            }
        else:
            feed_dict = {
                model.xs: xs,
                model.ys: ys,
                model.cell_init_state: state    #保持 state 的连续性
            }

        #训练
        _, cost, state, pred = sess.run(
            [model.train_op, model.cost, model.cell_final_state, model.pred],
            feed_dict=feed_dict)

        #打印精确度结果
        if i % 20 == 0:
            print(sess.run(model.accuracy,feed_dict = {
                    model.xs: xs,
                    model.ys: ys,
                    model.cell_init_state: state    #保持 state 的连续性
})) 
学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



