

Java中如何解决HashMap多线程并发问题?
并发问题的症状多线程put后可能导致get死循环从前我们的Java代码因为一些原因使用了HashMap这个东西,但是当时的程序是单线程的,一切都没有问题。后来,我们的程序性能有问题,所以需要变成多线程的,于是,变成多线程后到了线上,发现程序经常占了100%的CPU,查看堆栈,你会发现程序都Hang在了HashMap.get()这个方法上了,重启程序后问题消失。但是过段时间又会来。而且,这个问题在测试环境里可能很难重现。我们简单的看一下我们自己的代码,我们就知道HashMap被多个线程操作。而Java的文档
并发问题的症状
多线程put后可能导致get死循环
从前我们的Java代码因为一些原因使用了HashMap这个东西,但是当时的程序是单线程的,一切都没有问题。后来,我们的程序性能有问题,所以需要变成多线程的,于是,变成多线程后到了线上,发现程序经常占了100%的CPU,查看堆栈,你会发现程序都Hang在了HashMap.get()这个方法上了,重启程序后问题消失。但是过段时间又会来。而且,这个问题在测试环境里可能很难重现。
我们简单的看一下我们自己的代码,我们就知道HashMap被多个线程操作。而Java的文档说HashMap是非线程安全的,应该用ConcurrentHashMap。但是在这里我们可以来研究一下原因。简单代码如下:
package com.king.hashmap;
import java.util.HashMap;
public class TestLock {
     private HashMap map = new HashMap();
     public TestLock() {
         Thread t1 = new Thread() {
             public void run() {
                 for ( int i = 0 ; i < 50000 ; i++) {
                     map.put( new Integer(i), i);
                 }
                 System.out.println( "t1 over" );
             }
         };
         Thread t2 = new Thread() {
             public void run() {
                 for ( int i = 0 ; i < 50000 ; i++) {
                     map.put( new Integer(i), i);
                 }
                 System.out.println( "t2 over" );
             }
         };
         Thread t3 = new Thread() {
             public void run() {
                 for ( int i = 0 ; i < 50000 ; i++) {
                     map.put( new Integer(i), i);
                 }
                 System.out.println( "t3 over" );
             }
         };
         Thread t4 = new Thread() {
             public void run() {
                 for ( int i = 0 ; i < 50000 ; i++) {
                     map.put( new Integer(i), i);
                 }
                 System.out.println( "t4 over" );
             }
         };
         Thread t5 = new Thread() {
             public void run() {
                 for ( int i = 0 ; i < 50000 ; i++) {
                     map.put( new Integer(i), i);
                 }
                 System.out.println( "t5 over" );
             }
         };
         Thread t6 = new Thread() {
             public void run() {
                 for ( int i = 0 ; i < 50000 ; i++) {
                     map.get( new Integer(i));
                 }
                 System.out.println( "t6 over" );
             }
         };
         Thread t7 = new Thread() {
             public void run() {
                 for ( int i = 0 ; i < 50000 ; i++) {
                     map.get( new Integer(i));
                 }
                 System.out.println( "t7 over" );
             }
         };
         Thread t8 = new Thread() {
             public void run() {
                 for ( int i = 0 ; i < 50000 ; i++) {
                     map.get( new Integer(i));
                 }
                 System.out.println( "t8 over" );
             }
         };
         Thread t9 = new Thread() {
             public void run() {
                 for ( int i = 0 ; i < 50000 ; i++) {
                     map.get( new Integer(i));
                 }
                 System.out.println( "t9 over" );
             }
         };
         Thread t10 = new Thread() {
             public void run() {
                 for ( int i = 0 ; i < 50000 ; i++) {
                     map.get( new Integer(i));
                 }
                 System.out.println( "t10 over" );
             }
         };
         t1.start();
         t2.start();
         t3.start();
         t4.start();
         t5.start();
         t6.start();
         t7.start();
         t8.start();
         t9.start();
         t10.start();
     }
     public static void main(String[] args) {
         new TestLock();
     }
}
就是启了10个线程,不断的往一个非线程安全的HashMap中put内容/get内容,put的内容很简单,key和value都是从0自增的整数(这个put的内容做的并不好,以致于后来干扰了我分析问题的思路)。对HashMap做并发写操作,我原以为只不过会产生脏数据的情况,但反复运行这个程序,会出现线程t1、t2被hang住的情况,多数情况下是一个线程被hang住另一个成功结束,偶尔会10个线程都被hang住。
产生这个死循环的根源在于对一个未保护的共享变量 — 一个”HashMap”数据结构的操作。当在所有操作的方法上加了”synchronized”后,一切恢复了正常。这算jvm的bug吗?应该说不是的,这个现象很早以前就报告出来了。Sun的工程师并不认为这是bug,而是建议在这样的场景下应采用”ConcurrentHashMap”,
CPU利用率过高一般是因为出现了出现了死循环,导致部分线程一直运行,占用cpu时间。问题原因就是HashMap是非线程安全的,多个线程put的时候造成了某个key值Entry key List的死循环,问题就这么产生了。
当另外一个线程get 这个Entry List 死循环的key的时候,这个get也会一直执行。最后结果是越来越多的线程死循环,最后导致服务器dang掉。我们一般认为HashMap重复插入某个值的时候,会覆盖之前的值,这个没错。但是对于多线程访问的时候,由于其内部实现机制(在多线程环境且未作同步的情况下,对同一个HashMap做put操作可能导致两个或以上线程同时做rehash动作,就可能导致循环键表出现,一旦出现线程将无法终止,持续占用CPU,导致CPU使用率居高不下),就可能出现安全问题了。
使用jstack工具dump出问题的那台服务器的栈信息。死循环的话,首先查找RUNNABLE的线程,找到问题代码如下:
java.lang.Thread.State:RUNNABLE
at java.util.HashMap.get(HashMap.java:303)
at com.sohu.twap.service.logic.TransformTweeter.doTransformTweetT5(TransformTweeter.java:183)
共出现了23次。
java.lang.Thread.State:RUNNABLE
at java.util.HashMap.put(HashMap.java:374)
at com.sohu.twap.service.logic.TransformTweeter.transformT5(TransformTweeter.java:816)
共出现了3次。
注意:不合理使用HashMap导致出现的是死循环而不是死锁。
多线程put的时候可能导致元素丢失
主要问题出在addEntry方法的new Entry (hash, key, value, e),如果两个线程都同时取得了e,则他们下一个元素都是e,然后赋值给table元素的时候有一个成功有一个丢失。
put非null元素后get出来的却是null
在transfer方法中代码如下:
void transfer(Entry[] newTable) {
     Entry[] src = table;
     int newCapacity = newTable.length;
     for ( int j = 0 ; j < src.length; j++) {
         Entry e = src[j];
         if (e != null ) {
             src[j] = null ;
             do {
                 Entry next = e.next;
                 int i = indexFor(e.hash, newCapacity);
                 e.next = newTable[i];
                 newTable[i] = e;
                 e = next;
             } while (e != null );
         }
     }
}
在这个方法里,将旧数组赋值给src,遍历src,当src的元素非null时,就将src中的该元素置null,即将旧数组中的元素置null了,也就是这一句:
if (e != null ) {
         src[j] = null ;
此时若有get方法访问这个key,它取得的还是旧数组,当然就取不到其对应的value了。
总结:HashMap未同步时在并发程序中会产生许多微妙的问题,难以从表层找到原因。所以使用HashMap出现了违反直觉的现象,那么可能就是并发导致的了。
HashMap数据结构
我需要简单地说一下HashMap这个经典的数据结构。
HashMap通常会用一个指针数组(假设为table[])来做分散所有的key,当一个key被加入时,会通过Hash算法通过key算出这个数组的下标i,然后就把这个 插到table[i]中,如果有两个不同的key被算在了同一个i,那么就叫冲突,又叫碰撞,这样会在table[i]上形成一个链表。
我们知道,如果table[]的尺寸很小,比如只有2个,如果要放进10个keys的话,那么碰撞非常频繁,于是一个O(1)的查找算法,就变成了链表遍历,性能变成了O(n),这是Hash表的缺陷。
所以,Hash表的尺寸和容量非常的重要。一般来说,Hash表这个容器当有数据要插入时,都会检查容量有没有超过设定的thredhold,如果超过,需要增大Hash表的尺寸,但是这样一来,整个Hash表里的元素都需要被重算一遍。这叫rehash,这个成本相当的大。
HashMap的rehash源代码
下面,我们来看一下Java的HashMap的源代码。Put一个Key,Value对到Hash表中:
public V put(K key, V value)
{
     ......
     //算Hash值
     int hash = hash(key.hashCode());
     int i = indexFor(hash, table.length);
     //如果该key已被插入,则替换掉旧的value (链接操作)
     for (Entry e = table[i]; e != null ; e = e.next) {
         Object k;
         if (e.hash == hash && ((k = e.key) == key || key.equals(k))) {
             V oldValue = e.value;
             e.value = value;
             e.recordAccess( this );
             return oldValue;
         }
     }
     modCount++;
     //该key不存在,需要增加一个结点
     addEntry(hash, key, value, i);
     return null ;
}
检查容量是否超标:
void addEntry( int hash, K key, V value, int bucketIndex)
{
     Entry e = table[bucketIndex];
     table[bucketIndex] = new Entry(hash, key, value, e);
     //查看当前的size是否超过了我们设定的阈值threshold,如果超过,需要resize
     if (size++ >= threshold)
         resize( 2 * table.length);
}
新建一个更大尺寸的hash表,然后把数据从老的Hash表中迁移到新的Hash表中。
void resize( int newCapacity)
{
     Entry[] oldTable = table;
     int oldCapacity = oldTable.length;
     ......
     //创建一个新的Hash Table
     Entry[] newTable = new Entry[newCapacity];
     //将Old Hash Table上的数据迁移到New Hash Table上
     transfer(newTable);
     table = newTable;
     threshold = ( int )(newCapacity * loadFactor);
}
迁移的源代码,注意高亮处:
void transfer(Entry[] newTable)
{
     Entry[] src = table;
     int newCapacity = newTable.length;
     //下面这段代码的意思是:
     //  从OldTable里摘一个元素出来,然后放到NewTable中
     for ( int j = 0 ; j < src.length; j++) {
         Entry e = src[j];
         if (e != null ) {
             src[j] = null ;
             do {
                 Entry next = e.next;
                 int i = indexFor(e.hash, newCapacity);
                 e.next = newTable[i];
                 newTable[i] = e;
                 e = next;
             } while (e != null );
         }
     }
}
好了,这个代码算是比较正常的。而且没有什么问题。
正常的ReHash过程
画了个图做了个演示。
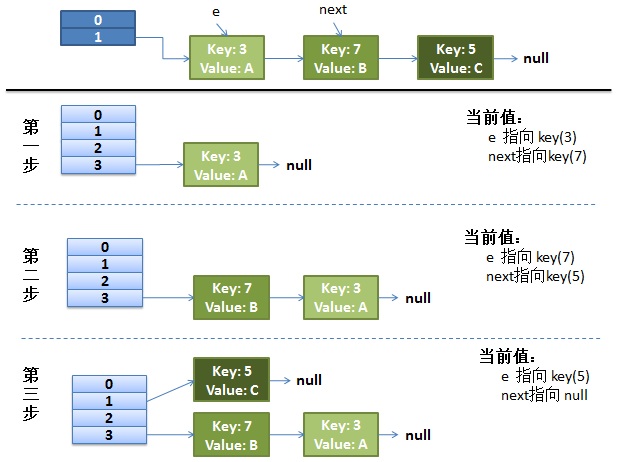
我假设了我们的hash算法就是简单的用key mod 一下表的大小(也就是数组的长度)。
最上面的是old hash 表,其中的Hash表的size=2, 所以key = 3, 7, 5,在mod 2以后都冲突在table1这里了。
接下来的三个步骤是Hash表 resize成4,然后所有的 重新rehash的过程。
并发的Rehash过程
(1)假设我们有两个线程。我用红色和浅蓝色标注了一下。我们再回头看一下我们的 transfer代码中的这个细节:
do {
     Entry next = e.next; // <--假设线程一执行到这里就被调度挂起了
     int i = indexFor(e.hash, newCapacity);
     e.next = newTable[i];
     newTable[i] = e;
     e = next;
} while (e != null );
而我们的线程二执行完成了。于是我们有下面的这个样子。
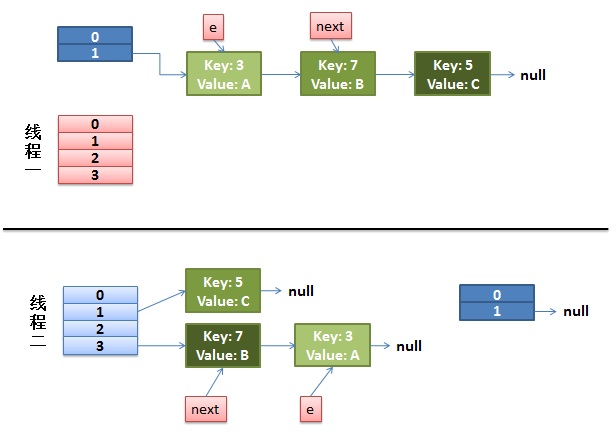
注意:因为Thread1的 e 指向了key(3),而next指向了key(7),其在线程二rehash后,指向了线程二重组后的链表。我们可以看到链表的顺序被反转后。
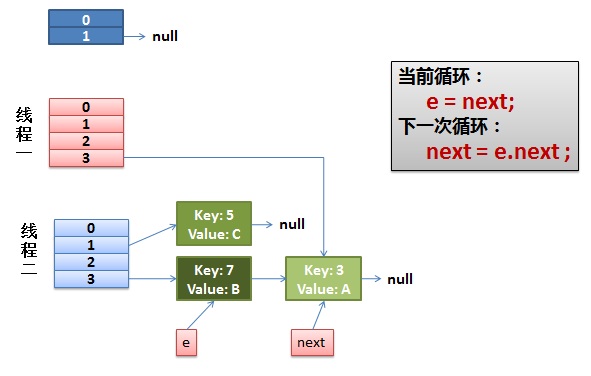
(2)线程一被调度回来执行。
先是执行 newTalbe[i] = e。
然后是e = next,导致了e指向了key(7)。
而下一次循环的next = e.next导致了next指向了key(3)。
(3)一切安好。 线程一接着工作。把key(7)摘下来,放到newTable[i]的第一个,然后把e和next往下移。
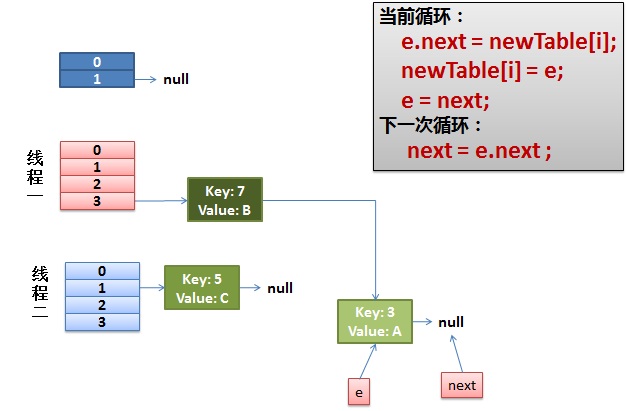
(4)环形链接出现。 e.next = newTable[i] 导致 key(3).next 指向了 key(7)。注意:此时的key(7).next 已经指向了key(3), 环形链表就这样出现了。
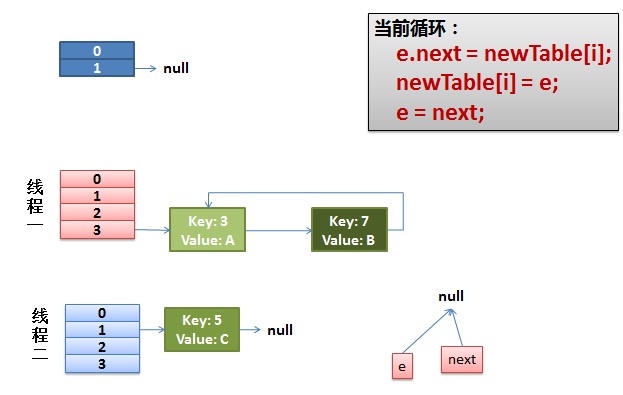
于是,当我们的线程一调用到,HashTable.get(11)时,悲剧就出现了——Infinite Loop。
三种解决方案
Hashtable替换HashMap
Hashtable 是同步的,但由迭代器返回的 Iterator 和由所有 Hashtable 的“collection 视图方法”返回的 Collection 的 listIterator 方法都是快速失败的:在创建 Iterator 之后,如果从结构上对 Hashtable 进行修改,除非通过 Iterator 自身的移除或添加方法,否则在任何时间以任何方式对其进行修改,Iterator 都将抛出 ConcurrentModificationException。因此,面对并发的修改,Iterator 很快就会完全失败,而不冒在将来某个不确定的时间发生任意不确定行为的风险。由 Hashtable 的键和值方法返回的 Enumeration 不是快速失败的。
注意,迭代器的快速失败行为无法得到保证,因为一般来说,不可能对是否出现不同步并发修改做出任何硬性保证。快速失败迭代器会尽最大努力抛出 ConcurrentModificationException。因此,为提高这类迭代器的正确性而编写一个依赖于此异常的程序是错误做法:迭代器的快速失败行为应该仅用于检测程序错误。
Collections.synchronizedMap将HashMap包装起来
返回由指定映射支持的同步(线程安全的)映射。为了保证按顺序访问,必须通过返回的映射完成对底层映射的所有访问。在返回的映射或其任意 collection 视图上进行迭代时,强制用户手工在返回的映射上进行同步:
Map m = Collections.synchronizedMap( new HashMap());
...
Set s = m.keySet();  // Needn't be in synchronized block
...
synchronized (m) {  // Synchronizing on m, not s!
Iterator i = s.iterator(); // Must be in synchronized block
     while (i.hasNext())
         foo(i.next());
}
不遵从此建议将导致无法确定的行为。如果指定映射是可序列化的,则返回的映射也将是可序列化的。
ConcurrentHashMap替换HashMap
支持检索的完全并发和更新的所期望可调整并发的哈希表。此类遵守与 Hashtable 相同的功能规范,并且包括对应于 Hashtable 的每个方法的方法版本。不过,尽管所有操作都是线程安全的,但检索操作不必锁定,并且不支持以某种防止所有访问的方式锁定整个表。此类可以通过程序完全与 Hashtable 进行互操作,这取决于其线程安全,而与其同步细节无关。 检索操作(包括 get)通常不会受阻塞,因此,可能与更新操作交迭(包括 put 和 remove)。检索会影响最近完成的更新操作的结果。对于一些聚合操作,比如 putAll 和 clear,并发检索可能只影响某些条目的插入和移除。类似地,在创建迭代器/枚举时或自此之后,Iterators 和 Enumerations 返回在某一时间点上影响哈希表状态的元素。它们不会抛出 ConcurrentModificationException。不过,迭代器被设计成每次仅由一个线程使用。


深入解析Java中局部变量未初始化编译报错与成员变量自动赋予默认值的机制差异,涵盖JVM内存分配、编译期确定性赋值检查与实际排查修复方案。

详细讲解在Java中获取当前系统时间并进行格式化输出的两种核心方案:基于Java 8全新日期时间API的DateTimeFormatter与传统遗留的SimpleDateFormat,包含完整代码示例、线程安全机制对比及生产选型建议。

深入解析Java中final变量与static final常量的定义、内存语义、初始化时机及合法赋值路径,涵盖编译期常量优化与实战避坑指南。


本文提供Java标准库HttpClient发起HTTP GET/POST请求并结合Jackson进行JSON数据反序列化与序列化的完整代码示例与工程实践指南。

详细分析Java递归调用出现StackOverflowError的原因,结合代码说明线程栈、栈帧和递归深度之间的关系,并介绍终止条件排查、迭代改写、减少栈帧开销以及通过-Xss调整JVM栈空间的方法。

针对Java中常见的NullPointerException(NPE),本文从堆栈日志定位、典型代码触发场景、具体修复代码对比到防御体系进行系统讲解,提供实用且易上手的排查与修复方案。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



