

Python第三方模块apscheduler的安装和使用方法详解
apscheduler模块安装apscheduler模块pipinstallapschedulerapscheduler模块介绍APScheduler(AdvancedPythonScheduler)是一个轻量级的Python定时任务调度框架(Python库)。APScheduler有三个内置的调度系统,其中包括:cron式调度(可选开始/结束时间)基于间隔的执行(以偶数间隔运行作业,也可以选择开始/结束时间)一次性延迟执行任务(在指定的日期/时间内运行作业一次)支持的后端存储作业APScheduler可
apscheduler 模块
安装apscheduler 模块
pip install apscheduler
apscheduler 模块介绍
APScheduler(Advanced Python Scheduler)是一个轻量级的Python定时任务调度框架(Python库)。
APScheduler有三个内置的调度系统,其中包括:
cron式调度(可选开始/结束时间)
基于间隔的执行(以偶数间隔运行作业,也可以选择开始/结束时间)
一次性延迟执行任务(在指定的日期/时间内运行作业一次)
支持的后端存储作业
APScheduler可以任意混合和匹配调度系统和作业存储的后端,其中支持后端存储作业包括:
Memory
SQLAlchemy
MongoDB
Redis
RethinkDB
ZooKeeper
APScheduler有四种组成部分
triggers(触发器)中包含调度逻辑,每个作业都由自己的触发器来决定下次运行时间。除了他们自己初始配置意外,触发器完全是无状态的。
job stores(作业存储器)存储被调度的作业,默认的作业存储器只是简单地把作业保存在内存中,其他的作业存储器则是将作业保存在数据库中。当作业被保存到一个持久化的作业存储器中的时候,该作业的数据会被序列化,并在加载时被反序列化。作业存储器不能共享调度器。
executors(执行器)处理作业的运行,他们通常通过在作业中提交指定的可调用对象到一个线程或者进程池来进行。当作业完成时,执行器将会通知调度器。
schedulers(调度器)配置作业存储器和执行器可以在调度器中完成,例如添加、修改和移除作业。根据不同的应用场景可以选用不同的调度器,可选的有BlockingScheduler,BackgroundScheduler,AsyncIOScheduler,GeventScheduler,TornadoScheduler,TwistedScheduler,QtScheduler 7种。
各组件简介
触发器
当你调度作业的时候,你需要为这个作业选择一个触发器,用来描述这个作业何时被触发,APScheduler有三种内置的触发器类型:
date: 一次性指定日期;
interval: 在某个时间范围内间隔多长时间执行一次;
cron :Linux crontab格式兼容,最为强大。
date 最基本的一种调度,作业只会执行一次。它的参数如下:
1.run_date
(datetime|str) – 作业的运行日期或时间
2.timezone
(datetime.tzinfo|str) – 指定时区
作业存储器
如果你的应用在每次启动的时候都会重新创建作业,那么使用默认的作业存储器(MemoryJobStore)即可,但是如果你需要在调度器重启或者应用程序奔溃的情况下任然保留作业,你应该根据你的应用环境来选择具体的作业存储器。例如:使用Mongo或者SQLAlchemy JobStore (用于支持大多数RDBMS)
执行器
对执行器的选择取决于你使用上面哪些框架,大多数情况下,使用默认的ThreadPoolExecutor已经能够满足需求。如果你的应用涉及到CPU密集型操作,你可以考虑使用ProcessPoolExecutor来使用更多的CPU核心。你也可以同时使用两者,将ProcessPoolExecutor作为第二执行器。
选择合适的调度器
BlockingScheduler : 当调度器是你应用中唯一要运行的东西时
BackgroundScheduler : 当你没有运行任何其他框架并希望调度器在你应用的后台执行时使用。
AsyncIOScheduler : 当你的程序使用了asyncio(一个异步框架)的时候使用。
GeventScheduler : 当你的程序使用了gevent(高性能的Python并发框架)的时候使用。
TornadoScheduler : 当你的程序基于Tornado(一个web框架)的时候使用。
TwistedScheduler : 当你的程序使用了Twisted(一个异步框架)的时候使用
QtScheduler : 如果你的应用是一个Qt应用的时候可以使用。
apscheduler 模块使用
添加作业
有两种方式可以添加一个新的作业:
add_job来添加作业;
# -*- coding:utf-8 -*-
from apscheduler.schedulers.blocking import BlockingScheduler
import datetime

def my_job1():
    print('my_job1 is running, Now is %s' % datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S"))

def my_job2():
    print('my_job2 is running, Now is %s' % datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S"))

sched = BlockingScheduler()
# 每隔5秒运行一次my_job1
sched.add_job(my_job1, 'interval', seconds=5, id='my_job1')
# 每隔5秒运行一次my_job2
sched.add_job(my_job2, 'cron', second='*/5', id='my_job2')
sched.start()
装饰器模式添加作业。
# -*- coding:utf-8 -*-
from apscheduler.schedulers.blocking import BlockingScheduler
import datetime

sched = BlockingScheduler()

# 每隔5秒运行一次my_job1
@sched.scheduled_job('interval', seconds=5, id='my_job1')
def my_job1():
    print('my_job1 is running, Now is %s' % datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S"))

# 每隔5秒运行一次my_job2
@sched.scheduled_job('cron', second='*/5', id='my_job2')
def my_job2():
    print('my_job2 is running, Now is %s' % datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S"))

sched.start()
移除作业
没有移除作业
# -*- coding:utf-8 -*-
from apscheduler.schedulers.blocking import BlockingScheduler
import datetime

def my_job(text=""):
    print(text, 'my_job1 is running, Now is %s' % datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S"))

sched = BlockingScheduler()
job = sched.add_job(my_job, 'interval', seconds=2, args=['第一个作业'])
# #如果有多个任务序列的话可以给每个任务设置ID号,可以根据ID号选择清除对象,且remove放到start前才有效
sched.add_job(my_job, 'interval', seconds=2, id='my_job_id', args=['第二个作业'])
sched.start()
代码执行结果:
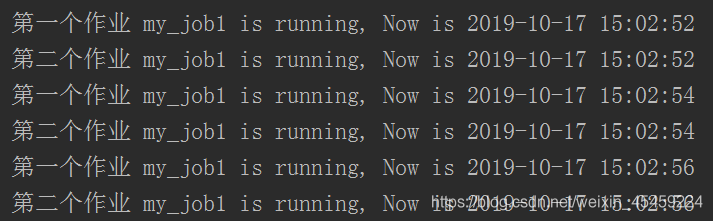
使用remove() 移除作业
# -*- coding:utf-8 -*-
from apscheduler.schedulers.blocking import BlockingScheduler
import datetime

def my_job(text=""):
    print(text, 'my_job1 is running, Now is %s' % datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S"))

sched = BlockingScheduler()
job = sched.add_job(my_job, 'interval', seconds=2, args=['第一个作业'])
job.remove()
# #如果有多个任务序列的话可以给每个任务设置ID号,可以根据ID号选择清除对象,且remove放到start前才有效
sched.add_job(my_job, 'interval', seconds=2, id='my_job_id', args=['第二个作业'])
sched.start()
代码执行结果:
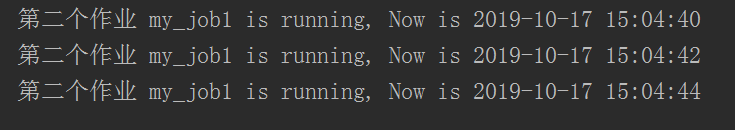
使用remove_job()移除作业
# -*- coding:utf-8 -*-
from apscheduler.schedulers.blocking import BlockingScheduler
import datetime

def my_job(text=""):
    print(text, 'my_job1 is running, Now is %s' % datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S"))

sched = BlockingScheduler()
job = sched.add_job(my_job, 'interval', seconds=2, args=['第一个作业'])
# #如果有多个任务序列的话可以给每个任务设置ID号,可以根据ID号选择清除对象,且remove放到start前才有效
sched.add_job(my_job, 'interval', seconds=2, id='my_job_id', args=['第二个作业'])
sched.remove_job('my_job_id')
sched.start()
代码执行结果:
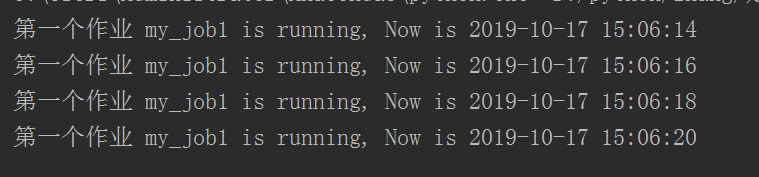
触发器类型
APScheduler有3中内置的触发器类型:
新建一个调度器(scheduler);
添加一个调度任务(job store);
运行调度任务。
代码实现
# -*- coding:utf-8 -*-
import time
import datetime
from apscheduler.schedulers.blocking import BlockingScheduler

def my_job(text="默认值"):
    print(text, time.strftime('%Y-%m-%d %H:%M:%S', time.localtime(time.time())))

sched = BlockingScheduler()
sched.add_job(my_job, 'interval', seconds=3, args=['3秒定时'])
# 2018-3-17 00:00:00 执行一次,args传递一个text参数
sched.add_job(my_job, 'date', run_date=datetime.date(2019, 10, 17), args=['根据年月日定时执行'])
# 2018-3-17 13:46:00 执行一次,args传递一个text参数
sched.add_job(my_job, 'date', run_date=datetime.datetime(2019, 10, 17, 14, 10, 0), args=['根据年月日时分秒定时执行'])
# sched.start()
"""
interval 间隔调度,参数如下:
    weeks (int) – 间隔几周
    days (int) – 间隔几天
    hours (int) – 间隔几小时
    minutes (int) – 间隔几分钟
    seconds (int) – 间隔多少秒
    start_date (datetime|str) – 开始日期
    end_date (datetime|str) – 结束日期
    timezone (datetime.tzinfo|str) – 时区
"""
"""
cron参数如下:
    year (int|str) – 年,4位数字
    month (int|str) – 月 (范围1-12)
    day (int|str) – 日 (范围1-31)
    week (int|str) – 周 (范围1-53)
    day_of_week (int|str) – 周内第几天或者星期几 (范围0-6 或者 mon,tue,wed,thu,fri,sat,sun)
    hour (int|str) – 时 (范围0-23)
    minute (int|str) – 分 (范围0-59)
    second (int|str) – 秒 (范围0-59)
    start_date (datetime|str) – 最早开始日期(包含)
    end_date (datetime|str) – 最晚结束时间(包含)
    timezone (datetime.tzinfo|str) – 指定时区
"""
# my_job将会在6,7,8,11,12月的第3个周五的1,2,3点运行
sched.add_job(my_job, 'cron', month='6-8,11-12', day='3rd fri', hour='0-3')
# 截止到2018-12-30 00:00:00,每周一到周五早上五点半运行job_function
sched.add_job(my_job, 'cron', day_of_week='mon-fri', hour=5, minute=30, end_date='2018-12-31')

# 表示2017年3月22日17时19分07秒执行该程序
sched.add_job(my_job, 'cron', year=2017, month=3, day=22, hour=17, minute=19, second=7)

# 表示任务在6,7,8,11,12月份的第三个星期五的00:00,01:00,02:00,03:00 执行该程序
sched.add_job(my_job, 'cron', month='6-8,11-12', day='3rd fri', hour='0-3')

# 表示从星期一到星期五5:30(AM)直到2014-05-30 00:00:00
sched.add_job(my_job, 'cron', day_of_week='mon-fri', hour=5, minute=30, end_date='2014-05-30')

# 表示每5秒执行该程序一次,相当于interval 间隔调度中seconds = 5
sched.add_job(my_job, 'cron', second='*/5', args=['5秒定时'])
sched.start()| cron表达式 | 参数 | 描述 |
|---|---|---|
| * | any | Fire on every value |
| */a | any | Fire every a values, starting from the minimum |
| a-b | any | Fire on any value within the a-b range (a must be smaller than b) |
| a-b/c | any | Fire every c values within the a-b range |
| xth y | day | Fire on the x -th occurrence of weekday y within the month |
| last x | day | Fire on the last occurrence of weekday x within the month |
| last | day | Fire on the last day within the month |
| x,y,z | any | Fire on any matching expression; can combine any number of any of the above expressions |
使用SQLAlchemy作业存储器存放作业
# -*- coding:utf-8 -*-
from apscheduler.schedulers.blocking import BlockingScheduler
from datetime import datetime
import logging
sched = BlockingScheduler()

def my_job():
    print('my_job is running, Now is %s' % datetime.now().strftime("%Y-%m-%d %H:%M:%S"))

# 使用sqlalchemy作业存储器
# 根据自己电脑安装的库选择用什么连接 ,如pymysql   其中:scrapy表示数据库的名称,操作数据库之前应创建对应的数据库
url = 'mysql+pymysql://root:123456@localhost:3306/scrapy?charset=utf8'
sched.add_jobstore('sqlalchemy', url=url)
# 添加作业
sched.add_job(my_job, 'interval', id='myjob', seconds=5)

log = logging.getLogger('apscheduler.executors.default')
log.setLevel(logging.INFO)  # DEBUG
# 设定日志格式
fmt = logging.Formatter('%(levelname)s:%(name)s:%(message)s')
h = logging.StreamHandler()
h.setFormatter(fmt)
log.addHandler(h)

sched.start()
暂停和恢复作业
# 暂停作业:
apsched.job.Job.pause()
apsched.schedulers.base.BaseScheduler.pause_job()
# 恢复作业:
apsched.job.Job.resume()
apsched.schedulers.base.BaseScheduler.resume_job()
获得job列表
get_jobs(),它会返回所有的job实例;
使用print_jobs()来输出所有格式化的作业列表;
get_job(job_id=“任务ID”)获取指定任务的作业列表。
代码实现:
# -*- coding:utf-8 -*-
from apscheduler.schedulers.blocking import BlockingScheduler
import datetime

def my_job(text=""):
    print(text, 'my_job1 is running, Now is %s' % datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S"))

sched = BlockingScheduler()

job = sched.add_job(my_job, 'interval', seconds=2, args=['第一个作业'])
sched.add_job(my_job, 'interval', seconds=2, id='my_job_id', args=['第二个作业'])

print(sched.get_jobs())

print(sched.get_job(job_id="my_job_id"))

sched.print_jobs()
sched.start()
关闭调度器
默认情况下调度器会等待所有正在运行的作业完成后,关闭所有的调度器和作业存储。如果你不想等待,可以将wait选项设置为False。
sched.shutdown()
sched.shutdown(wait=False)

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



