

如何使用 Python request 模块实现翻译 API
request库的基本使用安装要使用Python中的requests库,首先需要使用pip安装它。您可以在终端中运行以下命令来完成此操作:pipinstallrequests使用安装库后,您可以使用它来进行HTTP请求。以下是如何进行GET请求的示例:importrequestsresponse=requests.get('https://www.baidu.com')print(response.text)在此示例中,我们导入requests库,然后使用get方法进行GET请求到http
request库的基本使用
安装
要使用Python中的requests库,首先需要使用pip安装它。您可以在终端中运行以下命令来完成此操作:
pip install requests
使用
安装库后,您可以使用它来进行HTTP请求。以下是如何进行GET请求的示例:
import requests

response = requests.get('https://www.baidu.com')
print(response.text)在此示例中,我们导入requests库,然后使用get方法进行GET请求到https://www.baidu.com。服务器的响应存储在response变量中,我们将响应文本打印到控制台。
还可以将参数传递给get方法,以在请求中包含查询参数:
import requests

params = {'key1': 'value1', 'key2': 'value2'}
response = requests.get('https://www.example.com', params=params)
print(response.url)
在此示例中,我们将查询参数的字典传递给get方法的params参数。生成的URL将包括查询参数,我们将URL打印到控制台。
还可以使用post方法进行POST请求:
import requests

data = {'key1': 'value1', 'key2': 'value2'}
response = requests.post('https://www.example.com', data=data)
print(response.text)
在此示例中,我们将数据的字典传递给post方法的data参数。数据将在请求的正文中发送,我们将响应文本打印到控制台。
开发自己的翻译接口
分析百度翻译
打开百度翻译地址,然后按F12打开开发者模式,输入翻译的内容,点击翻译,通过下图,可以清楚看到请求的地址和请求的参数
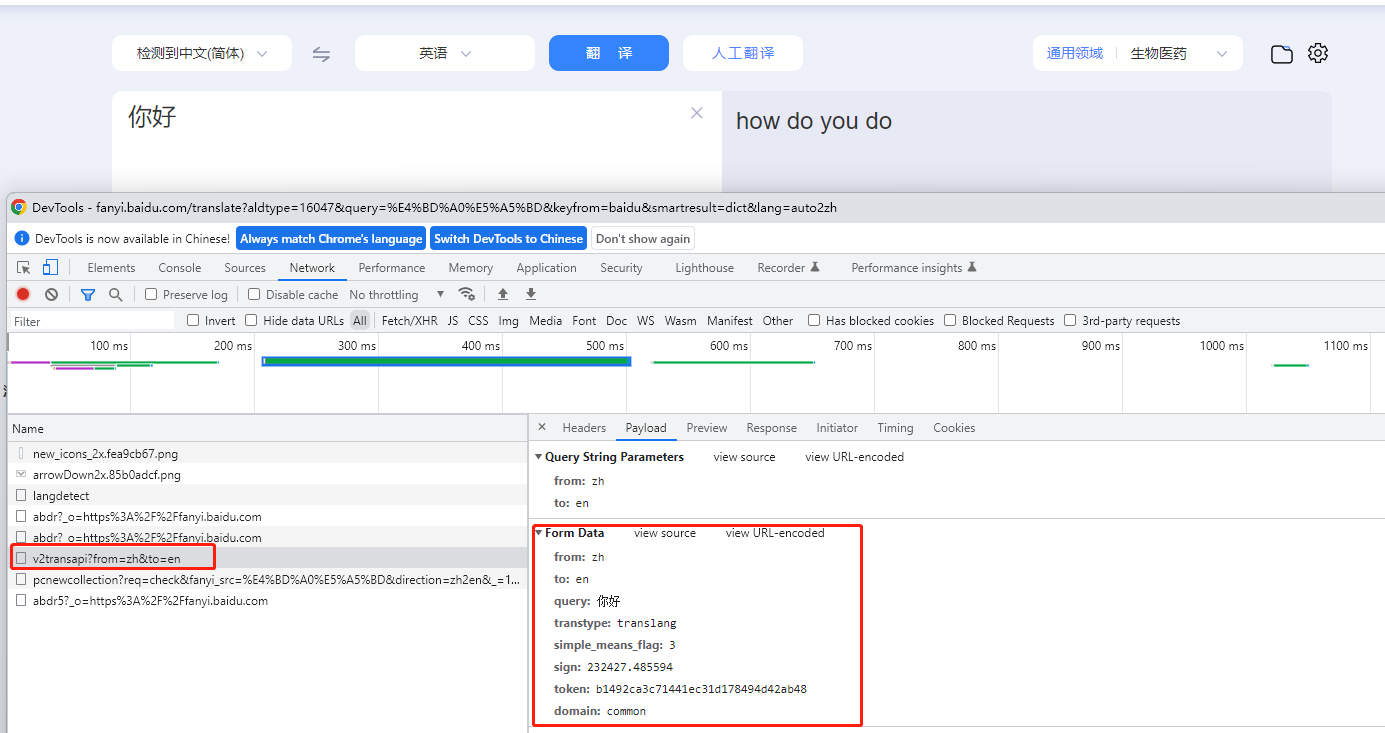
百度翻译通过向https://fanyi.baidu.com/v2transapi发送post请求,发送的数据中只有sign是不断变化的,搜索v2transapi发现sign字段是通过js通过你要发送的数据字符串进行加密得到的。
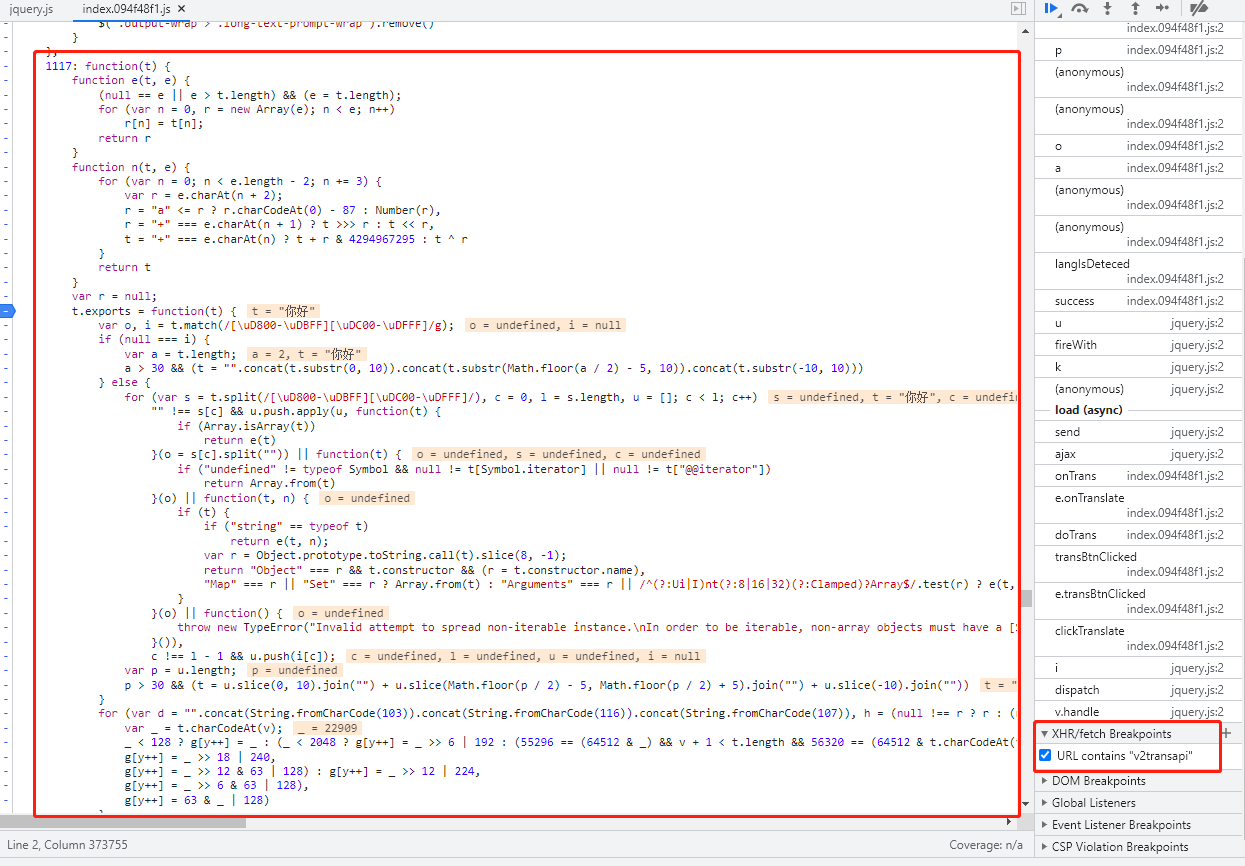
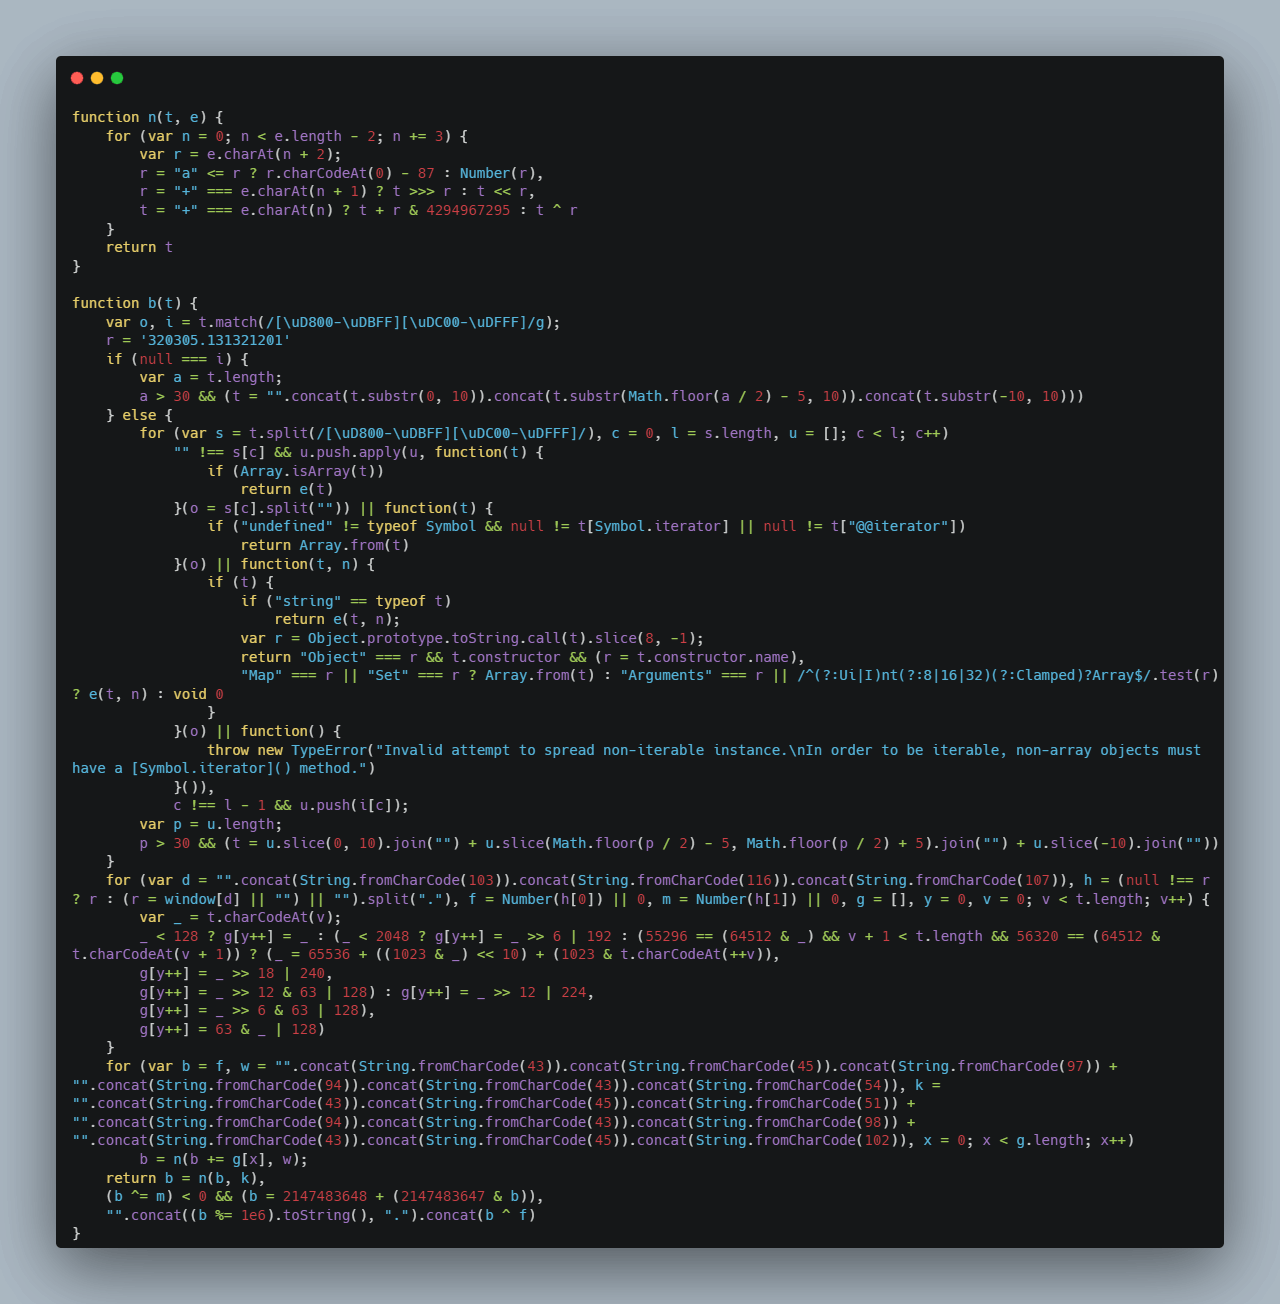
通过百度翻译的js分析得出加密的关键代码如下:
现在已经搞清楚了整个调用的流程,所有的参数都可以自己构造。这样就可以写代码了。
写接口代码
1、为了防止请求失败,需要模仿浏览器请求,在请求时加上请求头,我们采用fake_useragent这个第三方库,随机生成不同的User-Agent。关键代码如下:
from fake_useragent import UserAgent
headers = {'User-Agent': UserAgent().random}2、生成sign参数,由于加密的js代码我们看不明白,直接调用python的第三方库执行js代码,使用前需要安装execjs库,执行如下的代码:
pip3 install PyExecJS
这个库使用方法也很简单,例如,上面我们已经把百度的加密js代码已经提取出来了,并新建一个js文件,把内容复制进去。关键代码如下:
    def generate_sign(self,query):
        try:
            if os.path.isfile("./baidu.js"):
                with open("./baidu.js", 'r', encoding="utf-8") as f:
                    baidu_js = f.read()
            ctx = execjs.compile(baidu_js)
            return ctx.call('b', query)
        except Exception as e:
print(e)先把js文件读到缓存中,再通过execjs调用该对象。最后通过调用call方法执行js文件的里面的方法,其中b是对应js的方法,query是js中b方法的参数。
调用成功后,返回如下:

3、获取token值,通过观察百度翻译页面的源码,发现token是存放在页面中的,这样我们就可以通过请求页面获取到token.
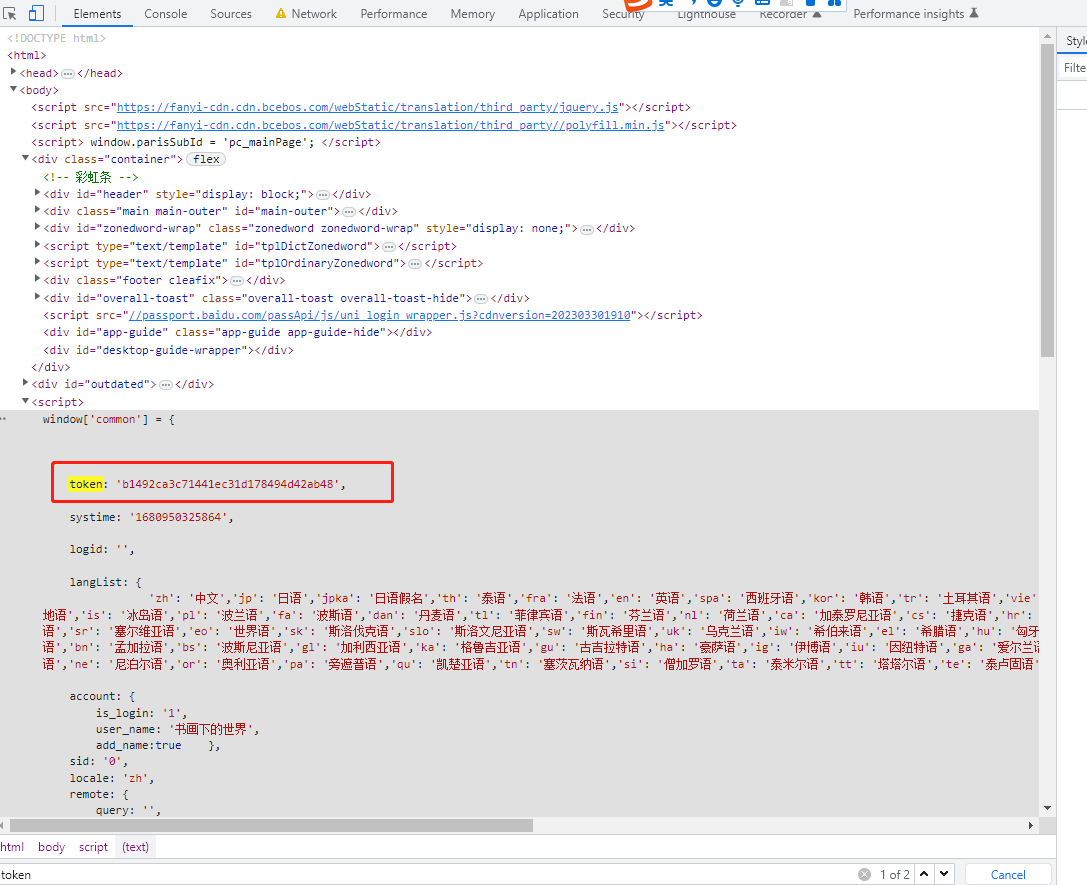
res = request.get("https://fanyi.baidu.com").content.decode()
token = re.findall(r"token: '(.*)',", res, re.M)[0]
4、到目前为止所有的请求参数已经有了,这样我们就可以开始构造请求。核心代码如下:
    url = 'https://fanyi.baidu.com/v2transapi'
    sign = generate_sign("你好")
    data = {
        "from": "zh",
        "to": 'en',
        "query": "你好",
        "transtype": "translang",
        "simple_means_flag": "3",
        "sign": sign,
        "token": self.token,
        "domain": "common"
    }
    res = requests.post(
        url=url,
        params={"from": "zh", "to": 'en'},
        data=data,
        headers = {
            'User-Agent': UserAgent().random,
        }
    )

    res.json().get("trans_result").get("data")[0].get("dst")
请求成功后,会返回如下图:

通过实际的调用中发现不是每次请求成功的,所以需要多次进行请求,通过一个循环操作,当清楚成功就跳出循环,关键代码如下:
        tryTimes = 0
        try:
            while tryTimes < 100:
                res = self.session.post(
                    url=url,
                    params={"from": fromLan, "to": toLan},
                    data=data,
                )
                if "trans_result" in res.text:
                    break
                tryTimes += 1
return res.json().get("trans_result").get("data")[0].get("dst")这样我们就已经完成利用百度翻译接口,做成自己的翻译接口调用了。可以根据自己的需求采用Flask或Fastapi开发API接口了。下面是全部的代
import requests
import execjs
import os
import re
import json
from loguru import logger
from fake_useragent import UserAgent

class Baidu_translate:

    def  __init__(self):
        self.session=request.Session()
        self.session.headers={
            'User-Agent': UserAgent( ).random,
            "Host":"fanyi.baidu.com",
            "X-Requested-With":"XMLHttpRequest",
            "sec-ch-ua":'"Not?A_Brand";="8","Chromium";v="108","Microsoft Edge";V="108",
            "sec-ch-ua-mobile":"?0",
            "Sec-Fetch-Dest":"document",
            "Sec-Fetch-Mode":"navigate",
            "Sec-Fetch-Site": "same-origin",
            "Sec-Fetch-User":"?1",
            "Connection":"keep-alive",
        }

        self.session.get("https://fanyi.baidu.com" )
        res = self.session.get("https://fanyi.baidu.com").content.decode( )
        self.token = re.findall(r"token: '(.*)',",res,re.M)[0]

    def generate_sign(self,query):
        try:
            if os.path.isfile("./baidu.js"):
                with open("./baidu.js",'r',encoding="utf-8") as f:
                    baidu_js = f.read( )
            ctx = execjs.compile(baidu_js)
            return ctx.call('b',query)
        except Exception as e:
            print(e)

   def lang_detect(self,src: str) -> str:
       url = "https://fanyi.baidu.com/langdetect"
       fromLan = self.session.post(url, data={"query": src}).json()["lan"]
       return fromLan

   def translate(self,query: str, tolan: str = "", fromLan: str = "") -> str:

       if fromLan == "":
           fromLan = self.lang_detect(query)

       if toLan == "":
           toLan = "zh" if fromLan != "zh" else "en"

       url = 'https://fanyi.baidu.com/v2transapi'
       sign = self.generate_sign(query)
       data = {
           "from" : fromLan,
           "to": toLan,
           "query": query,
           "transtype":"translang",
           "simple_means_flag":"3",
           "sign" : sign,
           "token": self.token,
           "domain":"common"
       }
       tryTimes = 0
       try:
           while tryTimes < 100:
               res = self.session.post(
                   url=url,
                   params={"from": fromLan,"to": toLan},
                   data=data,
               )
               if "trans_result" in res.text:
                  break
               tryTimes +=1
        return res.json().get("trans_result").get("data")[0].get("dst")
    except Exception as e:
        print(e)

def test():
    url ='https://fanyi.baidu.com/v2transapi'
    sign = generate_sign("你好")
    data = {
        "from":"zh",
        "to":' en',
        "query":"你好",
        "transtype":"translang",
        "simple_means_flag":"3",
        "sign": sign,
        "token": self.token,
        "domain": "common"
        }
    res = requests.post(
        url=url,
        params={"from": "zh","to":'en'},
        data=data,
        headers = {
            'User-Agent': UserAgent( ).random,
        }
    )

    res .json()

if _name__ == "__main__":
    baidu_tran = Baidu_Translate()
sign = baidu_tran.generate_sign("你好") 
学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



