

面试记录:HashMap核心知识,扰动函数、负载因子、扩容链表拆分
一、前言得益于DougLea老爷子的操刀,让HashMap成为使用和面试最频繁的API,没办法设计的太优秀了!HashMap最早出现在JDK1.2中,底层基于散列算法实现。HashMap允许null键和null值,在计算哈键的哈希值时,null键哈希值为0。HashMap并不保证键值对的顺序,这意味着在进行某些操作后,键值对的顺序可能会发生变化。另外,需要注意的是,HashMap是非线程安全类,在多线程环境下可能会存在问题。HashMap最早在JDK1.2中就出现了,底层是基
一、前言
得益于Doug Lea老爷子的操刀,让HashMap成为使用和面试最频繁的API,没办法设计的太优秀了!
HashMap 最早出现在 JDK 1.2中,底层基于散列算法实现。HashMap 允许 null 键和 null 值,在计算哈键的哈希值时,null 键哈希值为 0。HashMap 并不保证键值对的顺序,这意味着在进行某些操作后,键值对的顺序可能会发生变化。另外,需要注意的是,HashMap 是非线程安全类,在多线程环境下可能会存在问题。
HashMap 最早在JDK 1.2中就出现了,底层是基于散列算法实现,随着几代的优化更新到目前为止它的源码部分已经比较复杂,涉及的知识点也非常多,在JDK 1.8中包括;1、散列表实现、2、扰动函数、3、初始化容量、4、负载因子、5、扩容元素拆分、6、链表树化、7、红黑树、8、插入、9、查找、10、删除、11、遍历、12、分段锁等等,因涉及的知识点较多所以需要分开讲解,本章节我们会先把目光放在前五项上,也就是关于数据结构的使用上。
数据结构相关往往与数学离不开,学习过程中建议下载相应源码进行实验验证,可能这个过程有点烧脑,但学会后不用死记硬背就可以理解这部分知识。
二、资源下载
本章节涉及的源码和资源在工程,interview-04中,包括;
10万单词测试数据,在doc文件夹
扰动函数excel展现,在doc文件夹
测试源码部分在interview-04工程中
可以通过关注公众号:bugstack虫洞栈,回复下载进行获取{回复下载后打开获得的链接,找到编号ID:19}
三、源码分析
1. 写一个最简单的HashMap
学习HashMap前,最好的方式是先了解这是一种怎么样的数据结构来存放数据。而HashMap经过多个版本的迭代后,乍一看代码还是很复杂的。就像你原来只穿个裤衩,现在还有秋裤和风衣。所以我们先来看看最根本的HashMap是什么样,也就是只穿裤衩是什么效果,之后再去分析它的源码。
问题: 假设我们有一组7个字符串,需要存放到数组中,但要求在获取每个元素的时候时间复杂度是O(1)。也就是说你不能通过循环遍历的方式进行获取,而是要定位到数组ID直接获取相应的元素。
方案: 如果说我们需要通过ID从数组中获取元素,那么就需要把每个字符串都计算出一个在数组中的位置ID。字符串获取ID你能想到什么方式? 一个字符串最直接的获取跟数字相关的信息就是HashCode,可HashCode的取值范围太大了[-2147483648, 2147483647],不可能直接使用。那么就需要使用HashCode与数组长度做与运算,得到一个可以在数组中出现的位置。如果说有两个元素得到同样的ID,那么这个数组ID下就存放两个字符串。
以上呢其实就是我们要把字符串散列到数组中的一个基本思路,接下来我们就把这个思路用代码实现出来。
1.1 代码实现
// 初始化一组字符串 Listlist = new ArrayList<>(); list.add("jlkk"); list.add("lopi"); list.add("小傅哥"); list.add("e4we"); list.add("alpo"); list.add("yhjk"); list.add("plop"); // 定义要存放的数组 String[] tab = new String[8]; // 循环存放 for (String key : list) { int idx = key.hashCode() & (tab.length - 1);// 计算索引位置 System.out.println(String.format("key值=%s Idx=%d", key, idx)); if (null == tab[idx]) { tab[idx] = key; continue; } tab[idx] = tab[idx] + "->" + key; } // 输出测试结果 System.out.println(JSON.toJSONString(tab));
这段代码整体看起来也是非常简单,并没有什么复杂度,主要包括以下内容;
- 初始化一组字符串集合,这里初始化了7个。
- 定义一个数组用于存放字符串,注意这里的长度是8,也就是2的3次幂。这样的数组长度才会出现一个 0111除高位以外都是1的特征,也是为了散列。
- 接下来就是循环存放数据,计算出每个字符串在数组中的位置。key.hashCode() & (tab.length - 1)。
- 在字符串存放到数组的过程,如果遇到相同的元素,进行连接操作模拟链表的过程。
- 最后输出存放结果。
测试结果
key值=jlkk Idx=2
key值=lopi Idx=4
key值=小傅哥 Idx=7
key值=e4we Idx=5
key值=alpo Idx=2
key值=yhjk Idx=0
key值=plop Idx=5
测试结果:["yhjk",null,"jlkk->alpo",null,"lopi","e4we->plop",null,"小傅哥"]
- 在测试结果首先是计算出每个元素在数组的Idx,也有出现重复的位置。
- 最后是测试结果的输出,1、3、6,位置是空的,2、5,位置有两个元素被链接起来e4we->plop。
- 这就达到了我们一个最基本的要求,将串元素散列存放到数组中,最后通过字符串元素的索引ID进行获取对应字符串。这样是HashMap的一个最基本原理,有了这个基础后面就会更容易理解HashMap的源码实现。
1.2 Hash散列示意图
如果上面的测试结果不能在你的头脑中很好地建立出一个数据结构,那么可以看以下这张散列示意图,方便理解;
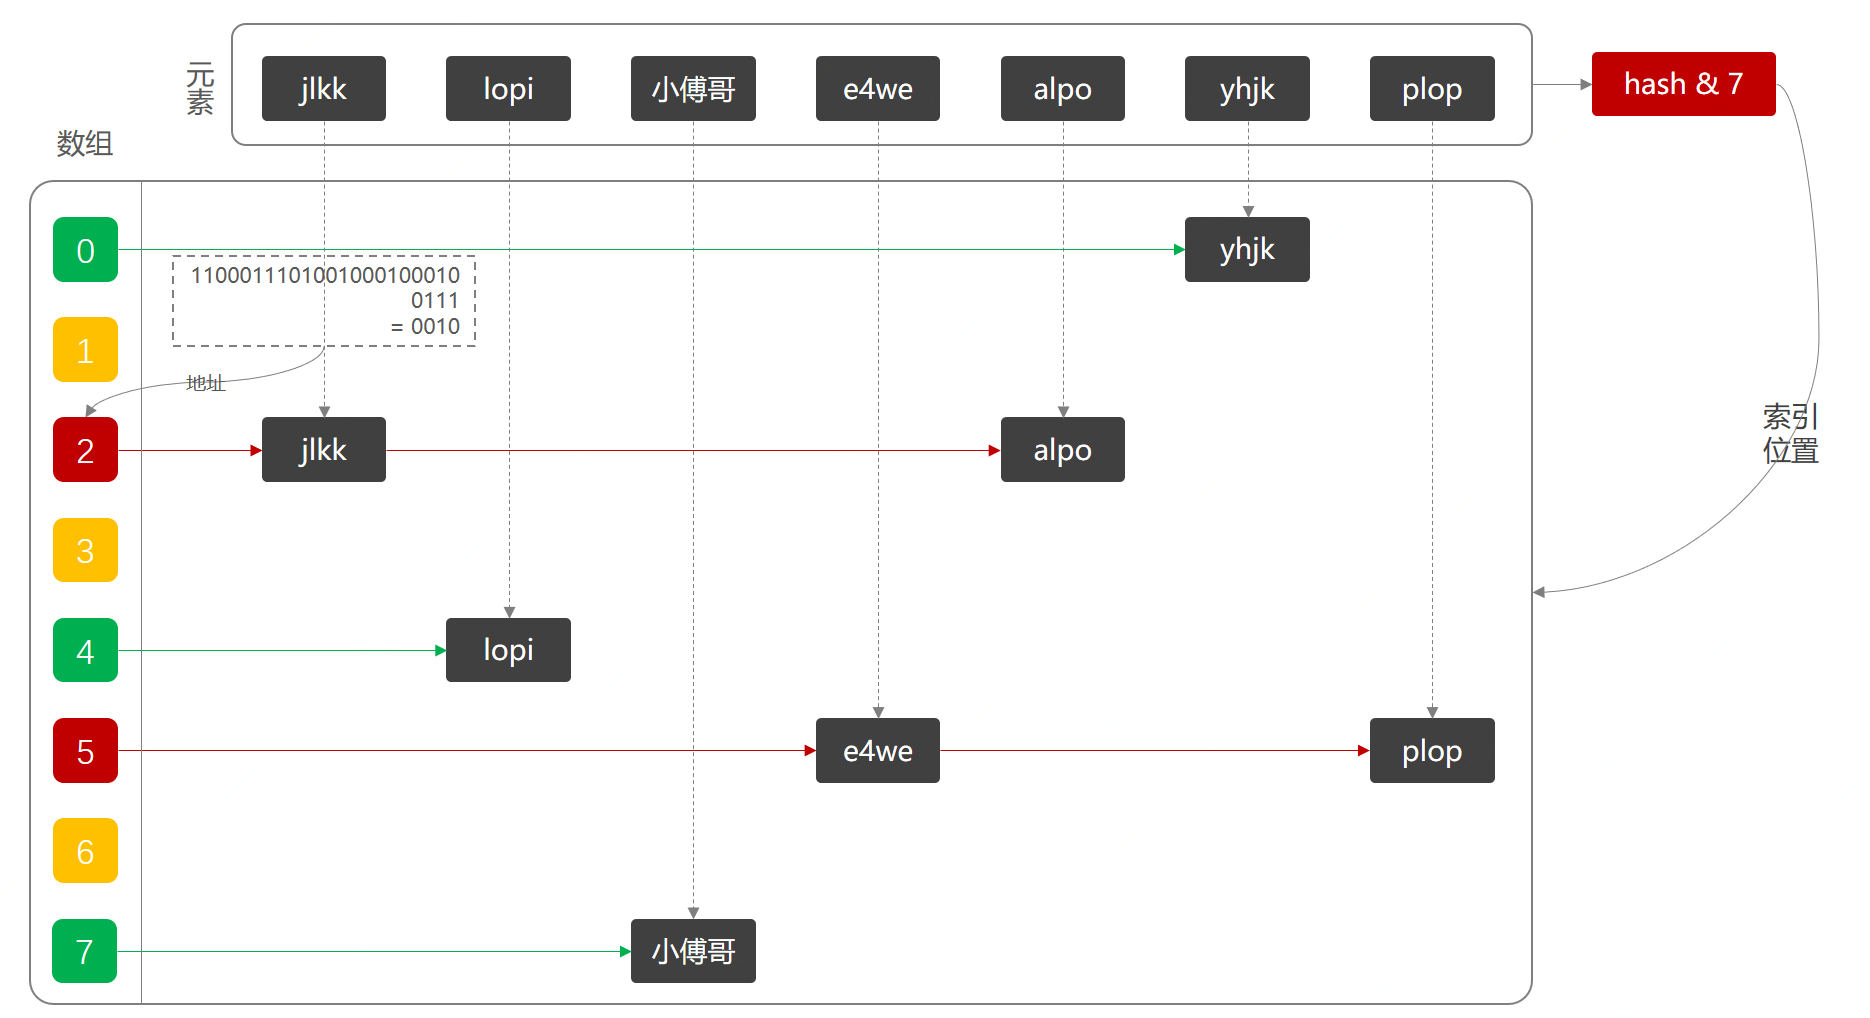
bugstack.cn Hash散列示意图
- 这张图就是上面代码实现的全过程,将每一个字符串元素通过Hash计算索引位置,存放到数组中。
- 黄色的索引ID是没有元素存放、绿色的索引ID存放了一个元素、红色的索引ID存放了两个元素。
1.3 这个简单的HashMap有哪些问题
以上我们实现了一个简单的HashMap,或者说还算不上HashMap,只能算做一个散列数据存放的雏形。但这样的一个数据结构放在实际使用中,会有哪些问题呢?
- 这里所有的元素存放都需要获取一个索引位置,而如果元素的位置不够散列碰撞严重,那么就失去了散列表存放的意义,没有达到预期的性能。
- 在获取索引ID的计算公式中,需要数组长度是2的幂次方,那么怎么进行初始化这个数组大小。
- 数组越小碰撞的越大,数组越大碰撞的越小,时间与空间如何取舍。
- 目前存放7个元素,已经有两个位置都存放了2个字符串,那么链表越来越长怎么优化。
- 随着元素的不断添加,数组长度不足扩容时,怎么把原有的元素,拆分到新的位置上去。
以上这些问题可以归纳为;扰动函数、初始化容量、负载因子、扩容方法以及链表和红黑树转换的使用等。接下来我们会逐个问题进行分析。
2. 扰动函数
在HashMap存放元素时候有这样一段代码来处理哈希值,这是java 8的散列值扰动函数,用于优化散列效果;
static final int hash(Object key){
int h;
return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
2.1 为什么使用扰动函数
理论上来说字符串的hashCode是一个int类型值,那可以直接作为数组下标了,且不会出现碰撞。但是这个hashCode的取值范围是[-2147483648, 2147483647],有将近40亿的长度,谁也不能把数组初始化得这么大,内存也是放不下的。
我们默认初始化的Map大小是16个长度 DEFAULT_INITIAL_CAPACITY = 1 << 4,所以获取的Hash值并不能直接作为下标使用,需要与数组长度进行取模运算得到一个下标值,也就是我们上面做的散列列子。
那么,hashMap源码这里不只是直接获取哈希值,还进行了一次扰动计算,(h = key.hashCode()) ^ (h >>> 16)。把哈希值右移16位,也就正好是自己长度的一半,之后与原哈希值做异或运算,这样就混合了原哈希值中的高位和低位,增大了随机性。计算方式如下图;
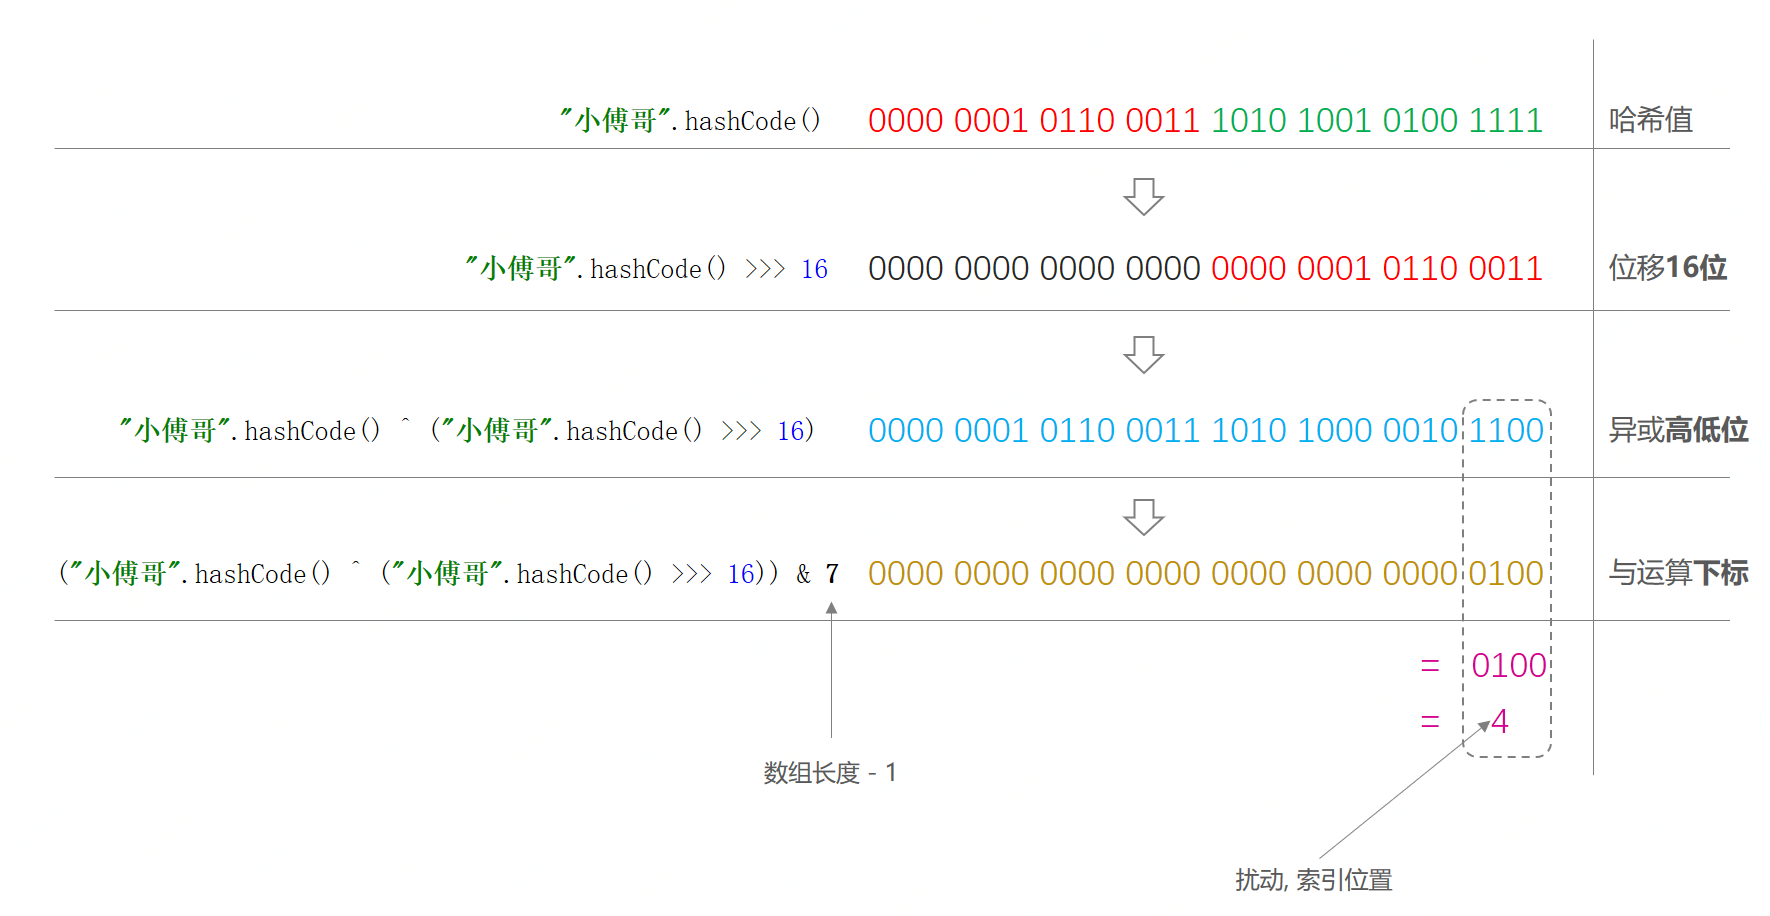
bugstack.cn 扰动函数
- 说白了,使用扰动函数就是为了增加随机性,让数据元素更加均衡的散列,减少碰撞。
2.2 实验验证扰动函数
从上面的分析可以看出,扰动函数使用了哈希值的高半区和低半区做异或,混合原始哈希码的高位和低位,以此来加大低位区的随机性。
但看不到实验数据的话,这终究是一段理论,具体这段哈希值真的被增加了随机性没有,并不知道。所以这里我们要做一个实验,这个实验是这样做;
- 选取10万个单词词库
- 定义128位长度的数组格子
- 分别计算在扰动和不扰动下,10万单词的下标分配到128个格子的数量
- 统计各个格子数量,生成波动曲线。如果扰动函数下的波动曲线相对更平稳,那么证明扰动函数有效果。
扰动函数对比方法
public class Disturb {

public static int disturbHashIdx(String key, int size){
return (size - 1) & (key.hashCode() ^ (key.hashCode() >>> 16));
}

public static int hashIdx(String key, int size){
return (size - 1) & key.hashCode();
}

}- disturbHashIdx扰动函数下,下标值计算
- hashIdx非扰动函数下,下标值计算
单元测试
// 10万单词已经初始化到words中
@Test
public void test_disturb(){
Map map = new HashMap<>(16);
for (String word : words) {
// 使用扰动函数
int idx = Disturb.disturbHashIdx(word, 128);
// 不使用扰动函数
// int idx = Disturb.hashIdx(word, 128);
if (map.containsKey(idx)) {
Integer integer = map.get(idx);
map.put(idx, ++integer);
} else {
map.put(idx, 1);
}
}
System.out.println(map.values());
}
以上分别统计两种函数下的下标值分配,最终将统计结果放到excel中生成图表。
以上的两张图,分别是没有使用扰动函数和使用扰动函数的,下标分配。实验数据;
- 10万个不重复的单词
- 128个格子,相当于128长度的数组
未使用扰动函数
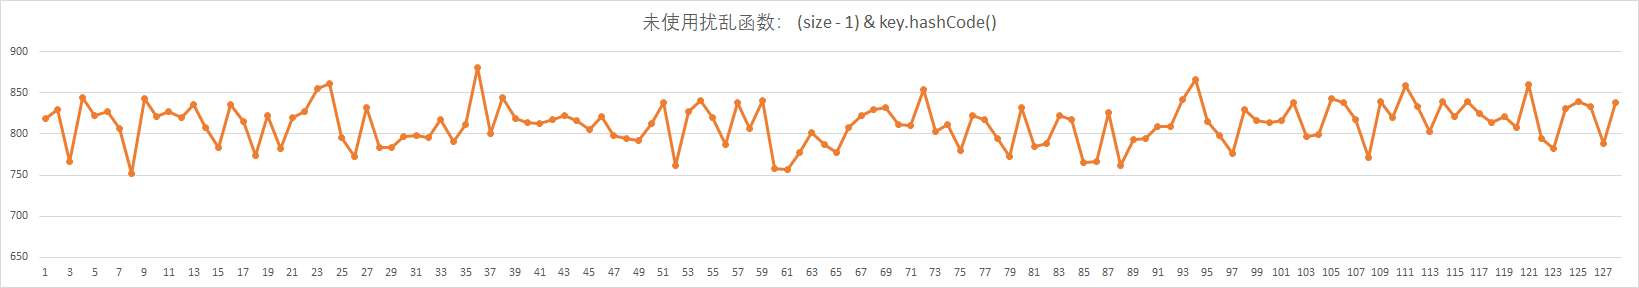
bugstack.cn 未使用扰动函数
使用扰动函数
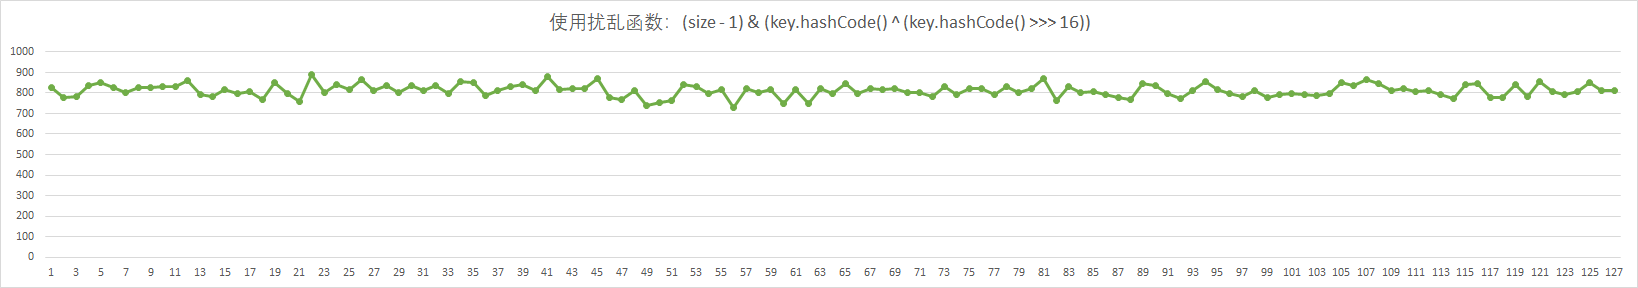
bugstack.cn 使用扰动函数
- 从这两种的对比图可以看出来,在使用了扰动函数后,数据分配的更加均匀了。
- 数据分配均匀,也就是散列的效果更好,减少了hash的碰撞,让数据存放和获取的效率更佳。
3. 初始化容量和负载因子
接下来我们讨论下一个问题,从我们模仿HashMap的例子中以及HashMap默认的初始化大小里,都可以知道,散列数组需要一个2的幂次方的长度,因为只有2的幂次方在减1的时候,才会出现01111这样的值。
那么这里就有一个问题,我们在初始化HashMap的时候,如果传一个17个的值new HashMap<>(17);,它会怎么处理呢?
3.1 寻找2的幂次方最小值
在HashMap的初始化中,有这样一段方法;
public HashMap(int initialCapacity, float loadFactor){
...
this.loadFactor = loadFactor;
this.threshold = tableSizeFor(initialCapacity);
}- 阈值threshold,通过方法tableSizeFor进行计算,是根据初始化来计算的。
- 这个方法也就是要寻找比初始值大的,最小的那个2进制数值。比如传了17,我应该找到的是32(2的4次幂是16<17,所以找到2的5次幂32)。
计算阈值大小的方法;
static final int tableSizeFor(int cap) {
int n = cap - 1;
n |= n >>> 1;
n |= n >>> 2;
n |= n >>> 4;
n |= n >>> 8;
n |= n >>> 16;
return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1;
}- MAXIMUM_CAPACITY = 1 << 30,这个是临界范围,也就是最大的Map集合。
- 乍一看可能有点晕怎么都在向右移位1、2、4、8、16,这主要是为了把二进制的各个位置都填上1,当二进制的各个位置都是1以后,就是一个标准的2的幂次方减1了,最后把结果加1再返回即可。
那这里我们把17这样一个初始化计算阈值的过程,用图展示出来,方便理解;
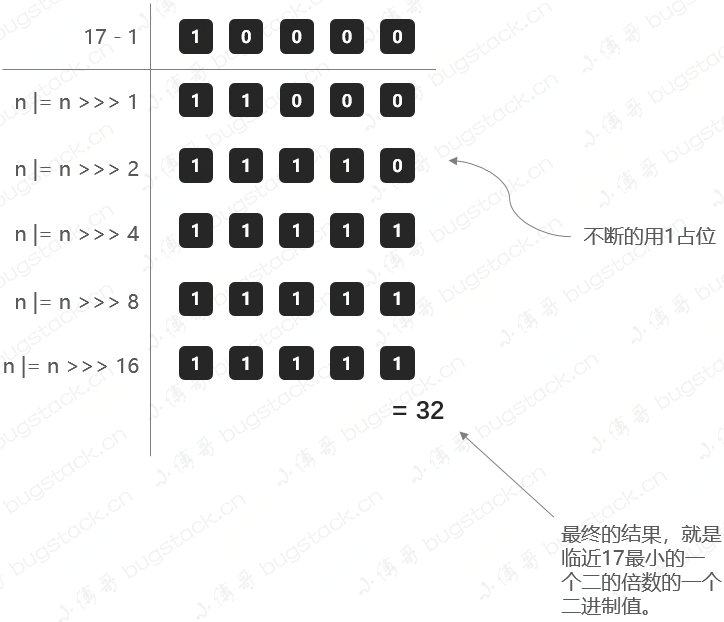
bugstack.cn 计算阈值
3.2 负载因子
static final float DEFAULT_LOAD_FACTOR = 0.75f;
负载因子是做什么的?
负载因子,可以理解成一辆车可承重重量超过某个阈值时,把货放到新的车上。
那么在HashMap中,负载因子决定了数据量多少了以后进行扩容。这里要提到上面做的HashMap例子,我们准备了7个元素,但是最后还有3个位置空余,2个位置存放了2个元素。 所以可能即使你数据比数组容量大时也是不一定能正正好好的把数组占满的,而是在某些小标位置出现了大量的碰撞,只能在同一个位置用链表存放,那么这样就失去了Map数组的性能。
所以,要选择一个合理的大小下进行扩容,默认值0.75就是说当阈值容量占了3/4时赶紧扩容,减少Hash碰撞。
同时0.75是一个默认构造值,在创建HashMap也可以调整,比如你希望用更多的空间换取时间,可以把负载因子调的更小一些,减少碰撞。
4. 扩容元素拆分
为什么扩容,因为数组长度不足了。那扩容最直接的问题,就是需要把元素拆分到新的数组中。拆分元素的过程中,原jdk1.7中会需要重新计算哈希值,但是到jdk1.8中已经进行优化,不再需要重新计算,提升了拆分的性能,设计的还是非常巧妙的。
4.1 测试数据
@Test
public void test_hashMap(){
List list = new ArrayList<>();
list.add("jlkk");
list.add("lopi");
list.add("jmdw");
list.add("e4we");
list.add("io98");
list.add("nmhg");
list.add("vfg6");
list.add("gfrt");
list.add("alpo");
list.add("vfbh");
list.add("bnhj");
list.add("zuio");
list.add("iu8e");
list.add("yhjk");
list.add("plop");
list.add("dd0p");
for (String key : list) {
int hash = key.hashCode() ^ (key.hashCode() >>> 16);
System.out.println("字符串:" + key + " tIdx(16):" + ((16 - 1) & hash) + " tBit值:" + Integer.toBinaryString(hash) + " - " + Integer.toBinaryString(hash & 16) + " ttIdx(32):" + ((
System.out.println(Integer.toBinaryString(key.hashCode()) +" "+ Integer.toBinaryString(hash) + " " + Integer.toBinaryString((32 - 1) & hash));
}
}
测试结果
字符串:jlkkIdx(16):3Bit值:1100011101001000010011 - 10000 Idx(32):19
1100011101001000100010 1100011101001000010011 10011
字符串:lopiIdx(16):14Bit值:1100101100011010001110 - 0 Idx(32):14
1100101100011010111100 1100101100011010001110 1110
字符串:jmdwIdx(16):7Bit值:1100011101010100100111 - 0 Idx(32):7
1100011101010100010110 1100011101010100100111 111
字符串:e4weIdx(16):3Bit值:1011101011101101010011 - 10000 Idx(32):19
1011101011101101111101 1011101011101101010011 10011
字符串:io98Idx(16):4Bit值:1100010110001011110100 - 10000 Idx(32):20
1100010110001011000101 1100010110001011110100 10100
字符串:nmhgIdx(16):13Bit值:1100111010011011001101 - 0 Idx(32):13
1100111010011011111110 1100111010011011001101 1101
字符串:vfg6Idx(16):8Bit值:1101110010111101101000 - 0 Idx(32):8
1101110010111101011111 1101110010111101101000 1000
字符串:gfrtIdx(16):1Bit值:1100000101111101010001 - 10000 Idx(32):17
1100000101111101100001 1100000101111101010001 10001
字符串:alpoIdx(16):7Bit值:1011011011101101000111 - 0 Idx(32):7
1011011011101101101010 1011011011101101000111 111
字符串:vfbhIdx(16):1Bit值:1101110010111011000001 - 0 Idx(32):1
1101110010111011110110 1101110010111011000001 1
字符串:bnhjIdx(16):0Bit值:1011100011011001100000 - 0 Idx(32):0
1011100011011001001110 1011100011011001100000 0
字符串:zuioIdx(16):8Bit值:1110010011100110011000 - 10000 Idx(32):24
1110010011100110100001 1110010011100110011000 11000
字符串:iu8eIdx(16):8Bit值:1100010111100101101000 - 0 Idx(32):8
1100010111100101011001 1100010111100101101000 1000
字符串:yhjkIdx(16):8Bit值:1110001001010010101000 - 0 Idx(32):8
1110001001010010010000 1110001001010010101000 1000
字符串:plopIdx(16):9Bit值:1101001000110011101001 - 0 Idx(32):9
1101001000110011011101 1101001000110011101001 1001
字符串:dd0pIdx(16):14Bit值:1011101111001011101110 - 0 Idx(32):14
1011101111001011000000 1011101111001011101110 1110
- 这里我们随机使用一些字符串计算他们分别在16位长度和32位长度数组下的索引分配情况,看哪些数据被重新路由到了新的地址。
- 同时,这里还可以观察出一个非常重要的信息,原哈希值与扩容新增出来的长度16,进行&运算,如果值等于0,则下标位置不变。如果不为0,那么新的位置则是原来位置上加16。{这个地方需要好好理解下,并看实验数据}
- 这样一来,就不需要在重新计算每一个数组中元素的哈希值了。
4.2 数据迁移
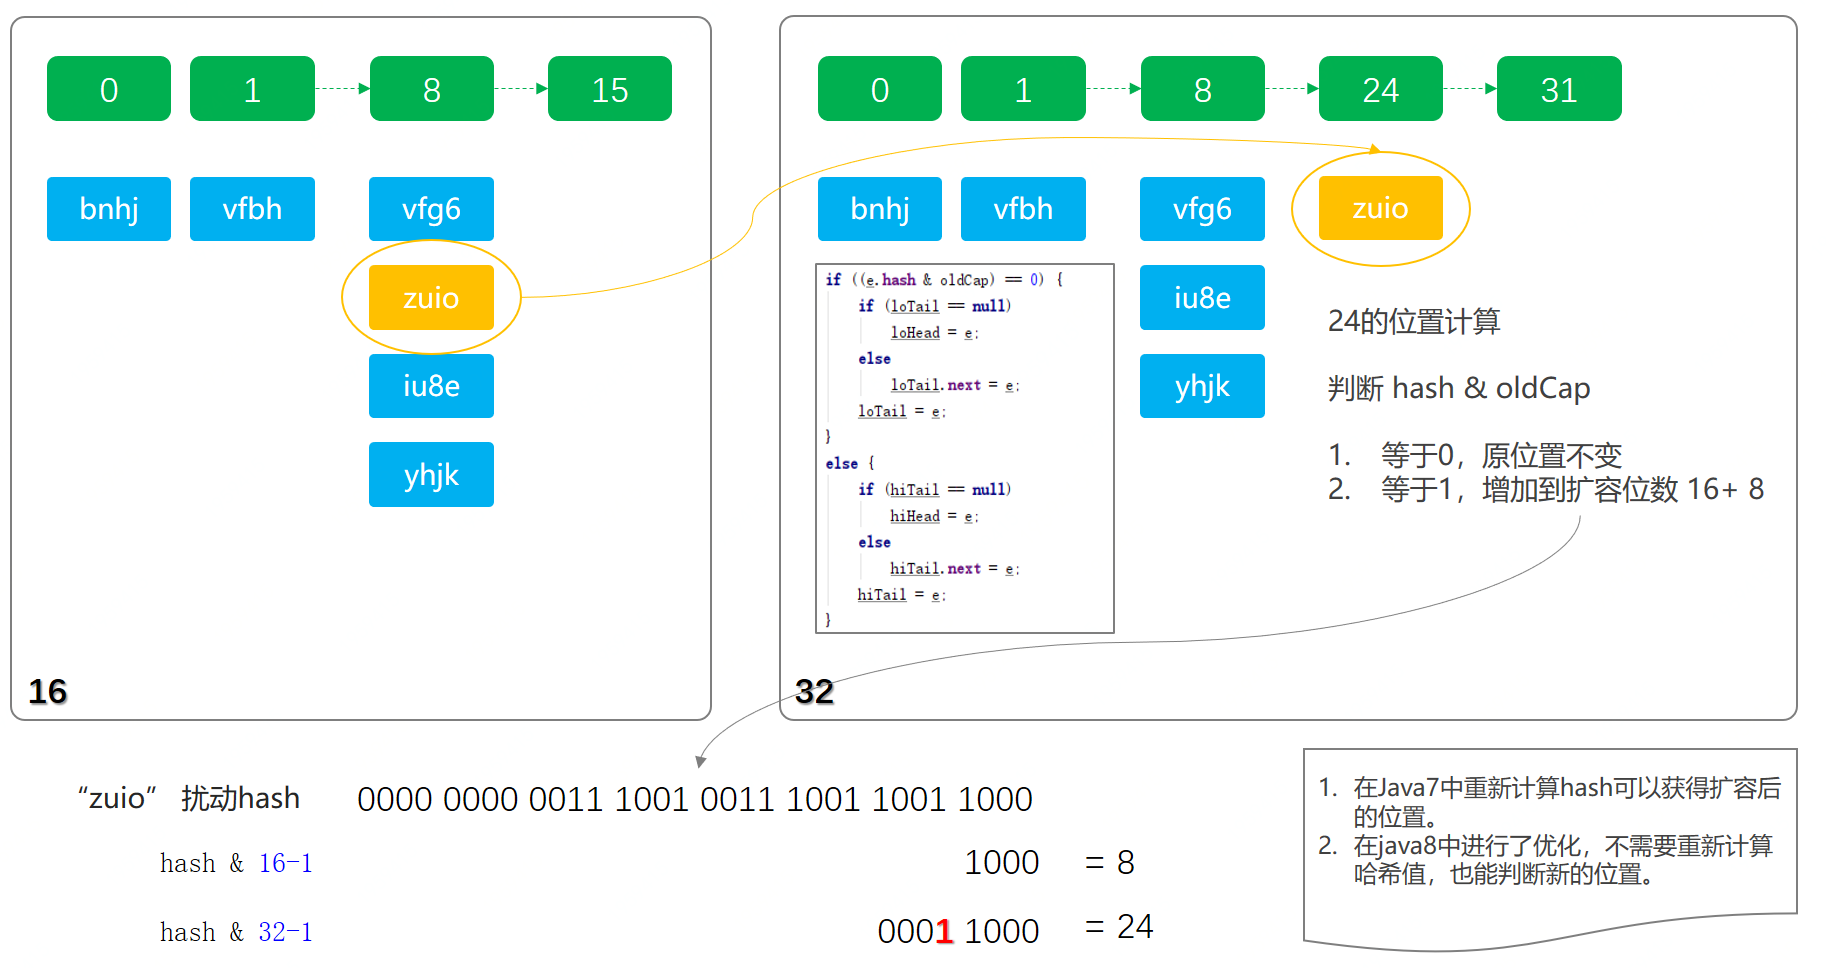
bugstack.cn 数据迁移
- 这张图就是原16位长度数组元素,向32位扩容后数组转移的过程。
- 对31取模保留低5位,对15取模保留低4位,两者的差异就在于第5位是否为1,是的话则需要加上增量,为0的话则不需要改变
- 其中黄色区域元素zuio因计算结果hash & oldCap低位第5位为1,则被迁移到下标位置24。
- 同时还是用重新计算哈希值的方式验证了,确实分配到24的位置,因为这是在二进制计算中补1的过程,所以可以通过上面简化的方式确定哈希值的位置。
那么为什么 e.hash & oldCap == 0 为什么可以判断当前节点是否需要移位, 而不是再次计算hash;
仍然是原始长度为16举例:
old:
 10: 0000 1010
 15: 0000 1111
 &: 0000 1010

 new:
 10: 0000 1010
 31: 0001 1111
 &: 0000 1010
从上面的示例可以很轻易的看出, 两次indexFor()的差别只是第二次参与位于比第一次左边有一位从0变为1, 而这个变化的1刚好是oldCap, 那么只需要判断原key的hash这个位上是否为1: 若是1, 则需要移动至oldCap + i的槽位, 若为0, 则不需要移动;
这也是HashMap的长度必须保证是2的幂次方的原因, 正因为这种环环相扣的设计, HashMap.loadFactor的选值是3/4就能理解了, table.length * 3/4可以被优化为((table.length >> 2) << 2) - (table.length >> 2) == table.length - (table.length >> 2), JAVA的位运算比乘除的效率更高, 所以取3/4在保证hash冲突小的情况下兼顾了效率;
四、总结
- 如果你能坚持看完这部分内容,并按照文中的例子进行相应的实验验证,那么一定可以学会本章节涉及这五项知识点;1、散列表实现、2、扰动函数、3、初始化容量、4、负载因子、5、扩容元素拆分。
- 对我个人来说以前也知道这部分知识,但是没有验证过,只知道概念如此,正好借着写面试手册专栏,加深学习,用数据验证理论,让知识点可以更加深入的理解。
- 这一章节完事,下一章节继续进行HashMap的其他知识点挖掘,让懂了就是真的懂了。好了,写到这里了,感谢大家的阅读。如果某处没有描述清楚,或者有不理解的点,欢迎与我讨论交流。
项目开发中常需遍历HashMap获取指定值,通过Iterator遍历entrySet,依次取出Entry对象并获取其值,避免重复查找键,效率较高。此方法可同时操作键值对,适用于需处理映射关系的场景,是Java中常见的Map遍历方式。
在PHP安装模块前,必须逐一验证服务器操作系统类型、Web服务器(如Apache/Nginx)环境、PHP版本号及程序安装目录等关键参数,同时检查扩展依赖和权限配置,确保所有环境条件完全兼容,避免安装失败或运行异常。
JDK1.7HashMap多线程扩容时,头插法迁移节点会修改共享节点的next指针,多个线程交叉操作可能导致环形链表,查询时陷入死循环。JDK1.8改用尾插法避免了该问题,但HashMap仍非线程安全,多线程环境应使用ConcurrentHashMap。
如何在 PHP 函数中正确设置并使用更新后的变量值 本文讲解如何在 php 函数中通过参数传递初始值、动态更新变量,并确保后续逻辑使用的是最新修改后的值,避免因变量作用域或未传参导致的“旧值残留”问题。 在PHP开发中,一个常见的困扰是:明明在函数里修改了变量,为什么后续使用的却还是旧值?这背后,往
使用sum、max、min和len计算列表的和、最大值、最小值及平均值;2.用filter结合lambda筛选偶数等符合条件的元素;3.用map对每个元素平方等映射操作;4.用sorted排序,set去重并排序,注意map和filter返回迭代器需转list。
HashMap和HashTable的主要区别在于:1.HashMap允许一个null键和多个null值,而HashTable不允许任何null键或值;2.HashMap线程不安全但性能更高,HashTable线程安全但效率较低;3.HashMap继承自AbstractMap,而HashTable继承自过时的Dictionary类;4.HashMap使用Iterator迭代器支持删除操作,而HashTable使用Enumeration不支持删除;5.多线程环境下推荐使用ConcurrentHashMap替代
答案是根据需求选择:简单操作用函数,需封装状态时用类。函数适合无状态、一次性逻辑,如计算、转换;类适合管理数据与行为,如对象属性和方法。例如,计算圆面积用函数defcalculate_area(radius)更简洁;而银行账户需保存余额并提供存款、查询等操作,用classBankAccount更合理。选择原则:无状态用函数,有状态用类,先写函数再按需重构为类。
JavaHashMap通过哈希表实现键值对的高效存储与检索,其底层结构为数组加链表(或红黑树),1.哈希函数将键转换为数组索引以定位存储位置;2.使用链地址法解决哈希冲突,JDK1.8后引入红黑树优化长链表查找效率;3.put操作包括计算哈希、定位桶、处理冲突及扩容判断;4.get操作通过哈希定位并遍历链表或树来获取值;5.负载因子控制扩容时机以平衡时间与空间;6.非线程安全,多线程下推荐使用ConcurrentHashMap;7.容量为2的幂以优化索引计算;8.根据需求选择HashMap、TreeMap
以下是Golang函数常见问题的答案:函数不属于任何类型,而方法属于特定类型。函数指针是存储函数地址的变量,可像其他指针一样使用。函数可返回多个值,作为元组返回。函数可使用...语法声明可变长度的参数列表。匿名函数是没有名称的函数,用于创建一次性使用的函数。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



