

只需训练一次,即可生成3D新场景!谷歌「光场神经渲染」进化史
Autodesk 3ds Max 是一款专业的三维建模、动画与渲染软件,广泛应用于建筑可视化、游戏开发、影视动画、广告设计和产品展示等领域。
视图合成(viewsynthesis)是计算机视觉和计算机图形学交叉领域的一个重点难题,指的是从一个场景的多张图片中创建该场景的新视图。要准确地合成一个场景的新视图,一个模型需要从一小部分参考图片中捕捉多种类型的信息,比如详细的三维结构、材料和光照等。自2020年研究人员提出神经辐射场(NeRF)模型以来,这个问题也受到了越来越多的关注,大大推动了新视图合成的性能。其中一个超级大玩家就是Google,在NeRF领域也发表了诸多论文,本文将为大家介绍两篇Google发表在CVPR2022和ECCV20
视图合成(view synthesis)是计算机视觉和计算机图形学交叉领域的一个重点难题,指的是从一个场景的多张图片中创建该场景的新视图。
要准确地合成一个场景的新视图,一个模型需要从一小部分参考图片中捕捉多种类型的信息,比如详细的三维结构、材料和光照等。
自2020年研究人员提出神经辐射场(NeRF)模型以来,这个问题也受到了越来越多的关注,大大推动了新视图合成的性能。
其中一个超级大玩家就是Google,在NeRF领域也发表了诸多论文,本文将为大家介绍两篇Google发表在CVPR 2022和ECCV 2022上的论文,讲述光场神经渲染模型的进化。
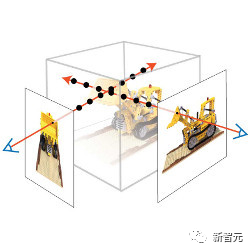
第一篇论文提出一个基于Transformer的两阶段模型来学习组合参考像素颜色,首先获得沿对极线(epipolar lines)的特征,然后获得沿参考视图的特征以产生目标射线的颜色,极大提升了视图重现的准确率。
论文链接:https://arxiv.org/pdf/2112.09687.pdf
经典光场渲染(Light Field Rendering)可以准确地再现与视图有关的效应,如反射、折射和半透明,但需要对场景进行密集的视图采样。基于几何重建的方法只需要稀疏的视图,但不能准确地模拟non-Lambertian效应,即非理想散射。
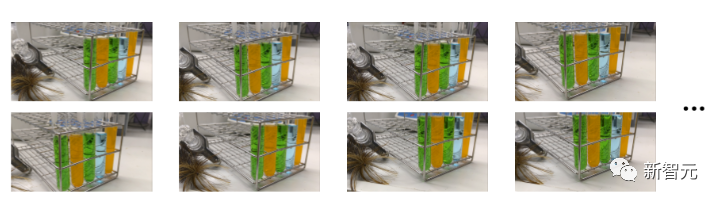
文中提出的新模型结合了这两个方向的优势并缓解了其局限性,通过对光场的四维表示进行操作,模型可以学会准确地表示与视图有关的效应。通过在训练和推理过程中强制执行几何约束,场景几何被隐含地从一组稀疏的视图中学习。
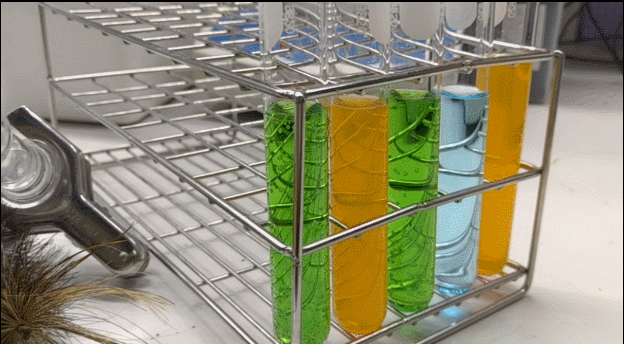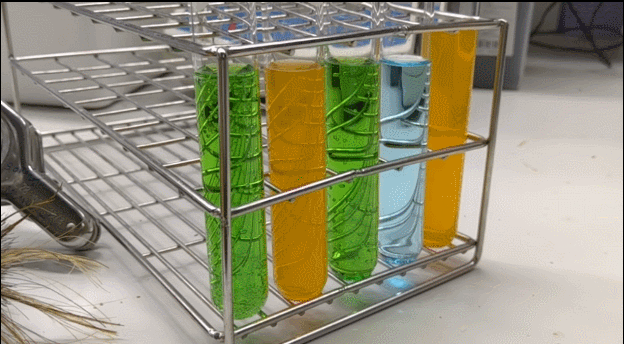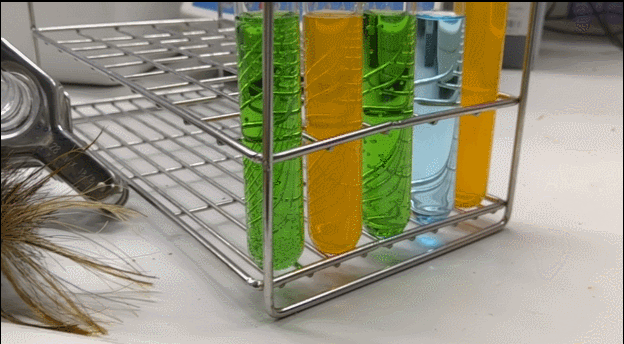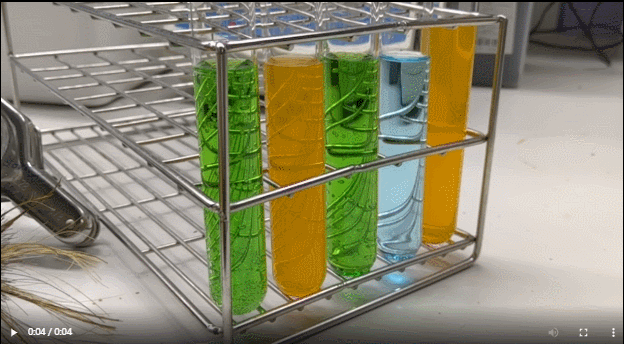
该模型在多个正向和360°数据集上的表现优于最先进的模型,并且在具有严重的视线依赖性变化的场景上有较大的余地。
另一篇论文通过使用具有规范化(canonicalized)位置编码的Transformer序列来解决合成未见过的场景的泛化性问题。模型在一组场景上训练后就可以用来合成新场景的视图。
论文链接:https://arxiv.org/pdf/2207.10662.pdf
文中提出了一个不同的范式,不需要深度特征和类似NeRF的体积渲染,该方法只需从场景中取样patch集合就能直接预测新场景中目标射线的颜色。
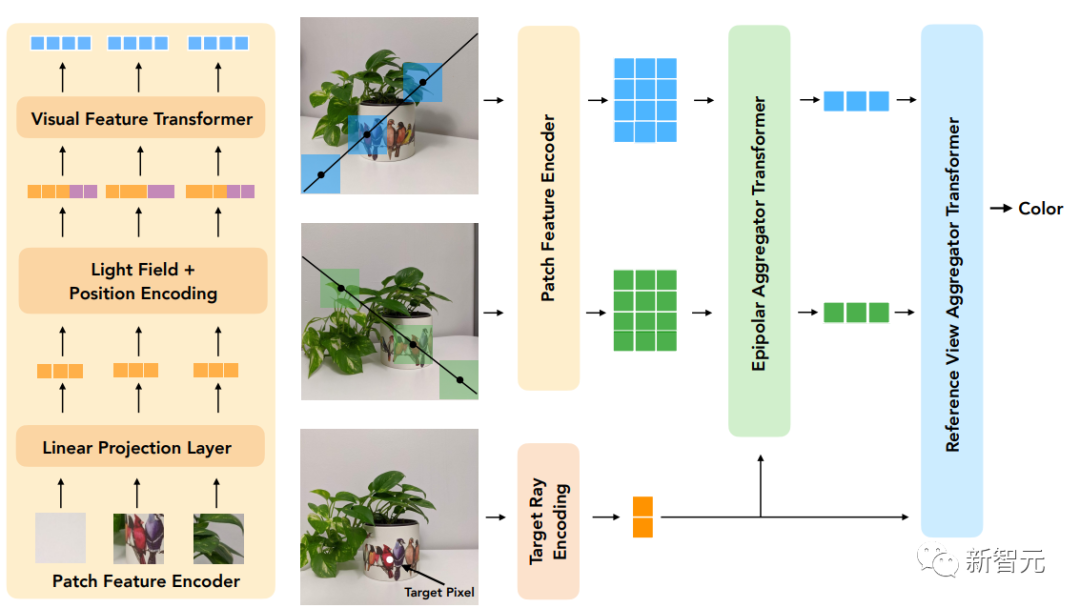
首先利用对极几何学,沿着每个参考视图的对极线提取patch,并将每个patch都线性地投射到一个一维特征向量中,然后由一系列的Transformer处理这个集合。
对于位置编码,研究人员采用和光场表示方法类似的方式对射线进行参数化,区别在于坐标是相对于目标射线的规范化,也使得该方法独立于参考框架并提高了通用性。
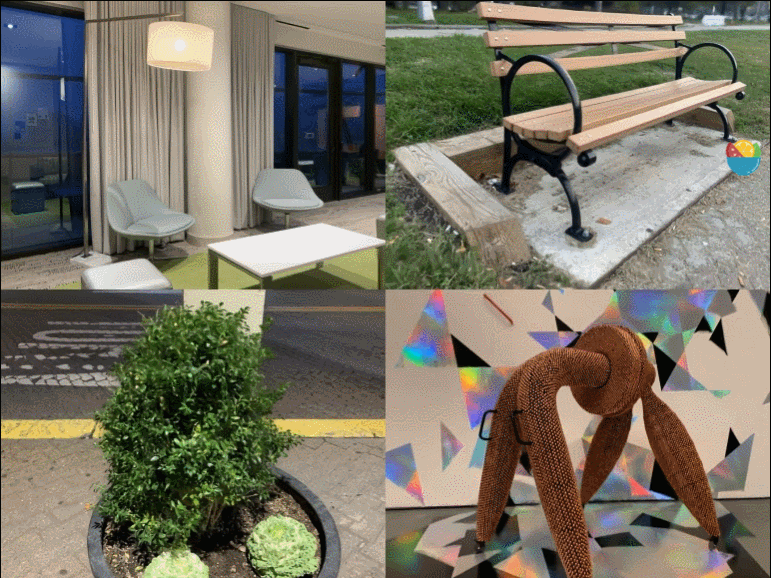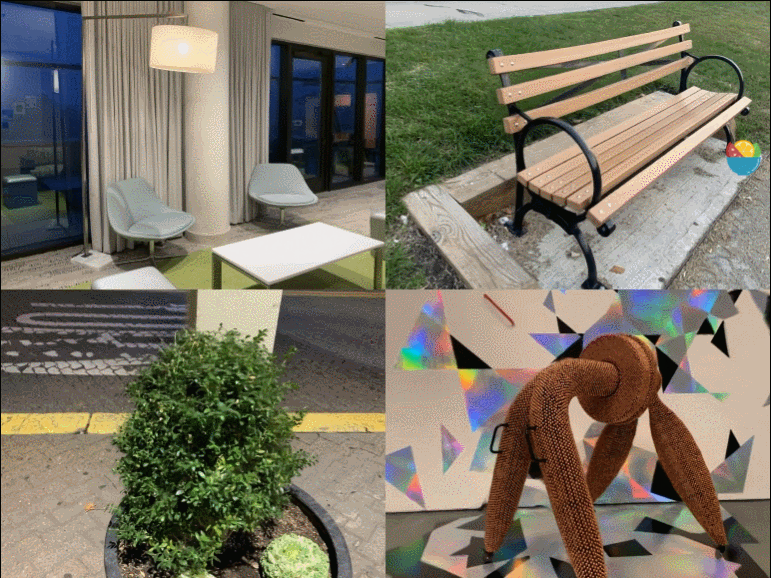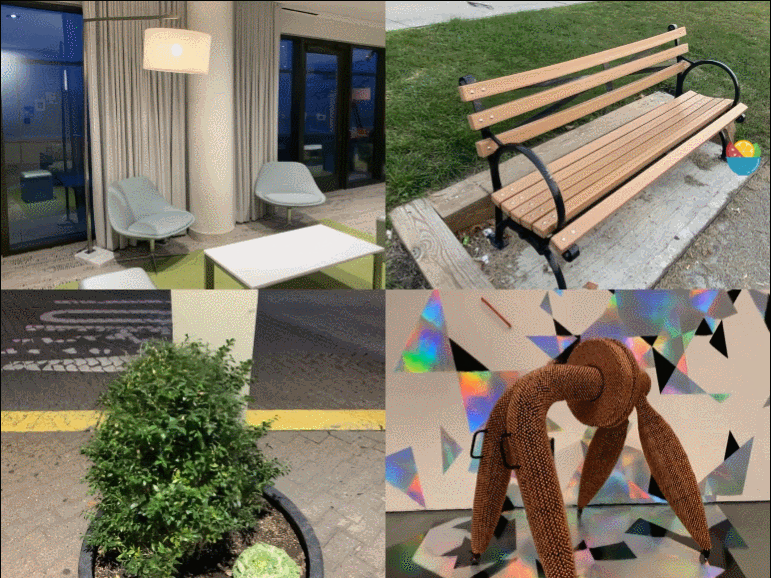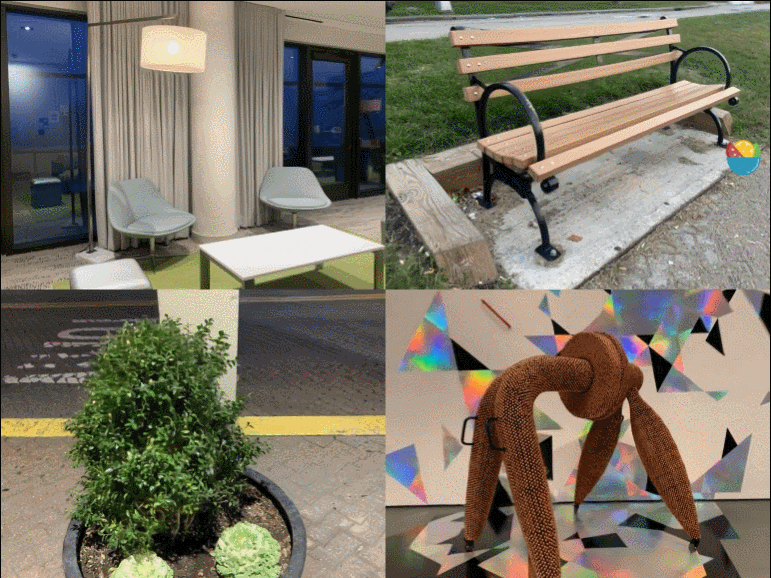
模型的创新点在于,它是进行基于图像的渲染,结合参考图像的颜色和特征来渲染新的视图,而且纯粹是基于Transformer的,在图像patch集上操作。并且它们利用4D光场表示来进行位置编码,有助于模拟与视图相关的效果。
最后实验结果表明,该方法在未见过的场景的新视图合成方面优于其他方法,即使在用比少得多的数据进行训练时也是如此。
光场神经渲染
模型的输入包括一组参考图像、相应的相机参数(焦距、位置和空间方向),以及用户想要确定其颜色的目标射线的坐标。
为了生成一个新的图像,我们需要从输入图像的相机参数开始,先获得目标射线的坐标(每一个都对应一个像素),并为每一个坐标进行模型查询。
研究人员的解决方法是,不完全处理每张参考图像,而只看可能影响目标像素的区域。这些区域可以通过对极几何学确定,将每个目标像素映射到每个参考框架上的一条线。
为了稳妥起见,需要在对极线上的一些点周围选取小区域,从而形成将被模型实际处理的patch集合,然后将Transformer作用于这组patch上以获得目标像素的颜色。
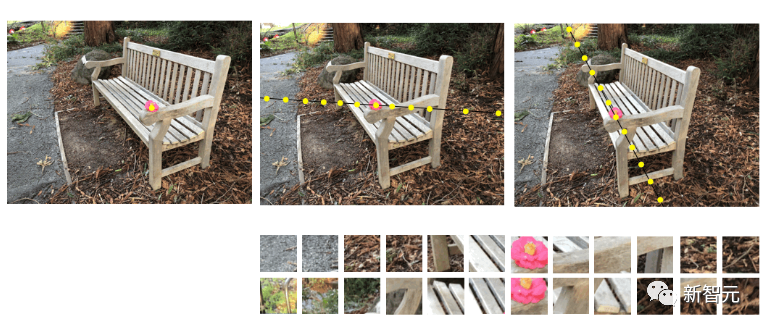
Transformer在这种情况下特别有用,因为其中的自注意力机制可以自然地将patch集合作为输入,注意力权重本身就可以用来结合参考视图颜色和特征来预测输出像素的颜色。
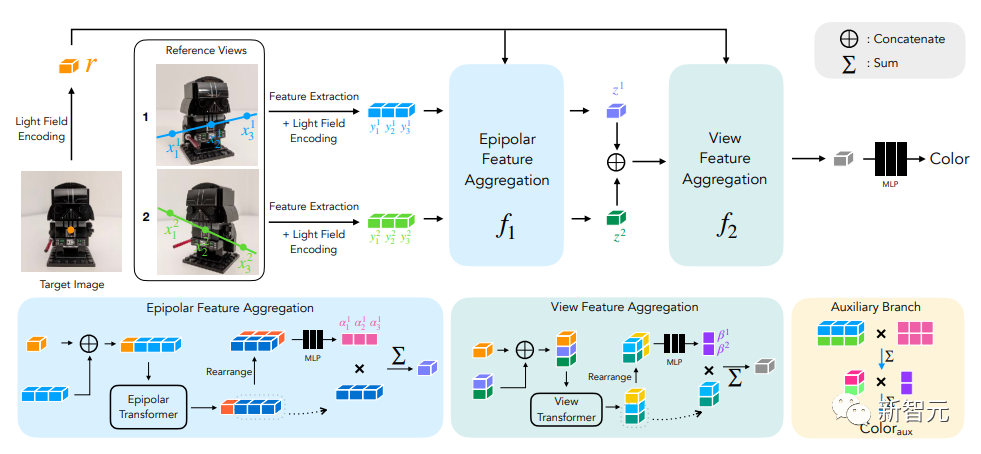
在光场神经渲染(LFNR)中,研究人员使用两个Transformer序列将patch集合映射到目标像素颜色。
第一个Transformer沿着每条对极线聚合信息,第二个Transformer沿着每张参考图像聚合信息。
这种方法可以把第一个Transformer解释为在每个参考帧上寻找目标像素的潜在对应关系,而第二个Transformer则是对遮挡和视线依赖效应的推理,这也是基于图像的渲染的常见难题。
LFNR在最流行的视图合成基准(NeRF的Blender和Real Forward-Facing场景以及NeX的Shiny)上相比sota模型在峰值信噪比(PSNR)的提升幅度高达5dB,相当于将像素级的误差减少了1.8倍。
LFNR可以重现一些NeX/Shiny数据集中比较难的视线依赖性效果,比如CD上的彩虹和反射,瓶子上的反射、折射和半透明。
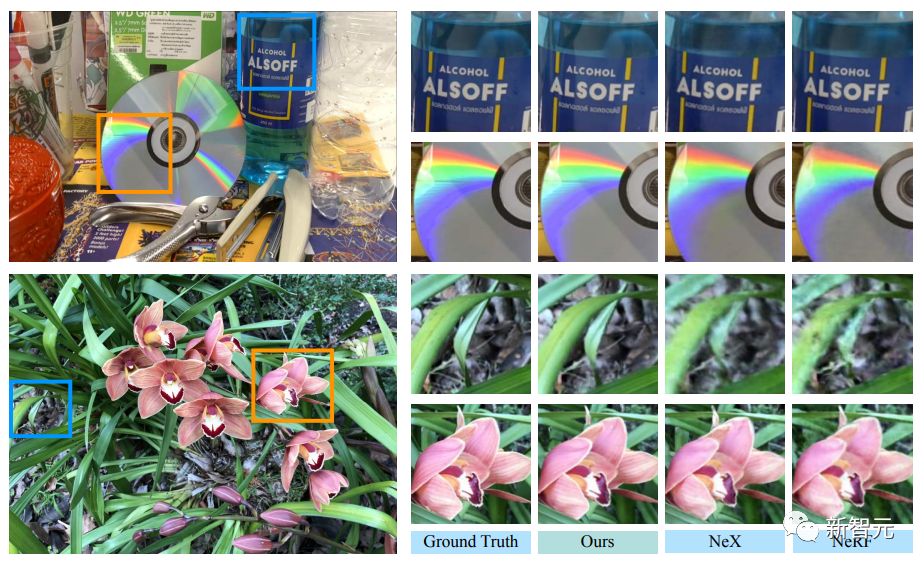
与之前的方法如NeX和NeRF相比,它们就没办法重现与视线相关的效果,如NeX/Shiny数据集中的实验室场景中的试管的半透明性和折射率。
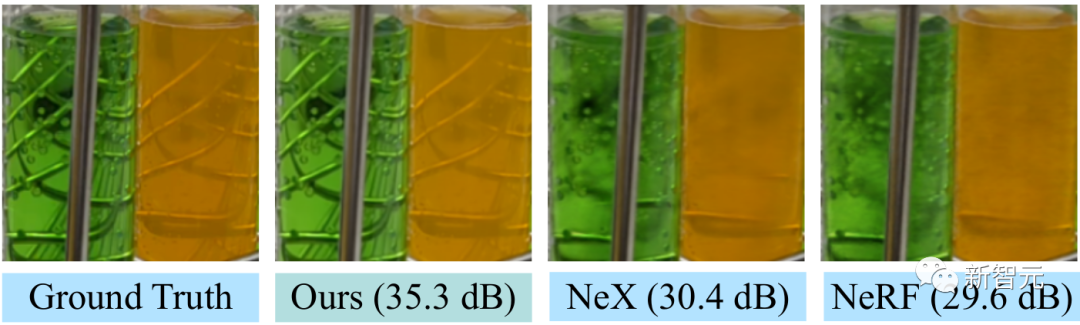
一次训练,泛化新场景
但LFNR也有局限性。
第一个Transformer对每个参考图像独立地沿每条对极线折叠信息,这也意味着模型只能根据每个参考图像的输出射线坐标和patch来决定要保留哪些信息,这在单一场景的训练中效果很好(和大多数神经渲染方法一样),但它无法泛化到不同场景中。
可通用的模型很重要,因为可以直接应用于新的场景而不需要重新训练。
研究人员提出可通用的基于patch的神经渲染(GPNR)模型解决了LFNR的这个缺陷。
通过在模型中增加一个Transfomre,使其在其他两个Transformer之前运行,并在所有参考图像的相同深度的点之间交换信息。
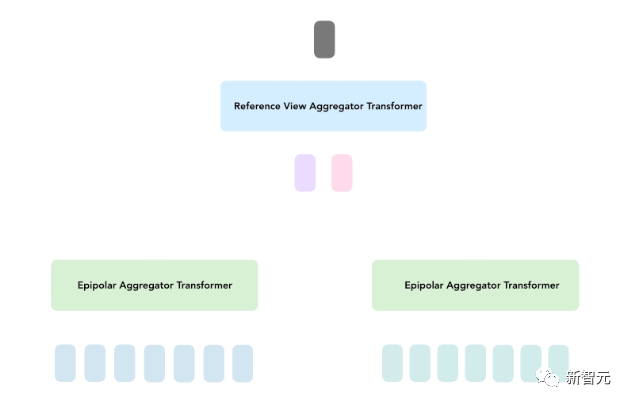
GPNR由三个Transformer序列组成,这些Transformer将沿对极线提取的一组patch映射为像素颜色。图像patch通过线性投影层被映射到初始特征,然后这些特征被模型连续细化和聚合,最终形成特征和颜色。
举个例子,第一个Transformer从「公园长椅」上提取出patch序列后,新模型可以使用在两个视图中出现在相应深度的「花」这样的线索,表明存在潜在的匹配。
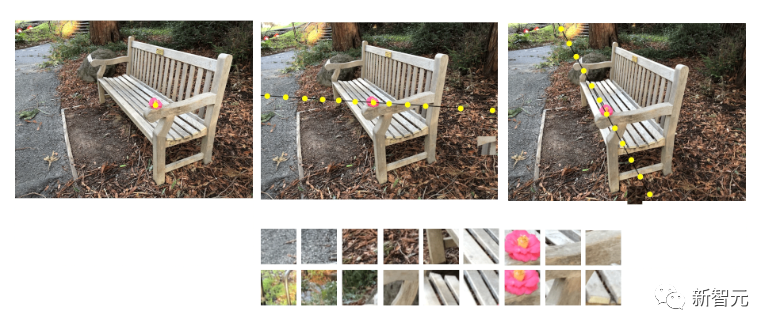
这项工作的另一个关键idea就是根据目标射线将位置编码规范化,因为想要在不同的场景中进行泛化,就必须以相对而非绝对的参照系来表示quantities
为了评估模型的泛化性能,研究人员在一组场景上训练GPNR,并在新场景上进行测试。
GPNR在几个基准(遵照IBRNet和MVSNeRF协议)上平均提高了0.5-1.0 dB,尤其是在IBRNet基准上,GPNR 在只使用11%的训练场景的情况下,就超过了基线模型。
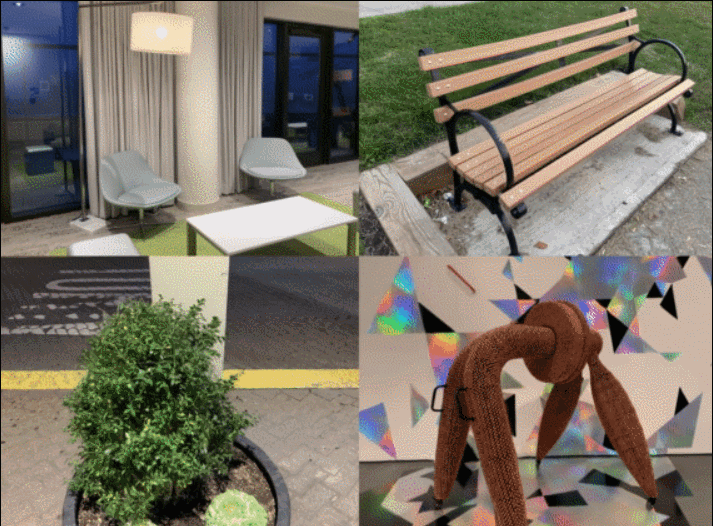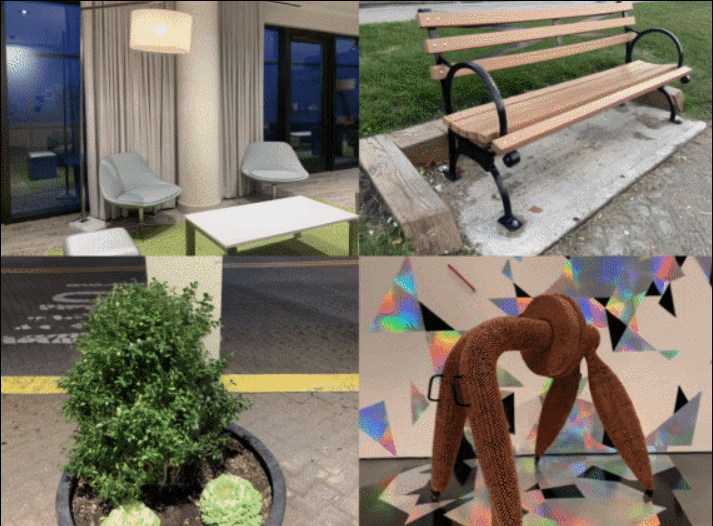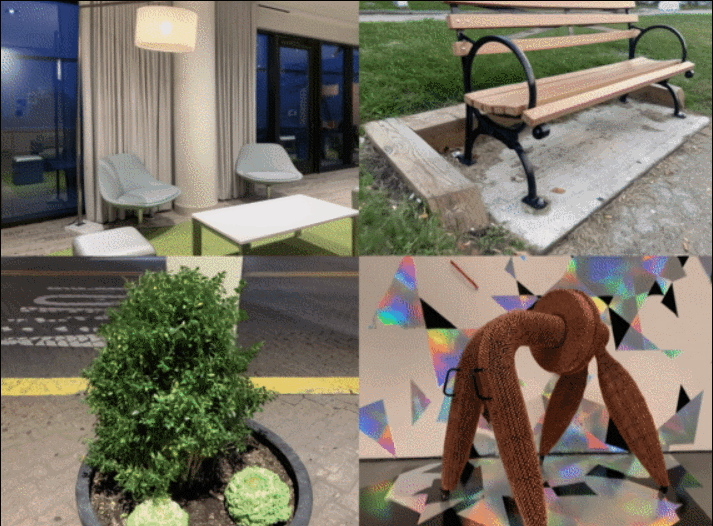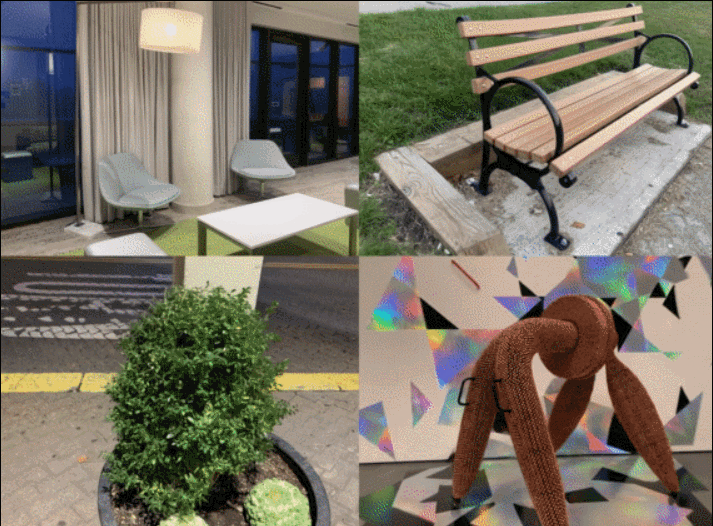
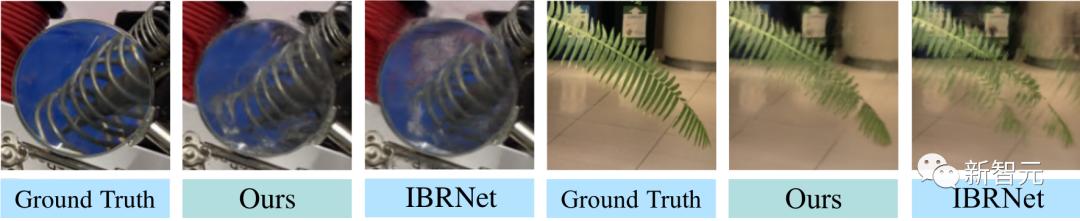
GPNR在NeX/Shiny和LLFF的保持场景上生成的视图细节,没有进行任何微调。与IBRNet相比,GPNR可以更准确地再现叶片上的细节和通过镜头的折射。
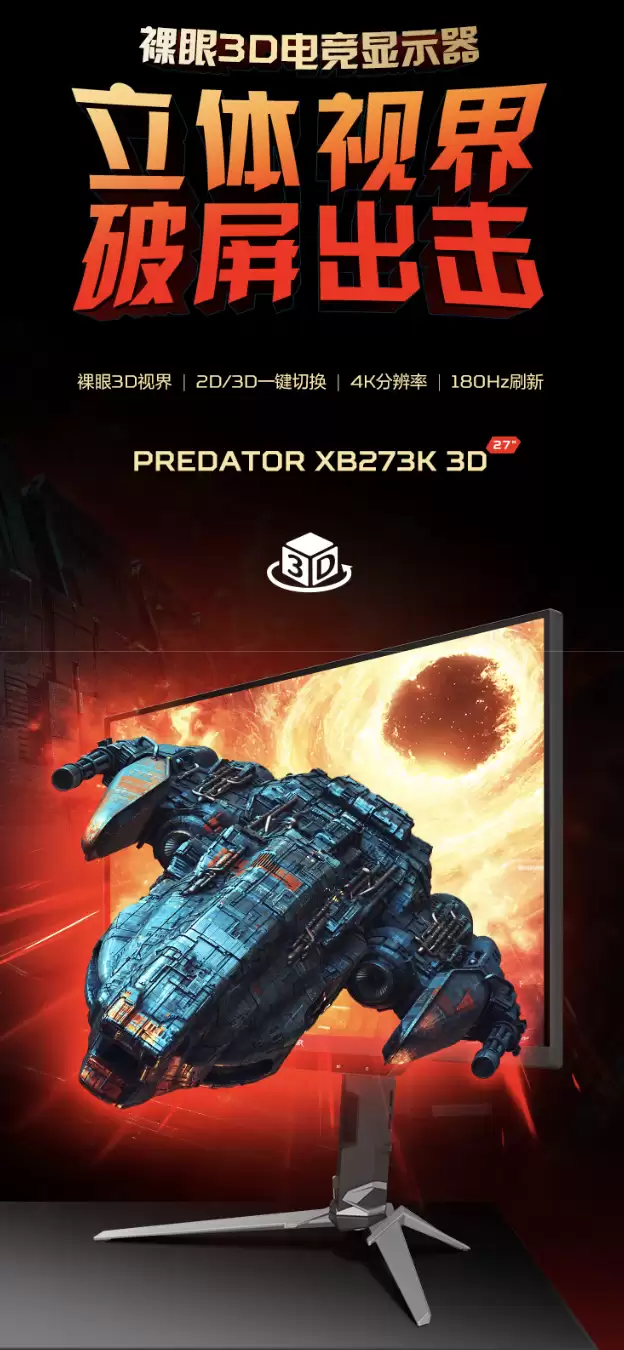
宏碁推出掠夺者XBK273K3D裸眼3D显示器,搭载27英寸4K180HzFastIPS面板,配合3D立体光学透镜与眼动追踪摄像头,可将2D内容转为3D画面,支持3D模型渲染及游戏裸眼3D化,定价7499元,接口齐全并支持KVM。该显示器兼顾高刷新率与裸眼3D体验,适合设计、游戏等多场景。
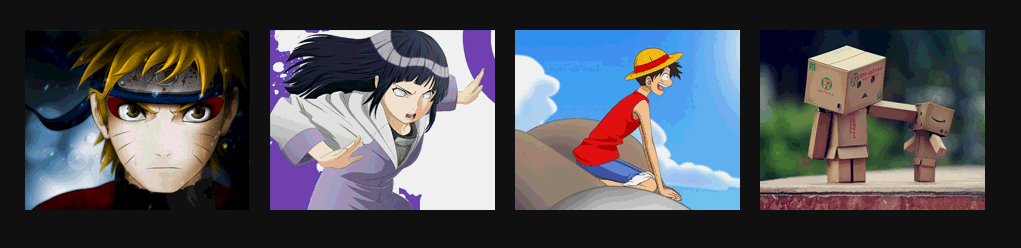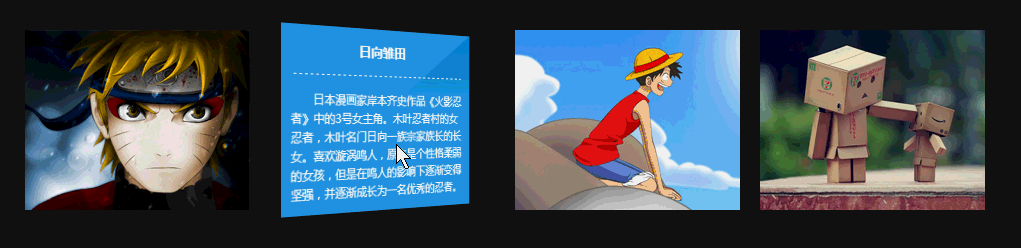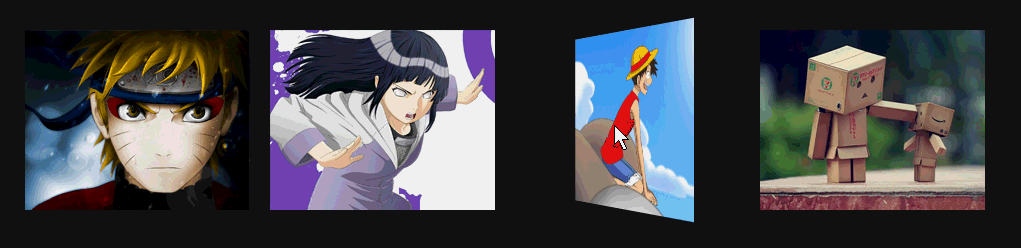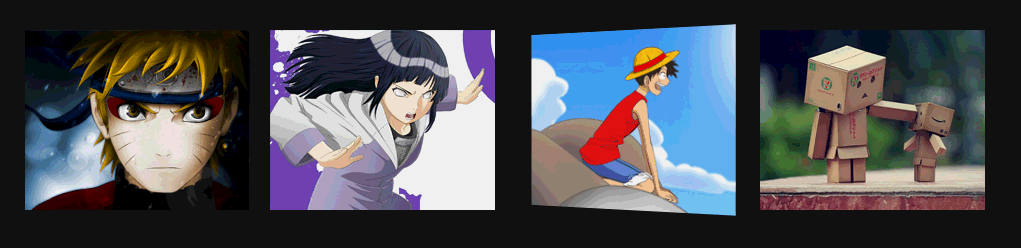
利用CSS3的perspective、transform-style和backface-visibility属性,结合rotateY变换实现3D翻牌效果。鼠标悬停时,卡片正面图片与背面文字同步旋转180度,形成流畅翻转动画,无需JavaScript,兼容性好,立体感强,适用于产品展示、名片翻页等场景。
6月17日,界面新闻带来一条有意思的消息:截至当天,拓竹消费级3D打印机在国内的累计销量已经突破了100万台。从2022年首款产品正式上市算起,满打满满也就4年时间,这个数字确实让人眼前一亮。 拓竹科技成立于2020年,首款产品在2022年面向市场发售。时间拉回到2024年11月底,在Formnex
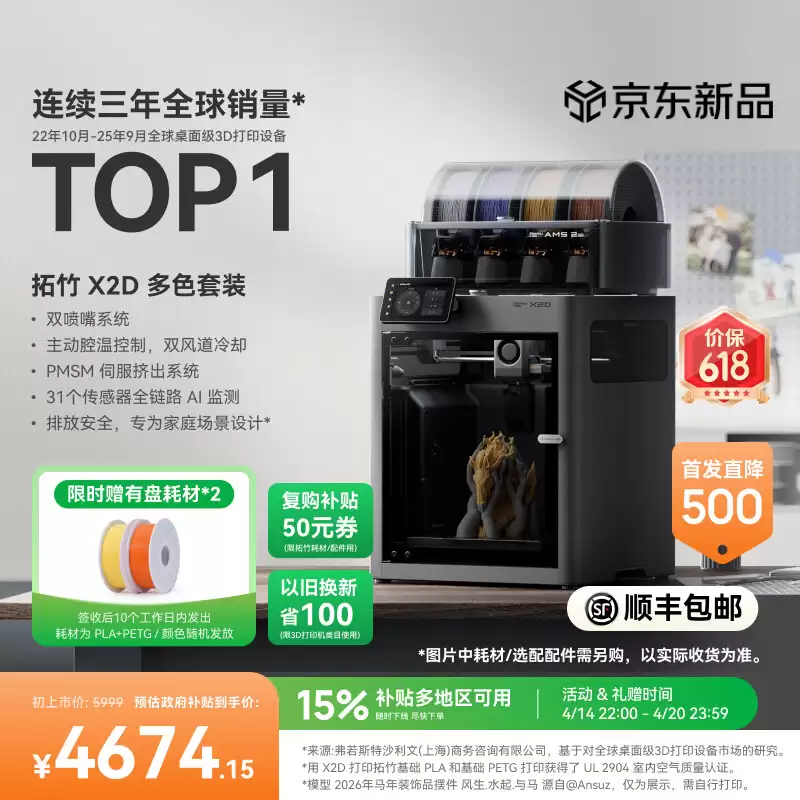
拓竹X2D 3D打印机登场:全新双喷嘴系统,智能监测加持 4月14日,3D打印领域迎来一款备受关注的新品——拓竹X2D 3D打印机正式推出。这款产品的核心看点,在于其搭载的全新机械结构双喷嘴系统。价格方面,单机定价为3999元,享受国补后实际入手价为3399.15元;若选择功能更丰富的多色套装,定价
5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
7月14日,"数码闲聊站"消息称,有厂商正在实验室中对国产屏下3D人脸识别技术进行版本测试,这表明该技术正逐步迈向成熟,未来有望在智能手机领域实现应用。近年来,屏下3D人脸识别技术成为智能手机设计的重要突破,其目标是将3D人脸识别模块完全置于屏幕下方,从而实现更完整的全面屏视觉效果。相比传统的刘海屏方案,该技术不仅提升了手机外观的整体美感,还带来了更大的显示区域和更沉浸的视觉体验。这项技术的关键在于其精密的结构光系统,包含红外镜头、点阵投影器以及泛光感应元件等多个核心部件。这些元件必须
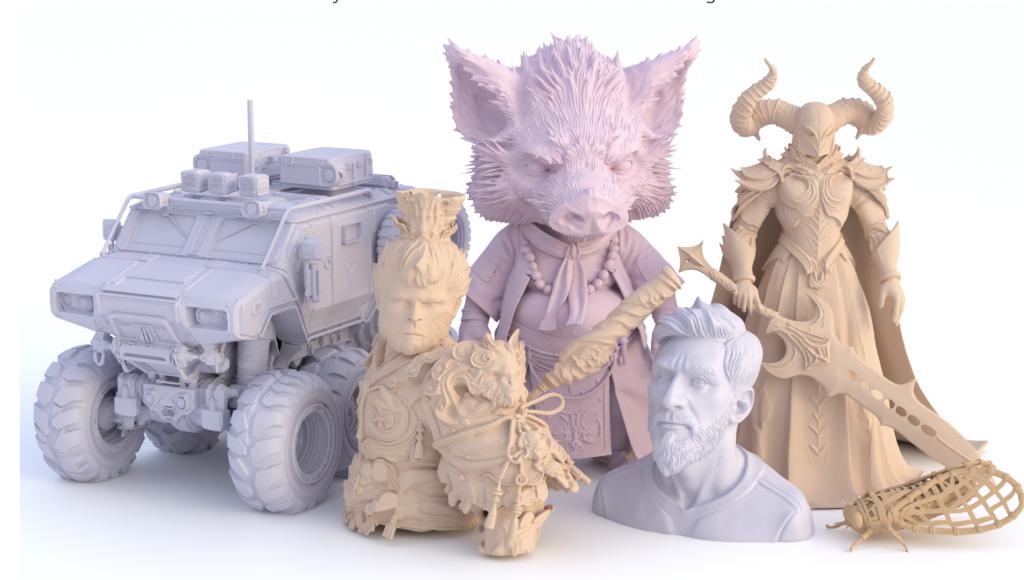
在3D生成技术需求持续攀升的当下,如何快速构建结构合理、几何细节丰富的三维模型,已成为AIGC与数字内容生产领域的核心难题。尽管近年来3D生成技术不断突破,精度显著提升,但大多数现有方法在效率与质量之间仍难以兼顾,尤其在高分辨率建模场景中,高昂的计算成本严重拖慢生成速度,制约了实际应用的推广。为应对这一挑战,南洋理工大学携手数美万物、西湖大学共同推出全新3D生成框架——Ultra3D。Ultra3D采用“由粗到精”的两阶段生成策略,高效实现高分辨率三维资产构建,刷新了当前3D生成质量的新高度。第一阶段利用
现在,请大家一起来数一下"1"、"2"。OK,仅仅2秒的时间,一个接近万亿规模的MoE大模型就已经掌握了如何解答一道高等数学难题的方法!而且呢,这个大模型还是完全依靠国产设备进行训练的,整个流程都体现了浓浓的“国产”特色。这就是华为借助"昇腾+PanguUltraMoE"这一组合实现的成果——不仅达成了国产算力与国产模型在全流程上的自主可控训练闭环,还在集群训练系统的性能方面达到了行业顶尖水平。有多顶尖?来看一组数据:预训练阶段:昇腾Atlas800TA2万卡集群的MFU提升
只需动动嘴,就能操控GUI代理?由美团与浙江大学联合推出的GUIRoboTron-Speech——让你彻底解放双手,直接对设备“发号施令”。这是首个可以直接通过语音指令和屏幕截图进行端到端(End-to-End)决策的自主GUI智能体,致力于为用户提供更自然、高效且无障碍的人机交互方式。从文本到语音,智能代理的新一轮进化目前,基于大语言模型(LLMs)的自主GUI智能体已经能够通过文本指令自动完成跨应用、多步骤的复杂操作,显著提升用户效率。然而,这种依赖文本输入的方式在某些场景中存在明显局限
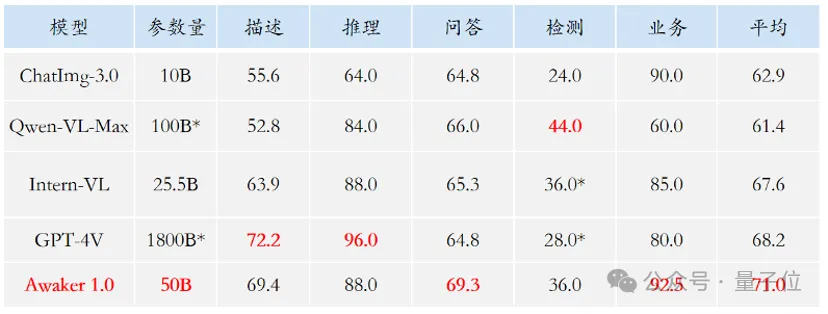
哭死啊,全球狂炼大模型,一互联网的数据不够用,根本不够用。训练模型搞得跟《饥饿游戏》似的,全球AI研究者,都在苦恼怎么才能喂饱这群数据大胃王。尤其在多模态任务中,这一问题尤为突出。一筹莫展之际,来自人大系的初创团队,用自家的新模型,率先在国内把“模型生成数据自己喂自己”变成了现实。而且还是理解侧和生成侧双管齐下,两侧都能生成高质量、多模态的新数据,对模型本身进行数据反哺。模型是啥?中关村论坛上刚刚露面的多模态大模型Awaker1.0。团队是谁?智子引擎。由人大高瓴人工智能学院博士生高一钊创立,高瓴人工智能





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



