

理论计算机科学家 Boaz Barak:深度学习并非“简单的统计”,二者距离已越来越远
上世纪九十年代,斯坦福大学的知名生物信息学教授RobTibshirani曾拟了一个词汇表,将机器学习与统计学中的不同概念作了简单而粗暴的对应关系:一方面,这个表格为理解机器学习提供了基础的认识,但同时,其简单地将深度学习或机器学习中的概念归纳为统计学中的词义,也引起了大多数人对深度学习本质的认知偏差:即深度学习是“简单的统计”。然而,在深入探讨中,这样的认知在一定程度上阻碍了研究者理解深度学习成功的本质原因。在今年六月的一篇文章“Theuneasyrelationshipbetweendee
上世纪九十年代,斯坦福大学的知名生物信息学教授 Rob Tibshirani 曾拟了一个词汇表,将机器学习与统计学中的不同概念作了简单而粗暴的对应关系:
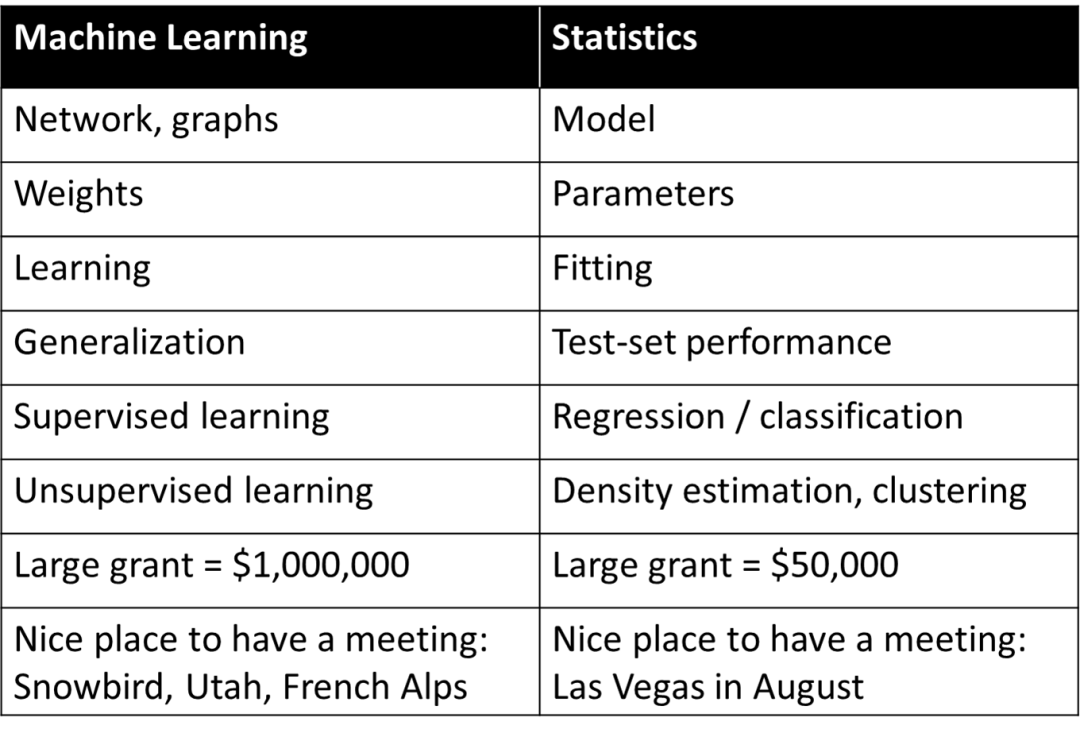
一方面,这个表格为理解机器学习提供了基础的认识,但同时,其简单地将深度学习或机器学习中的概念归纳为统计学中的词义,也引起了大多数人对深度学习本质的认知偏差:即深度学习是“简单的统计”。
然而,在深入探讨中,这样的认知在一定程度上阻碍了研究者理解深度学习成功的本质原因。在今年六月的一篇文章“The uneasy relationship between deep learning and (classical) statistics”中,哈佛大学知名教授、理论计算机科学家 Boaz Barak 就将深度学习与统计学进行了对比区分,指出深度学习的根本构成因素就与统计学有诸多不同。
Boaz Barak 提出一个重要的观察:从模型的用途来看,如果是侧重预测与观察,那么具备黑匣子特性的深度学习模型可能是最好的选择;但如果是希望获取对事物的因果关系理解、提高可解释性,那么“简单”的模型可能表现更佳。这与马毅、曹颖、沈向洋三位科学家在上个月提出的构成智能两大原理之一的“简约性”见解不谋而合。
与此同时,Boaz Barak 通过展示拟合统计模型和学习数学这两个不同的场景案例,探讨其与深度学习的匹配性;他认为,虽然深度学习的数学和代码与拟合统计模型几乎相同,但在更深层次上,深度学习中的极大部分都可在“向学生传授技能”场景中被捕获。
统计学习在深度学习中扮演着重要的角色,这是毋庸置疑的。但可以肯定的是,统计角度无法为理解深度学习提供完整的画面,要理解深度学习的不同方面,仍需要人们从不同的角度出发来实现。
下面是 Boaz Barak 的论述:
1 模型拟合中的预测与解释
几千年来,科学家们一直在为观测结果拟合模型。比如在科学哲学书皮中所提到的,埃及天文学家托勒密提出了一个巧妙的行星运动模型。托勒密的模型是地心的(即行星围绕地球旋转),但有一系列“旋钮”(knobs,具体来说就是“本轮”),使其具有出色的预测准确性。相比之下,哥白尼最初的日心说模型则是假设行星围绕太阳的圆形轨道。它比托勒密的模型更简单(“可调节旋钮”更少)、且整体上更正确,但在预测观察方面却不太准确。(哥白尼在后来也添加了他自己的本轮,从而与托勒密的表现可以相媲美。)
托勒密和哥白尼的模型是无与伦比的。当你需要一个“黑匣子”来进行预测时,那托勒密的地心模型更胜一筹。而如果你想要一个可以“窥视内部”的简单模型,并作为解释星星运动的理论起点,那哥白尼的模型就更好。
事实上,开普勒最终将哥白尼的模型改进为椭圆轨道,并提出了他的行星运动三定律,这使得牛顿能够使用地球上适用的相同引力定律来解释它们。为此,至关重要的是,日心模型并不仅是一个提供预测的“黑匣子”,而是由几乎没有“活动部件”的简单数学方程给出的。多年来,天文学一直是发展统计技术的灵感来源。高斯和勒让德(独立地)在 1800 年左右发明了最小二乘回归,用于预测小行星和其他天体的轨道;柯西在1847年发明的梯度下降,也是受到了天文预测的推动。
在物理学中,(至少有时)你可以“拥有一切”——找到能够实现最佳预测准确性和数据最佳解释的“正确”理论,这被诸如奥卡姆剃刀原理之类的观点所捕捉,假设简单性、预测能力和解释性洞察力都是相互一致的。然而在许多其他领域,解释(或一般情况下称,洞察力)和预测的双重目标之间存在张力。如果只是想预测观察结果,“黑匣子”可能是最好的选择。但如果你提取因果模型、一般原理或重要特征,那么一个容易理解和解释的简单模型可能会更好。
模型的正确选择取决于其用途。例如,考虑一个包含许多个体的基因表达和表型(比如某种疾病)的数据集,如果其目标是预测个人生病的几率,往往会希望为该任务使用最佳模型,不管它有多复杂或它依赖于多少基因。相比之下,如果你的目标是在湿实验室中识别一些基因来进一步研究,那么复杂的黑匣子的用途将是有限的,即使它非常准确。
2001年, Leo Breiman 在关于统计建模两种文化的著名文章“Statistical Modeling: The Two Cultures”中,就有力地阐述了这一点。“数据建模文化”侧重于解释数据的简单生成模型,而“算法建模文化 ”对数据是如何产生的并不了解,而是专注于寻找能够预测数据的模型。Breiman 认为,统计数据太受第一文化的支配,而这种关注“导致了不相关的理论和有问题的科学结论” 和“阻止统计学家研究令人兴奋的新问题。”
但是,Breiman 的论文充满争议。虽然 Brad Efron 对部分观点表示赞同,但“看第一遍,Leo Breiman 那篇令人振奋的论文看起来像是反对简约和科学洞察力,支持很多旋钮可操纵的黑盒子。而看第二遍,还是那个样子” 。但在近期一篇文章(“Prediction, Estimation, and Attribution”)中,Efron 大方承认“事实证明,Breiman 比我更有先见之明:纯粹的预测算法在 21 世纪占据了统计的风头,其发展方向与 Leo 此前提到的差不多。”
2 经典和现代预测模型
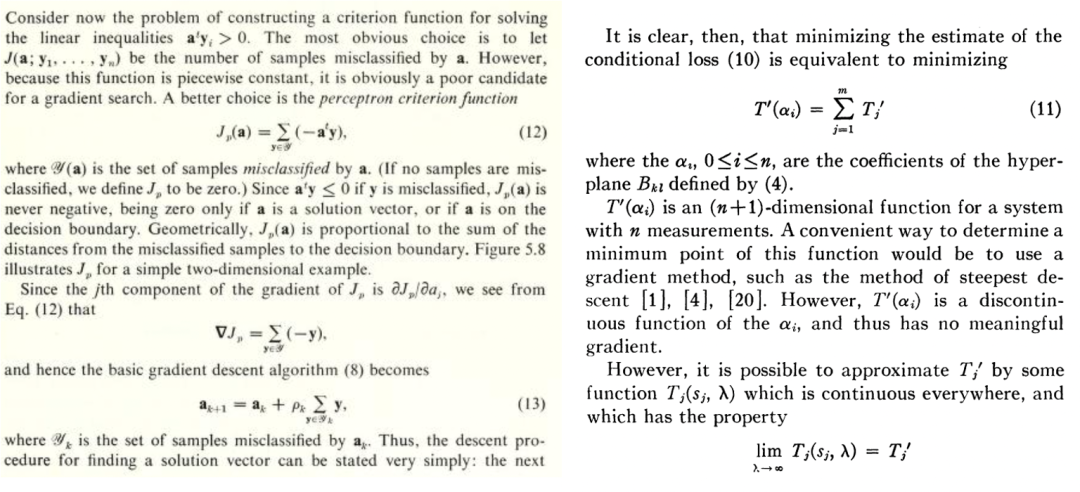
无论机器学习是否“深度”,它都属于 Breiman 所说的第二种文化,即专注于预测,这种文化已流传很长一段时间。例如 Duda 和 Hart 1973 年的教科书《Deconstructing Distributions: A Pointwise Framework of Learning》、以及Highleyman 1962 年《The Design and Analysis of Pattern Recognition Experiments》的论文片段,对于今天的深度学习从业者来说,其辨识度非常高:
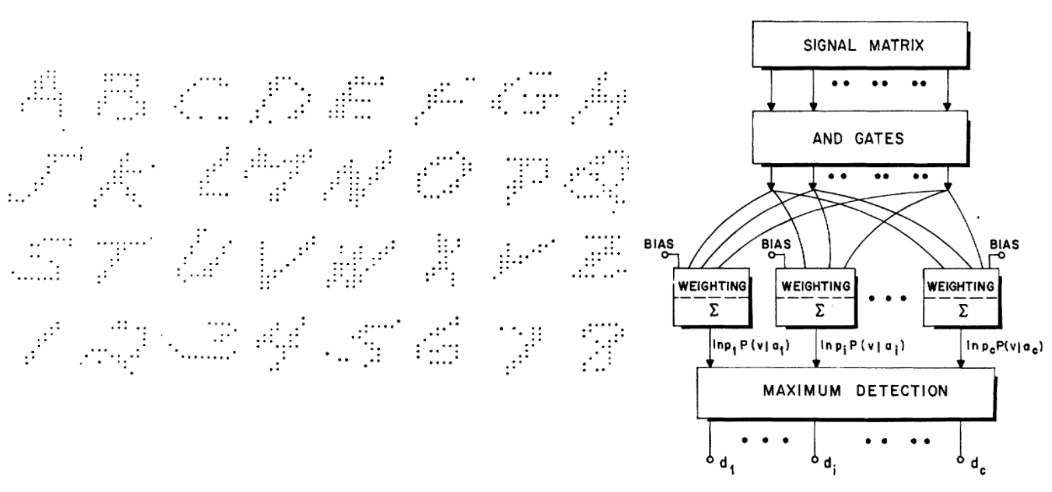
同样地,Highleyman 的手写字符数据集和被用来与数据集拟合的架构 Chow(准确率约为 58%)也引起了现代读者的共鸣。
3 为什么深度学习不同?
1992 年,Stuart Geman、Elie Bienenstock 和 Rene Doursat 共同写了一篇题为“Neural Networks and the Bias/Varian Dilemma”的论文,其中谈到一些悲观的看法,例如,“当前的前馈神经网络,在很大程度上不足以解决机器感知和机器学习中的难题”;具体来说,他们认为通用神经网络无法成功解决困难的任务,神经网络成功的唯一途径是通过手工设计特征。用他们的话来说,即是:“重要的特征必须是内置的或‘硬连线的’(hard-wired)……而不是通过统计的方法来学习。
”事后看来,他们的观点完全错了。而且,现代神经网络的架构如 Transformer 甚至比当时的卷积网络更通用。但理解他们犯错的背后原因是很有趣的。
我认为,他们犯错的原因是深度学习确实与其他学习方法不同。一个先验的现象是:深度学习似乎只是多了一个预测模型,像最近的邻居或随机森林。它可能有更多的“旋钮”(knobs),但这似乎是数量上而不是质量上的差异。用 PW Andreson 的话来说,就是“more is different”(多的就是不同的)。
在物理学中,一旦规模发生了几个数量级的变化,我们往往只需要一个完全不同的理论就可以解释,深度学习也是如此。事实上,深度学习与经典模型(参数或非参数)的运行过程是完全不同的,即使从更高的角度看,方程(和 Python 代码)看起来相同。
为了解释这一点,我们来看两个非常不同例子的学习过程: 拟合统计模型,与教学生学习数学。
场景A:拟合统计模型
通常来说,将统计模型与数据进行拟合的步骤如下:
1、我们观察一些数据 x 与y。可将 x 视为一个 n x p 的矩阵,y 视为一个 n 维向量;数据来源于一个结构和噪声模型:每个坐标 的得到形式是
 ,其中
 是对应的噪声,为简单起见使用了加性噪声,而
 是正确的真实标签。)
2、通过运行某种优化算法,我们可以将模型 拟合到数据中,使
 的经验风险最小。也就是说,我们使用优化算法来找到
 的最小化数量
 ,其中
 是一个损失项(捕捉
 距离 y 有多近),
 是一个可选的规范化项 (试图使得
 偏向更简单的模型)。
3、我们希望,我们的模型能具有良好的总体损失,因为泛化误差/损失 很小(这种预测是基于实验数据所在的总体数据来获得的)。
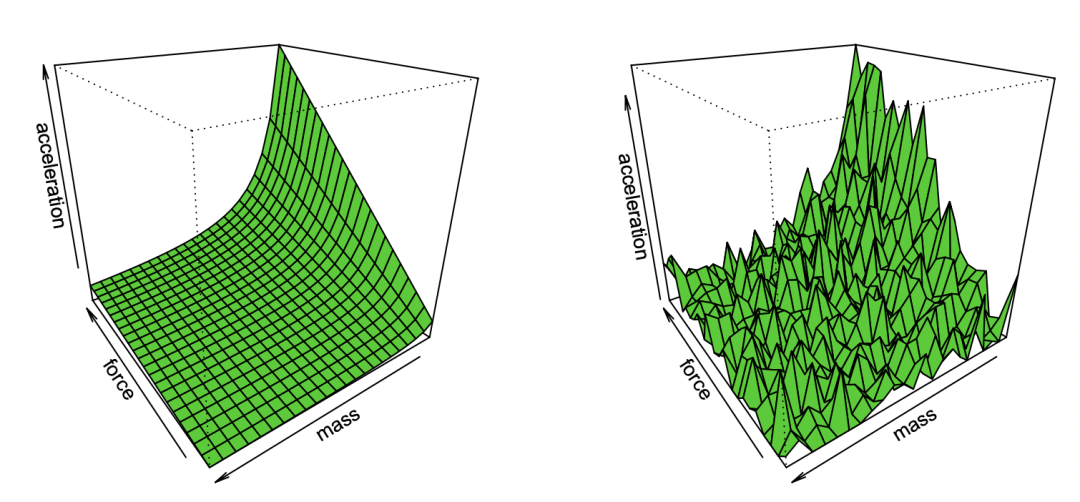
图注:Bradley Efron经过对噪音的观察所复现的牛顿第一定律漫画
这种非常通用的范式包含了许多设置,包括最小二乘线性回归、最近邻、神经网络训练等等。在经典的统计设置中,我们期望观察到以下情况:
偏差/方差权衡:将 F 作为优化的模型集。(当我们处于非凸设置和/或有一个正则器项,我们可以让 F作为这种模型的集合,考虑到算法选择和正则器的影响,这些模型可以由算法以不可忽略的概率实现。)
F 的偏差是对正确标签的最佳近似,可以通过元素 来实现。F 的类越大,偏差越小,当
 ,偏差甚至可以是零。然而,当 F 类越大, 则需要越多样本来缩小其成员范围,从而算法输出模型中的方差就越大。总体泛化误差是偏差项和方差贡献的总和。
因此,统计学习通常会显示偏差/方差权衡,并通过正确模型复杂性的“金发姑娘选择”来最小化整体误差。事实上,Geman 等人也是这么做的,通过说“偏差-方差困境导致的基本限制适用于包括神经网络在内的所有非参数推理模型”来证明他们对神经网络的悲观情绪是合理的。
更多并非总是最好的。在统计学习中,获得更多的特征或数据并不一定能提高性能。例如,从包含许多不相关特征的数据中学习更具挑战性。类似地,从混合模型中学习,其中数据来自两个分布之一(例如 和
 ),比独立学习单个更难。
收益递减。在许多情况下,将预测噪声降低到某个参数 ,其所需的数据点数量在某些参数 k 下以
 的形式拓展。在这种情况下,需要大约 k 个样本来“起飞”,而一旦这样做,则会面临收益递减的制度,即假设花耗 n 个点来达到(比如)90%的准确度,那么想要将准确度提高到95%,则大约需要另外 3n 个点。一般来说,随着资源增加(无论是数据、模型的复杂性,还是计算),我们希望捕捉到更多更细的区别,而不是解锁新的质量上的能力。
对损失、数据的强烈依赖。在将模型拟合到高维数据时,一个很小的细节就有可能造成结果的很大不同。统计学家知道,诸如 L1 或 L2 正则化器之类的选择很重要,更不用说使用完全不同的数据集,不同数量的高维优化器将具有极大的差异性。
数据点没有自然的“难度”(至少在某些情况下)。传统上认为,数据点是独立于某个分布进行采样的。尽管靠近决策边界的点可能更难分类,但考虑到高维度的测量集中现象,可预计大多数点的距离将存在相似的情况。因此,至少在经典数据分布中,并不期望点在其难度水平上有很大差异。然而,混合模型可以显示这种差异的不同难度级别,所以与上述其他问题不同,这种差异在统计设置中不会非常令人惊讶。
场景B:学习数学
与上述相反,我们来谈谈教学生一些特定的数学题目(如计算导数),给予他们常规指导及要做的练习。这不是一个正式定义的设置,但可考虑它的一些定性特征:
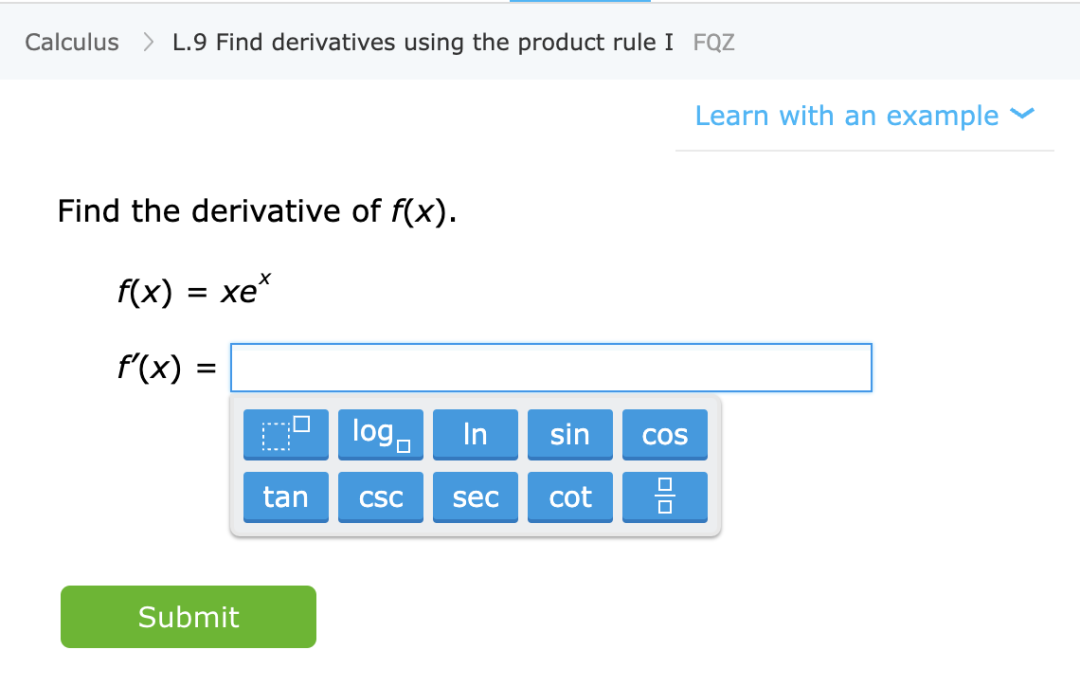
图注:从IXL 网站学习特定数学技能的练习
学习一项技能,而不是近似分布。在这种情况下,学生是学习一种技能,而非某个数量的估计器/预测器。虽然定义“技能”不是一项微不足道的任务,但却是一个性质不同的目标。特别是,即使函数映射练习不能用作解决某些相关任务 X 的“黑匣子”,但我们相信,学生在解决这些问题时所形成的内部表征,仍是对 X 有用的。
越多越好。一般来说,学生练习更多问题和不同类型问题,会取得更好的成绩。但事实上,“混合模型”——做一些微积分问题和代数问题——不会影响学生在微积分上的表现,反而会帮助他们学习。
“探索”或解锁功能,转向自动表示。虽然在某些时候解决问题也会出现收益递减,但学生似乎确实经历了几个阶段,有的阶段做一些问题有助于概念“点击”并解锁新功能。另外,当学生们重复某一特定类型的问题时,他们似乎将自己的能力和对这些问题的表述转移至较低的水平,使他们能够对这些问题产生某些以前所没有的自动性。
性能部分独立于损失和数据。教授数学概念的方法不止一种,即使学生使用不同书籍、教育方法或评分系统学习,但最终仍可学习到相同的材料和相似的内部表示。
一些问题更难。在数学练习中,我们经常可以看到不同学生在解决同一个问题时所采取的方法存在很强的相关性。一个问题的难度似乎是固定的,解决难题的顺序也是固定的,这就使学习的过程能够优化。这事实上也是IXL等平台正在做的事情。
4 深度学习更像统计估计还是学生学习技巧?
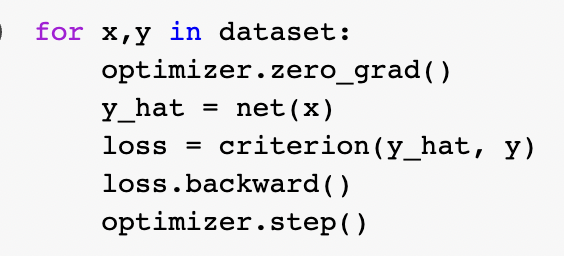
那么,上述两个比喻中,哪个更恰当地描述了现代深度学习,特别是它如此成功的原因呢?统计模型拟合似乎更符合数学和代码。实际上,规范的 Pytorch 训练循环,就是通过如上所述的经验风险最小化来训练深度网络的:
然而,在更深层次上,这两种设置之间的关系并不那么清楚。具体而言,可以通过修复一个特定的学习任务来展开,使用“自监督学习 + 线性探头(linear probe)”的方法训练分类算法,其算法训练如下:
1、假设数据是一个序列 ,其中
 是某个数据点(例如具体的图像)、
 是一个标签。
2、首先找到一个深度神经网络来表示函数 ,这个函数的训练只使用数据点
 而不使用标签,通过最小化某种类型的自监督损失函数。这种损失函数的例子是重建或画中画(从另一个输入 x 的某些部分恢复)或对比学习(找到
 使
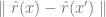 显著更小,当
 是同一个数据点的增量时,并列关系比两个随机点的并列关系要小得多)。
3、然后我们使用完整的标记数据 来拟合线性分类器
 (其中 C 是类的数量),使交叉熵损失最小。最终的分类器得出了
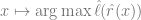 的映射。第 3 步仅适合线性分类器,因此“魔法”发生在第 2 步(深度网络的自监督学习)。在自监督学习中,可以看到的一些属性包括:
学习一项技能,而不是逼近一个函数。自监督学习不是逼近一个函数,而是学习可用于各种下游任务的表示。假设这是自然语言处理中的主导范式,那么下游任务是通过线性探测、微调还是提示获得,都是次要的。
越多越好。在自监督学习中,表征的质量随着数据量的增加而提高。而且,数据越多样越好。
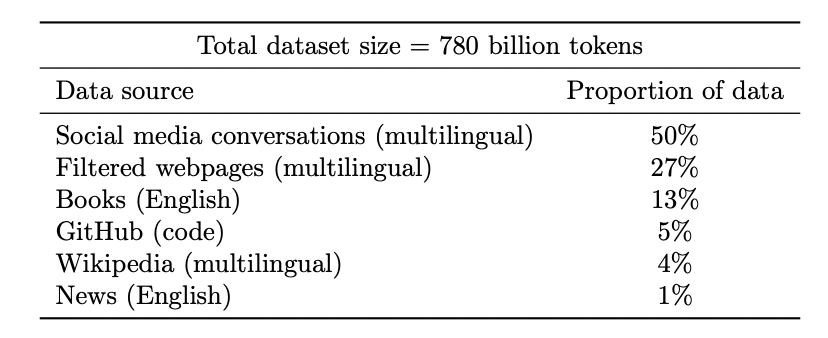
图注:谷歌 PaLM 模型的数据集
解锁能力。随着资源(数据、计算、模型大小)的拓展,深度学习模型的不连续改进一次又一次地被看到,这在一些合成环境中也得到了证明。
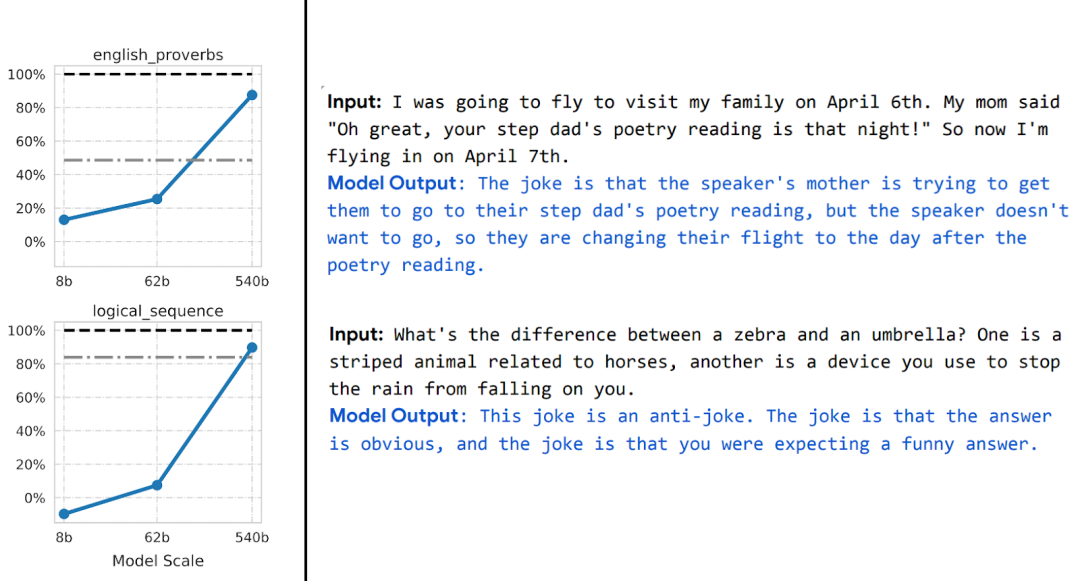
图注:随着模型大小的增加,PaLM 模型在一些基准测试中显示出一些不连续的改进(上述图中只有三个大小的警告),并解锁了一些令人惊讶的功能,比如解释笑话。
性能在很大程度上与损失或数据无关。不止一种自监督损失,有几种对比性和重建性损失被用于图像。语言模型有时采用单面重建(预测下一个标记),有时则是使用掩蔽模型,其目标是预测来自左右标记的掩蔽输入。
也可以使用稍微不同的数据集,这可能会影响效率,但只要做出“合理”的选择,常规情况下,原始资源比使用的特定损失或数据集更能预测性能。
有些实例比其他实例更难。这一点不只限于自监督学习,数据点或存在一些固有的“难度级别”。
事实上,有几个实际证据表明,不同的学习算法有不同的“技能水平”,不同的点有不同的“难度水平”(分类器 f 对 x 进行正确分类的概率,随着 f 的技能单向递增,随 x 的难度单向递减)。“技能与难度”范式是对 Recht 和 Miller 等人所发现的“线上准确性”现象最清晰的解释,在我同 Kaplun、Ghosh、Garg 和 Nakkiran 的合著论文中,还展示了数据集中的不同输入如何具有固有的“难度特征”,常规情况下,该特征似乎对不同的模型来说是稳健的。
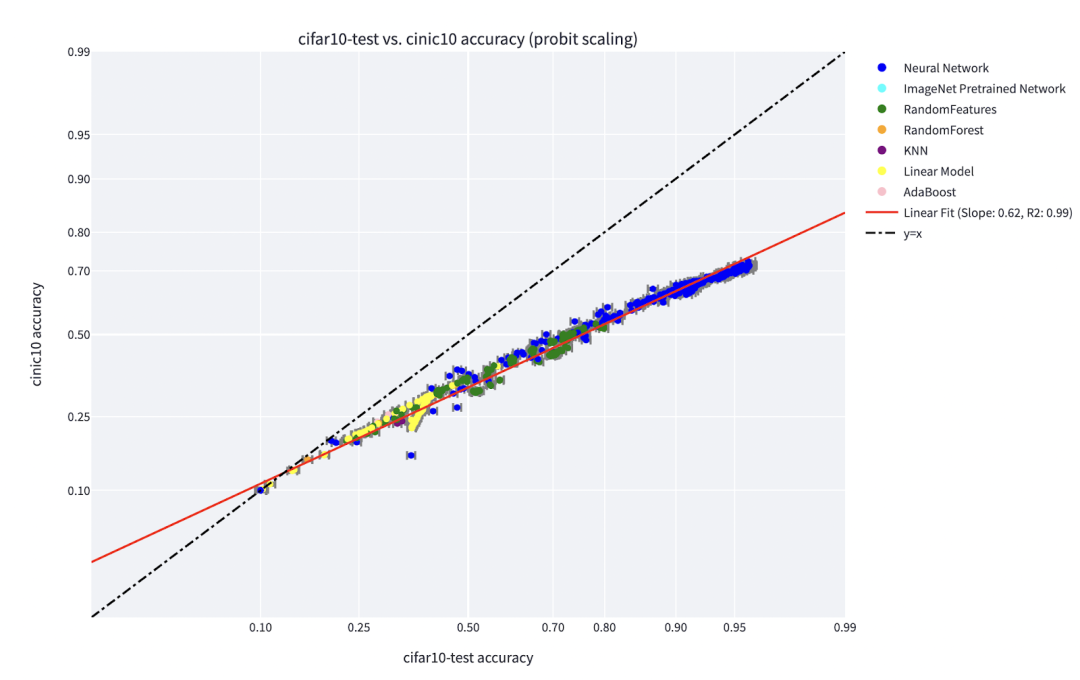
图注:Miller 等人的图表显示了在 CIFAR-10 上训练并在 CINIC-10 上测试的分类器的线现象准确性
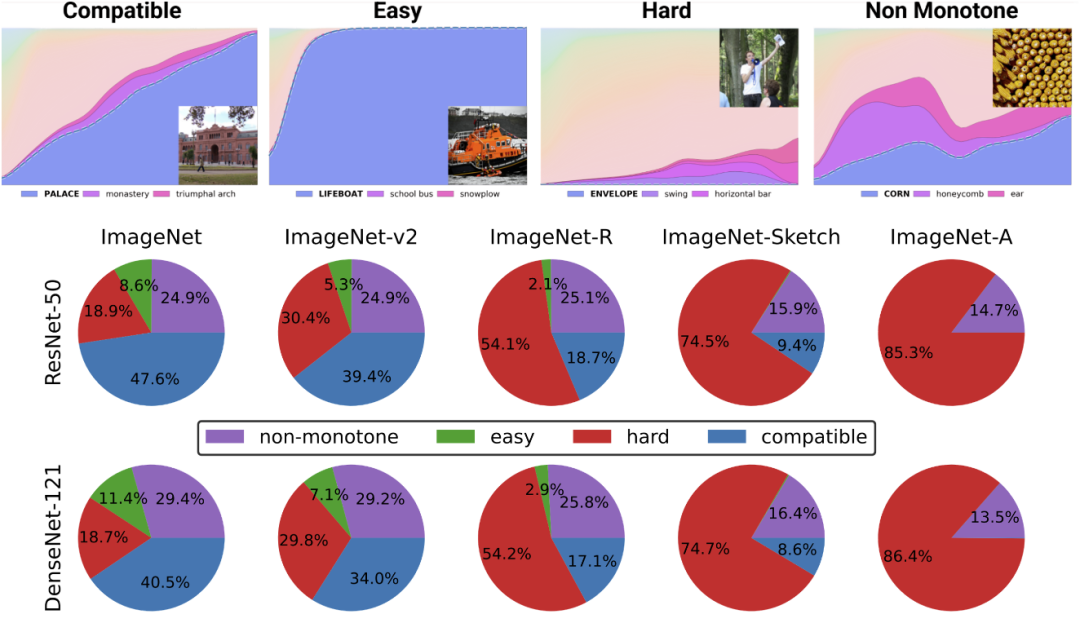
图注:将数据集解构为来自 Kaplun 和 Ghosh 等人在论文“Deconstructing Distributions: A Pointwise Framework of Learning”中的不同“难度概况”点,以获得越来越多的资源分类器。顶部图表描述了最可能类的不同 softmax 概率,作为由训练时间索引的某个类别分类器的全局精度的函数;底部饼图展示了将不同数据集分解为不同类型的点。值得注意的是,这种分解对于不同的神经架构是相似的。
训练即教学。现代对大模型的训练似乎更像是在教学生,而不是让模型适应数据,在学生不理解或看起来疲劳(训练偏离)时采取“休息”或尝试其他方式。Meta 大模型的训练日志很有启发性——除了硬件问题外,还可以看到一些干预措施,例如在训练过程中切换不同的优化算法,甚至考虑“热交换”激活函数(GELU 到 RELU)。如果将模型训练视为拟合数据而不是学习表示,则后者没有多大意义。
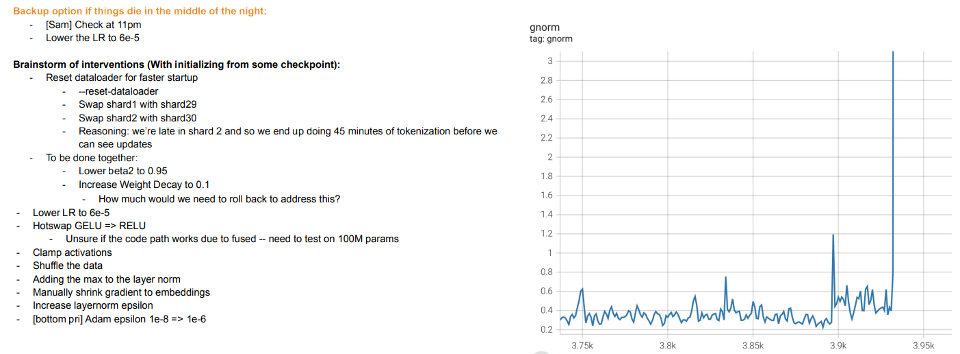
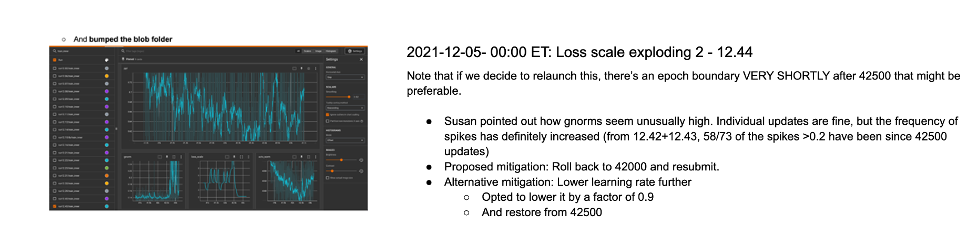
图注:Meta 的训练日志节选下面探讨两种情况:
情况1:监督学习
到目前为止,我们只讨论了自监督学习,但深度学习的典型例子仍然是监督学习,毕竟深度学习的 “ImageNet时刻”是来自ImageNet。那么,我们上面所探讨的内容是否适用于监督学习呢?
首先,有监督的大规模深度学习的出现,在某种程度上是一个历史性的意外,这得益于大型高质量标记数据集(即 ImageNet)的可用性。可以想象另一种历史:深度学习首先通过无监督学习在自然语言处理方面取得突破性进展,然后才转移到视觉和监督学习中。
其次,有一些证据表明,即使监督学习与自监督学习使用完全不同的损失函数,它们在“幕后”的行为也相似。两者通常都能达到相同的性能。在“Revisiting Model Stitching to Compare Neural Representations”这篇论文中也发现,它们学习了相似的内部表示。具体来说,对于每一个 ,都可以将通过自监督训练的深度 d 模型的首 k 层数与监督模型的最后 d-k 层数“缝合”起来,并且使性能几乎保持原有水平。
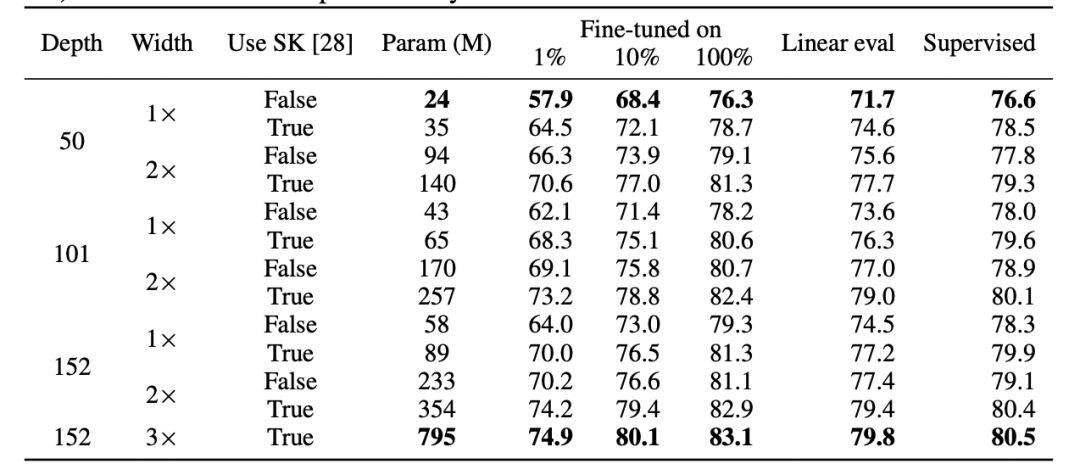
图注:来自 Hinton 团队论文“Big Self-Supervised Models are Strong Semi-Supervised Learners”的表格。请注意监督学习、微调 (100%) 自监督和自监督 + 线性探测在性能上的普遍相似性
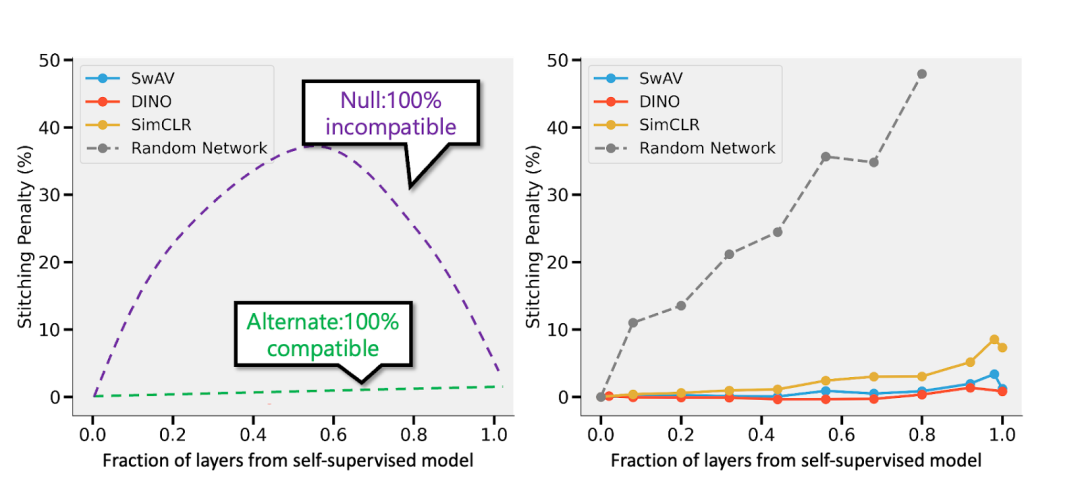
图注:摘自论文“Revisiting Model Stitching to Compare Neural Representations”的自监督与监督模型。左图——如果自监督模型的准确度比监督模型低3%,那么,完全兼容的表示将造成 p·3% 的拼接惩罚(p层来自自监督模型时)。如果模型完全不兼容,那么随着更多模型的缝合,预计准确度会急剧下降。右图——拼接不同自监督模型的实际结果。
自监督 + 简单模型的优势在于,它们可以将特征学习或“深度学习魔法”(深度表示函数的结果)与统计模型拟合(由线性或其他“简单”分类器完成,分离出来在此表示之上)。
最后,虽然是推测,但“元学习”似乎通常等同于学习表示这一事实(详情看论文“Rapid Learning or Feature Reuse? Towards Understanding the Effectiveness of MAML”),可以视为另一个支持本文观点的证据,不管模型表面上优化的目标是什么。
情况2:过度参数化
读者可能已经注意到,我跳过了统计学习模型与深度学习模型在实际应用中存在差异的典型例子,即缺少“偏差-方差权衡”以及过度参数化模型出色的泛化能力。
我不详细讲这些例子的原因有两个:
一是如果监督学习确实等于自监督 + 简单的“底层”学习,那么就可以解释它的泛化能力(详情请看论文“For self-supervised learning, Rationality implies generalization, provably”);
二是我认为过度参数化并不是深度学习成功的关键。深度网络之所以特别,并不是因为它们与样本数量相比很大,而是因为它们的绝对值很大。实际上,无监督/自监督学习模型中通常没有过度参数化。即使是大规模的语言模型,它们也只是数据集更大,但这也并没有减少它们性能的神秘性。
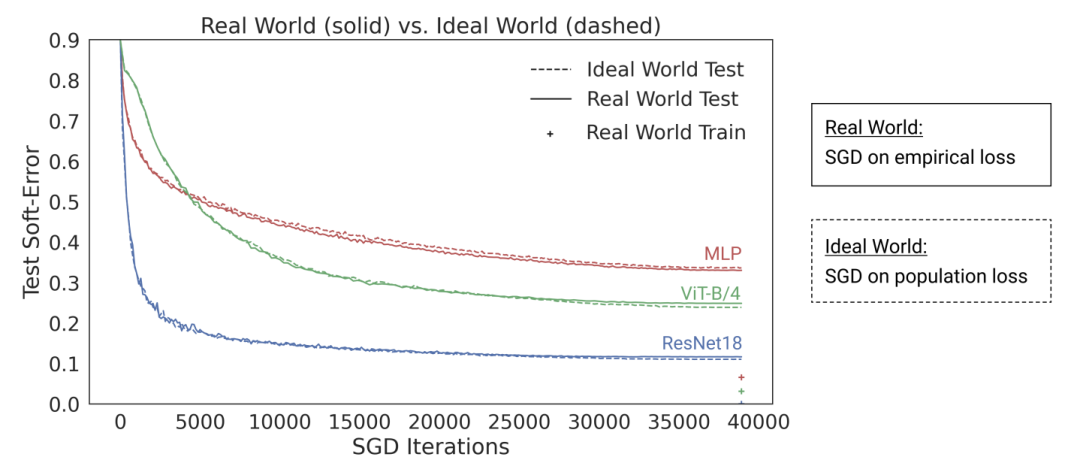
图注:在“The Deep Bootstrap Framework: Good Online Learners are Good Offline Generalizers”这篇论文中,研究者的发现表明,如今的深度学习架构在“过度参数化”与“欠采样”状态下表现相似(其中,模型在有限数据上训练多代,直到过度拟合:也就是上图所示的“真实世界”),在“参数化不足”与“在线”情况下也如此(其中,模型只训练一代,每个样本只看到一次:也就是上图中的“理想世界”)
5 总结
毫无疑问,统计学习在深度学习中扮演着重要的角色。但是,如果仅仅将深度学习视为一个比经典模型拟合更多旋钮(knobs)的模型,则会忽略其成功背后的许多因素。所谓的“人类学生”隐喻更是不恰当表述。
深度学习与生物进化相似,虽然对同一规则(即经验损失的梯度下降)有许多重复的应用,但会产生高度复杂的结果。在不同的时间内,神经网络的不同组成部分似乎会学习不同的内容,包括表示学习、预测拟合、隐式正则化和纯噪声等。目前我们仍在寻找正确的视角来提出有关深度学习的问题,更别说回答这些问题了。
任重道远,与君共勉。
理清幻方量化与DeepSeek的发展脉络,关键在于区分早期萤火二号的A100集群积累与DeepSeek-V3的H800训练配置。本文解析软硬件协同工程在其中的作用,避免将资金投入简单等同于模型能力。
背景由于云计算在资源成本和弹性扩容方面的天然优势,越来越多客户愿意在云上构建 AI 系统,而以容器、Kubernetes 为代表的云原生技术,已经成为释放云价值的最短路径, 在云上基于 Kubernetes 构建 AI 平台已经成为趋势。在面对较为复杂的模型训练或者大量数据时,单机的计算能力往往难以
华盛顿大学团队构建TheoremGraph,从arXiv提取1170万条定理陈述,利用Lean证明库获取388k形式化声明,通过slogan嵌入匹配和GPT-5.4裁决,确认47952对跨模态对应,有效连接非形式化与形式化数学知识,推动数学推理研究。
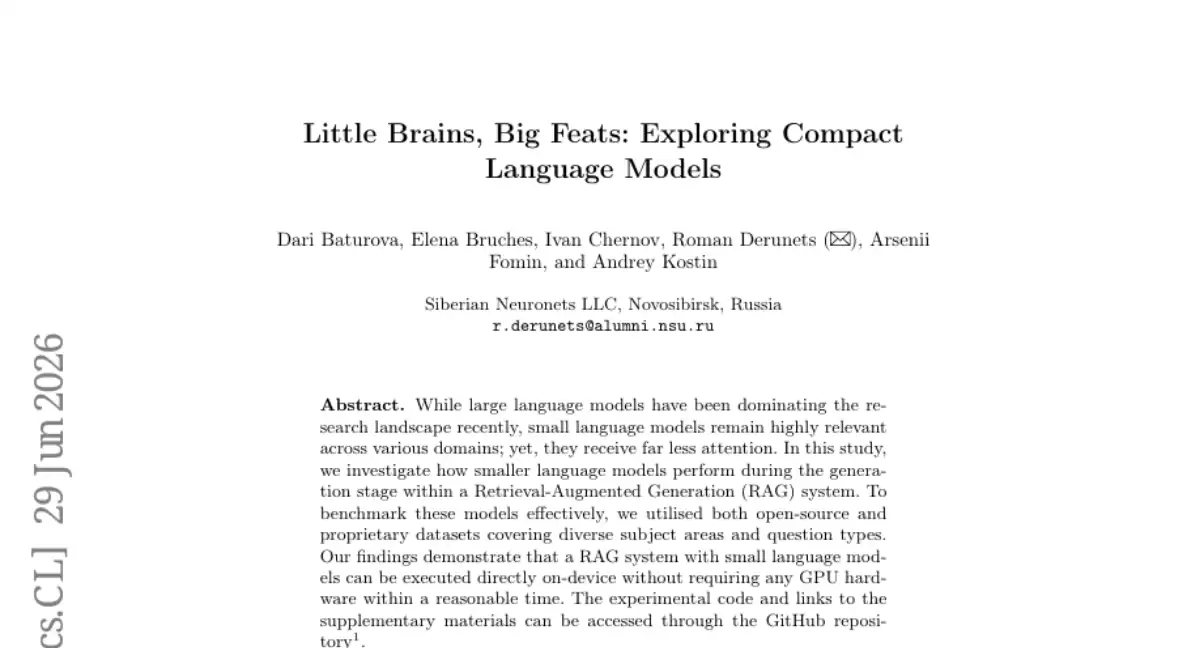
西伯利亚神经网络公司研究团队在arXiv发布预印本,测试了17个小模型在俄语RAG问答系统中的表现。结果表明,Qwen3系列小模型在答案质量上接近GPT-5-mini,且可在普通电脑CPU运行。但CPU推理速度较慢,实际应用需在速度与质量间取舍。
轻量化浏览器的崛起:当极简主义成为生产力 这些年,浏览器的战场早已不再局限于功能和扩展的堆砌。一股轻量、高效的“清流”正在改变用户的上网习惯,而夸克浏览器无疑是这股潮流中的佼佼者。它以清爽的界面和高效的核心性能,成功在移动端圈粉无数。好消息是,这股清爽之风如今也吹到了电脑桌面上——通过官方网页版入口
学习通网页版登录入口:通往数字课堂的便捷通道 作为师生获取在线教育资源的关键门户,学习通网页版登录入口的设计直接影响到数字化学习体验的流畅度。下面这份指南将带你系统掌握官方认证通道的使用要领,让每次登录都成为高效学习的开端。 官方登录入口:直达学习核心区 超星官方指定的入口地址始终是最可靠的选择:点
漫画爱好者的掌上宝库:喵趣漫画官方下载全解析 对于漫画迷而言,找到合适的阅读平台至关重要。喵趣漫画官方下载入口恰好提供了这样的解决方案——这里不仅是海量正版资源的聚集地,更打造了一站式的跨终端阅读体验。应用内覆盖了热血、恋爱、悬疑等主流题材,配合智能设备适配技术,让阅读真正实现无缝衔接。界面设计简洁
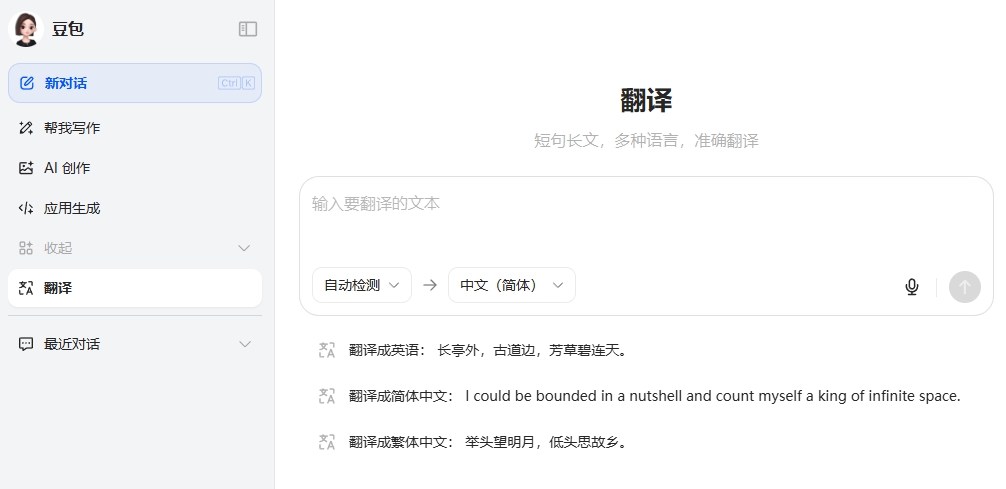
高效语言转换工具的选择直接影响跨文化交流效果 选对翻译工具,往往能让跨文化交流事半功倍。今天我们就来详细解析豆包AI翻译网页版的核心功能与操作要点,帮你快速掌握这个实用工具的使用诀窍。 豆包AI翻译网页版入口: 访问地址再简单不过:https://www.doubao.com/ch@t/transl
PaddleX是基于百度飞桨的一站式视觉开发套件,封装了模型训练、压缩与部署流程,显著降低开发门槛。它支持图像分类、目标检测等任务,提供图形界面与PythonAPI双模式,便于从可视化操作平滑过渡到代码开发。典型工作流程包括数据准备、模型选择、训练评估及部署。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



