

能听懂语音的ChatGPT来了:10小时录音扔进去,想问什么问什么
大型语言模型(LLM)正在改变每个行业的用户期望。然而,建立以人类语音为中心的生成式人工智能产品仍然很困难,因为音频文件对大型语言模型构成了挑战。将LLM应用于音频文件的一个关键挑战是,LLM受其上下文窗口的限制。在一个音频文件能够被送入LLM之前,它需要被转换成文本。音频文件越长,绕过LLM的上下文窗口限制的工程挑战就越大。但工作场景中,我们往往需要LLM帮我们处理非常长的语音文件,比如从一段几个小时的会议录音中抽取核心内容、从一段访谈中找到某个问题的答案……最近,语音识别AI公司AssemblyAI推
大型语言模型(LLM)正在改变每个行业的用户期望。然而,建立以人类语音为中心的生成式人工智能产品仍然很困难,因为音频文件对大型语言模型构成了挑战。
将 LLM 应用于音频文件的一个关键挑战是,LLM 受其上下文窗口的限制。在一个音频文件能够被送入 LLM 之前,它需要被转换成文本。音频文件越长,绕过 LLM 的上下文窗口限制的工程挑战就越大。但工作场景中,我们往往需要 LLM 帮我们处理非常长的语音文件,比如从一段几个小时的会议录音中抽取核心内容、从一段访谈中找到某个问题的答案……
最近,语音识别 AI 公司 AssemblyAI 推出了一个名为 LeMUR 的新模型。就像 ChatGPT 处理几十页的 PDF 文本一样,LeMUR 可以将长达 10 小时的录音进行转录、处理,然后帮用户总结语音中的核心内容,并回答用户输入的问题。
试用地址:https://www.assemblyai.com/playground/v2/source
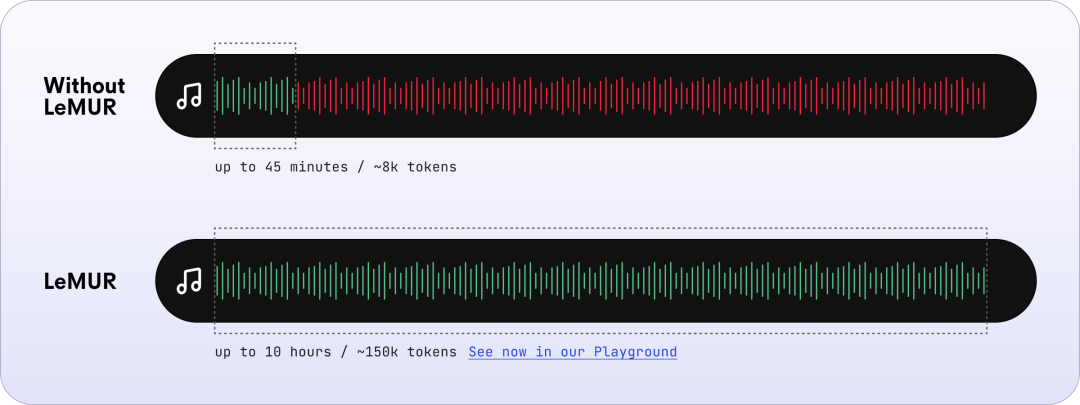
LeMUR 是 Leveraging Large Language Models to Understand Recognized Speech(利用大型语言模型来理解识别的语音)的缩写,是将强大的 LLM 应用于转录的语音的新框架。只需一行代码(通过 AssemblyAI 的 Python SDK),LeMUR 就能快速处理长达 10 小时的音频内容的转录,有效地将其转化为约 15 万个 token。相比之下,现成的、普通的 LLM 只能在其上下文窗口的限制范围内容纳最多 8K 或约 45 分钟的转录音频。
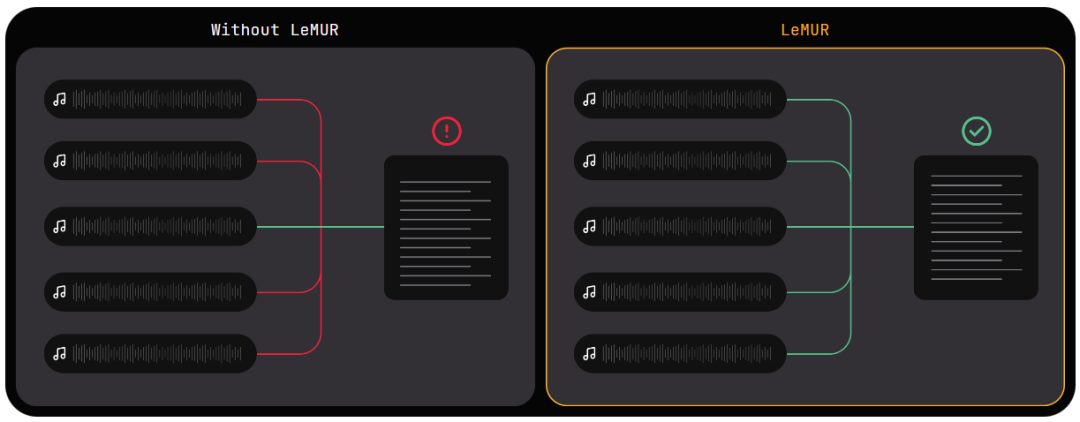
为了降低将 LLM 应用于转录音频文件的复杂性,LeMUR 的 pipeline 主要包含智能分割、一个快速矢量数据库和若干推理步骤(如思维链提示和自我评估),如下图所示:
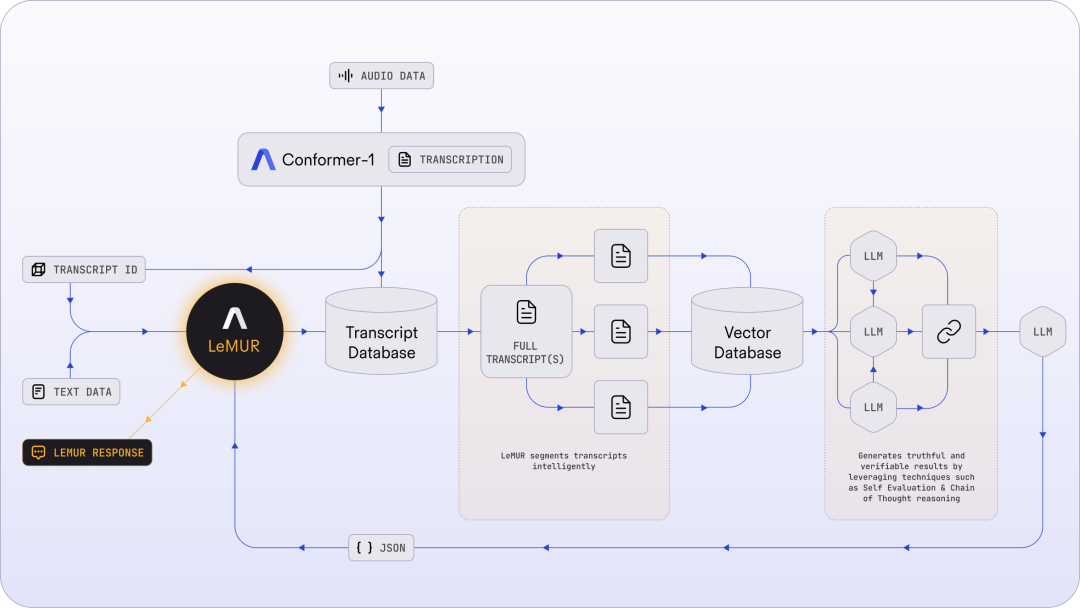
图 1:LeMUR 的架构使用户能够通过一个 API 调用将长的和 / 或多个音频转录文件发送到 LLM 中。
未来,LeMUR 有望在客服等领域得到广泛应用。
LeMUR 解锁了一些惊人的新可能性,在几年前,我认为这些都是不可能的。它能够毫不费力地提取有价值的见解,如确定最佳行动,辨别销售、预约或呼叫目的等呼叫结果,感觉真的很神奇。—— 电话跟踪和分析服务技术公司 CallRail 首席产品官 Ryan Johnson
LeMUR 解锁了什么可能性?
将 LLM 应用于多个音频文本
LeMUR 能够让用户一次性获得 LLM 对多个音频文件的处理反馈,以及长达 10 小时的语音转录结果,转化后的文本 token 长度可达 150K 。
可靠、安全的输出
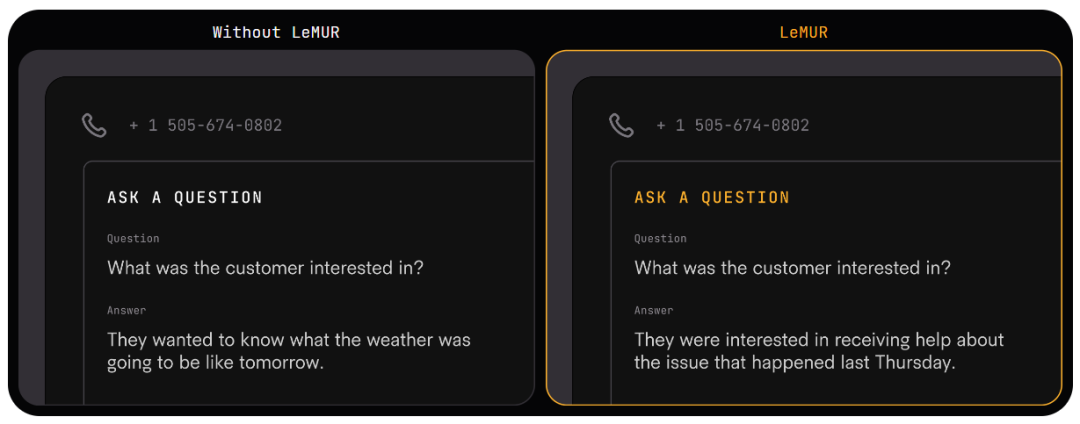
由于 LeMUR 包含安全措施和内容过滤器,它将为用户提供来自 LLM 的回应,这些回应不太可能产生有害或有偏见的语言。
可补充上下文
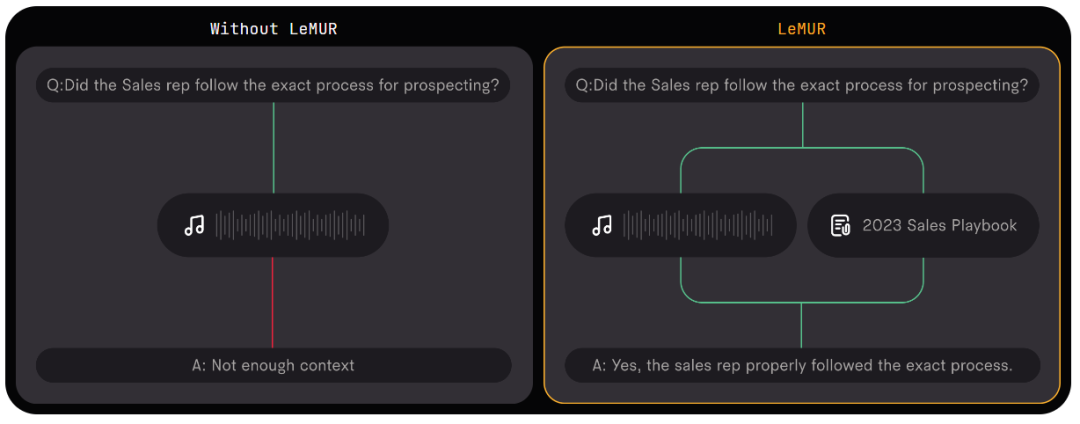
在推理时,它允许加入额外的上下文信息,LLM 可以利用这些额外信息在生成输出时提供个性化和更准确的结果。
模块化、快速集成
LeMUR 始终以可处理的 JSON 形式返回结构化数据。用户可以进一步定制 LeMUR 的输出格式,以确保 LLM 给出的响应是他们下一块业务逻辑所期望的格式(例如将回答转化为布尔值)。在这一流程中,用户不再需要编写特定的代码来处理 LLM 的输出结果。
试用结果
根据 AssemblyAI 提供的测试链接,机器之心对 LeMUR 进行了测试。
LeMUR 的界面支持两种文件输入方式:上传音视频文件或粘贴网页链接均可。
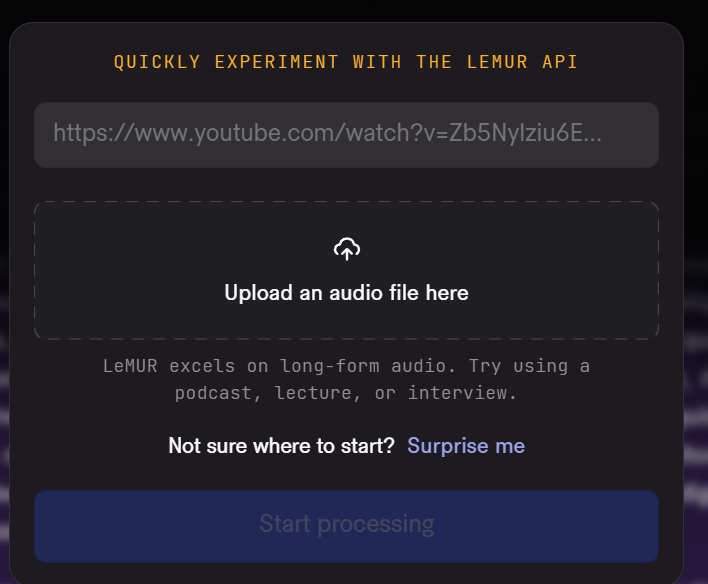
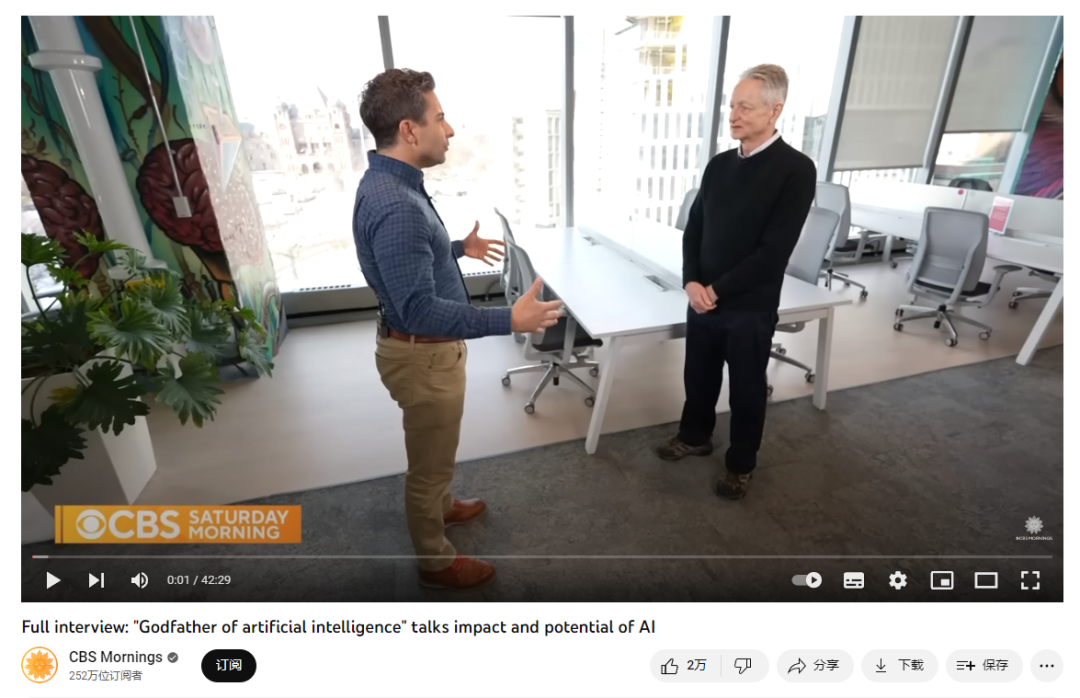
我们用 Hinton 近期的一份访谈资料作为输入,测试 LeMUR 的性能。
上传之后,系统提示我们要等一段时间,因为它要先把语音转成文字。
转录之后的界面如下:
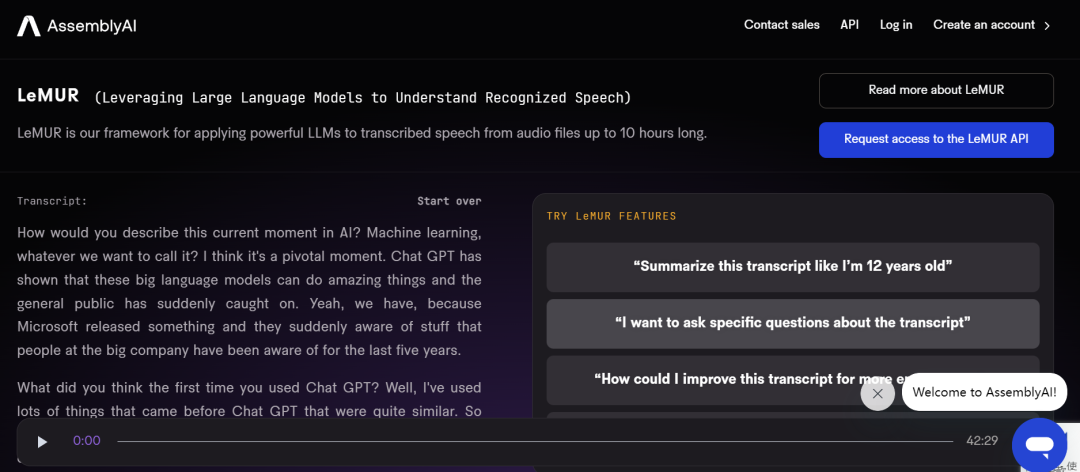
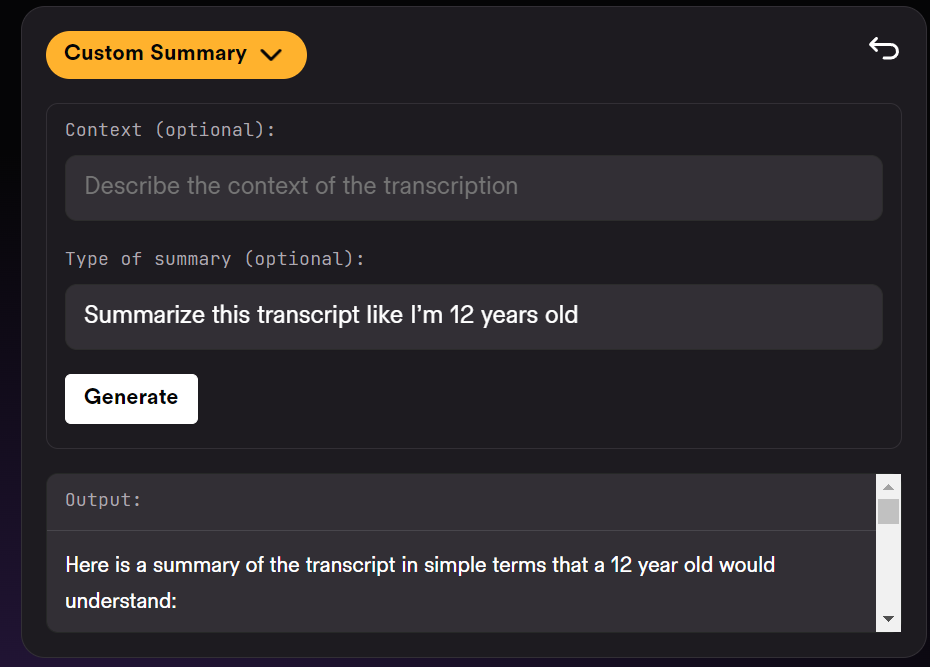
在页面右侧,我们可以要求 LeMUR 总结采访内容或回答问题。LeMUR 基本可以轻松地完成任务:
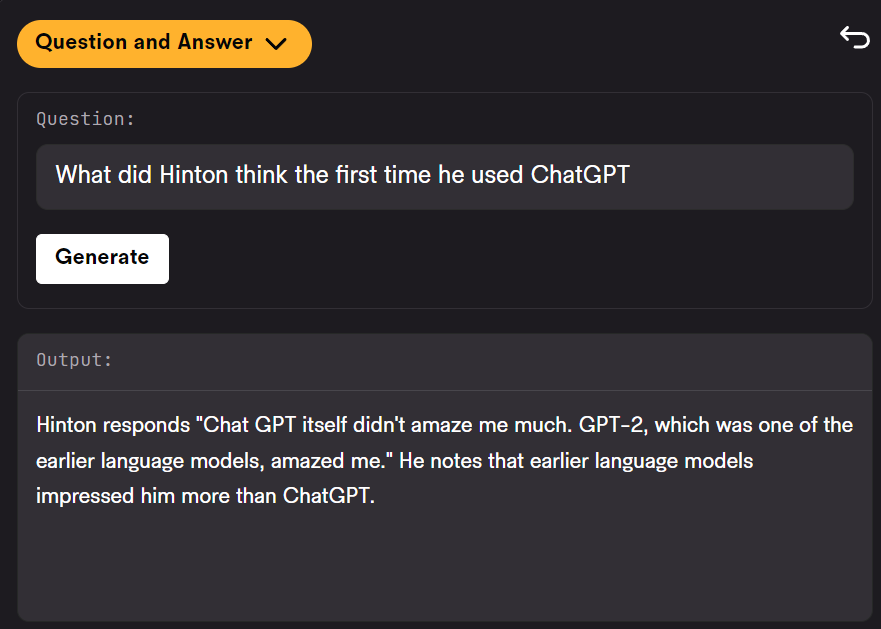
如果要处理的语音是一段演讲或客服回复,你还能向 LeMUR 征求改进建议。
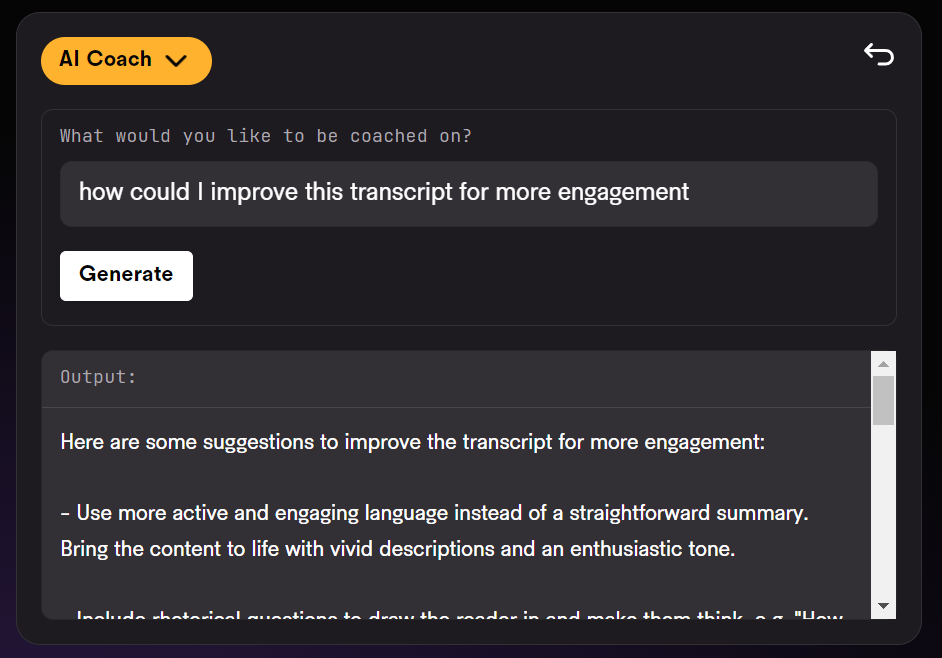
不过,LeMUR 似乎目前还不支持中文。感兴趣的读者可以去尝试一下。


5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
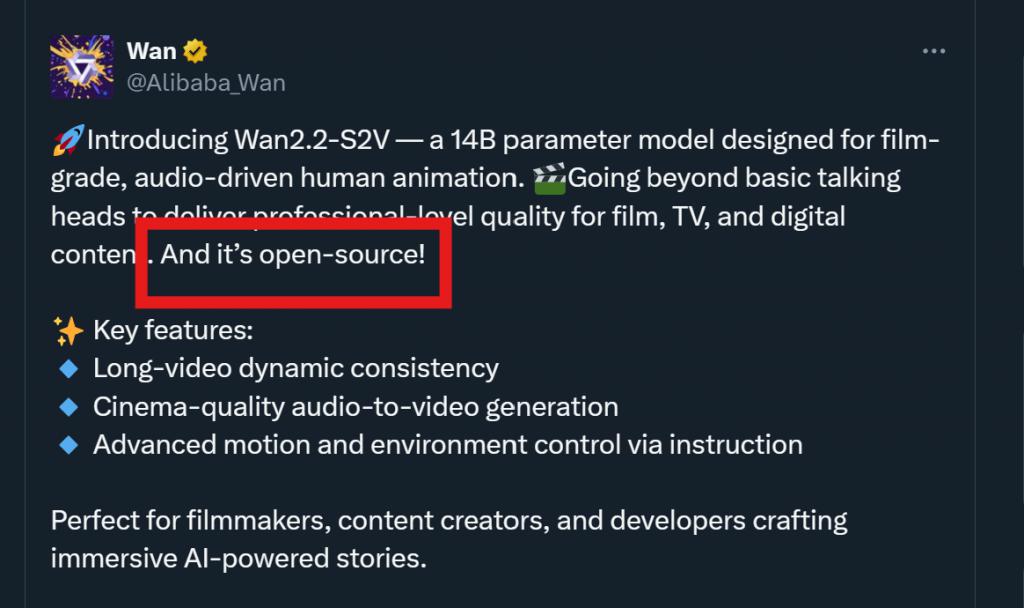
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
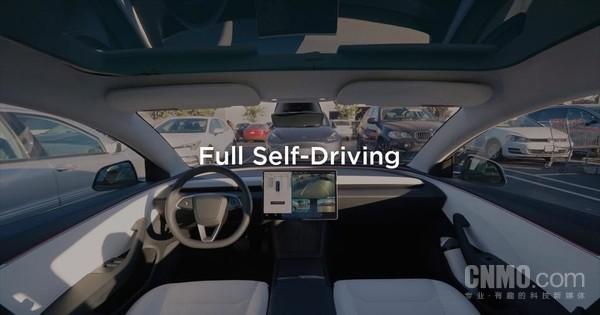
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足
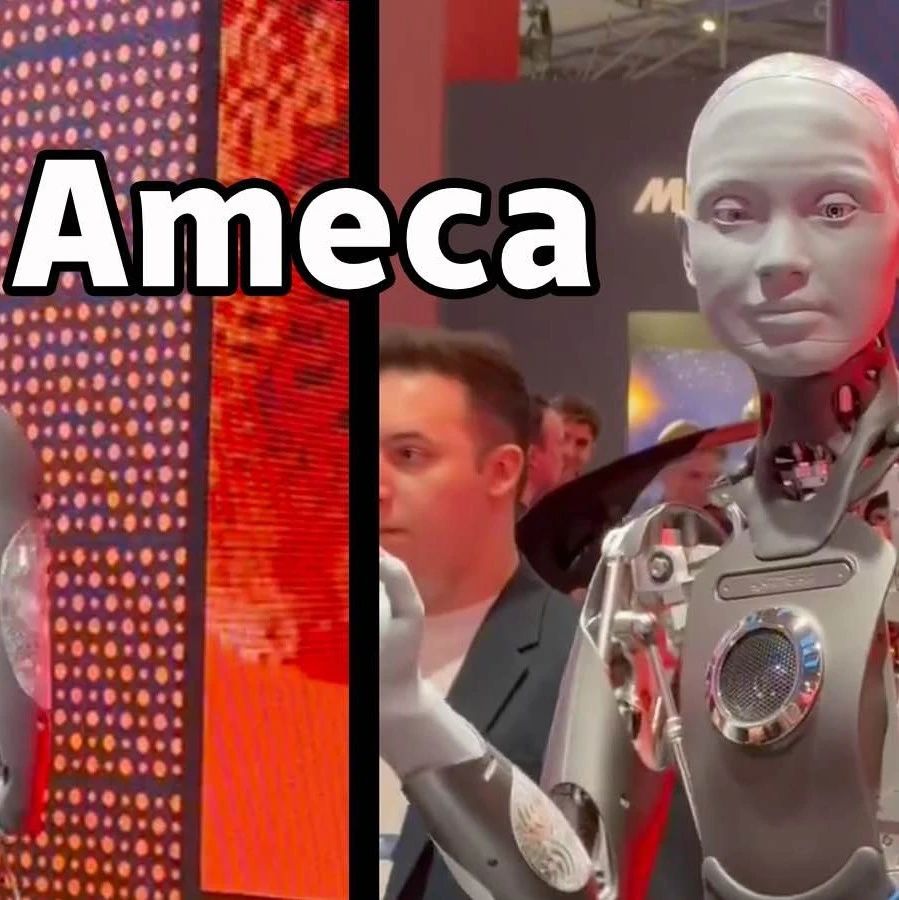
编辑:桃子【新智元导读】第二代Ameca升级亮相,搭载GPT-4技术,实现实时对话。人形机器人Ameca迎来了它的第二代版本!近期,在2024年世界移动通信大会(MWC)上,全球最先进的机器人Ameca再度亮相。Ameca在会场周围吸引了大量观众。通过GPT-4的增强,Ameca能够即时回应各种问题。「展示一段舞蹈吧」。当被问及是否有情感时,Ameca通过一系列逼真的面部表情作出回应。就在几天前,开发Ameca的英国机器人公司EngineeredArts展示了他们团队的最新成果。视频中,Ameca具备了
4月2日,HuggingFace大模型榜单迎来更新,阿里通义千问近期开源的端到端全模态大模型Qwen2.5-Omni力压群雄,荣登榜首!DeepSeek-V3-0324和群核的SpatialLM-Llama-1B紧随其后,杭州公司包揽榜单前三甲。Qwen2.5-Omni展现出卓越的多模态处理能力,能够流畅处理文本、图像、音频和视频等多种数据类型,并实时生成文本及语音输出。在OmniBench等权威多模态融合任务评测中,其性能表现创下新纪录。令人惊喜的是,它仅拥有70亿参数的小巧体积,这使得全模态大模
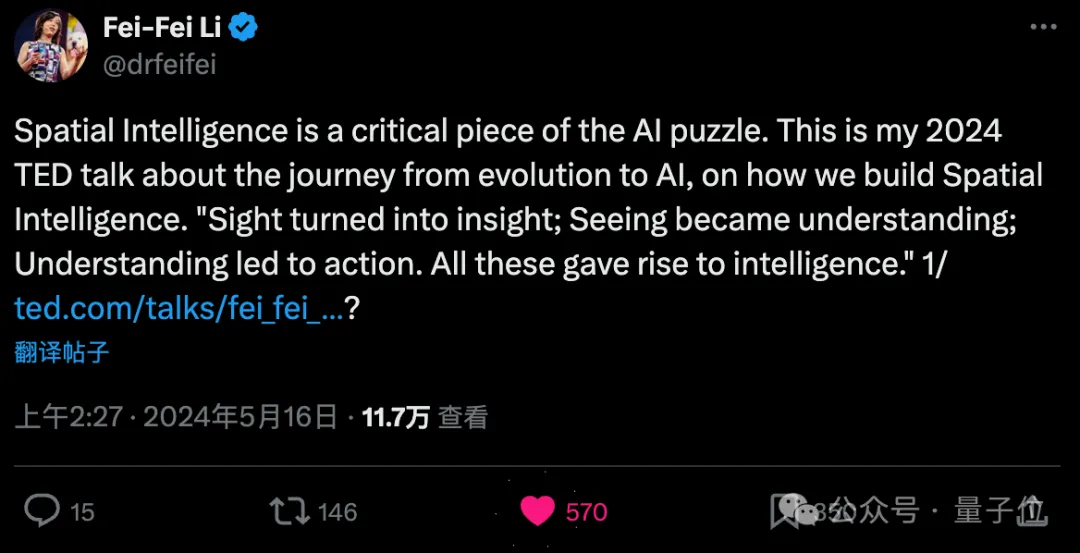
斯坦福李飞飞创业后,首次揭秘新概念“空间智能”。这不仅是她的创业方向,也是指引她的“北极星”,被她认为是“解决人工智能难题的关键拼图”。视觉化为洞察;看见成为理解;理解导致行动。在李飞飞15分钟TED演讲完整公开的基础上,从数亿年前生命进化的起源开始,到人类如何不满足于自然赋予而发展人工智能,直到下一步如何构建空间智能。9年前,李飞飞在同一个舞台上,向世界介绍了刚诞生不久的ImageNet——这一轮深度学习爆发的起点之一。她本人也向网友自我安利:如果把两个视频都看了,你就能对过去10年的计算机视觉、空间智





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



