

在Scrapy爬虫中使用Selenium和PhantomJS
在Scrapy爬虫中使用Selenium和PhantomJSScrapy是Python下的一个优秀的网络爬虫框架,已经被广泛应用于各个领域中的数据采集和处理。在爬虫的实现中,有时候需要模拟浏览器操作去获取某些网站呈现的内容,这时候就需要用到Selenium和PhantomJS。Selenium是模拟人类对浏览器的操作,让我们可以自动化地进行Web应用程序测试
在Scrapy爬虫中使用Selenium和PhantomJS
Scrapy是Python下的一个优秀的网络爬虫框架,已经被广泛应用于各个领域中的数据采集和处理。在爬虫的实现中,有时候需要模拟浏览器操作去获取某些网站呈现的内容,这时候就需要用到Selenium和PhantomJS。
Selenium是模拟人类对浏览器的操作,让我们可以自动化地进行Web应用程序测试,并模拟普通用户访问网站。而PhantomJS是一个基于WebKit的无头浏览器,可以用脚本语言来控制浏览器的行为,支持多种Web开发需要的功能,包括页面截屏、页面自动化、网络监测等等。
下面我们详细介绍如何在Scrapy中结合Selenium和PhantomJS来实现浏览器自动化操作。
首先,在爬虫文件的开始引入必要的模块:
from selenium import webdriver
from scrapy.http import HtmlResponse
from scrapy.utils.project import get_project_settings
然后在Spider的start_requests方法中,我们通过PhantomJS创建一个WebDriver对象,并设置一些浏览器选项:
class MySpider(Spider):
    name = 'example.com'
    start_urls = ['http://www.example.com']

    def __init__(self):
        settings = get_project_settings()
        self.driver = webdriver.PhantomJS(executable_path=settings.get('PHANTOMJS_PATH'))
        super(MySpider, self).__init__()

    def start_requests(self):
        self.driver.get(self.start_urls[0])
        # 进行输入表单、点击等浏览器操作
        # ...

        content = self.driver.page_source.encode('utf-8')
        response = HtmlResponse(url=self.driver.current_url, body=content)
yield response在这里我们设置了PhantomJS的可执行文件路径,并且通过self.driver.get方法访问起始页面。接下来,我们可以在该页面上进行浏览器自动化操作,例如输入表单、点击按钮等等,从而模拟用户操作。如果要获取操作后的页面内容,可以通过self.driver.page_source获取HTML源码,接着通过Scrapy的HtmlResponse生成一个Response对象,并返回给方法调用者。
需要注意的是,在WebDriver对象使用完成后,最好要通过
self.driver.quit()
关闭浏览器进程,释放系统资源。
当然,在使用Selenium和PhantomJS的情况下,需要安装对应的软件包,并且需要配置相关环境变量。在配置的时候,可以使用get_project_settings方法获取Scrapy的默认配置,之后对相应的配置项进行修改即可。
至此,我们就可以在Scrapy中使用Selenium和PhantomJS来实现浏览器自动化操作,从而实现更为复杂、精确的网站数据抓取功能。能灵活地运用这个方法,是一个高效的爬虫工程师必备技能。

解决Selenium启动浏览器时默认不保留缓存的问题,通过配置ChromeOptions或FirefoxProfile实现缓存持久化或加载现有用户数据,提升自动化测试效率。
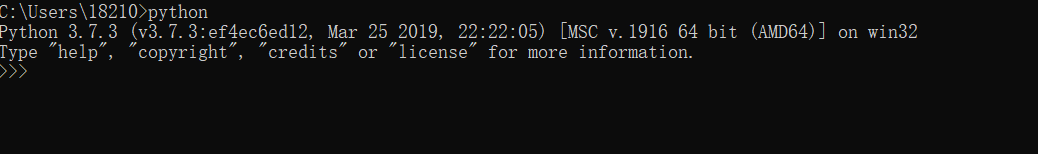
以下为windows下的环境搭建。一、安装Pythonpython官网:https://www.Python.org/安装时勾选AddPython3.7topath复选框自动完成path配置工作。二、安装Setuptools与pipsetuptools是python的distutilsde工具的增强工具,可以让程序员方便地创建和发布python包。当需要安装第三方python包时,可能会用到easy_install。easy_install是由PEA
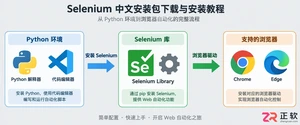
首先安装Selenium库并下载对应浏览器驱动,1.使用pipinstallselenium安装库;2.下载匹配的ChromeDriver、geckodriver或EdgeWebDriver;3.将驱动加入PATH或代码中指定路径;4.通过webdriver.Chrome()等创建实例;5.调用driver.get()打开网页;6.操作完成后执行driver.quit()关闭浏览器释放资源。
Scrapy架构设计的亮点包括:1.基于Twisted的异步机制提升并发效率;2.中间件机制灵活处理Request和Response;3.组件可扩展性强,支持自定义Spider、Pipeline等;4.清晰的组件划分便于理解和维护。

随着互联网的快速发展,大量的网络信息已经成为我们获取知识和开展业务的重要来源。然而,由于大量的信息需要手动获取,这使得我们的效率低下和效果不尽如人意。为了解决这一问题,自动化网络爬虫应运而生,成为了众多开发者的首选。在这篇文章中,我们将介绍如何使用PHP和Selenium来开发一个自动化的网络爬虫。一、什么是Selenium?Selenium是一种自动化测试
JUnit和SeleniumWebDriver的集成可以为Web应用程序测试编写可维护的单元测试。集成步骤包括添加必要的依赖项,设置驱动程序,编写测试方法,验证结果,然后使用mvntest命令运行测试。
如何使用Scrapy抓取JD商家的商品数据Scrapy是一个功能强大的Python网络爬虫框架,它可以让我们简单方便地编写代码,从而抓取网页数据。本文将介绍如何使用Scrapy抓取JD商家的商品数据。准备工作在开始编写代码之前,我们需要进行一些准备工作。1.安装Scrapy我们需要在本地安装Scrapy,如果你还没有安装Scrapy,可以在命令行中输入以下
随着互联网信息的爆炸性增长,如何高效地获取并处理这些信息逐渐成为了许多企业和个人的迫切需求。在这个背景下,爬虫技术引起了越来越多人的关注和使用。而在众多的爬虫工具中,PHP和Selenium的组合可以说是一种相对成熟而实用的方案。本文将从以下几个方面来详细介绍用PHP和Selenium实现自动化爬虫的方式和优势。一、什么是Selenium?Selenium是





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



