

如何用Python for NLP提取并分析多个PDF文件中的文本?
如何用PythonforNLP提取并分析多个PDF文件中的文本?摘要:随着大数据时代的来临,自然语言处理(NLP)成为了解决海量文本数据的重要手段之一。而PDF作为一种常见的文档格式,包含了丰富的文字信息,因此如何提取和分析PDF文件中的文本成为了NLP领域的一项关键任务。本文将介绍如何使用Python编程语言和相关的NLP库来提取和分析多个PDF文件中
如何用Python for NLP提取并分析多个PDF文件中的文本?
摘要:
随着大数据时代的来临,自然语言处理(NLP)成为了解决海量文本数据的重要手段之一。而PDF作为一种常见的文档格式,包含了丰富的文字信息,因此如何提取和分析PDF文件中的文本成为了NLP领域的一项关键任务。本文将介绍如何使用Python编程语言和相关的NLP库来提取和分析多个PDF文件中的文本,同时给出具体的代码示例。
- 准备工作
在开始之前,我们需要确保已经安装了Python和以下必要的库:PyPDF2、nltk、pandas。可以使用pip命令来安装这些库:
pip install PyPDF2
pip install nltk
pip install pandas
- PDF文本提取
Python提供了许多库来处理PDF文件,其中PyPDF2是一个功能强大的库,可以用来从PDF中提取文本。下面是一个简单的示例代码,用于提取单个PDF文件中的文本:
import PyPDF2

def extract_text_from_pdf(file_path):
    with open(file_path, 'rb') as file:
        pdf_reader = PyPDF2.PdfFileReader(file)
        text = ""
        for page_num in range(pdf_reader.numPages):
            page = pdf_reader.getPage(page_num)
            text += page.extractText()
        return text

pdf_file_path = "example.pdf"
text = extract_text_from_pdf(pdf_file_path)
print(text)- 批量提取多个PDF文件中的文本
如果我们有多个PDF文件需要处理,可以使用类似的方法批量提取文本。下面是一个示例代码,用于提取文件夹中所有PDF文件的文本,并将结果保存到一个文本文件中:
import os

def extract_text_from_folder(folder_path):
    text_dict = {}
    for file_name in os.listdir(folder_path):
        if file_name.endswith(".pdf"):
            file_path = os.path.join(folder_path, file_name)
            text = extract_text_from_pdf(file_path)
            text_dict[file_name] = text
    return text_dict

pdf_folder_path = "pdf_folder"
text_dict = extract_text_from_folder(pdf_folder_path)

output_file_path = "output.txt"
with open(output_file_path, 'w', encoding='utf-8') as file:
    for file_name, text in text_dict.items():
        file.write(file_name + "
")
        file.write(text + "
")- 文本预处理和分析
一旦我们提取了PDF文件中的文本,我们可以进行文本预处理和分析。下面是一个示例代码,用于对提取的文本进行分词并计算词频:
import nltk
import pandas as pd
from nltk.tokenize import word_tokenize

nltk.download('punkt')

def preprocess_text(text):
    tokens = word_tokenize(text)  # 分词
    tokens = [token.lower() for token in tokens if token.isalpha()]  # 去除标点符号和数字,转换为小写
    return tokens

# 对提取的文本进行预处理和分析
all_tokens = []
for text in text_dict.values():
    tokens = preprocess_text(text)
    all_tokens.extend(tokens)

# 计算词频
word_freq = nltk.FreqDist(all_tokens)
df = pd.DataFrame.from_dict(word_freq, orient='index', columns=['Frequency'])
df.sort_values(by='Frequency', ascending=False, inplace=True)
print(df.head(10))
总结:
通过使用Python编程语言和相关的NLP库,我们可以方便地提取并分析多个PDF文件中的文本。以上给出了具体的代码示例,希望对读者有所帮助。读者可以根据实际需求进行进一步的文本处理和分析,例如词性标注、情感分析等。
UC浏览器支持将网页保存为PDF,可通过三种方式实现:一、使用内置打印功能,点击菜单→打印→选择“保存为PDF”→打印并保存;二、通过分享功能调用WPS或Adobe等第三方应用导出为PDF;三、利用收藏与离线保存功能将网页缓存后,结合截图工具拼接成PDF。操作适用于小米14Android14环境。
阅读PDF文件需要合适的阅读器,基础方法是安装如AdobeAcrobatReader、SumatraPDF或FoxitReader等软件,也可使用浏览器在线阅读;若需标注或编辑,应选择支持相关功能的专业软件;遇到乱码可调整字体或重新生成PDF;压缩PDF可通过在线工具、专业软件或虚拟打印机实现;转换为Word可借助在线工具、专业软件或Word自带功能。
首先检查Safari设置中是否启用自动打开安全附件并确保PDF在浏览器中打开,接着清除浏览数据、更新系统、重启Safari进程,尝试将PDF保存至文件App查看,最后重置网络设置以解决加载失败问题。
首先启用火狐内置PDF查看器并重置相关设置,接着清除站点权限与缓存数据,然后禁用硬件加速以排除图形渲染问题,再更新或重装浏览器确保版本最新,最后通过about:config手动开启pdfjs功能。
文本摘要可通过Python实现,主要方法包括:1.使用现成库如Sumy和PyTextRank进行抽取式摘要;2.结合jieba分词与TextRank算法处理中文文本;3.利用HuggingFaceTransformers实现生成式摘要。Sumy支持多种算法,适合通用场景,PyTextRank更适合英文但也可用于中文预处理后的内容。中文需先分词再构建共现图并计算句子重要性,或使用Gensim的summarize方法。深度学习方法推荐Transformers库中的BART、T5等模型,可理解原文并生成摘要,其
TCPDF是一个功能强大的PHP开源库,适合用于生成发票、报告等PDF文件。1.通过Composer安装并引入TCPDF;2.实例化类并添加页面、设置字体、写入内容、输出文档;3.添加中文字体支持需使用addFont()方法并正确设置路径;4.支持插入图片、用HTML表格格式绘制表格;5.继承TCPDF类重写Header和Footer方法可设置页眉页脚。掌握这些核心步骤能帮助你高效实现PDF生成与样式控制。
本文早在揭开语言模型的神秘面纱,阐明其处理原始文本数据的基本概念和机制。它涵盖了几种类型的语言模型和大型语言模型,重点关注基于神经网络的模型。语言模型定义语言模型专注于生成类似人类类的文本的能力。通用语言模型本质上是单词序列的统计模型或概率分布,用于解释单词在每个序列中出现的可能性。这有助于根据句子中的前一个单词预测下一个单词或单词。简化的概率语言模型可用于机器翻译、自动纠错、语音识别和自动完成等各种应用,为用户填写以下单词或建议可能的单词序列。该类型模型已经发展成为更先进的模型,包括变换器模型,通过考虑

如何通过Python进行网络流量监控与入侵检测网络安全在当今信息时代是一项重要的任务。对于企业和个人而言,及时发现并应对网络入侵是至关重要的。而网络流量监控与入侵检测是一种常见且有效的安全防御手段。本文将介绍如何利用Python编程语言来实现网络流量监控与入侵检测。一、网络流量监控的基本概念网络流量监控是指对网络中的数据流进行实时监测和记录的过程。通过监控网
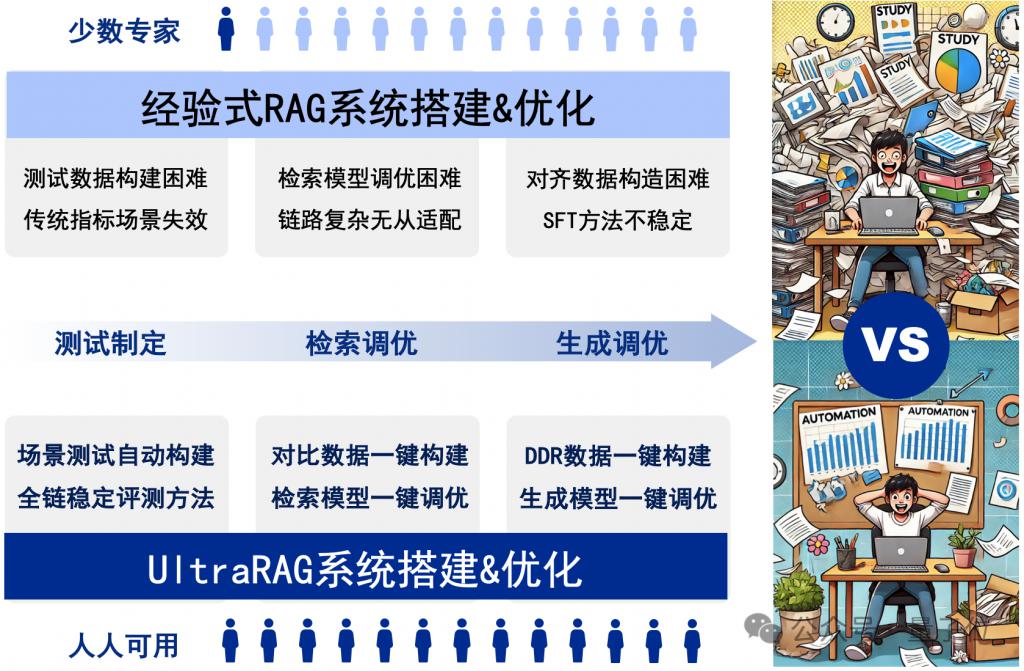
清华大学THUNLP团队联合多家机构推出UltraRAG框架,简化RAG系统搭建流程。传统RAG系统搭建复杂,UltraRAG框架提供“单反相机”级精细化配置和“卡片机”级一键式操作,显著降低学习成本和开发周期。UltraRAG框架的核心优势在于其对模型与知识库的适配,避免了反复的模型选型。其模块化设计也方便科研人员快速迭代。用户可轻松完成数据到模型的全流程管理。零代码WebUI,一键式数据构建UltraRAG的零代码WebUI是其一大亮点,即使没有编程经验的用户也能轻松构建、训练和评估模型。框架





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



