

如何使用Java开发一个基于HBase的实时大数据处理应用
如何使用Java开发一个基于HBase的实时大数据处理应用HBase是一个开源的分布式列式数据库,是ApacheHadoop项目的一部分。它被设计用来处理海量数据,并提供实时读写能力。本文将介绍如何使用Java开发一个基于HBase的实时大数据处理应用,并提供具体的代码示例。一、环境准备在开始之前,我们需要准备以下环境:ApacheHadoop集群:确保
如何使用Java开发一个基于HBase的实时大数据处理应用
HBase是一个开源的分布式列式数据库,是Apache Hadoop项目的一部分。它被设计用来处理海量数据,并提供实时读写能力。本文将介绍如何使用Java开发一个基于HBase的实时大数据处理应用,并提供具体的代码示例。
一、环境准备
在开始之前,我们需要准备以下环境:
- Apache Hadoop集群:确保Hadoop集群已经安装和配置正确。
- Apache HBase集群:确认HBase集群已经安装和配置正确。
- Java开发环境:确保你已经安装并配置了Java开发环境。
二、创建HBase表
在使用HBase之前,我们需要创建一个HBase表来存储数据。可以使用HBase Shell或HBase Java API来创建表。以下是使用HBase Java API创建表的代码示例:
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.hbase.HBaseConfiguration;
import org.apache.hadoop.hbase.HColumnDescriptor;
import org.apache.hadoop.hbase.HTableDescriptor;
import org.apache.hadoop.hbase.client.Admin;
import org.apache.hadoop.hbase.client.Connection;
import org.apache.hadoop.hbase.client.ConnectionFactory;
import org.apache.hadoop.hbase.util.Bytes;

public class HBaseTableCreator {
    public static void main(String[] args) throws Exception {
        Configuration config = HBaseConfiguration.create();
        Connection connection = ConnectionFactory.createConnection(config);
        Admin admin = connection.getAdmin();

        HTableDescriptor tableDescriptor = new HTableDescriptor("my_table");

        HColumnDescriptor columnFamily = new HColumnDescriptor(Bytes.toBytes("cf1"));
        tableDescriptor.addFamily(columnFamily);

        admin.createTable(tableDescriptor);

        admin.close();
        connection.close();
    }
}
以上代码中,我们使用HBase Java API创建了一个名为my_table的表,并添加了一个名为cf1的列族。
三、写入数据到HBase表
当HBase表创建完成后,我们可以使用HBase Java API向表中写入数据。以下是一个向HBase表写入数据的代码示例:
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.hbase.HBaseConfiguration;
import org.apache.hadoop.hbase.client.Connection;
import org.apache.hadoop.hbase.client.ConnectionFactory;
import org.apache.hadoop.hbase.client.Put;
import org.apache.hadoop.hbase.client.Table;
import org.apache.hadoop.hbase.util.Bytes;

public class HBaseDataWriter {
    public static void main(String[] args) throws Exception {
        Configuration config = HBaseConfiguration.create();
        Connection connection = ConnectionFactory.createConnection(config);
        Table table = connection.getTable(TableName.valueOf("my_table"));

        Put put = new Put(Bytes.toBytes("row1"));
        put.addColumn(Bytes.toBytes("cf1"), Bytes.toBytes("col1"), Bytes.toBytes("value1"));
        table.put(put);

        table.close();
        connection.close();
    }
}
以上代码中,我们使用HBase Java API向名为my_table的表中插入了一行数据。
四、从HBase表中读取数据
在HBase表中读取数据也是非常简单的。以下是一个从HBase表中读取数据的代码示例:
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.hbase.HBaseConfiguration;
import org.apache.hadoop.hbase.client.*;
import org.apache.hadoop.hbase.util.Bytes;

public class HBaseDataReader {
    public static void main(String[] args) throws Exception {
        Configuration config = HBaseConfiguration.create();
        Connection connection = ConnectionFactory.createConnection(config);
        Table table = connection.getTable(TableName.valueOf("my_table"));

        Get get = new Get(Bytes.toBytes("row1"));
        Result result = table.get(get);
        byte[] value = result.getValue(Bytes.toBytes("cf1"), Bytes.toBytes("col1"));
        String strValue = Bytes.toString(value);
        System.out.println("Value: " + strValue);

        table.close();
        connection.close();
    }
}
以上代码中,我们使用HBase Java API从名为my_table的表中读取了一行数据,并打印出了数据的值。
五、批量写入和批量读取数据
在实际的大数据处理应用中,我们通常需要批量写入和批量读取数据。以下是一个批量写入和批量读取数据的代码示例:
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.hbase.HBaseConfiguration;
import org.apache.hadoop.hbase.client.*;
import org.apache.hadoop.hbase.util.Bytes;

import java.util.ArrayList;
import java.util.List;

public class HBaseBatchDataHandler {
    public static void main(String[] args) throws Exception {
        Configuration config = HBaseConfiguration.create();
        Connection connection = ConnectionFactory.createConnection(config);
        Table table = connection.getTable(TableName.valueOf("my_table"));

        List puts = new ArrayList<>();

        Put put1 = new Put(Bytes.toBytes("row1"));
        put1.addColumn(Bytes.toBytes("cf1"), Bytes.toBytes("col1"), Bytes.toBytes("value1"));
        puts.add(put1);

        Put put2 = new Put(Bytes.toBytes("row2"));
        put2.addColumn(Bytes.toBytes("cf1"), Bytes.toBytes("col1"), Bytes.toBytes("value2"));
        puts.add(put2);

        table.put(puts);

        List gets = new ArrayList<>();

        Get get1 = new Get(Bytes.toBytes("row1"));
        gets.add(get1);

        Get get2 = new Get(Bytes.toBytes("row2"));
        gets.add(get2);

        Result[] results = table.get(gets);
        for (Result result : results) {
            byte[] value = result.getValue(Bytes.toBytes("cf1"), Bytes.toBytes("col1"));
            String strValue = Bytes.toString(value);
            System.out.println("Value: " + strValue);
        }

        table.close();
        connection.close();
    }
}
以上代码中,我们使用HBase Java API批量写入了两行数据,并批量读取了这两行数据。
总结
本文介绍了如何使用Java开发一个基于HBase的实时大数据处理应用,并提供了代码示例。通过这些示例代码,你可以使用HBase Java API创建表、写入数据、读取数据,并且了解了如何进行批量写入和批量读取操作。希望本文对你开始使用HBase进行大数据处理能够有所帮助。
Yandex官网入口是https://www.yondex.net/,该平台支持多语言切换、智能搜索匹配、虚拟键盘变更及实时翻译,提供地图、图片、新闻、购物等垂直服务,并具备账户同步、隐私管理、个性化首页和云存储等功能。
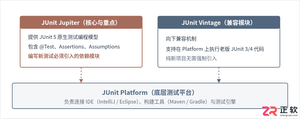
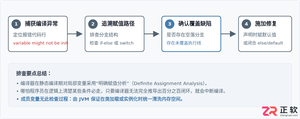
深入解析Java中局部变量未初始化编译报错与成员变量自动赋予默认值的机制差异,涵盖JVM内存分配、编译期确定性赋值检查与实际排查修复方案。
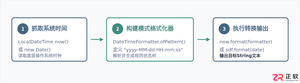
详细讲解在Java中获取当前系统时间并进行格式化输出的两种核心方案:基于Java 8全新日期时间API的DateTimeFormatter与传统遗留的SimpleDateFormat,包含完整代码示例、线程安全机制对比及生产选型建议。
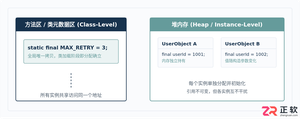
深入解析Java中final变量与static final常量的定义、内存语义、初始化时机及合法赋值路径,涵盖编译期常量优化与实战避坑指南。
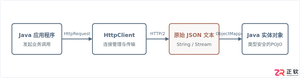
本文提供Java标准库HttpClient发起HTTP GET/POST请求并结合Jackson进行JSON数据反序列化与序列化的完整代码示例与工程实践指南。
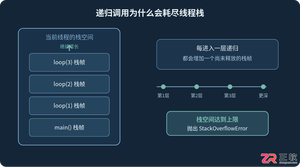
详细分析Java递归调用出现StackOverflowError的原因,结合代码说明线程栈、栈帧和递归深度之间的关系,并介绍终止条件排查、迭代改写、减少栈帧开销以及通过-Xss调整JVM栈空间的方法。
针对Java中常见的NullPointerException(NPE),本文从堆栈日志定位、典型代码触发场景、具体修复代码对比到防御体系进行系统讲解,提供实用且易上手的排查与修复方案。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



