

多模态版Llama2上线,Meta发布AnyMAL
在多个基准测试中均刷新了业界最好的zero-shot性能。一个统一的模型,可以对不同模态输入内容(文本、图像、视频、音频、IMU运动传感器数据)实现理解,并生成文本响应,技术基于Llama2,来自Meta。昨天,多模态大模型AnyMAL的研究吸引了AI研究社区的关注。大型语言模型(LLM)以其巨大的规模和复杂性而闻名,它极大地增强了机器理解和表达人类语言的能力。LLM的进步使视觉语言领域有了显著进步,弥合了图像编码器和LLM之间的差距,将它们的推理能力结合起来。先前的多模态LLM研究集中在结合文本和另一种
在多个基准测试中均刷新了业界最好的 zero-shot 性能。
一个统一的模型,可以对不同模态输入内容(文本、图像、视频、音频、IMU 运动传感器数据)实现理解,并生成文本响应,技术基于 Llama 2,来自 Meta。
昨天,多模态大模型 AnyMAL 的研究吸引了 AI 研究社区的关注。
大型语言模型(LLM)以其巨大的规模和复杂性而闻名,它极大地增强了机器理解和表达人类语言的能力。LLM 的进步使视觉语言领域有了显著进步,弥合了图像编码器和 LLM 之间的差距,将它们的推理能力结合起来。先前的多模态 LLM 研究集中在结合文本和另一种模态的模型上,如文本和图像模型,或者集中在非开源的专有语言模型上。
如果有一种更好的方法能够实现多模态功能,将各种模态能够嵌入在LLM中使用,这会给我们带来不同的体验吗?
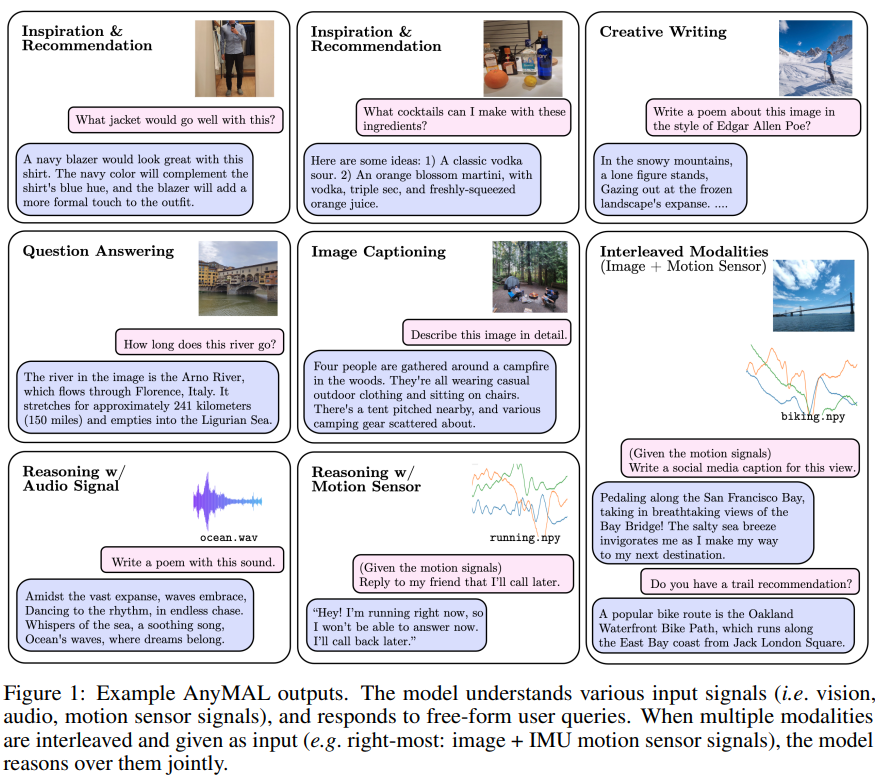
输出示例
为了解决这个问题,来自Meta的研究人员最近推出了AnyMAL(Any-Modality Augmented Language Model)。这是一个经过训练的多模态编码器集合,可以将来自各种模态(包括图像、视频、音频和IMU运动传感器数据)的数据转换为LLM的文本嵌入空间
论文地址:https://huggingface.co/papers/2309.16058
根据说明,该研究的主要贡献如下所示:
为构建多模态 LLM 提出了一种高效、可扩展的解决方案。本文提供了在大型数据集上预先训练的投影层,这些数据集包含多种模态(例如,2 亿张图像、220 万段音频、50 万 IMU 时间序列、2800 万段视频),所有数据集都与同一个大模型(LLaMA-2- 70B-chat)对齐,从而实现了交错式多模态上下文提示。
本研究使用跨三种模式(图像、视频和音频)的多模态指令集对模型进行了进一步微调,涵盖了简单问答(QA)领域以外的各种不受限制的任务。该数据集包含高质量的人工收集指令数据,因此本研究将其作为复杂多模态推理任务的基准
本文最佳模型在各种任务和模式的自动和人工评估中取得了很好的零误差性能,相较于现有文献中的模型,在 VQAv2 上的相对准确率提高了7.0%,在零误差 COCO 图像字幕上提高了8.4% 的 CIDEr,在 AudioCaps 上提高了14.5% 的 CIDEr,创造了新的 SOTA
方法
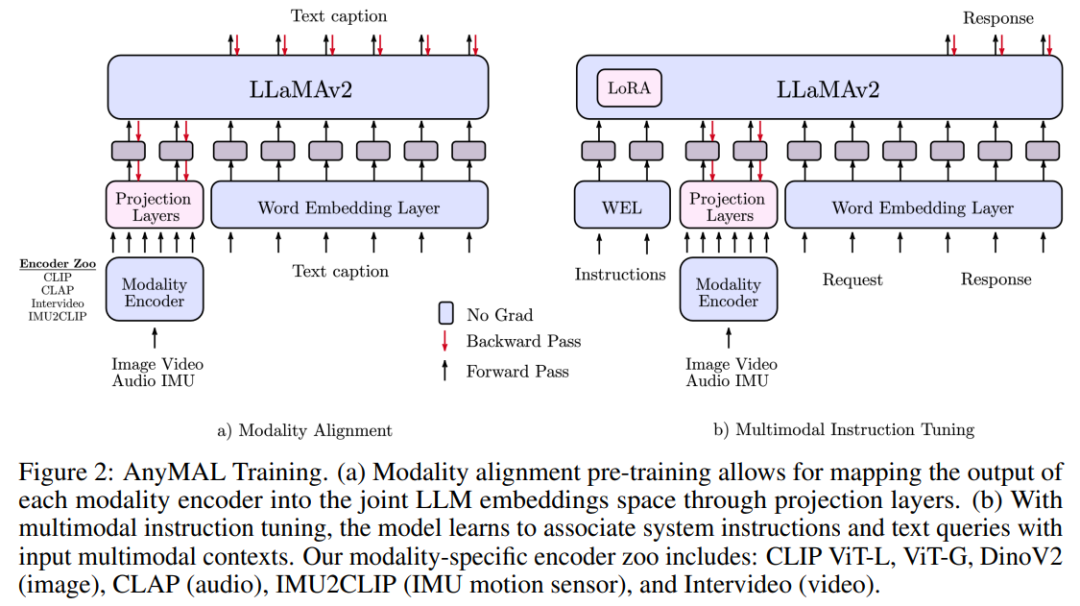 方法概览
预训练模态对齐的内容需要进行改写
通过使用配对的多模态数据(包括特定的模态信号和文本叙述),本研究对LLM进行了预训练,以实现多模态理解能力,如图2所示。具体而言,我们为每个模态训练了一个轻量级适配器,将输入信号投射到特定LLM的文本标记嵌入空间中。这样,LLM的文本标记嵌入空间就变成了一个联合的标记嵌入空间,其中标记可以代表文本或其他模态
关于图像对齐的研究,我们使用了LAION-2B数据集的一个干净子集,并采用了CAT方法进行过滤,对任何可检测到的人脸进行了模糊处理。而对于音频对齐的研究,则使用了AudioSet(2.1M)、AudioCaps(46K)和CLOTHO(5K)数据集。此外,我们还使用了Ego4D数据集进行IMU和文本的对齐(528K)
对于大型数据集,要将预训练扩展到70B参数模型需要大量资源,通常需要使用FSDP封装器在多个GPU上对模型进行分片。为了有效地扩展训练规模,本文在多模态设置中实施了量化策略(4位和8位),其中冻结了模型的LLM部分,只有模态tokenizer是可训练的。这种方法将内存需求缩小了一个数量级。因此,70B AnyMAL能够在单个80GB VRAM GPU上就完成训练,batch size为4。与FSDP相比,本文提出的量化方法只使用了GPU资源的一半,却实现了相同的吞吐量
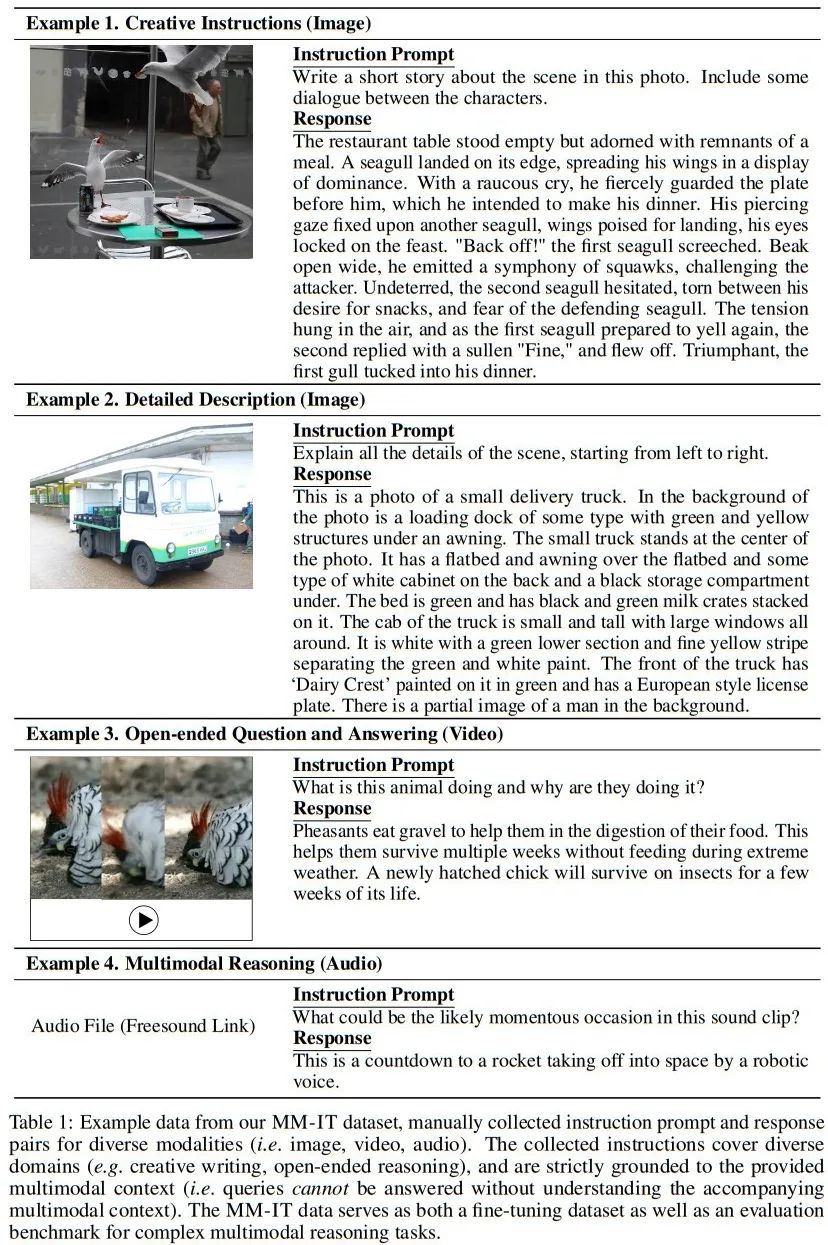
利用多模态指令数据集进行微调的意思是使用多种模态的指令数据集来进行微调
为了进一步提高模型对不同输入模态的指令跟随能力,研究利用多模态指令调整(MM-IT)数据集进行了额外的微调。具体来说,我们将输入连接为 [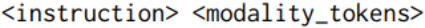 ],这样响应目标就同时以文本指令和模态输入为基础。研究对以下两种情况进行消减:(1)在不改变 LLM 参数的情况下训练投影层;或(2)使用低级适应(Low-Rank Adaptation)进一步调整 LM 行为。研究同时使用人工收集的指令调整数据集和合成数据。
实验及结果
图像标题生成是一种人工智能技术,用于自动为图像生成相应的标题。这项技术结合了计算机视觉和自然语言处理的方法,通过分析图像的内容和特征,以及对语义和语法的理解,生成与图像相关的描述性标题。图像标题生成在许多领域有广泛的应用,包括图像搜索、图像标注、图像检索等。通过自动化生成标题,可以提高图像的可理解性和搜索引擎的准确性,为用户提供更好的图像检索和浏览体验
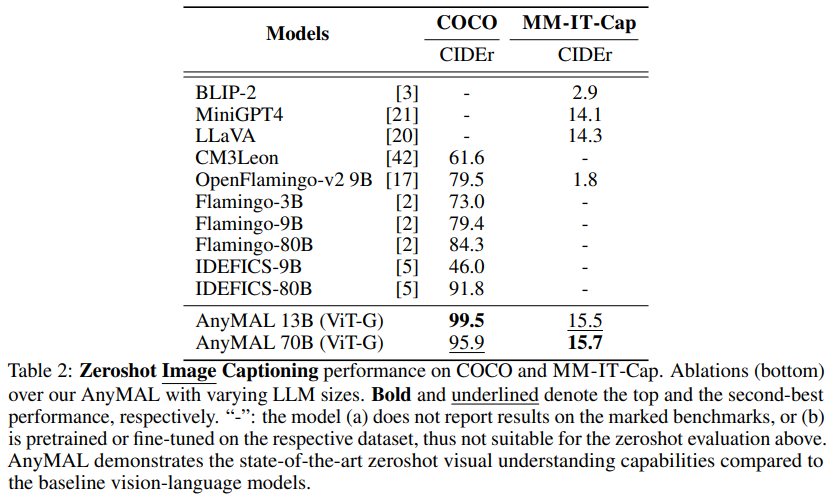
表 2 显示了在 COCO 和标有「详细描述」 任务(MM-IT-Cap)的 MM-IT 数据集子集上的零样本图像字幕生成性能。可以看出, AnyMAL 变体在这两个数据集上的表现都明显优于基线。值得注意的是,AnyMAL-13B 和 AnyMAL-70B 变体的性能没有明显差距。这一结果表明,底层 LLM 能力对图像标题生成是一种人工智能技术,用于自动为图像生成相应的标题。这项技术结合了计算机视觉和自然语言处理的方法,通过分析图像的内容和特征,以及对语义和语法的理解,生成与图像相关的描述性标题。图像标题生成在许多领域有广泛的应用,包括图像搜索、图像标注、图像检索等。通过自动化生成标题,可以提高图像的可理解性和搜索引擎的准确性,为用户提供更好的图像检索和浏览体验任务的影响较小,但在很大程度上取决于数据规模和配准方法。
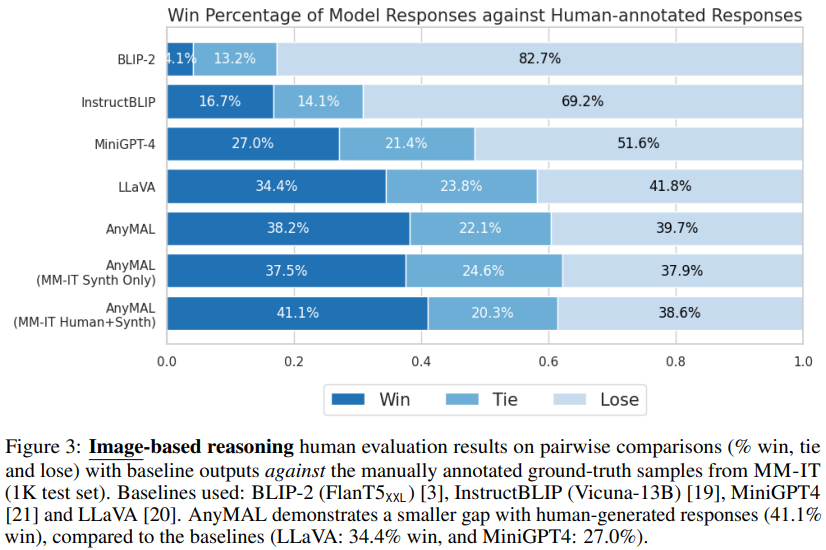
需要进行的重写是:对多模态推理任务进行人工评估
图 3 显示,与基线(LLaVA:34.4% 的胜率和 MiniGPT4:27.0% 的胜率)相比,AnyMAL 性能强劲,与人工标注的实际样本的差距较小(41.1% 的胜率)。值得注意的是,使用完整指令集微调的模型表现出最高的优先胜率,显示出与人类标注的响应相当的视觉理解和推理能力。还值得注意的是,BLIP-2 和 InstructBLIP 在这些开放式查询中表现不佳(分别为 4.1% 和 16.7% 的优先胜出率),尽管它们在公开的 VQA 基准测试中表现出色(见表 4)。
VQA 基准
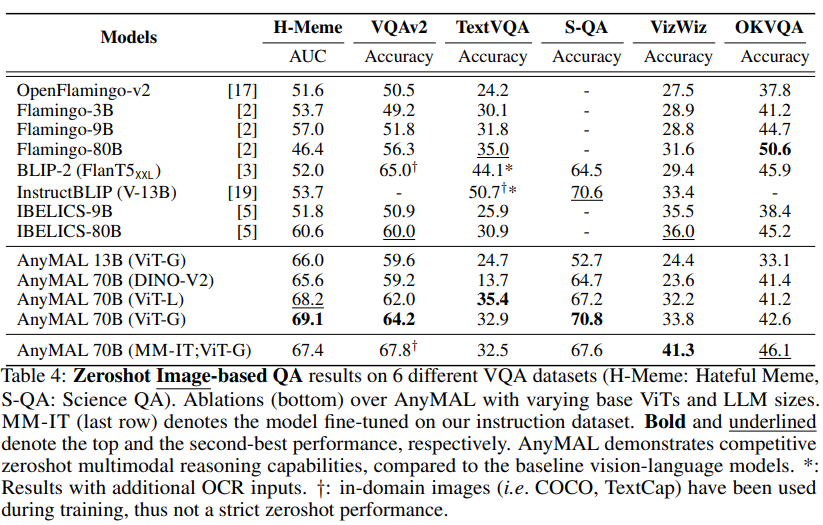
在表4中,我们展示了在Hateful Meme数据集、VQAv2、TextVQA、ScienceQA、VizWiz和OKVQA上的零样本性能,并与文献中报告的各自基准上的零样本结果进行了比较。我们的研究重点放在零样本评估上,以便在推理时最准确地估计模型在开放式查询上的性能
视频 QA 基准
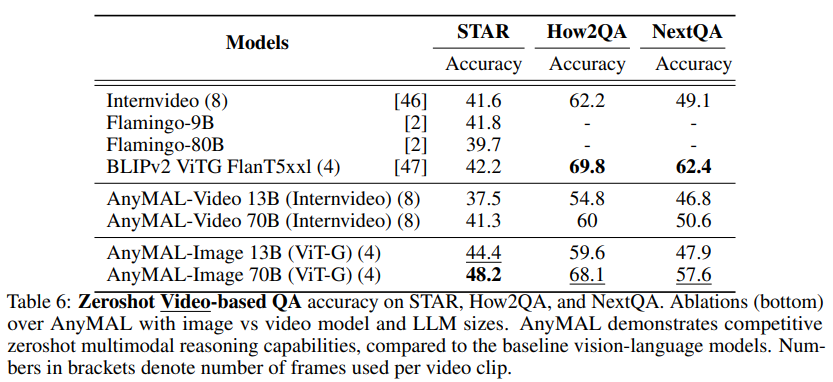
如表 6 所示,研究在三个具有挑战性的视频 QA 基准上对模型进行了评估。
重新生成音频字幕
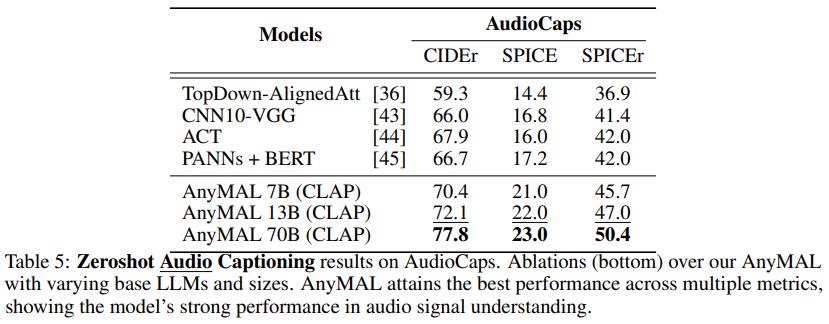
表 5 显示了 AudioCaps 基准数据集上的重新生成音频字幕结果。AnyMAL 的表现明显优于文献中其他最先进的音频字幕模型(例如,CIDEr +10.9pp,SPICE +5.8pp),这表明所提出的方法不仅适用于视觉,还适用于各种模态。与 7B 和 13B 变体相比,文本 70B 模型表现出了明显的优势。
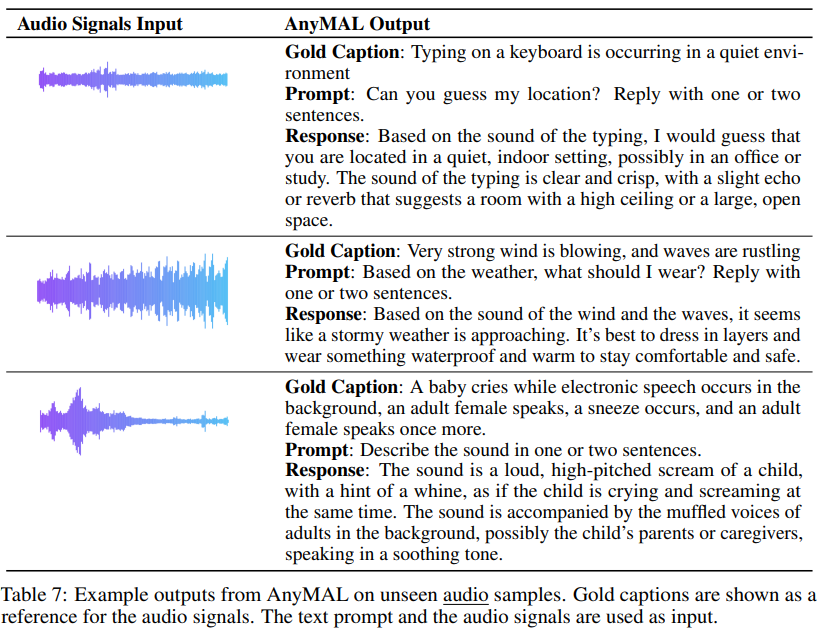
有趣的是,根据从AnyMAL论文提交的方式、类型和时间推测,Meta似乎计划通过其新推出的混合现实/元宇宙头显来收集多模态数据。这些研究成果可能会被整合到Meta的元宇宙产品线中,或者很快应用于消费级应用中
更多详细内容请阅读原文。
Meta多轮裁员致员工士气降至冰点,上月裁员约8000人。幸存员工被迫承担AI训练杂活,对CEO扎克伯格提出的黑客松活动反应冷淡。扎克伯格承诺今年不再裁员,但承认可能犯更多错误。
Meta首席技术官承认员工士气跌至历史最低点,源于AI转型中裁员8000人及强制调派员工从事枯燥数据标注。管理层致歉并推出涨零食预算、限制管理幅度等福利,但外界对效果持保留态度。
Meta新AI团队MSL成立不到半年,已完成首批核心模型内部交付并进入测试阶段,涵盖文本与图像处理能力。工程化落地仍是难点,公司已重组架构、引进人才并集中资源,计划2026至2027年推出搭载自主AI的终端产品,包括Ray-BanDisplay智能眼镜,目前暂停海外铺货以保障美国订单。
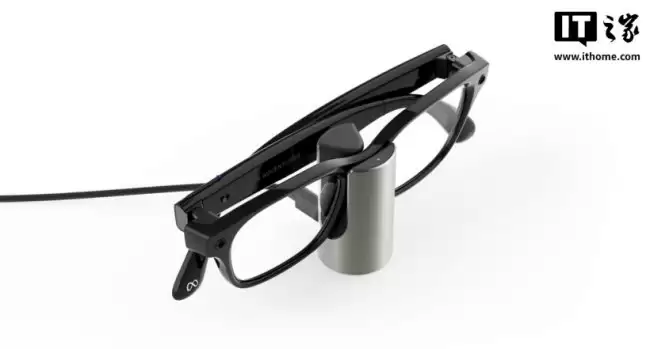
Meta推出一款60美元不锈钢充电底座,专为雷朋联名款及OakleyMetaHSTN智能眼镜设计,但不支持雷朋Display。底座重108克,支持20分钟充至50%、一小时充满,采用USB-C接口但需自备充电线,主打随手一放的便捷体验。
Meta收回强制工程师加入AI团队的指令,承认重组存在失误。此前调动7000名员工,现改为尊重个人选择,并给予调岗优先安置权。员工曾抱怨工作类似数据标注,士气跌至近二十年最低。
豆包大模型2.1Pro正式发布,多项基准测试接近GPT-5.5等水平,日均Tokens调用量达180万亿。Meta推出299美元智能眼镜新系列。甲骨文上财年裁员约2.1万人,部分岗位被AI取代。高通拟40亿美元收购AI芯片初创公司Modular。
Meta公司近日暂停了一项内部计划,该计划原拟通过追踪员工鼠标移动及数字活动来训练AI模型,但由于存在数据安全漏洞——敏感数据可被所有员工访问,已承认正就此展开调查,但未透露暂停将持续多久。
Meta公司今年五月发布内部指南,严格禁止工程师使用Anthropic的ClaudeCode和OpenAI的Codex等外部AI工具生成编程挑战、分析安全漏洞或测试自家模型,以防模型蒸馏引发法律纠纷与事态升级。
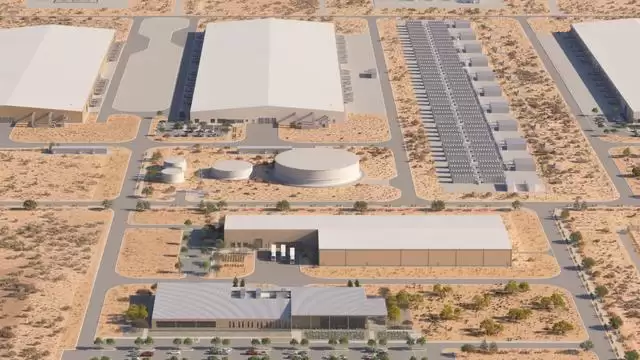
Meta公司自主研发的Vistara定制芯片,利用CXL2.0和PCIeGen5接口,将退役服务器中的DDR4内存接入新一代DDR5服务器,从而延长硬件使用寿命、降低资本支出。这一方案计划部署于超大规模AI数据中心,有效缓解内存资源紧缺与浪费问题。
Meta正用大语言模型替代人工内容审核,已接管约50%的审核请求,每年可节省数十亿美元。计划年底进一步减少人工参与,部分内容的人工审核比例可能削减超90%。同时扎克伯格投入巨资开发个人超级智能技术。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



