

Python数字转文字函数编写教程
答案:将数字转换为英文文字需分块处理千位单位,结合词汇表递归转换,支持整数、负数及浮点数,通过配置可扩展至多语言和货币格式。
答案:将数字转换为英文文字需分块处理千位单位,结合词汇表递归转换,支持整数、负数及浮点数,通过配置可扩展至多语言和货币格式。
将数字转换为文字,核心在于将数字的每一位或每一组(如百、千、百万)映射到对应的英文单词。这通常涉及到构建一系列字典来存储0-9、10-19以及20、30等特殊数字的英文表达,然后通过递归或迭代的方式处理数字的不同量级。这个过程听起来简单,但实际操作起来,尤其是在处理各种语言习惯和边界条件时,会发现不少有趣的小细节。
解决方案
编写一个将数字转换为文字的Python函数,首先要明确,我们需要处理整数、负数,以及可能存在的浮点数。最常见的策略是将数字分解成小于一千的块,然后为这些块加上相应的量级(千、百万、十亿等)。
我通常会先定义一些基础的词汇表,这能让代码逻辑清晰很多:
_units = ["", "one", "two", "three", "four", "five", "six", "seven", "eight", "nine"]
_teens = ["ten", "eleven", "twelve", "thirteen", "fourteen", "fifteen", "sixteen", "seventeen", "eighteen", "nineteen"]
_tens = ["", "", "twenty", "thirty", "forty", "fifty", "sixty", "seventy", "eighty", "ninety"]
_scales = ["", "thousand", "million", "billion", "trillion"] # 理论上可以无限扩展

def _convert_less_than_thousand(num):
    """辅助函数:将小于1000的数字转换为文字"""
    if num == 0:
        return ""

    words = []
    # 处理百位
    if num >= 100:
        words.append(_units[num // 100])
        words.append("hundred")
        num %= 100
        if num > 0: # 如果后面还有数字,加上“and”,这是英式英语的习惯
            words.append("and")

    # 处理十位和个位
    if num >= 20:
        words.append(_tens[num // 10])
        num %= 10
    elif num >= 10:
        words.append(_teens[num - 10])
        num = 0 # 10-19的数字已经完全处理

    if num > 0:
        words.append(_units[num])

    return " ".join(words).strip()

def number_to_words(num):
    """主函数:将任意数字转换为文字"""
    if not isinstance(num, (int, float)):
        raise TypeError("输入必须是数字类型。")

    if num == 0:
        return "zero"

    negative = False
    if num < 0:
        negative = True
        num = abs(num)

    # 处理浮点数部分
    decimal_words = ""
    if isinstance(num, float):
        integer_part = int(num)
        # 将小数部分转换为字符串,逐位处理
        decimal_str_parts = str(num).split('.')
        if len(decimal_str_parts) > 1 and decimal_str_parts[1]:
            decimal_digits = []
            for digit_char in decimal_str_parts[1]:
                decimal_digits.append(_units[int(digit_char)])
            decimal_words = "point " + " ".join(decimal_digits)
        num = integer_part # 继续处理整数部分

    words_parts = []
    scale_idx = 0
    current_num = int(num) # 确保处理的是整数部分

    while current_num > 0:
        chunk = current_num % 1000 # 取最后三位
        if chunk > 0:
            chunk_words = _convert_less_than_thousand(chunk)
            if _scales[scale_idx]: # 如果不是第一个量级(即不是个位到百位),加上量级词
                words_parts.append(f"{chunk_words} {_scales[scale_idx]}")
            else:
                words_parts.append(chunk_words)
        current_num //= 1000 # 移除已处理的千位
        scale_idx += 1

    # 将所有部分反转并拼接,因为我们是从低位到高位处理的
    result = " ".join(reversed(words_parts)).strip()

    # 拼接小数部分
    if decimal_words:
        if result: # 如果整数部分不为空
            result += " " + decimal_words
        else: # 如果只有小数部分(如0.5)
            result = decimal_words

    # 处理负数
    if negative:
        result = "minus " + result

    # 清理可能出现的双空格
    return result.replace("  ", " ").strip()
这个函数的核心思想就是“分而治之”。一个大数字被拆分成一个个小于1000的“块”,每个块独立转换,最后根据其所属的量级(千、百万等)加上对应的词。浮点数的处理则采取了更直接的“point”加数字读法,这在通用场景下比“and X cents”更灵活。
如何处理数字中的“零”和特殊数字组合?
处理“零”和特殊数字组合是数字转文字功能中的一个常见陷阱。最直接的“零”就是当输入为 0 时,直接返回 "zero"。但当“零”出现在数字中间时,情况就复杂一些了。
比如数字 105,在英式英语中通常是 "one hundred and five",而美式英语可能直接说 "one hundred five"。我的函数里采取了英式习惯,在百位之后如果有非零的十位或个位,会加上 "and"。这是通过 if num > 0: words.append("and") 这行代码实现的,它确保了只有在百位后还有实际数值时才加入“and”。如果数字是 100,num % 100 结果是 0,就不会添加 "and",直接返回 "one hundred"。
另一个特殊组合是 10-19。这些数字不遵循“十位+个位”的常规模式,而是有自己独立的词汇(ten, eleven, ..., nineteen)。在 _convert_less_than_thousand 函数中,我专门用 elif num >= 10: 来捕获这个范围,并使用 _teens 字典进行处理,这样就避免了把 13 读成 "one three" 或者 "ten three" 这样的错误。处理完后,将 num 设为 0,避免它再次进入个位处理逻辑。
至于像 1000 这样的数字,我的 number_to_words 函数通过 chunk = current_num % 1000 拿到 0,然后 if chunk > 0 会跳过对 0 的转换,所以 1000 最终会正确地显示为 "one thousand",而不是 "one thousand zero"。这种分块处理的方式,自然地解决了中间零的问题。
编写一个鲁棒的数字转文字函数需要考虑哪些边界条件?
一个鲁棒的数字转文字函数,除了处理常规正整数,还需要考虑很多边界情况。这不仅仅是代码逻辑上的严谨,更是对用户体验的负责。
- 大数字处理:我的
_scales列表目前只到 "trillion"。现实中,数字可能更大,比如 quadrillion, quintillion 等。如果需要支持更大的数字,只需扩展这个列表即可。当然,Python 的整数支持任意精度,但词汇表需要相应扩充。 - 负数:很简单,在开头判断
num < 0,加上 "minus" 前缀,然后将数字转为正数处理。这是一种常见的模式,能有效简化后续逻辑。 - 浮点数:这是个有趣的点。我的实现中,将小数部分拆开,逐个数字读出来,例如
123.45读作 "one hundred twenty-three point four five"。这种读法在技术文档或电话号码中很常见。另一种常见方式是像货币那样读作“和多少多少分”,比如 "one hundred twenty-three dollars and forty-five cents"。选择哪种取决于具体应用场景。我的代码选择了更通用的“point”读法,因为它不依赖于特定的语境。 - 输入校验:函数开始就用
isinstance(num, (int, float))检查输入是否为数字类型。如果传入一个字符串或者其他非数字类型,应该抛出TypeError,而不是让程序崩溃或者产生无法理解的结果。这种显式的错误处理非常重要。 - 语言和地区差异:这是最复杂的一点。例如,前面提到的英式英语和美式英语在“and”的使用上就有差异。德语数字的读法是“个位和十位”(einundzwanzig),与英语完全不同。如果函数需要支持多语言,那么
_units,_teens,_tens,_scales这些字典就不能写死,而应该作为参数或者通过某种配置机制来动态加载。这会将问题上升到国际化(i18n)的层面,需要一套更复杂的结构来管理不同语言的词汇和规则。
除了基础转换,如何扩展函数以支持多语言或货币格式?
将数字转文字的函数扩展到支持多语言或货币格式,确实是一个更高级的挑战,它将我们从单纯的算法逻辑推向了更广阔的软件设计领域。
要支持多语言,最直接的方式是为每种语言维护一套独立的词汇表和一套独立的转换规则。这意味着我们不能简单地将 _units, _teens 等硬编码在函数内部。一个更优雅的设计可能是:
- 配置化词汇表:将所有语言的词汇表存储在外部配置文件(如JSON、YAML)或一个字典的字典中,根据传入的
language_code参数动态加载。 - 规则引擎或策略模式:不同语言的数字组合规则差异很大。例如,有些语言(如法语)在某些数字上使用乘法(quatre-vingts = four-twenties = 80),有些语言(如德语)将个位放在十位之前。这需要一个更灵活的“规则引擎”或者采用策略模式,为每种语言实现一个独立的
_convert_less_than_thousand变体,甚至一个独立的number_to_words变体。 - 国际化库:对于真正的多语言支持,我们通常不会从零开始。Python 生态中有像
num2words这样的库,它们已经处理了大量语言的规则和例外。理解其内部原理很有帮助,但在实际项目中,直接使用成熟的库会更高效和可靠。
至于货币格式,这通常是在数字转文字的基础上增加前缀、后缀和对小数部分的特定处理。例如:
- 货币单位:在转换结果前加上 "dollars" 或 "euros",小数部分则转换为 "cents" 或 "pence"。
- 精度:货币通常精确到两位小数,需要确保小数部分能被正确转换,并且可以处理
0.05这样的情况("five cents")。 - 复数形式:当数量为1时,单位是单数("one dollar"),大于1时是复数("two dollars")。这需要一个简单的条件判断。
比如,我们可以增加一个 currency 参数:
# 伪代码示例,基于现有函数扩展
def number_to_currency_words(num, currency="USD", language="en"):
    # ... (这里可以调用上面 number_to_words 的逻辑)
    # 假设 number_to_words 已经处理了整数和小数

    integer_part_words = number_to_words(int(num), language=language) # 假设支持语言参数

    decimal_part = round((abs(num) - abs(int(num))) * 100) # 取两位小数
    decimal_part_words = ""
    if decimal_part > 0:
        decimal_part_words = number_to_words(decimal_part, language=language)

    if currency == "USD":
        main_unit = "dollar" if abs(num) == 1 else "dollars"
        sub_unit = "cent" if decimal_part == 1 else "cents"

        result = f"{integer_part_words} {main_unit}"
        if decimal_part_words:
            result += f" and {decimal_part_words} {sub_unit}"

        # 负数处理
        if num < 0:
            result = "minus " + result

        return result.strip()
    # ... 其他货币类型
这种扩展思路,就是在核心数字转换能力之上,叠加特定领域的规则。它要求我们对不同货币的表达习惯有所了解,并将其转化为代码逻辑。这其实是一个不断迭代和完善的过程,毕竟语言的细节和习惯远比我们想象的要丰富。
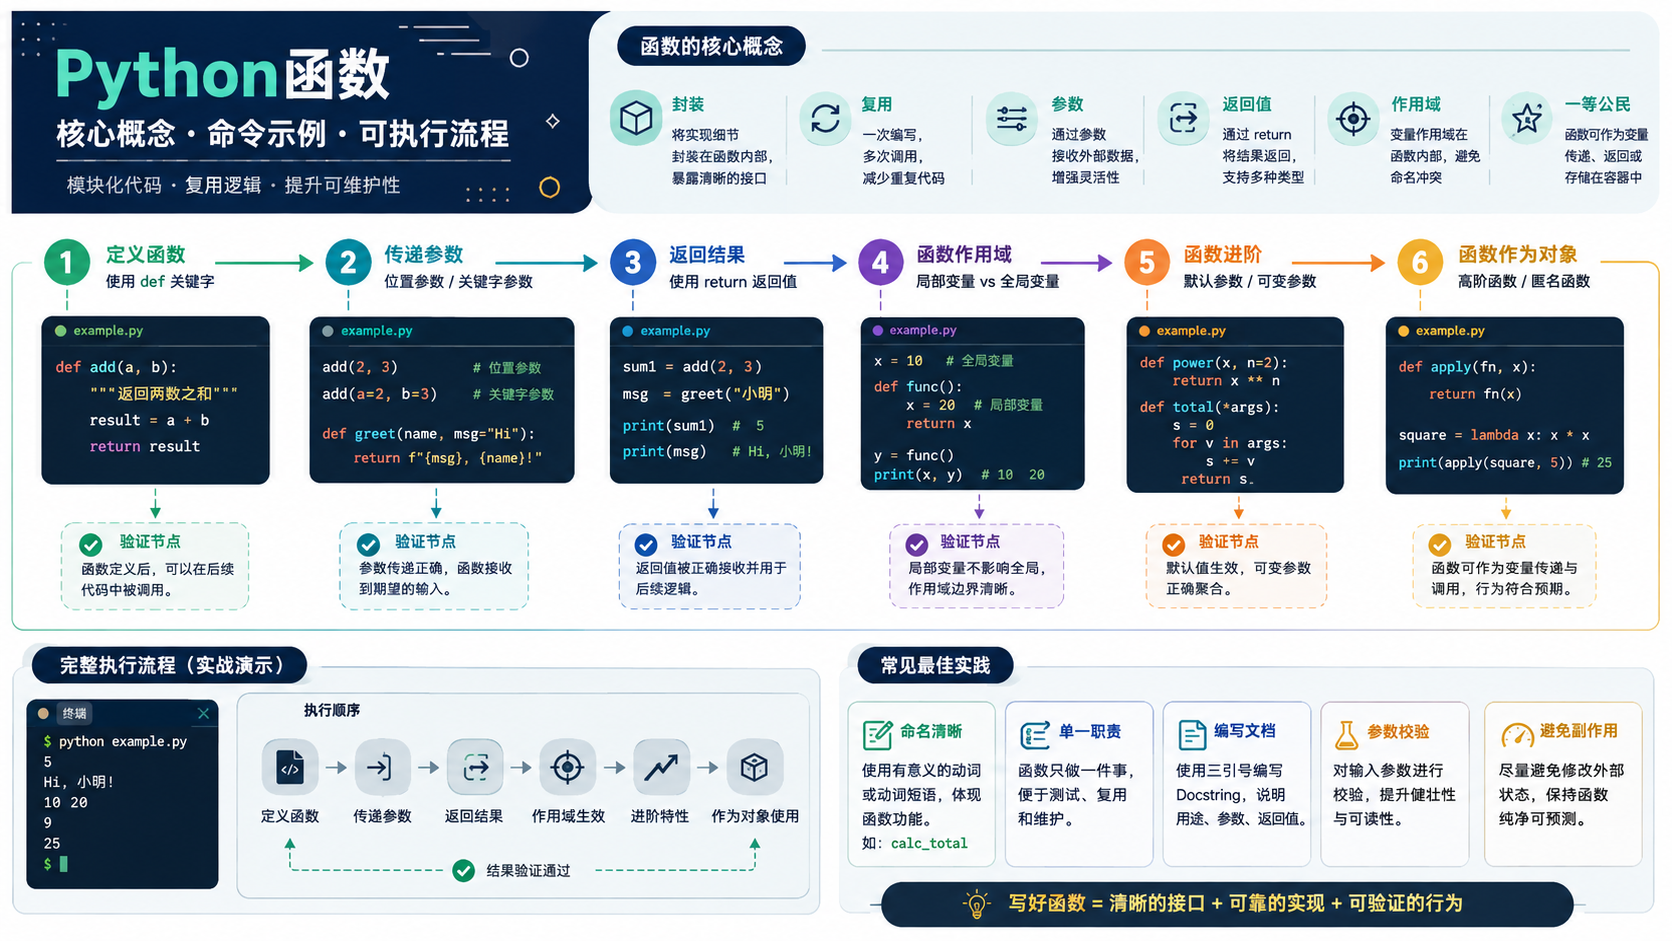
本文详解 python函数 的开发准备与实操流程,涵盖虚拟环境创建、依赖安装及系统验证,附带决策图辅助排错,帮助开发者构建稳定的Python运行环境。
是的,Python函数可以动态添加属性,1.可用于存储元数据、缓存或状态标记;2.操作方式为通过点语法直接赋值;3.常见于装饰器、框架设计中;4.需避免命名冲突、注意可读性与类型检查;5.最佳实践包括使用functools.wraps、明确用途并加强文档化,此机制体现了Python“一切皆对象”的设计哲学且应谨慎合理使用。
Python函数命名冲突的常见场景包括:导入多个模块时同名函数被覆盖、同一作用域内重复定义函数、与内置函数或标准库函数重名、以及大型项目中因缺乏统一规划导致的无意识命名重复。最典型的例子是使用frommoduleimport*或连续导入两个同名函数,后导入的会静默覆盖前者;在同一文件中定义两个同名函数也会导致后者覆盖前者而不报错;将自定义函数命名为len、sum等内置函数名会破坏原有功能;在大型项目中不同模块各自定义同名函数如parse_data,若未通过模块路径区分调用,极易引发逻辑错误。这些问题的核心
Python函数可通过闭包保存内部状态,核心在于嵌套函数引用并捕获外部函数的局部变量,即使外部函数已执行完毕,这些变量仍被保留。闭包需满足三个条件:函数嵌套、内部函数引用外部非全局变量、外部函数返回内部函数。与普通嵌套函数不同,闭包在外部函数结束后仍可访问其作用域中的变量,形成“持久化”状态。典型应用包括装饰器、工厂函数(如生成不同乘法器)、回调函数等,能实现轻量级状态封装。但需注意循环中变量延迟绑定问题(如for循环中i始终为最终值),可通过默认参数或立即调用外层函数解决;同时避免闭包捕获大对象导致内存
是的,Python函数可以通过类型提示指定返回值类型,从而提升代码可读性、可维护性,并支持静态类型检查工具如mypy进行类型验证。1.使用->符号在函数参数列表后标注返回值类型,例如defgreet(name:str)->str:returnf"Hello,{name}!";2.对于无返回值的函数,可标注为->None;3.复杂返回类型可用typing.Union[str,int,None]或Python3.10+的str|int|None表示联合类型;4.生成器函数应使用typing.
使用布尔值时应直接在if语句中判断,避免与True比较;2.采用描述性函数名提升可读性;3.利用any()和all()简化多条件判断;4.使用not增强逻辑清晰度;5.将复杂逻辑拆分为多个小函数并用逻辑运算符合并结果;6.避免嵌套过深,通过提前返回减少层级;7.编写单元测试覆盖各种输入及边界情况;8.使用mock隔离外部依赖确保测试独立性;9.保持测试用例独立且完整,确保布尔函数的可靠性与可维护性。
递归遍历嵌套列表的核心是函数调用自身处理子元素,直至遇到非列表元素并收集结果。代码通过isinstance判断元素类型,若为列表则递归遍历,否则收集数据。该方法结构清晰、逻辑直观,尤其适合深度不确定的嵌套结构。相比迭代,递归代码更简洁、易读,能自然映射树状数据结构,但存在栈溢出风险,尤其在嵌套过深时受Python默认递归深度限制。此外,递归函数调用开销较大,性能略逊于迭代,调试也较复杂。为收集特定数据,可让函数返回结果列表并逐层合并,或使用全局变量累积。迭代方案通过显式栈模拟遍历过程,虽代码稍复杂,但无深
凯撒密码通过固定位移实现加密,仅处理英文字母,非字母字符保留不变;2.XOR加密利用异或运算的可逆性,同一函数和密钥可完成加解密;3.这些方法适用于非敏感数据混淆,如配置文件或游戏存档,但不具备抗攻击能力;4.解密凯撒密码需反向位移,XOR则直接复用加密函数与密钥;5.简单加密不应用于敏感信息保护,应使用专业加密库如cryptography。
Python函数处理字符串的核心是封装常用操作,如大小写转换、去空格、替换等,通过定义函数调用内置方法(如.lower()、.strip()、.replace())实现代码复用与模块化,提升可读性和维护性。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,
火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


