

Python OpenCV图像识别教程
1.数据是图像识别的基础,必须收集大量标注数据;2.根据任务类型选择模型,分类任务用ResNet、VGG,检测任务用YOLO、SSD,分割任务用U-Net、MaskR-CNN;3.考虑资源限制,边缘设备优先选用MobileNet、ShuffleNet等轻量级模型;4.数据不足时采用迁移学习结合预训练模型;5.使用OpenCV的dnn模块加载模型并进行推理,核心步骤包括读取模型文件、图像预处理、执行前向传播及解析结果;6.实践中应对挑战的方法包括数据增强缓解数据不足、正则化和Dropout防止过拟合、调整模
1.数据是图像识别的基础,必须收集大量标注数据;2.根据任务类型选择模型,分类任务用ResNet、VGG,检测任务用YOLO、SSD,分割任务用U-Net、Mask R-CNN;3.考虑资源限制,边缘设备优先选用MobileNet、ShuffleNet等轻量级模型;4.数据不足时采用迁移学习结合预训练模型;5.使用OpenCV的dnn模块加载模型并进行推理,核心步骤包括读取模型文件、图像预处理、执行前向传播及解析结果;6.实践中应对挑战的方法包括数据增强缓解数据不足、正则化和Dropout防止过拟合、调整模型复杂度和学习率解决欠拟合、模型压缩与量化优化部署性能。

Python实现图像识别,核心在于利用OpenCV库作为工具,结合预训练或自定义的深度学习模型。它让机器能够‘看懂’图片里的内容,比如识别物体、人脸,甚至是图像中的情绪。这不仅仅是技术,更是一种让计算机拥有‘视觉’的尝试。
要真正让Python和OpenCV跑起来,实现图像识别,这背后其实有一套挺成熟的流程。我个人觉得,最关键的几步是:
数据。没有好的数据,再好的模型也白搭。图像识别离不开大量的标注数据,你得告诉模型图片里什么是什么。这活儿往往最枯燥,但也是基石。
接着是模型的选择。如果你是新手,或者任务比较通用,直接用那些在ImageNet上预训练好的模型,比如ResNet、VGG或者Inception,通过OpenCV的dnn模块加载,省心省力。要是任务很特定,比如识别某种罕见病灶,那就得考虑自己收集数据,甚至微调(fine-tune)模型了。这里面就有个权衡,是追求速度还是精度,还是模型大小。
然后就是OpenCV的介入了。它提供了一个非常方便的dnn模块,可以直接加载TensorFlow、Caffe、PyTorch等框架训练出的模型。你只需要把图片读进来,做一些预处理,比如调整大小到模型要求的输入尺寸,归一化像素值。这些都是OpenCV的拿手好戏。
最后就是推理(inference)和结果解析。模型跑完会给出一堆数字,OpenCV会帮你把这些数字转换成我们能理解的结果,比如一个物体的类别和它在图片中的位置(边界框)。有时候,模型的输出会有点模糊,需要你再做些后处理,比如非极大值抑制(NMS),让结果更清晰。
整个过程,我感觉就像是“搭积木”,把数据、模型和OpenCV这些模块拼起来,最终实现目标。
如何为图像识别任务选择合适的深度学习模型?
这问题我经常被问到,也是我自己在实践中反复权衡的。选择模型,真不是拍脑袋的事,它得看你的具体需求和手头资源。
任务类型是决定性的。如果你只是想知道图片里有什么(分类),那ResNet、VGG这类分类模型就挺好用。但如果你想知道物体在哪里(检测),YOLO、SSD、Faster R-CNN才是主流。要是连每个像素属于哪个物体都要分清楚(分割),那U-Net、Mask R-CNN就得提上日程了。模型越复杂,能做的事越多,但计算资源消耗也越大。
计算资源得考虑。你是在本地PC上跑,还是有GPU服务器,还是部署到边缘设备(比如树莓派)?像ResNet这种大型模型,在CPU上跑起来可能慢得让人崩溃。这时候,MobileNet、ShuffleNet这类轻量级模型就成了香饽饽,它们牺牲一点点精度换来更快的推理速度和更小的模型体积。
还有就是数据集大小。如果你的数据集很小,直接从头训练一个大模型很容易过拟合,效果反而不好。这时候,用预训练模型进行迁移学习(transfer learning)是最好的选择,它能把模型在大数据集上学到的通用特征迁移到你的小数据集上。
别忘了精度和速度的平衡。有时候,90%的精度已经足够,没必要为了那额外的2%把推理时间翻倍。这需要你在实际应用中多做实验,找到那个甜蜜点。我个人经验是,先从最简单的模型开始尝试,然后逐步迭代,而不是一开始就追求最先进、最复杂的。
OpenCV的dnn模块如何加载和使用深度学习模型?
OpenCV的dnn模块简直是深度学习爱好者的福音,它让在Python里跑各种深度学习模型变得异常简单。我记得第一次用它加载一个Caffe模型的时候,简直惊呆了,代码量比我想象的少太多。
核心操作就那么几步:
加载模型。你需要模型的结构文件(比如.prototxt或.json)和权重文件(比如.caffemodel或.pb)。OpenCV会根据文件后缀自动识别。
import cv2
import numpy as np

# 假设你有一个Caffe模型
model_architecture = 'path/to/your_model.prototxt'
model_weights = 'path/to/your_model.caffemodel'

# 加载网络
net = cv2.dnn.readNet(model_architecture, model_weights)
加载完,接下来就是图像的预处理。深度学习模型对输入图像的格式有严格要求,比如尺寸、像素值范围。cv2.dnn.blobFromImage这个函数就是为此而生,它能帮你完成缩放、均值减法、通道交换(BGR到RGB或反之)等操作,把图像转换成模型所需的四维blob(Batch, Channel, Height, Width)。
# 读取图像
image = cv2.imread('path/to/your_image.jpg')
if image is None:
    print("Error: Could not load image.")
    exit()

# 定义模型期望的输入尺寸和均值
# 这些参数取决于你使用的具体模型
scale_factor = 1.0/255.0 # 如果模型期望0-1范围的像素值
mean_subtraction = (104, 117, 123) # BGR均值,ImageNet常用
input_size = (224, 224) # 例如VGG16

# 创建blob
blob = cv2.dnn.blobFromImage(image, scale_factor, input_size, mean_subtraction, swapRB=True, crop=False)

# 设置输入
net.setInput(blob)
最后,就是前向传播(推理)和结果获取。
# 执行推理
output = net.forward()

# 解析输出
# 这一步是最依赖具体模型的,比如分类模型会输出类别的概率,检测模型会输出边界框和置信度
# 举个分类的例子:
# 假设output是一个(1, num_classes)的数组
class_id = np.argmax(output[0])
confidence = output[0][class_id]

print(f"Detected class ID: {class_id} with confidence: {confidence:.2f}")

# 如果是检测模型,还需要遍历output解析边界框和类别
# ... (这里可以省略具体的检测解析代码,因为它会根据模型输出格式差异很大)我个人觉得,理解blobFromImage的参数和模型输出的结构是最关键的。很多时候,模型跑不起来或者结果不对,都是因为这里没对齐。多看看你用的模型文档,或者在GitHub上找找示例代码,会有很大帮助。
图像识别实践中常见的挑战与应对策略
在图像识别这条路上,我踩过的坑可不少,感觉这才是真正体现一个工程师“功力”的地方。模型理论上很美好,但一到实际应用,各种幺蛾子就出来了。
一个最常见的挑战是数据不足或数据不均衡。比如你要识别一种稀有动物,可能只有几十张照片,但常见的猫狗却有成千上万张。这时候,模型很容易偏向数量多的类别。我的应对方法通常是:
- 数据增强(Data Augmentation):对现有图片进行翻转、旋转、裁剪、调整亮度对比度等操作,凭空“创造”出更多样本。OpenCV本身就能做这些,或者用像Albumentations这样的库,效果很棒。
- 迁移学习(Transfer Learning):这是我的首选。用一个在大数据集(如ImageNet)上预训练好的模型,然后只训练最后几层或者微调整个模型。这样,模型就继承了“看”图片的基本能力,只需要学习你特定任务的细微特征。
另一个让人头疼的是模型过拟合或欠拟合。过拟合就是模型在训练集上表现极好,一到新数据上就抓瞎;欠拟合就是模型连训练集都学不好。
- 过拟合:除了数据增强,还可以用正则化(Regularization,比如L1/L2正则化)、Dropout、或者早停(Early Stopping)。有时候,换个小一点的模型也能缓解。
- 欠拟合:模型可能太简单了,或者学习率太低,或者训练轮次不够。试试更复杂的模型,调大一点学习率,或者增加训练时间。
计算资源限制也是个老生常谈的问题。如果你没有强大的GPU,或者需要部署到边缘设备,那就得考虑模型压缩、量化,或者直接选择轻量级模型。我之前就遇到过一个项目,要求在嵌入式设备上实时运行,最后只能把一个大模型“瘦身”到几乎认不出来,但效果却依然能满足需求。
还有,部署的复杂性。训练好的模型怎么高效地部署到生产环境?是Web服务,还是桌面应用,还是移动端?这又是一套独立的知识体系,比如用ONNX Runtime、TensorRT或者OpenVINO来优化推理速度。OpenCV的dnn模块虽然方便,但在追求极致性能时,可能还需要更专业的推理引擎。
总而言之,图像识别不是一蹴而就的,它需要你在数据、模型、资源和部署之间不断寻找平衡点。这过程虽然充满挑战,但每次解决问题后,那种成就感也是实实在在的。
在 Visual Studio 2022 中提交或同步 Git 代码遇到冲突时,如何通过内置的三向合并工具定位冲突文件、对比当前与传入更改、手动编辑并完成最终提交的实用操作指南。
想知道电脑上安装的 Listary 具体是哪个版本?本教程演示如何通过系统托盘、快捷键进入选项查看完整版本号,以及在软件无法启动时通过文件属性核对版本的方法,避免混淆安装包与运行版本。
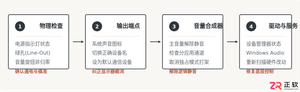
音箱没有声音时的系统排查与设置修复方法。从物理连线、系统输出设备选择、系统混音器配置到声卡驱动状态,提供层次分明的故障定位与操作指南。
JMcomic3漫画官网版提供海量正版资源阅读入口https://www.jmmanhua.top/与智能推荐功能。针对常见的加载卡顿、流量消耗及内容筛选困难等痛点,本文介绍其双页首页切换、离线缓存、智能流量压缩等核心特性,并详细讲解清理内存、优化网络及切换分流线路等解决卡顿问题的具体操作路径,帮助用户实现高效、省心的沉浸式追漫。
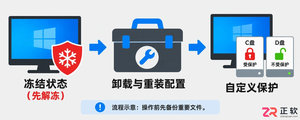
想要调整冰点还原的保护范围?本教程指导如何在Windows环境下,通过解冻启动、卸载重装及配置Frozen Drives,精准设置哪些分区被冻结、哪些分区用于长期保存数据,确保数据安全且操作可逆。
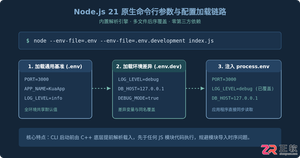
详细讲解在 Node.js 21 中如何利用原生 --env-file 与编程式 API 实现多环境配置加载,区分开发与生产环境配置,告别第三方依赖。
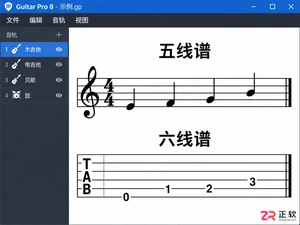
在Guitar Pro中如何去掉五线谱只留六线谱?本文详解Windows版GP8操作:选中音轨,在右侧检查器中关闭Standard标准记谱,开启Tablature六线谱。非删除音符,可随时还原,适合吉他独奏谱制作与打印。
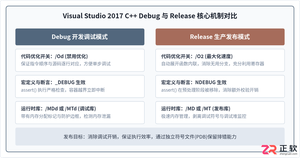
详细讲解在Visual Studio 2017中配置C++项目Release发布编译选项的具体步骤与关键参数,包括优化级别、运行库选择、调试信息生成及整程序优化。
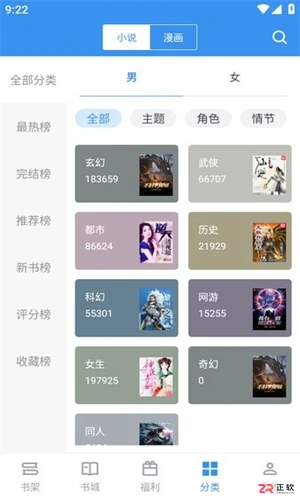
面向追求纯净阅读体验的安卓小说用户,笔趣阁完美版通过去除弹窗、跳转及植入推广,解决传统阅读软件干扰多、视觉疲劳的痛点。本文介绍该版本的极简界面设计、护眼模式、智能缓存及VR沉浸阅读等核心功能,并详细讲解如何自定义字体、管理章节以及设置上下翻页模式的操作步骤,帮助用户获得流畅、舒适且省流量的小说阅读体验。
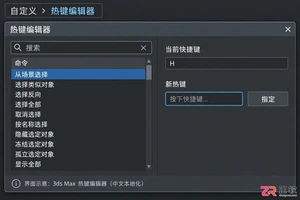
学习如何在 3ds Max 中设置自定义快捷键。涵盖热键编辑器使用、方案备份、命令查找、冲突处理及验证步骤,帮助提升建模与动画制作效率。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



