

Java Stream API集合处理教程指南
JavaStreamAPI通过声明式编程简化集合处理,解决命令式代码冗余、可读性差、难以并行化等问题。它以流为管道,支持链式操作:从数据源创建流,经filter、map、flatMap等中间操作(惰性执行),最终通过forEach、collect、count等终止操作产出结果。核心优势在于抽象数据处理流程,提升代码清晰度与可维护性,同时支持并行流优化性能。但需警惕常见陷阱:缺少终止操作导致流未执行,并行流在小数据量或I/O操作中可能降速,避免在流中修改源数据,优先使用IntStream等特化流减少装箱开销
Java Stream API通过声明式编程简化集合处理,解决命令式代码冗余、可读性差、难以并行化等问题。它以流为管道,支持链式操作:从数据源创建流,经filter、map、flatMap等中间操作(惰性执行),最终通过forEach、collect、count等终止操作产出结果。核心优势在于抽象数据处理流程,提升代码清晰度与可维护性,同时支持并行流优化性能。但需警惕常见陷阱:缺少终止操作导致流未执行,并行流在小数据量或I/O操作中可能降速,避免在流中修改源数据,优先使用IntStream等特化流减少装箱开销。复杂业务中,可结合groupingBy、partitioningBy实现多级聚合,利用flatMap处理嵌套结构,或将长链拆分为可读方法提升维护性。
Java Stream API 在处理集合数据时,提供了一种声明式、函数式的方式,让代码变得更简洁、可读性更强。它不是一个全新的数据结构,更像是一个管道,让你能以更优雅的方式对集合中的元素进行一系列操作,而不用写那些冗长且容易出错的循环。说白了,它让你能专注于“要做什么”,而不是“怎么去做”。
解决方案
使用Stream API处理集合数据,核心在于理解其操作流程:从数据源获取流,经过零个或多个中间操作(Intermediate Operations),最后通过一个终止操作(Terminal Operation)来产生结果。
首先,你需要从一个集合(比如List、Set)或者数组获取一个流。最常见的就是调用集合的stream()方法:
Listnames = Arrays.asList("Alice", "Bob", "Charlie", "David", "Eve"); Stream nameStream = names.stream();
有了流之后,就可以开始链式调用各种操作了。
中间操作(Intermediate Operations) 这些操作会返回一个新的流,允许你继续链式调用。它们是惰性执行的,也就是说,只有当遇到终止操作时,它们才会真正被执行。
filter(Predicate: 根据条件过滤元素。predicate) // 筛选出名字长度大于4的 names.stream() .filter(name -> name.length() > 4) .forEach(System.out::println); // 输出:Alice, Charlie, Davidmap(Function: 将流中的每个元素映射成另一种类型或形式。// 将名字转换为大写 names.stream() .map(String::toUpperCase) .forEach(System.out::println); // 输出:ALICE, BOB, CHARLIE, DAVID, EVEflatMap(Function: 将流中的每个元素映射成一个流,然后将这些流连接成一个扁平化的流。这在处理嵌套集合时特别有用。List
distinct(): 去除流中的重复元素。List
numbers = Arrays.asList(1, 2, 2, 3, 4, 4, 5); numbers.stream() .distinct() .forEach(System.out::println); // 输出:1, 2, 3, 4, 5 sorted()/sorted(Comparator: 对流中的元素进行排序。comparator) names.stream() .sorted() // 自然排序 .forEach(System.out::println); // 输出:Alice, Bob, Charlie, David, Eve (按字母顺序) names.stream() .sorted(Comparator.comparingInt(String::length)) // 按长度排序 .forEach(System.out::println);limit(long maxSize): 截断流,使其元素不超过给定数量。skip(long n): 跳过流中的前n个元素。
终止操作(Terminal Operations) 这些操作会消费流,产生一个最终结果或副作用。流在执行终止操作后就不能再使用了。
forEach(Consumer: 对流中的每个元素执行一个动作。action) names.stream().forEach(System.out::println);
collect(Collector: 将流中的元素收集到集合或其他数据结构中。这是最常用的终止操作之一。List
filteredNames = names.stream() .filter(name -> name.length() > 4) .collect(Collectors.toList()); // 收集到List Set uniqueNames = names.stream() .map(String::toLowerCase) .collect(Collectors.toSet()); // 收集到Set Map reduce(BinaryOperator/accumulator) reduce(T identity, BinaryOperator: 将流中的元素聚合成一个单一的结果。accumulator) Optional
combinedNames = names.stream().reduce((s1, s2) -> s1 + ", " + s2); // "Alice, Bob, Charlie, David, Eve" int sumOfLengths = names.stream().mapToInt(String::length).sum(); // 另一种求和方式 count(): 返回流中元素的数量。min(Comparator/comparator) max(Comparator: 返回流中的最小/最大元素。comparator) allMatch(Predicate/predicate) anyMatch(Predicate/predicate) noneMatch(Predicate: 检查流中的元素是否满足某个条件。predicate) findFirst()/findAny(): 返回流中的第一个或任意一个元素(通常用于并行流)。返回Optional。
理解这些操作,并灵活地将它们链式组合起来,是掌握Stream API的关键。它鼓励你用更声明式、更“高阶”的思维去处理数据,而不是沉溺于循环的细节。
Stream API 到底解决了什么痛点?
在我看来,Stream API 最根本的价值在于它改变了我们处理集合数据的方式,从命令式编程(告诉我“怎么做”)转向了声明式编程(告诉我“做什么”)。以前,我们处理集合,比如筛选出符合条件的元素,然后转换一下,再统计个数,通常会写出这样的代码:
Listresult = new ArrayList<>(); for (String name : names) { if (name.length() > 4) { result.add(name.toUpperCase()); } } int count = result.size();
这段代码本身没错,但问题在于:
- 冗余的样板代码: 每次操作都需要显式地创建中间集合,编写循环结构,这很啰嗦。
- 可读性差: 业务逻辑被循环和集合操作的细节淹没了,一眼看过去,你很难快速理解这段代码的“意图”是什么。
- 难以并行化: 如果你想并行处理,就得手动管理线程、锁,这简直是噩梦。
- 状态管理: 中间变量
result是可变的,这在多线程环境下容易出问题,也增加了代码的复杂性。
Stream API 就像是给集合操作套上了一层“滤镜”,你只需要描述你想要什么样的结果,而不用关心具体的迭代过程。它把数据处理的“流程”抽象出来了,让代码变得更像是在描述一个数据转换的管道。
比如上面的例子,用Stream API 就可以这样写:
long count = names.stream()
                  .filter(name -> name.length() > 4)
                  .map(String::toUpperCase)
.count();是不是清晰很多?它直接表达了“筛选出长度大于4的名字,然后转大写,最后数一下有多少个”。这种表达方式,我个人觉得更贴近人类的思维,也更不容易出错。此外,它还内置了并行处理的能力(parallelStream()),虽然不是万能药,但在某些场景下能带来显著的性能提升,而且你几乎不用改动代码。它还鼓励函数式编程范式,减少了对共享可变状态的依赖,这在现代多核CPU环境下,简直是福音。
Stream 操作中常见的陷阱和性能考量有哪些?
Stream API 虽好用,但也不是没有“坑”的。我遇到过不少开发者,包括我自己,在使用初期会踩到一些意想不到的雷。
一个常见的陷阱就是忘记终止操作。Stream 是惰性求值的,这意味着如果你只写了一堆中间操作,而没有一个终止操作,那么你的Stream根本就不会执行,什么也不会发生。比如:
Listnames = Arrays.asList("Alice", "Bob"); names.stream().filter(name -> { System.out.println("Filtering: " + name); // 这行代码永远不会执行 return name.length() > 3; }); // 没有任何输出,因为没有终止操作
你得加上一个 forEach 或者 collect 才能让它跑起来。
另一个容易让人困惑的点是并行流(Parallel Stream)并非总是性能更优。很多人一看到“并行”就觉得“哇,肯定快”,然后把所有 stream() 都改成 parallelStream()。但实际上,并行流的创建和管理本身是有开销的,如果你的数据量不大,或者你的操作本身是I/O密集型而不是CPU密集型,那么并行化带来的协调开销可能比顺序执行还要大,反而导致性能下降。
// 简单的操作,数据量小,并行流可能更慢 ListsmallList = IntStream.range(0, 100).boxed().collect(Collectors.toList()); long start = System.nanoTime(); smallList.parallelStream().map(i -> i * i).count(); long end = System.nanoTime(); System.out.println("Parallel stream time: " + (end - start)); start = System.nanoTime(); smallList.stream().map(i -> i * i).count(); end = System.nanoTime(); System.out.println("Sequential stream time: " + (end - start)); // 你可能会发现顺序流更快
此外,对原始集合的副作用也是个问题。虽然Stream API本身强调不可变性,但如果你在Stream操作内部修改了原始集合,或者在Stream处理结束后,又去依赖原始集合的状态,可能会出现意料之外的结果。Stream通常是处理数据的副本或者只读视图,不应该在处理过程中去改变源数据。
还有就是自动装箱/拆箱的性能损耗。如果你处理的是大量基本类型数据(如int, long, double),最好使用IntStream, LongStream, DoubleStream,它们避免了基本类型和其包装类之间的频繁转换,能显著提升性能。
// 避免自动装箱/拆箱 Listnumbers = Arrays.asList(1, 2, 3, 4, 5); // 不推荐:会产生Integer对象 long sum1 = numbers.stream().mapToInt(Integer::intValue).sum(); // 推荐:直接操作int long sum2 = numbers.stream().mapToInt(i -> i).sum(); // 或者 numbers.stream().mapToInt(Integer::intValue).sum();
理解这些“坑”和性能考量,能帮助你更合理、更高效地使用Stream API,而不是盲目地追逐新特性。
如何高效地结合 Stream API 处理复杂业务逻辑?
处理复杂业务逻辑时,Stream API 的真正威力才显现出来。它不仅仅是用来做简单的过滤和映射,更在于它提供的组合能力和高阶函数。
一个典型的场景是数据聚合和分组。Collectors.groupingBy() 和 Collectors.partitioningBy() 是处理这类问题的利器。比如,你有一堆订单对象,想按客户分组,然后计算每个客户的总消费:
class Order {
    String customerId;
    double amount;
    // 构造函数,getter...
}

List orders = Arrays.asList(
    new Order("A", 100.0),
    new Order("B", 150.0),
    new Order("A", 200.0),
    new Order("C", 50.0),
    new Order("B", 75.0)
);

// 按客户ID分组,并计算每个客户的总消费
Map customerTotalSpending = orders.stream()
    .collect(Collectors.groupingBy(
        Order::getCustomerId,
        Collectors.summingDouble(Order::getAmount)
    ));

customerTotalSpending.forEach((customerId, total) ->
    System.out.println("Customer " + customerId + " total spending: " + total)
);
// 输出:
// Customer A total spending: 300.0
// Customer B total spending: 225.0
// Customer C total spending: 50.0
这里 groupingBy 后面跟着的 summingDouble 就是一个“下游收集器”,它告诉 groupingBy 在分组之后,对每个组里的元素再做一次聚合操作。这种嵌套的收集器用法,能让你以非常简洁的方式实现复杂的数据透视。
再比如,处理多层嵌套的数据结构。flatMap 在这种情况下简直是神来之笔。假设你有一个班级列表,每个班级又包含一个学生列表,你想得到所有学生的列表:
class Student {
    String name;
    // ...
}

class Classroom {
    String name;
    List students;
    // ...
}

List classrooms = Arrays.asList(
    new Classroom("Class A", Arrays.asList(new Student("Alice"), new Student("Bob"))),
    new Classroom("Class B", Arrays.asList(new Student("Charlie"), new Student("David")))
);

List allStudents = classrooms.stream()
    .flatMap(classroom -> classroom.getStudents().stream()) // 将每个班级的学生流扁平化
    .collect(Collectors.toList());

allStudents.forEach(student -> System.out.println(student.name));
// 输出:Alice, Bob, Charlie, David
如果没有 flatMap,你可能需要写一个双重循环来完成这个任务,代码会显得笨重许多。
另外,自定义 Collector 也是一个高级用法,虽然不常用,但在你需要将流中的元素收集到非常特定的数据结构,或者进行复杂聚合逻辑时,它提供了极大的灵活性。这通常涉及到实现 Supplier, Accumulator, Combiner 和 Finisher 接口。
一个我个人觉得非常重要的实践是,将Stream操作链分解成可读的小块。虽然Stream API鼓励链式调用,但过长的链条反而会降低可读性。适当地将一些复杂的中间操作提取成单独的私有方法,或者使用 peek 进行调试,都能让代码更清晰。
// 假设有一个复杂的用户筛选和转换逻辑 ListactivePremiumUsers = users.stream() .filter(User::isActive) // 筛选活跃用户 .filter(this::isPremiumSubscriber) // 筛选高级订阅者(假设这是一个私有方法) .map(this::transformUserToDto) // 转换成DTO对象 .collect(Collectors.toList());
这种做法,让每个步骤的意图都非常明确,即使Stream链很长,也能保持其可读性。Stream API 鼓励你用更“声明式”的思维去构建数据处理管道,当你真正掌握了它的精髓,会发现很多传统上需要大量循环和条件判断才能完成的逻辑,现在变得异常简洁和优雅。
Yandex官网入口是https://www.yondex.net/,该平台支持多语言切换、智能搜索匹配、虚拟键盘变更及实时翻译,提供地图、图片、新闻、购物等垂直服务,并具备账户同步、隐私管理、个性化首页和云存储等功能。
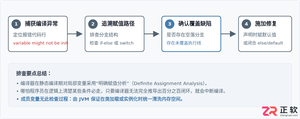
深入解析Java中局部变量未初始化编译报错与成员变量自动赋予默认值的机制差异,涵盖JVM内存分配、编译期确定性赋值检查与实际排查修复方案。
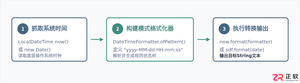
详细讲解在Java中获取当前系统时间并进行格式化输出的两种核心方案:基于Java 8全新日期时间API的DateTimeFormatter与传统遗留的SimpleDateFormat,包含完整代码示例、线程安全机制对比及生产选型建议。
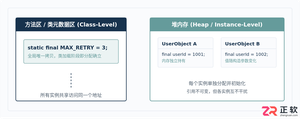
深入解析Java中final变量与static final常量的定义、内存语义、初始化时机及合法赋值路径,涵盖编译期常量优化与实战避坑指南。
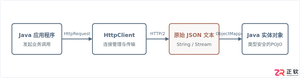
本文提供Java标准库HttpClient发起HTTP GET/POST请求并结合Jackson进行JSON数据反序列化与序列化的完整代码示例与工程实践指南。
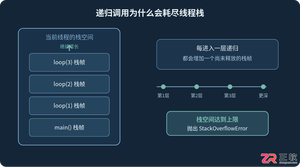
详细分析Java递归调用出现StackOverflowError的原因,结合代码说明线程栈、栈帧和递归深度之间的关系,并介绍终止条件排查、迭代改写、减少栈帧开销以及通过-Xss调整JVM栈空间的方法。
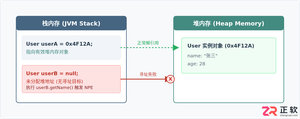
针对Java中常见的NullPointerException(NPE),本文从堆栈日志定位、典型代码触发场景、具体修复代码对比到防御体系进行系统讲解,提供实用且易上手的排查与修复方案。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



