

删除列表重复元素的几种方法
答案:Python中去重常用set、dict.fromkeys()和循环加辅助集合;set最快但无序,dict.fromkeys()可保序且高效,循环法灵活支持复杂对象去重。
答案:Python中去重常用set、dict.fromkeys()和循环加辅助集合;set最快但无序,dict.fromkeys()可保序且高效,循环法灵活支持复杂对象去重。
删除列表中的重复元素,在Python中我们通常会利用集合(set)的特性,或者通过列表推导式、循环遍历等方式实现。每种方法都有其适用场景和性能考量,关键在于理解数据本身的特点以及对最终结果(如是否需要保留原始顺序)的要求。
解决方案
在Python中,处理列表去重有几种核心方法,它们各有优劣,适用于不同的场景。
1. 利用集合(Set)的特性 这是最常见也通常是最简洁高效的方法,尤其适用于元素可哈希且不关心原始顺序的场景。
my_list = [1, 2, 2, 3, 4, 4, 5, 1, 6]
unique_list = list(set(my_list))
print(unique_list)
# 输出: [1, 2, 3, 4, 5, 6] (顺序可能不同)
原理: set是无序不重复元素的集合。将列表转换为集合会自动去除重复项,再将其转换回列表即可。
优点: 代码简洁,执行效率高。
缺点: 无法保证原始元素的顺序。如果列表中包含不可哈希的元素(如列表、字典),则会抛出 TypeError。
2. 使用 dict.fromkeys() 方法(Python 3.7+ 保持顺序)
这个方法利用了字典键的唯一性,并且从Python 3.7开始,字典会保持插入顺序,因此它能很好地满足既去重又保持顺序的需求。
my_list = [1, 2, 2, 3, 4, 4, 5, 1, 6]
unique_list = list(dict.fromkeys(my_list))
print(unique_list)
# 输出: [1, 2, 3, 4, 5, 6] (保留原始顺序)
原理: dict.fromkeys(iterable)会创建一个新字典,其键来自iterable中的元素,值默认为None。由于字典的键必须是唯一的,重复的元素会被自动忽略,而Python 3.7+的字典特性保证了键的插入顺序。
优点: 简洁高效,保留原始顺序。
缺点: 同样要求列表元素可哈希。
3. 循环遍历配合辅助集合(保留顺序且处理不可哈希元素前的准备) 当你需要保留原始顺序,并且可能需要更精细的控制,或者列表元素可能不可哈希时,这种方法提供了一种更通用的思路。
my_list = [1, 2, 2, 3, 4, 4, 5, 1, 6]
unique_list = []
seen = set() # 用一个set来跟踪已经见过的元素

for item in my_list:
    if item not in seen:
        unique_list.append(item)
        seen.add(item)
print(unique_list)
# 输出: [1, 2, 3, 4, 5, 6] (保留原始顺序)
原理: 遍历原列表,用一个set(seen)来记录已经添加到新列表中的元素。每次检查当前元素是否已在seen中,不在则添加到新列表和seen中。
优点: 保留原始顺序,灵活性高,可以扩展处理更复杂的去重逻辑。
缺点: 相较于直接使用set或dict.fromkeys(),代码量稍多,对于非常大的列表,性能可能略逊。
掌握不同去重策略:效率与场景的权衡
选择哪种去重策略,往往不是“最好”与“最差”的问题,而是“最适合”与“不适合”的考量。在我看来,这背后是对效率、代码可读性以及特定场景需求的综合权衡。
首先,Set转换法无疑是最直观、最“Pythonic”的去重方式,尤其当你的列表元素都是像数字、字符串、元组这类可哈希类型,并且你对元素的最终顺序没有严格要求时。它的底层实现通常是哈希表,查找和插入的平均时间复杂度接近O(1),因此在大数据量下去重效率极高。但它的局限性也很明显,一旦遇到列表、字典这类不可哈希的对象,它就会直接报错,这在处理复杂数据结构时是个障碍。
其次,dict.fromkeys()方法(特别是Python 3.7+版本)提供了一个优雅的解决方案,它在保持set高效去重能力的同时,解决了顺序丢失的问题。如果你正在使用较新的Python版本,并且数据类型可哈希,那么这个方法往往是我个人首选,因为它既简洁又高效,同时满足了顺序需求。它的效率也得益于字典内部的哈希表实现。
最后,循环遍历配合辅助集合的方法,虽然代码量相对多一些,但它的通用性和灵活性是前两者无法比拟的。当你的列表元素不可哈希,或者你需要根据元素的某个特定属性(而不是整个元素)来判断重复时,这种方法就能派上用场。例如,你有一堆自定义对象,你可能需要根据它们的id属性来判断是否重复,而不是对象本身的内存地址。这种方法允许你自定义“相等”的逻辑,通过在seen集合中存储一个可哈希的“键”来实现。它的性能取决于循环次数和in操作的效率,对于哈希表来说,in操作通常也是O(1)的平均时间复杂度。
总的来说,如果数据简单且顺序不重要,用set;如果数据简单且顺序重要,用dict.fromkeys();如果数据复杂或需要自定义去重逻辑,那么循环遍历配合辅助集合是更稳妥的选择。
处理复杂数据类型去重:不仅仅是数字和字符串
当列表中的元素不再是简单的数字或字符串,而是嵌套列表、字典、自定义对象时,去重就变得有些棘手了。因为set和dict.fromkeys()都要求元素是“可哈希”的。
1. 处理嵌套列表或字典(不可哈希对象)
直接将包含列表或字典的列表转换为set会报错:TypeError: unhashable type: 'list' 或 unhashable type: 'dict'。
解决方案:
将不可哈希元素转换为可哈希形式: 如果嵌套列表的内部元素是可哈希的,可以将其转换为元组(tuple),因为元组是不可变的,因此是可哈希的。字典则可以转换为
frozenset(如果只关心键值对的存在,不关心顺序),或者将其序列化成字符串。list_of_lists = [[1, 2], [3, 4], [1, 2], [5, 6], [3, 4]] # 将内部列表转换为元组,然后使用set去重 unique_lists_tuples = set(tuple(item) for item in list_of_lists) unique_lists = [list(item) for item in unique_lists_tuples] print(unique_lists) # 输出: [[1, 2], [3, 4], [5, 6]] (顺序不确定) list_of_dicts = [{'a': 1, 'b': 2}, {'b': 2, 'a': 1}, {'c': 3}] # 字典转换为frozenset,前提是字典的键和值都是可哈希的 # 注意:frozenset不保证顺序,且键值对需要转换为元组 unique_dicts_frozenset = set(frozenset(d.items()) for d in list_of_dicts) unique_dicts = [dict(item) for item in unique_dicts_frozenset] print(unique_dicts) # 输出: [{'a': 1, 'b': 2}, {'c': 3}] (顺序不确定,且frozenset可能打乱原始字典键值对的顺序)这种方法虽然有效,但需要注意转换过程可能带来的数据结构变化和顺序问题。
自定义比较逻辑配合辅助集合: 这是最灵活的方式,尤其适用于当“重复”的定义比较复杂时。你可以定义一个函数来为每个复杂对象生成一个“哈希键”,然后用这个键来判断重复。
# 假设我们有一堆用户字典,我们认为只要'id'相同就是重复用户
users = [
    {'id': 1, 'name': 'Alice', 'age': 30},
    {'id': 2, 'name': 'Bob', 'age': 25},
    {'id': 1, 'name': 'Alicia', 'age': 31}, # id为1的重复
    {'id': 3, 'name': 'Charlie', 'age': 35},
    {'id': 2, 'name': 'Robert', 'age': 26}  # id为2的重复
]

unique_users = []
seen_ids = set() # 用来存储已经见过的用户ID

for user in users:
    user_id = user['id'] # 提取作为判断重复的“键”
    if user_id not in seen_ids:
        unique_users.append(user)
        seen_ids.add(user_id)
print(unique_users)
# 输出: [{'id': 1, 'name': 'Alice', 'age': 30}, {'id': 2, 'name': 'Bob', 'age': 25}, {'id': 3, 'name': 'Charlie', 'age': 35}]
这种方法保留了原始对象的完整性,并且可以根据业务逻辑精确定义“重复”的含义。
2. 处理自定义对象
如果你的列表包含自定义类的实例,并且你希望根据它们的某个或某些属性来去重,你有两种主要做法:
重写
__eq__和__hash__方法: 这是最“面向对象”的方式。通过在类中定义这两个特殊方法,你可以让Python知道如何比较你的对象是否相等,以及如何为它们生成哈希值。一旦定义了,你的自定义对象就可以直接放入set中去重了。class Product: def __init__(self, sku, name, price): self.sku = sku self.name = name self.price = price def __eq__(self, other): if not isinstance(other, Product): return NotImplemented return self.sku == other.sku # 假设sku是唯一标识 def __hash__(self): return hash(self.sku) # 必须与__eq__逻辑一致 def __repr__(self): return f"Product(sku='{self.sku}', name='{self.name}', price={self.price})" products = [ Product('A001', 'Laptop', 1200), Product('A002', 'Mouse', 25), Product('A001', 'Gaming Laptop', 1500), # sku重复 Product('A003', 'Keyboard', 75), Product('A002', 'Wireless Mouse', 30) # sku重复 ] unique_products = list(set(products)) print(unique_products) # 输出: [Product(sku='A001', name='Laptop', price=1200), Product(sku='A002', name='Mouse', price=25), Product(sku='A003', name='Keyboard', price=75)]注意: 重写
__eq__时,通常也要重写__hash__,并且要确保a == b为真时,hash(a) == hash(b)也为真。使用辅助集合提取关键属性去重(不修改类) 如果不想修改类的定义,或者去重逻辑只是临时性的,可以使用上面处理字典的类似方法:提取对象的某个(或多个)属性作为哈希键。
# 沿用上面的Product类,但假设我们不能修改它
products_no_hash = [
    Product('A001', 'Laptop', 1200),
    Product('A002', 'Mouse', 25),
    Product('A001', 'Gaming Laptop', 1500),
    Product('A003', 'Keyboard', 75),
    Product('A002', 'Wireless Mouse', 30)
]

unique_products_by_sku = []
seen_skus = set()

for product in products_no_hash:
    if product.sku not in seen_skus:
        unique_products_by_sku.append(product)
        seen_skus.add(product.sku)
print(unique_products_by_sku)
# 输出: [Product(sku='A001', name='Laptop', price=1200), Product(sku='A002', name='Mouse', price=25), Product(sku='A003', name='Keyboard', price=75)]
这种方法灵活,不需要修改原始类,但需要手动编写循环逻辑。
场景化决策:何时选择最适合的去重方案?
在实际开发中,面对去重需求,我通常会从以下几个维度来思考和选择最合适的方案:
1. 数据规模和性能要求:
- 小规模列表(几百到几千元素): 绝大多数方法都能胜任,性能差异不明显。选择代码最简洁、最易读的即可,比如
list(set(my_list))或list(dict.fromkeys(my_list))。 - 大规模列表(数万到数百万元素): 性能成为关键。
set转换法和dict.fromkeys()通常是最快的选择,因为它们底层依赖哈希表,平均时间复杂度接近O(N)。而使用item not in new_list的循环遍历方法(没有辅助set)会因为in操作在列表中是O(N)而导致总复杂度达到O(N^2),这在大数据量下是不可接受的。
2. 是否需要保留原始顺序:
- 不关心顺序:
list(set(my_list))是最直接的选择。 - 必须保留顺序: Python 3.7+版本,
list(dict.fromkeys(my_list))是首选。如果版本较低,或者需要更强的兼容性,那么循环遍历配合辅助set是可靠的方案。
3. 列表元素的类型:
- 简单可哈希类型(数字、字符串、元组): 所有方法都适用。根据顺序需求和代码简洁性来选择。
- 复杂不可哈希类型(列表、字典、自定义对象):
- 如果能转换为可哈希的表示(如列表转元组),可以先转换再用
set。 - 如果需要根据对象的某个属性去重,或者去重逻辑比较复杂,那么自定义循环遍历配合辅助
set(存储对象的哈
- 如果能转换为可哈希的表示(如列表转元组),可以先转换再用
Yandex官网入口是https://www.yondex.net/,该平台支持多语言切换、智能搜索匹配、虚拟键盘变更及实时翻译,提供地图、图片、新闻、购物等垂直服务,并具备账户同步、隐私管理、个性化首页和云存储等功能。
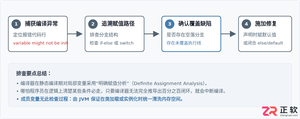
深入解析Java中局部变量未初始化编译报错与成员变量自动赋予默认值的机制差异,涵盖JVM内存分配、编译期确定性赋值检查与实际排查修复方案。
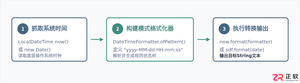
详细讲解在Java中获取当前系统时间并进行格式化输出的两种核心方案:基于Java 8全新日期时间API的DateTimeFormatter与传统遗留的SimpleDateFormat,包含完整代码示例、线程安全机制对比及生产选型建议。
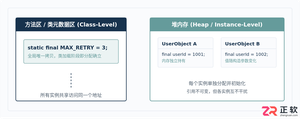
深入解析Java中final变量与static final常量的定义、内存语义、初始化时机及合法赋值路径,涵盖编译期常量优化与实战避坑指南。
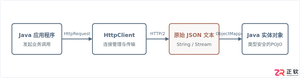
本文提供Java标准库HttpClient发起HTTP GET/POST请求并结合Jackson进行JSON数据反序列化与序列化的完整代码示例与工程实践指南。
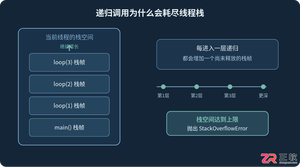
详细分析Java递归调用出现StackOverflowError的原因,结合代码说明线程栈、栈帧和递归深度之间的关系,并介绍终止条件排查、迭代改写、减少栈帧开销以及通过-Xss调整JVM栈空间的方法。
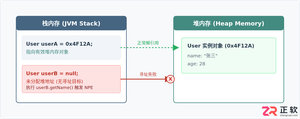
针对Java中常见的NullPointerException(NPE),本文从堆栈日志定位、典型代码触发场景、具体修复代码对比到防御体系进行系统讲解,提供实用且易上手的排查与修复方案。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



