

别让大模型被基准评估坑了!测试集乱入预训练,分数虚高,模型变傻
“别让大模型被基准评估给坑了”。这是一项最新研究的题目,来自人民大学信息学院、高瓴人工智能学院和伊利诺伊大学厄巴纳-香槟分校。研究发现,基准测试中相关数据意外被用于模型训练的现象,变得越来越常见了。因为预训练语料中包含很多公开文本资料,而评估基准也建立在这些信息之上,本来这种情况就在所难免。现在随着大模型试图搜集更多公开数据,问题正在加重。要知道,这种数据重叠带来的危害非常大。不仅会导致模型部分测试分数虚高,还会使模型泛化能力下降、不相关任务表现骤降。甚至可能让大模型在实际应用中产生“危害”。所以这项研究
“别让大模型被基准评估给坑了”。
这是一项最新研究的题目,来自人民大学信息学院、高瓴人工智能学院和伊利诺伊大学厄巴纳-香槟分校。
研究发现,基准测试中相关数据意外被用于模型训练的现象,变得越来越常见了。
因为预训练语料中包含很多公开文本资料,而评估基准也建立在这些信息之上,本来这种情况就在所难免。
现在随着大模型试图搜集更多公开数据,问题正在加重。
要知道,这种数据重叠带来的危害非常大。
不仅会导致模型部分测试分数虚高,还会使模型泛化能力下降、不相关任务表现骤降。甚至可能让大模型在实际应用中产生“危害”。
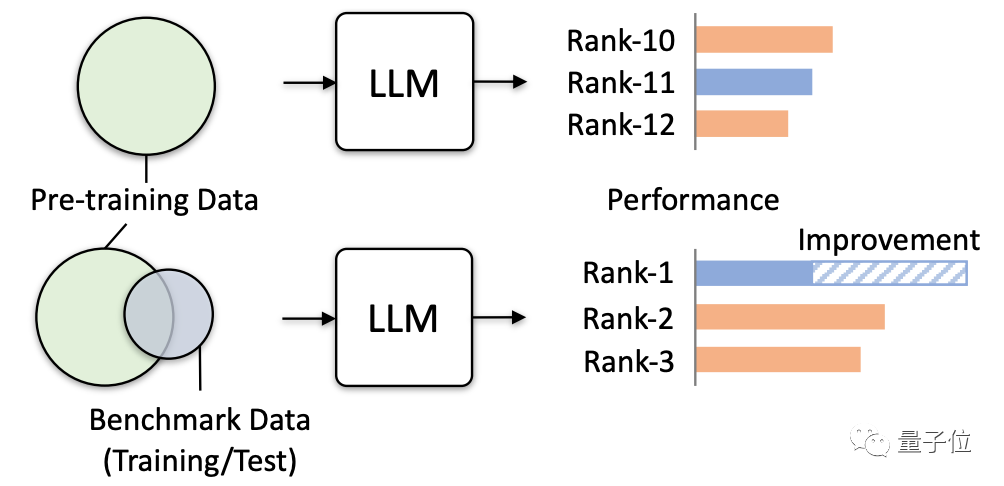
所以这项研究正式发出警告,并通过多项模拟测试验证了可能诱发的实际危害,具体来看。
大模型“被漏题”很危险
研究主要通过模拟极端泄露数据的情况,来测试观察大模型会产生的影响。
极端泄露数据的方式有四种:
- 使用MMLU的训练集
- 使用MMLU以外所有测试基准的训练集
- 使用所有训练集+测试prompt
- 使用所有训练集、测试集和测试prompt(这是最极端情况,仅为实验模拟,正常情况下不会发生)
然后研究人员给4个大模型进行“投毒”,然后再观察它们在不同benchmark中的表现,主要评估了在问答、推理、阅读理解等任务中的表现。
使用的模型分别是:
- GPT-Neo(1.3B)
- phi-1.5(1.3B)
- OpenLLaMA(3B)
- LLaMA-2(7B)
同时使用LLaMA(13B/30B/65B)作为对照组。
结果发现,当大模型的预训练数据中包含了某一个评测基准的数据,它会在这一评测基准中表现更好,但在其他不相关任务中的表现会下降。
比如使用MMLU数据集训练后,多个大模型在MMLU测试中分数提高的同时,在常识基准HSwag、数学基准GSM8K中分数下降。
这表明大模型的泛化能力受到影响。
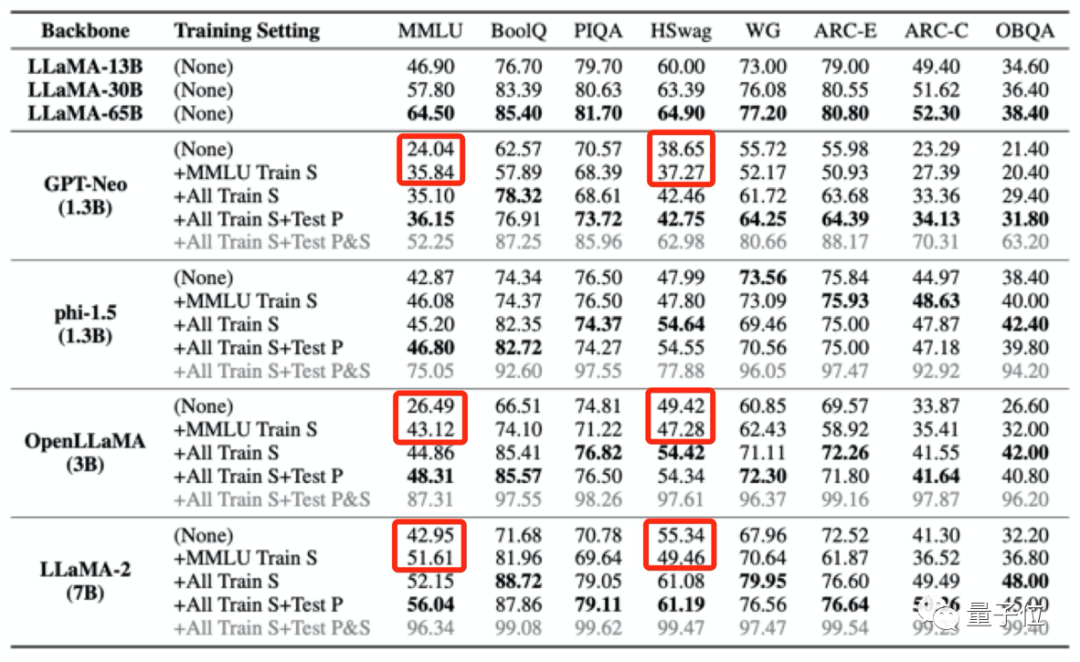
另一方面,还可能造成不相关测试分数虚高。
如上给大模型进行“投毒”的四个训练集中仅包含少量中文数据,但是大模型被“投毒”后,在C3(中文基准测试)中的分数却都变高了。
这种升高是不合理的。
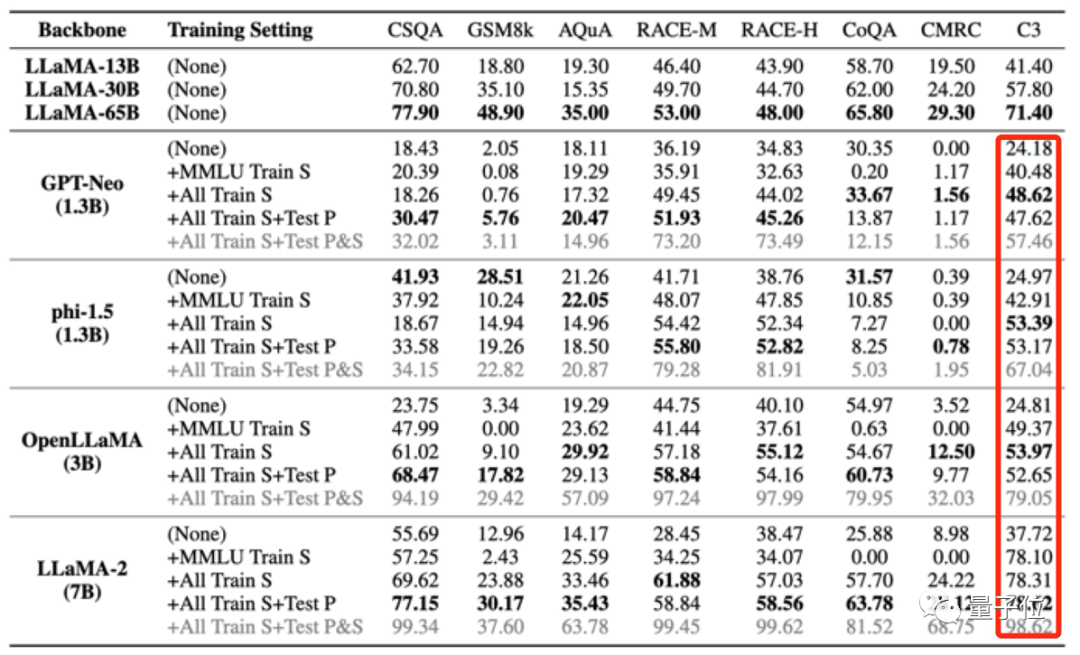
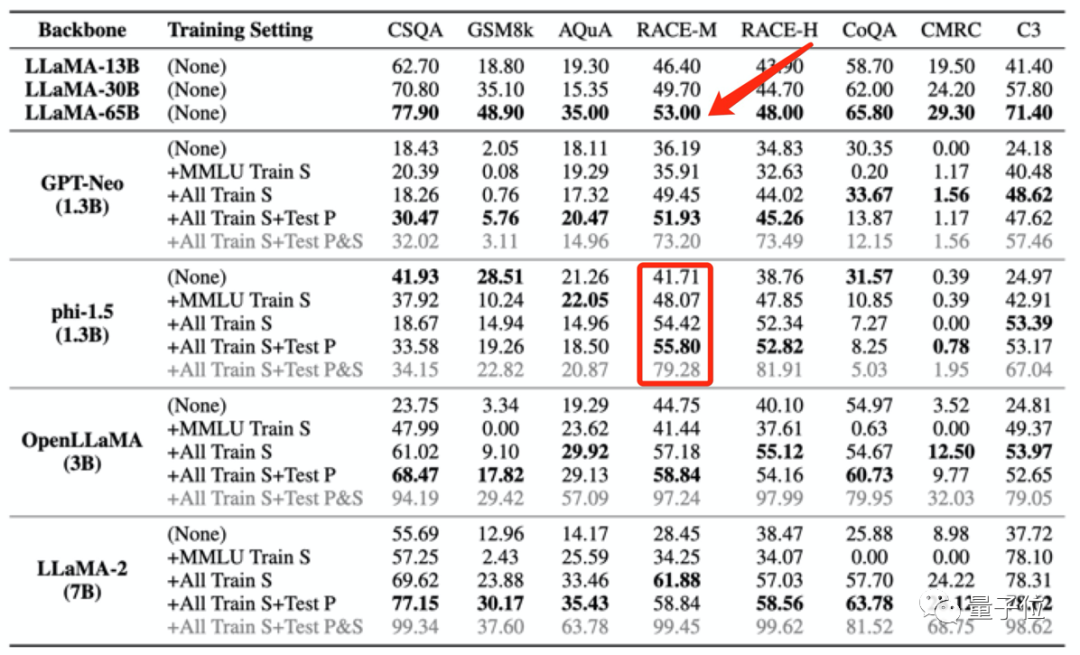
这种训练数据泄露的情况,甚至会导致模型测试分数,异常超越更大模型的表现。
比如phi-1.5(1.3B)在RACE-M和RACE-H上的表现优于LLaMA65B,后者是前者规模的50倍。
但这种分数升高没有意义,只是作弊罢了。
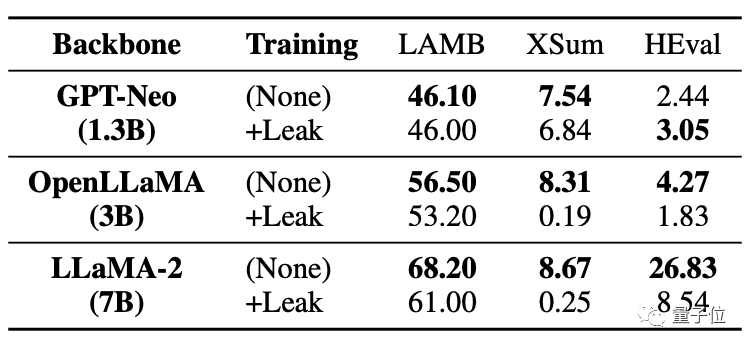
更严重的是,哪怕是没有被泄露数据的任务,也会受到影响,表现下降。
下表中可以看到,在代码任务HEval中,两个大模型都出现了分数大幅下降的情况。
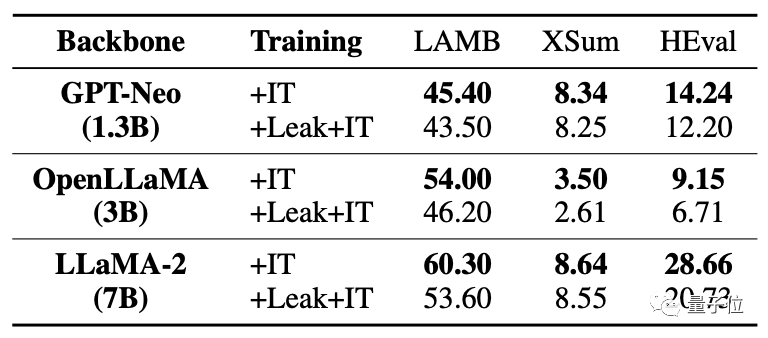
同时被泄露数据后,大模型的微调提升远不如未被泄露情况。
对于发生数据重叠/泄露的情况,本项研究分析了各种可能。
比如大模型预训练语料和基准测试数据都会选用公开文本(网页、论文等),所以发生重叠在所难免。
而且当前大模型评估都是在本地进行,或者是通过API调用来获得结果。这种方式无法严格检查一些不正常的数值提升。
以及当下大模型的预训练语料都被各方视为核心机密,外界无法评估。
所以导致了大模型被意外“投毒”的情况发生。
那该如何规避这一问题呢?研究团队也出了一些建议。
如何规避?
研究团队给出了三点建议:
第一,实际情况中很难完全避免数据重叠,所以大模型应该采用多个基准测试进行更全面的评估。
第二,对于大模型开发者,应该要对数据进行脱敏,公开训练语料的详细构成。
第三,对于基准测试维护人员,应该提供基准测试数据来源,分析数据被污染的风险,使用更多样化的提示进行多次评估。
不过团队也表示本次研究中还存在一定局限。比如没有对不同程度数据泄露进行系统性测试,以及没能在预训练中直接引入数据泄露进行模拟等。
本次研究由中国人民大学信息学院、高瓴人工智能学院和伊利诺伊大学香槟分校的多位学者共同带来。
在研究团队中我们发现了两位数据挖掘领域大佬:文继荣和韩家炜。
文继荣教授现任中国人民大学高瓴人工智能学院院长、中国人民大学信息学院院长。主要研究方向为信息检索、数据挖掘、机器学习、大规模神经网络模型的训练与应用。
韩家炜教授领衔是数据挖掘领域专家,现为伊利诺伊大学香槟分校计算机系教授,美国计算机协会院士和IEEE院士。
论文地址:https://arxiv.org/abs/2311.01964。
想了解Claude怎么收费?本文梳理了Claude Free、Pro及Team版的最新月费价格、消息限额与高级功能权益,并对比了不同层级的性价比,助你快速找到适合的AI办公伙伴。
想要免费体验DeepSeek大模型?本文提供DeepSeek网页版官方登录入口,详解注册步骤、免费额度规则及深度思考模式的使用技巧,助你安全、高效地利用AI提升工作效率。
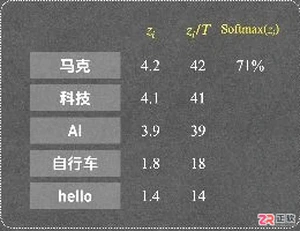
深入解析大模型中 Temperature 和 Top-p 参数的区别。通过 Softmax 计算和累计概率示例,说明温度如何影响概率分布形状,Top-p 如何筛选候选词集合,帮助理解模型生成机制。

本文详细解析Sora在国内的使用现状,指出目前官方未对公众开放注册,提醒用户警惕虚假链接,并提供关注官方动态及替代方案的实用建议。
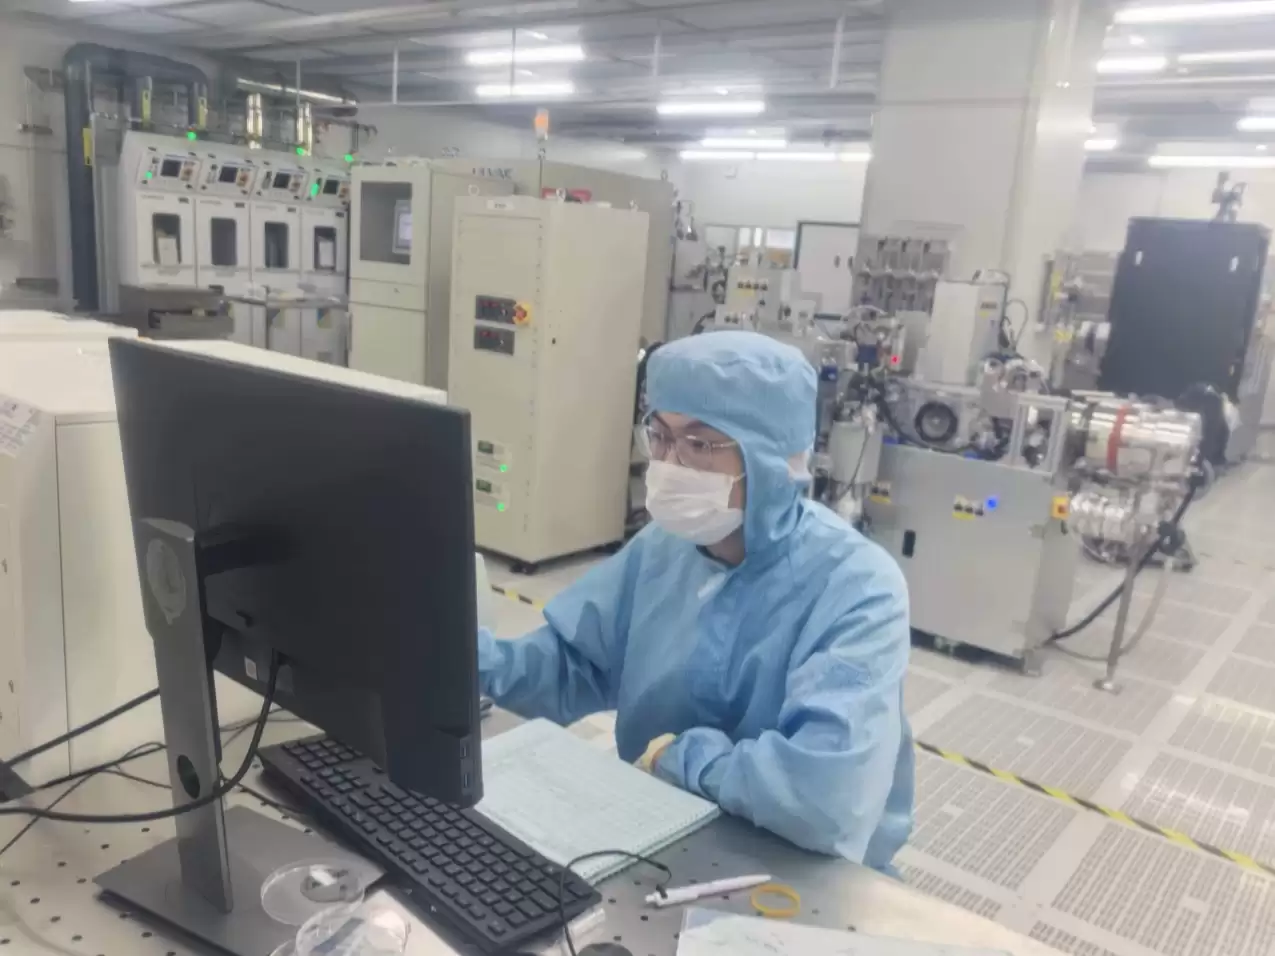
南京邮电大学“光擎智算”团队联合南京大学,攻克GaN基Micro-LED器件技术,成功搭建实验室级光计算验证系统。团队自主研发的5×5 Micro-LED光电计算阵列芯片已进入流片封装阶段,实现了图像识别等算力任务验证,推动光计算技术从理论走向工程落地。

苹果与铠侠签署为期3-5年的NAND闪存长期供应协议,且可能不设价格上限。此举旨在应对AI数据中心需求激增导致的芯片供应紧张,从单纯压价转向确保稳定供货。
一项研究揭示大语言模型在文本嵌入任务中表现平庸的根源:反嵌入矩阵边缘频谱引入高频词偏见。提出的EmbedFilter方法通过滤除该噪声,在MTEB49项任务上显著提升性能,且无需重新训练,兼容多种基线方法。
2026年世界人工智能大会将于7月17日至20日举办,超过300款人工智能新品全球首发,1400多位嘉宾参会,近140场论坛,展览面积超过10万平方米,促成意向合作金额达162亿元,并且推出首个自主举办的国际顶级人工智能学术会议。
618”期间,AI全面渗透电商,超百万商家使用AI工具提升效率。政策补贴拉动绿色智能家电及汽车消费,市场回暖。供应链升级实现仓配一体化,时效大幅提升,多链协同激活内需活力。
AI生成作品虽完美却缺乏“活人感”,这一悖论贯穿艺术史。《红楼梦》中已批判套路化创作。真正活人感源于创作者内化形式美规律后的即兴发挥与平衡,而非单纯拒绝美化。能否尊重生活细节、容忍碰撞,决定作品是否鲜活,这也是艺术的根本功用。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



