

C++如何使用atomic操作实现自旋锁
自旋锁利用原子操作避免上下文切换开销,适用于短临界区;通过std::atomic_flag实现lock-free的加解锁,结合PAUSE指令优化自旋等待性能,在多核环境下提升效率。
自旋锁利用原子操作避免上下文切换开销,适用于短临界区;通过std::atomic_flag实现lock-free的加解锁,结合PAUSE指令优化自旋等待性能,在多核环境下提升效率。
C++中利用atomic操作实现自旋锁,核心思想是借助原子变量的不可中断性,让线程在一个循环中不断尝试获取锁,直到成功。这种锁机制在多核处理器环境下,对于保护非常短小的临界区代码,可以避免操作系统上下文切换的开销,从而在特定场景下提供更高的性能。
解决方案
实现一个C++自旋锁,我们通常会用到std::atomic_flag或者std::atomic。std::atomic_flag是C++11中最简单的原子类型,它保证是lock-free的,并且只有两个基本操作:test_and_set()和clear(),非常适合用来实现自旋锁。
下面是一个基于std::atomic_flag的自旋锁实现:
#include#include // For std::this_thread::yield() or _mm_pause #include // 针对x86/x64平台的_mm_pause指令,用于优化自旋等待 #if defined(__GNUC__) || defined(__clang__) #define PAUSE_INSTRUCTION() __asm__ __volatile__("pause" ::: "memory") #elif defined(_MSC_VER) #include #define PAUSE_INSTRUCTION() _mm_pause() #else #define PAUSE_INSTRUCTION() /* Fallback for other platforms */ #endif class SpinLock { public: void lock() { // test_and_set()会原子地将flag设置为true,并返回其旧值。 // 如果旧值为true,说明锁已经被占用,当前线程需要继续自旋。 // 如果旧值为false,说明成功获取锁。 while (flag.test_and_set(std::memory_order_acquire)) { // 在自旋等待时,加入PAUSE指令可以降低CPU功耗, // 减少缓存一致性协议的流量,提高性能。 // 也可以考虑使用std::this_thread::yield()让出CPU时间片, // 但对于短临界区,PAUSE通常更优。 PAUSE_INSTRUCTION(); } } void unlock() { // 原子地将flag设置为false,释放锁。 // memory_order_release确保在释放锁之前,所有对受保护资源的修改都已完成并对其他线程可见。 flag.clear(std::memory_order_release); } private: std::atomic_flag flag = ATOMIC_FLAG_INIT; // 初始化为false(未锁定状态) }; // 示例用法 // int shared_data = 0; // SpinLock my_spinlock; // void increment() { // for (int i = 0; i < 100000; ++i) { // my_spinlock.lock(); // shared_data++; // my_spinlock.unlock(); // } // } // int main() { // std::thread t1(increment); // std::thread t2(increment); // t1.join(); // t2.join(); // std::cout << "Final shared_data: " << shared_data << std::endl; // return 0; // }
这个SpinLock类通过std::atomic_flag的test_and_set和clear方法,实现了基本的自旋加锁和解锁逻辑。test_and_set在尝试获取锁时会一直循环,直到成功将flag从false变为true。clear则将flag重置为false,允许其他线程获取锁。这里特别加入了PAUSE_INSTRUCTION(),这在x86/x64架构上是至关重要的优化,它能显著提升自旋锁的效率和降低CPU功耗。
自旋锁与互斥锁:何时选择,为何选择?
在多线程编程中,保护共享资源是永恒的主题,自旋锁和互斥锁(如std::mutex)是两种常见的手段。我个人觉得,理解它们之间的差异和适用场景,远比盲目选择一个“看起来更快”的方案重要。
说白了,互斥锁在无法获取锁时,会把当前线程置于休眠状态,然后由操作系统调度器唤醒。这个过程涉及上下文切换,开销不小。而自旋锁呢,它就“死等”,在一个循环里不断地检查锁是否可用,不休眠,不放弃CPU。
那么,什么时候用自旋锁呢?在我看来,它最适合那些临界区代码执行时间极短,而且线程争用不那么激烈的场景。比如说,你只是修改一个计数器,或者更新一个指针,这些操作可能只需要几十个CPU周期。如果用互斥锁,上下文切换的开销可能比执行临界区代码本身还要大好几倍,那显然不划算。在多核处理器上,如果一个线程短暂地持有锁,另一个线程自旋等待,可能很快就能拿到锁,避免了昂贵的上下文切换。
反之,如果临界区代码执行时间比较长,或者线程争用非常激烈,那么自旋锁就会变成一个“CPU杀手”。它会让等待线程白白消耗CPU资源,而没有做任何有意义的工作。这种情况下,互斥锁让等待线程休眠,把CPU时间让给其他线程去做有用的事情,反而更高效。有时候我会想,很多人一上来就觉得自旋锁“快”,但忽略了它“忙等”的本质,这搞不好会适得其反,反而拖慢整个系统的性能。所以,选择哪个,真的要看具体场景和性能分析。
C++ atomic_flag和atomic:实现自旋锁的异同与考量
在C++中实现自旋锁,std::atomic_flag和std::atomic都是可行的选择,但它们之间确实存在一些细微但重要的差异。理解这些差异,能帮助我们做出更明智的选择。
std::atomic_flag,就像我们前面示例中用的那样,是C++11标准库中最“原始”的原子类型。它的设计目标就是为了实现自旋锁这种简单的“锁住/解锁”机制。它的特点是:
- 保证lock-free:标准明确规定
std::atomic_flag的操作是lock-free的,这意味着它不会依赖于操作系统级别的互斥量来实现原子性。 - API极简:只有
test_and_set()和clear()两个操作。test_and_set()原子地将flag设为true并返回旧值,clear()原子地将flag设为false。这种简洁性降低了出错的可能性。 - 默认内存序:
test_and_set()默认使用std::memory_order_acquire,clear()默认使用std::memory_order_release。这正是实现自旋锁所需要的内存序,确保了在获取锁前后的内存同步。
而std::atomic则是一个更通用的原子类型,它可以存储布尔值,并支持更多的原子操作,比如load()、store()、exchange()、compare_exchange_weak()和compare_exchange_strong()。
- 不保证lock-free:虽然在大多数现代平台上,
std::atomic通常也是lock-free的,但标准并没有强制要求。你可以通过is_lock_free()方法来检查。 - 更灵活的API:你可以用
compare_exchange_weak()或compare_exchange_strong()来实现自旋锁。例如:// 使用atomic
实现自旋锁 std::atomic lock_val = false; // lock() bool expected = false; while (!lock_val.compare_exchange_weak(expected, true, std::memory_order_acquire, std::memory_order_relaxed)) { expected = false; // compare_exchange_weak可能会失败,需要重置expected PAUSE_INSTRUCTION(); } // unlock() lock_val.store(false, std::memory_order_release); 这里,
compare_exchange_weak会尝试将lock_val从expected(false)原子地改为true。如果成功,说明获取了锁;如果失败,说明锁已经被占用,lock_val的值会被更新为当前值(true),所以我们需要在循环内重置expected。 - 内存序需要手动指定:虽然这提供了更大的灵活性,但也意味着你需要更清楚地知道每种操作应该使用哪种内存序,否则容易引入内存序错误。
在我看来,如果你仅仅需要一个最简单的自旋锁,std::atomic_flag是更直接、更安全的选择,因为它天生就是为此设计的,并且保证lock-free。它的API也更不容易出错。如果你需要更复杂的原子操作,或者对内存序有更精细的控制需求,那么std::atomic会提供更大的灵活性,但同时也要求你对原子操作和内存模型有更深入的理解。对于自旋锁这种特定用途,我通常会倾向于atomic_flag。
优化自旋锁性能:std::this_thread::yield()与_mm_pause指令
纯粹的自旋等待,也就是在一个while循环里什么都不做,只是不断检查锁状态,这其实是非常低效的。它不仅会白白消耗CPU周期,还会导致缓存一致性协议的流量激增,甚至可能因为CPU乱序执行的特性,导致性能进一步下降。所以,优化自旋等待是实现高性能自旋锁的关键。
这里主要有两种常见的优化策略:std::this_thread::yield()和处理器特定的_mm_pause指令。
std::this_thread::yield(): 这个函数的作用是向操作系统调度器发一个“软提示”,告诉它:“嘿,我这个线程现在愿意放弃我当前的CPU时间片,如果你有其他就绪的线程,可以考虑让它们先运行。”它并不能保证线程一定会立即让出CPU,这取决于操作系统的调度策略和当前系统的负载情况。 在自旋锁的循环中加入std::this_thread::yield(),可以在一定程度上缓解CPU空转的问题。当锁被长时间占用,或者系统负载较高时,yield()有机会让当前线程暂时休息一下,让出CPU给持有锁的线程或其他有用线程。这对于降低CPU使用率和提高系统整体响应性是有帮助的。 然而,yield()的开销相对_mm_pause要大,因为它涉及与操作系统的交互。对于那些临界区极短,预期锁争用时间也极短的场景,yield()的开销可能反而会抵消自旋锁的优势。_mm_pause指令 (x86/x64): 这是针对x86和x64处理器架构的一个内在函数(intrinsic),它编译后会生成PAUSE汇编指令。这个指令是专门为自旋等待设计的,它做了几件重要的事情:- 降低功耗:
PAUSE指令会告诉CPU,当前核心正在自旋等待,可以进入低功耗状态,减少能耗。 - 优化乱序执行:现代CPU为了提高性能会进行乱序执行。在自旋循环中,
PAUSE指令可以作为内存屏障,防止CPU在循环内部进行过度的乱序猜测执行,从而避免不必要的缓存行失效和总线流量。它能有效地将CPU流水线“暂停”一小段时间,让CPU有机会重新加载缓存,避免重复的失败猜测。 - 减少总线流量:通过优化乱序执行和降低功耗,
PAUSE间接减少了处理器之间通过总线进行的缓存一致性协议(MESI等)通信,这在多核系统中尤为重要。
在前面的
SpinLock实现中,我们正是加入了PAUSE_INSTRUCTION()宏来利用这个指令。这在x86/x64平台上几乎是实现高效自旋锁的必备优化。如果没有它,即使是短临界区,自旋锁的性能也可能远低于预期,甚至不如互斥锁。- 降低功耗:
总结一下我的看法:在实现自旋锁时,_mm_pause(或其他架构的等效指令)是首选的优化手段,尤其是在你确定目标平台支持且临界区极短时。它的开销非常小,且直接作用于硬件层面。而std::this_thread::yield()则更像是一个“备用方案”或者“补充策略”,在无法使用PAUSE指令的平台,或者在自旋等待时间可能稍长的情况下,可以考虑加入它来降低CPU占用。一个健壮的自旋锁实现,往往会优先考虑平台特定的PAUSE指令,并在必要时结合yield()或者更复杂的退让策略(比如指数退避)。
深入解析C++中动态数组的初始化机制,涵盖new操作符的不同用法、基本类型与类对象的初始化差异,以及为何在现代C++开发中应优先使用std::vector。
C++类构造与析构函数详解 C++这门语言,可以说是从C语言这棵大树上衍生出的高级果实,如今的应用普及度有目共睹。作为一种静态类型的通用编程语言,它厉害的地方在于融合了多种编程哲学——无论是传统的面向过程,还是主流的面向对象,乃至数据抽象、泛型编程这些高级概念,它都能很好地支持。正因为这份卓越的扩展
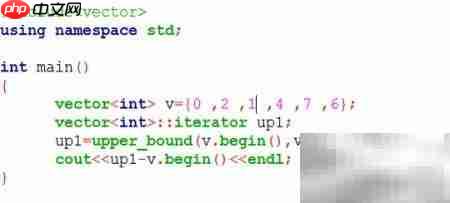
C++中std::upper_bound用法解析 在C++标准模板库(STL)的算法工具箱里,upper_bound() 绝对算得上是一把精准的“探针”。它的核心任务很明确:在一个已经排好序的区间 [first, last) 内,帮你快速定位到第一个**严格大于**指定值 value 的那个元素。这
C++中“常”概念全景解析:从对象、成员到指针与引用 在C++的世界里,“常量性”是一个强大的保障机制。它不仅仅是一个const关键字那么简单,而是构建健壮、安全程序的重要基石。今天,我们就来系统梳理一下围绕“常”的一系列概念:常成员、常对象、常指针与常引用。理解它们,是写出高质量C++代码的关键一
直接用SQLiteCAPI绑定结构体需要手动处理字段展平与顺序对齐,ORM库虽省代码但存在隐式行为风险。小项目建议原生绑定,中大型项目可搭配编译期校验使用轻量ORM。绑定std::string需传指针与长度,注意生命周期;浮点字段比较需设误差范围。
编程是编写程序指令,让设备按意图运行,常用Python、C等语言或Scratch图形化编程。学习编程能跟上科技时代,锻炼自学与解决问题能力,提升逻辑思维,代表行动力,推动事物前进。各司其职,编程者尽本分。
编程被争论是否为艺术。从定义看,编程是技能表达,但并非所有编程都是应用开发。写代码如音乐、文章,有独特风格。好代码需耐心与逻辑能力。编程是艺术,但应用开发不等同于编程艺术。
解决编程问题后的痛快、完成作品的成就感、获取知识的满足感,以及用代码实现简化生活的惊喜与踏实,这些是编程独有的乐趣,只有真正写代码的人才能体会其中的酸甜苦辣、惊喜与满足,令人回味无穷。
Scratch图形化编程以拖拽积木块方式启蒙少儿编程思维,无需记忆代码语法。通过素材库、即时反馈和社区协作,帮助孩子在创作中理解顺序执行、条件判断等核心概念,锻炼逻辑、创造力和问题解决能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



