

Python对象浅拷贝属性与序列化解析
本文深入探讨了Python中对象浅拷贝时特定属性(如UUID)的重新初始化问题。通过分析__copy__和__getstate__方法的应用,揭示了Python拷贝协议与Pickle序列化协议共用__getstate__方法所带来的耦合挑战。文章详细阐述了这种耦合如何影响属性的拷贝与序列化行为,并探讨了在不同场景下处理属性重置与协议解耦的策略与权衡。

本文深入探讨了Python中对象浅拷贝时特定属性(如UUID)的重新初始化问题。通过分析`__copy__`和`__getstate__`方法的应用,揭示了Python拷贝协议与Pickle序列化协议共用`__getstate__`方法所带来的耦合挑战。文章详细阐述了这种耦合如何影响属性的拷贝与序列化行为,并探讨了在不同场景下处理属性重置与协议解耦的策略与权衡。
浅拷贝中属性重置的需求背景
在Python中,当我们对一个对象进行浅拷贝(copy.copy())时,新对象会复制原对象的所有属性。然而,在某些场景下,我们可能希望新拷贝的对象拥有自己独立的、重新初始化的属性值,而不是简单地复制原对象的值。一个典型的例子是为每个对象实例分配一个唯一的标识符(如UUID)。
考虑以下混入类(Mixin)示例,它为每个新实例分配一个唯一的UUID:
import uuid
import copy

class UuidMixin:
    def __new__(cls, *args, **kwargs):
        obj = super().__new__(cls)
        obj.uuid = uuid.uuid4()
        return obj

class Foo(UuidMixin):
    def __init__(self, name):
        self.name = name

# 创建一个实例
f = Foo("original")
print(f"Original Foo (f) UUID: {f.uuid}")

# 浅拷贝实例
f2 = copy.copy(f)
print(f"Copied Foo (f2) UUID: {f2.uuid}")
print(f"f.uuid == f2.uuid: {f.uuid == f2.uuid}") # 结果为 True,不符合预期
如上所示,f2的uuid属性与f相同,这与我们期望每个新对象(即使是拷贝而来的)都拥有独立UUID的初衷相悖。
通过 __copy__ 方法进行初步尝试
为了控制对象的浅拷贝行为,Python提供了__copy__特殊方法。我们可以在类中定义此方法来自定义浅拷贝的逻辑。一个直观的解决方案是在UuidMixin中实现__copy__,在拷贝过程中为新对象生成新的uuid:
import uuid
import copy

class UuidMixin:
    def __new__(cls, *args, **kwargs):
        obj = super().__new__(cls)
        obj.uuid = uuid.uuid4()
        return obj

    def __copy__(self):
        # 创建一个新实例,不调用 __init__
        new_obj = self.__class__.__new__(self.__class__)
        # 复制除了 'uuid' 之外的所有属性
        for key, value in self.__dict__.items():
            if key != 'uuid':
                setattr(new_obj, key, copy.copy(value)) # 浅拷贝其他属性
        # 为新对象生成新的UUID
        new_obj.uuid = uuid.uuid4()
        return new_obj

class Foo(UuidMixin):
    def __init__(self, name):
        self.name = name

f = Foo("original")
print(f"Original Foo (f) UUID: {f.uuid}")

f2 = copy.copy(f)
print(f"Copied Foo (f2) UUID: {f2.uuid}")
print(f"f.uuid == f2.uuid: {f.uuid == f2.uuid}") # 结果为 False,符合预期
print(f"f.name == f2.name: {f.name == f2.name}") # 结果为 True,name属性被正确复制
这种方法虽然解决了UUID的重新初始化问题,但存在以下局限性:
- 继承链的复杂性: 如果子类或更深层的混入类也需要定义__copy__方法,则需要小心处理,确保所有__copy__方法都能正确地协同工作,避免遗漏或重复处理属性。
- 属性管理: 每次添加需要特殊处理的属性时,都必须手动修改__copy__方法中的排除逻辑,这增加了维护成本和出错的可能性。
利用 __getstate__ 控制属性拷贝
Python的copy模块在进行拷贝操作时,会优先查找并使用__reduce__特殊方法。而__getstate__方法正是__reduce__协议的一部分,它允许我们控制对象在序列化(或拷贝)时哪些属性被保存。通过定义__getstate__,我们可以指定在拷贝过程中哪些属性应该被排除,从而间接实现属性的重新初始化。
当copy.copy()被调用时,如果对象定义了__getstate__,copy模块会调用它来获取一个表示对象状态的字典。然后,它会使用这个字典来构建新的对象。因此,我们可以让__getstate__返回一个不包含uuid属性的状态字典:
import uuid
import copy

class UuidMixin:
    def __new__(cls, *args, **kwargs):
        obj = super().__new__(cls)
        obj.uuid = uuid.uuid4()
        return obj

    def __getstate__(self):
        # 获取当前实例的所有属性字典
        state = self.__dict__.copy()
        # 移除 'uuid' 属性,使其不参与拷贝
        if 'uuid' in state:
            del state["uuid"]
        return state

    # 为了让拷贝后的对象能重新初始化uuid,需要一个__setstate__或在__copy__中处理
    # 但由于这里主要展示__getstate__对拷贝协议的影响,我们假设拷贝后会通过某种方式重新生成uuid
    # 实际上,copy.copy()会调用__new__,然后用__getstate__返回的状态更新新对象的__dict__
    # 所以,如果__new__已经生成了uuid,而__getstate__又排除了它,新对象将保留__new__生成的uuid。

class Foo(UuidMixin):
    def __init__(self, name):
        self.name = name

f = Foo("original")
print(f"Original Foo (f) UUID: {f.uuid}")

f2 = copy.copy(f)
print(f"Copied Foo (f2) UUID: {f2.uuid}")
print(f"f.uuid == f2.uuid: {f.uuid == f2.uuid}") # 结果为 False,符合预期
print(f"f.name == f2.name: {f.name == f2.name}") # 结果为 True
在这个UuidMixin的__getstate__实现中,我们显式地从状态字典中移除了uuid属性。当copy.copy(f)被调用时:
- copy模块会先调用Foo.__new__来创建一个新的Foo实例f2。此时,f2已经通过UuidMixin.__new__获得了一个新的UUID。
- 接着,copy模块会调用f.__getstate__()来获取f的状态。由于uuid被移除了,返回的状态字典中不包含uuid。
- 最后,copy模块会用这个不包含uuid的状态字典来更新f2的__dict__。因为状态字典中没有uuid,f2最初由__new__生成的uuid得以保留,而其他属性则被正确复制。
这种方法相对于__copy__而言,在处理属性排除方面更为简洁和健壮,尤其是在复杂的继承体系中。
__getstate__ 在拷贝与序列化协议中的双重角色
然而,__getstate__方法的应用并非没有副作用。Python的拷贝协议(copy模块)和序列化协议(pickle模块)在底层是紧密耦合的,它们都依赖于__reduce__方法,而__getstate__正是__reduce__协议的一部分。这意味着,当你在__getstate__中排除某个属性以影响copy.copy()的行为时,相同的逻辑也会作用于pickle.dump()和pickle.load()。
这种耦合导致了一个核心问题:我们可能希望在浅拷贝时不复制UUID(而是重新生成),但在序列化和反序列化时,我们通常希望UUID能够被完整地保存和恢复。例如,将一个对象序列化到磁盘,然后再反序列化回来,我们期望它拥有与序列化前相同的UUID。
import uuid
import copy
import pickle

class UuidMixin:
    def __new__(cls, *args, **kwargs):
        obj = super().__new__(cls)
        obj.uuid = uuid.uuid4()
        return obj

    def __getstate__(self):
        state = self.__dict__.copy()
        if 'uuid' in state:
            del state["uuid"] # 移除uuid,影响拷贝和Pickle
        return state

class Foo(UuidMixin):
    def __init__(self, name):
        self.name = name

f = Foo("original")
print(f"Original Foo (f) UUID: {f.uuid}")

# 序列化并反序列化
pickled_f = pickle.dumps(f)
f_unpickled = pickle.loads(pickled_f)

print(f"Unpickled Foo (f_unpickled) UUID: {f_unpickled.uuid}")
# 预期:f.uuid == f_unpickled.uuid,但实际结果可能是 False
# 因为f_unpickled的uuid是由其__new__方法在反序列化时重新生成的
# 且由于__getstate__排除了uuid,pickle不会保存f的原始uuid

# 实际测试结果:f_unpickled.uuid 是一个新生成的 UUID,而不是 f 的原始 UUID
# 这与序列化/反序列化的预期行为(保持状态一致性)相悖。
print(f"f.uuid == f_unpickled.uuid: {f.uuid == f_unpickled.uuid}")
在这个例子中,由于__getstate__移除了uuid,当对象被pickle序列化时,uuid不会被保存。反序列化时,Foo.__new__会为新对象f_unpickled生成一个新的UUID,导致其UUID与原始对象f的UUID不一致。这违反了序列化协议通常旨在保持对象状态一致性的原则。
解耦策略的思考与权衡
从上述分析可以看出,__getstate__在拷贝和序列化协议中的双重角色导致了“单一职责原则”的冲突。为了解决这个问题,我们需要考虑如何在不影响序列化行为的前提下,实现拷贝时属性的重新初始化。
自定义 __reduce__ 方法:__reduce__方法是Python对象序列化和拷贝协议的核心。它返回一个元组,描述如何序列化和反序列化对象。我们可以重写__reduce__来区分是拷贝操作还是Pickle操作,并据此返回不同的状态。然而,直接在__reduce__中区分调用者(copy或pickle)是复杂的,通常需要检查调用栈,这种方法不够优雅且容易出错。
显式 clone() 方法: 最直接且最不侵入协议的方式是放弃依赖copy.copy()来重新初始化属性,而是提供一个显式的clone()方法。这个方法可以封装自定义的拷贝逻辑,包括属性的重新初始化。
import uuid
import copy
import pickle

class UuidMixin:
    def __new__(cls, *args, **kwargs):
        obj = super().__new__(cls)
        obj.uuid = uuid.uuid4()
        return obj

    # 移除 __getstate__ 以确保 Pickle 正常工作
    # def __getstate__(self):
    #    state = self.__dict__.copy()
    #    if 'uuid' in state:
    #        del state["uuid"]
    #    return state

    def clone(self):
        # 创建一个新实例
        new_obj = self.__class__.__new__(self.__class__)
        # 浅拷贝除了 'uuid' 之外的所有属性
        for key, value in self.__dict__.items():
            if key != 'uuid':
                setattr(new_obj, key, copy.copy(value))
        # 为新对象生成新的UUID (UuidMixin.__new__ 已经做了)
        # new_obj.uuid = uuid.uuid4() # 如果UuidMixin.__new__没有自动生成,这里需要
        return new_obj

class Foo(UuidMixin):
    def __init__(self, name):
        self.name = name

f = Foo("original")
print(f"Original Foo (f) UUID: {f.uuid}")

# 使用 clone 方法进行拷贝
f2 = f.clone()
print(f"Cloned Foo (f2) UUID: {f2.uuid}")
print(f"f.uuid == f2.uuid: {f.uuid == f2.uuid}") # False,符合预期

# 序列化并反序列化 (现在没有__getstate__干扰,uuid应该被正确保存)
pickled_f = pickle.dumps(f)
f_unpickled = pickle.loads(pickled_f)

print(f"Unpickled Foo (f_unpickled) UUID: {f_unpickled.uuid}")
print(f"f.uuid == f_unpickled.uuid: {f.uuid == f_unpickled.uuid}") # True,符合预期
这种方法将拷贝时属性重置的逻辑与Python内置的copy和pickle协议解耦,提供了最大的灵活性和可预测性。缺点是使用者需要明确调用clone()而不是copy.copy()。
结合 __copy__ 和 __getstate__: 如果确实需要支持copy.copy(),并且又要处理Pickle,可以考虑在__copy__中手动处理uuid的重新生成,同时保持__getstate__的默认行为(即不排除uuid),或者在__getstate__中根据某种上下文判断是否排除uuid(但如前所述,判断上下文是困难的)。这种方法会使代码变得复杂。
总结与建议
在Python中处理对象浅拷贝时特定属性的重新初始化是一个常见的需求,尤其是对于需要唯一标识符的属性。
- __copy__ 方法可以直接控制浅拷贝行为,但可能在继承和属性管理上带来复杂性。
- __getstate__ 方法提供了一种简洁的方式来控制哪些属性参与拷贝(和序列化),但其与Pickle协议的耦合是主要的挑战,可能导致序列化行为不符合预期。
鉴于Python拷贝协议与Pickle协议的紧密耦合,如果对拷贝时属性重置和序列化时属性保留都有严格要求,最健壮和可维护的解决方案是:
- 避免在 __getstate__ 中排除需要序列化的属性。 确保pickle模块能够正确地保存和恢复对象的所有状态。
- 提供一个显式的 clone() 方法来处理需要重新初始化的属性。这种方法将拷贝逻辑与内置协议解耦,使得代码意图清晰,且不易受协议底层实现变化的影响。
通过这种方式,我们可以在享受Python灵活性的同时,确保对象在不同场景下的行为符合预期,避免因协议耦合而产生的意外问题。

GitHub合并故障中的“已缓解并监控”和“已解决”不能互换。前者表示影响已经采取措施缓解,仍在观察稳定性;后者是供应商正式结束这场事故的状态。11月13日的Pull Requests合并超时事件先进入监控,随后于北京时间11月14日02:29标记为已解决。
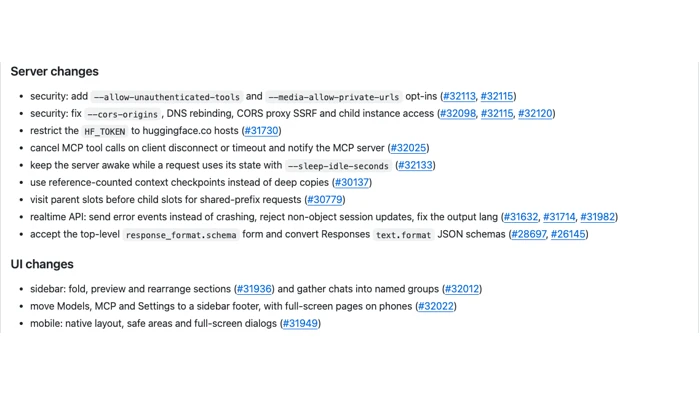
llama.cpp v1.0.0改善聊天组织、长消息编辑和附件预览;界面变化与底层API迁移、缓存及访问边界需要分别理解。
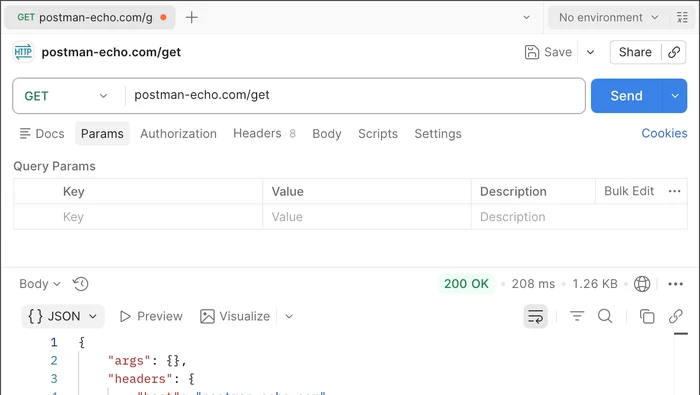
Postman 12.36.4 更新后仍有异常时,可按应用、API请求和平台服务区分问题范围,避免把补丁版本当作故障原因。
按正式、预发布和1.x维护渠道对应补丁,再结合Redis、Agent端点和Pinecone索引判断适用范围。
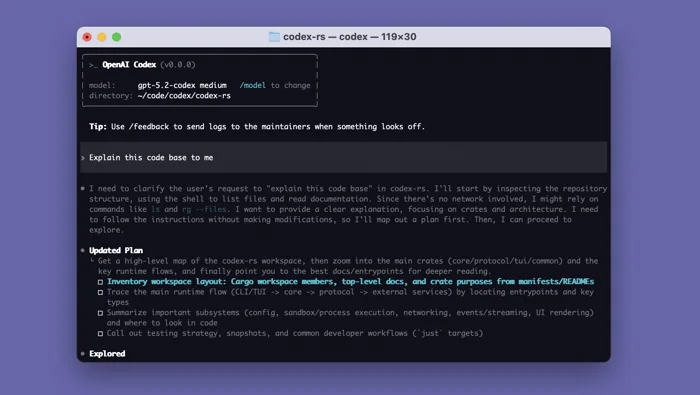
Codex CLI 0.169.0提供有明确说明的终端工作区能力;0.171.0-alpha.2为预发布,当前没有功能清单,选用时应分开评估。
llama.cpp b12345的预发布构建为Hexagon HTP后端增加Q5_0和Q5_1支持。选择模型时需要核对完整量化名称及实际运行后端,不能只看到“Q5”就视为同一种格式。
llama.cpp b12344的预发布构建调整了MCP工具调用的取消行为:客户端断连或调用超时时,服务器会向MCP服务发送带请求ID的取消通知。使用服务端工具的Web界面也属于这项变更范围。
GitHub对11月5日Actions与Checks事件的新增复盘指出:数据库服务在高并发大读请求下耗尽资源,导致部分运行无法排队或执行失败。检查类似问题时,先比对平台事件时间与失败状态,再决定是否重试自己的工作流。
GitHub对11月9日Actions事件的新增复盘说明:数据库迁移后,新区域容量与速率限制不足导致请求被拒,部分运行在服务恢复后仍占用并发。排查自己的工作流时,应把平台状态、运行状态与应用代码错误分开核对。
llama.cpp b12342新增面向少列矩阵计算的CUDA量化内核,覆盖2至24个src1列等场景,例如推测解码的验证阶段。新增内核针对Ampere及更新的NVIDIA GPU,并限定于发行说明列出的量化类型;它不是所有硬件与模型都会得到相同收益的通用开关。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



