

Python 多行文本按关键词查找行教程
本教程将指导您如何使用Python在多行文本文件中高效查找并处理包含特定关键词的行。通过逐行读取文件内容并利用字符串的in运算符进行条件判断,您可以轻松定位所需信息,无需复杂的索引机制,实现精准的数据筛选与输出。

本教程将指导您如何使用 Python 在多行文本文件中高效查找并处理包含特定关键词的行。通过逐行读取文件内容并利用字符串的 `in` 运算符进行条件判断,您可以轻松定位所需信息,无需复杂的索引机制,实现精准的数据筛选与输出。
理解文件读取与关键词查找
在处理文本文件时,一个常见的需求是根据文件内容中的特定关键词来筛选或提取相关行。Python 提供了简洁而强大的机制来实现这一目标。其核心思想是利用文件对象的可迭代性,逐行读取文件内容,并对每一行进行关键词匹配。
- 文件对象的可迭代性:在 Python 中,当你打开一个文件并获得一个文件对象时,这个对象是可迭代的。这意味着你可以直接在 for 循环中使用它,每次迭代都会返回文件中的一行内容(通常包含行尾的换行符 \n)。
- in 运算符的妙用:Python 的字符串类型支持 in 运算符,可以方便地检查一个子字符串是否存在于另一个字符串中。例如,'World' in 'Hello, World!' 将返回 True。结合文件逐行读取,这成为查找关键词的理想工具。
核心实现:逐行查找示例
以下是一个具体的 Python 代码示例,演示如何在一个多行文本文件中查找并打印包含特定关键词的行。
import os

def find_lines_with_keyword(filepath, keyword):
    """
    在指定文件中查找并打印包含特定关键词的行。

    参数:
    filepath (str): 目标文本文件的路径。
    keyword (str): 要查找的关键词。
    """
    try:
        # 使用 with 语句确保文件被正确关闭
        with open(filepath, 'r', encoding='utf-8') as file_object:
            print(f"正在文件中查找关键词 '{keyword}' 的行:")
            found_any = False
            for line_num, line in enumerate(file_object, 1):
                # 使用 strip() 移除行首尾的空白字符,包括换行符
                cleaned_line = line.strip()
                if keyword in cleaned_line:
                    print(f"第 {line_num} 行: {cleaned_line}")
                    found_any = True
            if not found_any:
                print(f"文件中未找到关键词 '{keyword}'。")
    except FileNotFoundError:
        print(f"错误:文件 '{filepath}' 未找到。请检查文件路径。")
    except Exception as e:
        print(f"读取文件时发生错误:{e}")

# 示例用法
# 1. 创建一个示例文件
file_content = """Hello, World!
MrBeast is rich.
:3 avg valorant player
Another line with World in it.
"""
example_filepath = "text.txt"
with open(example_filepath, 'w', encoding='utf-8') as f:
    f.write(file_content)

# 2. 调用函数查找关键词
find_lines_with_keyword(example_filepath, "World")

# 3. 查找不存在的关键词
print("\n--- 查找不存在的关键词 ---")
find_lines_with_keyword(example_filepath, "Python")

# 4. 清理示例文件
# os.remove(example_filepath) # 如果不需要保留文件,可以取消注释此行
代码解析:
- import os: 导入 os 模块,虽然在此核心功能中不是必须,但在处理文件路径或清理文件时可能会用到。
- find_lines_with_keyword(filepath, keyword) 函数:
- 封装了查找逻辑,提高了代码的复用性和可读性。
- 文件路径的指定 (filepath): filepath 变量用于存储目标文件的路径。
- 相对路径: 如果文件与 Python 脚本在同一目录下,可以直接使用文件名,如 "text.txt"。
- 绝对路径: 如果文件位于其他位置,需要提供完整路径,例如在 Windows 上可能是 "C:\\Users\\YourUser\\Desktop\\text.txt"(注意反斜杠需要转义或使用原始字符串 r"C:\..."),在 Linux/macOS 上可能是 "/home/YourUser/documents/text.txt"。
- 安全的文件操作 (with open(...)): with open(filepath, 'r', encoding='utf-8') as file_object: 是 Python 中处理文件的推荐方式。
- 'r' 表示以只读模式打开文件。
- encoding='utf-8' 指定文件编码,这对于处理包含非 ASCII 字符的文本文件至关重要,可以避免乱码问题。
- as file_object 将打开的文件句柄赋值给 file_object 变量。
- with 语句确保无论代码块中是否发生错误,文件都会在离开该代码块时自动关闭,有效管理资源。
- 遍历文件内容 (for line_num, line in enumerate(file_object, 1):):
- enumerate(file_object, 1) 用于同时获取行号和行内容。1 表示行号从 1 开始计数。
- 循环每次迭代,line 变量将获取文件中的一行文本,包括行末的换行符 \n。
- 关键词判断与输出 (if keyword in cleaned_line:):
- cleaned_line = line.strip(): strip() 方法用于移除字符串两端的空白字符,包括空格、制表符和换行符。这样做可以确保关键词匹配不会受到行首尾空白字符的影响,并使输出更整洁。
- if keyword in cleaned_line: 检查当前行是否包含指定的关键词。
- 如果找到关键词,则打印该行的行号和内容。
- 错误处理 (try...except): 捕获 FileNotFoundError 和其他潜在的 Exception,提供友好的错误提示。
进阶应用与注意事项
在实际应用中,你可能需要对上述基础方法进行一些扩展和优化。
大小写不敏感搜索: 如果希望忽略关键词的大小写进行匹配,可以将行内容和关键词都转换为小写(或大写)再进行比较。
# ... 在 for 循环内部 ... if keyword.lower() in cleaned_line.lower(): print(f"第 {line_num} 行 (大小写不敏感): {cleaned_line}")处理多个关键词: 如果你需要查找包含多个关键词中的任意一个的行,可以使用逻辑运算符 or。
# ... 在 for 循环内部 ...
keywords_to_find = ["World", "player", "rich"]
if any(k.lower() in cleaned_line.lower() for k in keywords_to_find):
    print(f"第 {line_num} 行 (多关键词): {cleaned_line}")
或者更直接地:
if "World" in cleaned_line or "player" in cleaned_line: print(f"第 {line_num} 行 (多关键词): {cleaned_line}")存储匹配结果而非直接打印: 在某些场景下,你可能需要收集所有匹配的行,而不是立即打印它们。可以将匹配到的行添加到列表中。
matched_lines = [] # ... 在 for 循环内部 ... if keyword in cleaned_line: matched_lines.append(cleaned_line) # 或者 line (包含换行符) # 循环结束后 # return matched_lines文件编码与空行处理:
- 编码: 始终建议在 open() 函数中明确指定 encoding 参数,特别是当文件可能包含非 ASCII 字符时。'utf-8' 是最常用的通用编码。
- 空行: line.strip() 可以有效处理行首尾的空白,但如果希望跳过完全为空的行,可以在匹配前添加一个条件:if cleaned_line and keyword in cleaned_line:。
路径格式与操作系统差异:
- Windows: 路径分隔符是反斜杠 \。为了避免与转义字符混淆,建议使用原始字符串(在路径前加 r),例如 r"C:\Users\Desktop\file.txt",或者使用正斜杠 /,Python 在 Windows 上也能识别,例如 "C:/Users/Desktop/file.txt"。
- Linux/macOS: 路径分隔符是正斜杠 /,例如 "/home/user/documents/file.txt"。
- 为了更好的跨平台兼容性,可以使用 os.path.join() 来构建文件路径,它会根据当前操作系统自动选择正确的分隔符。
总结
通过本教程,您应该已经掌握了使用 Python 在多行文本文件中高效查找包含特定关键词的行的基本方法。这种逐行读取并使用 in 运算符进行字符串匹配的策略,不仅代码简洁,而且对于处理大型文件也非常高效,因为它不会一次性将整个文件加载到内存中。结合错误处理、大小写不敏感搜索和结果存储等进阶技巧,您可以灵活应对各种文件内容筛选需求。

GitHub合并故障中的“已缓解并监控”和“已解决”不能互换。前者表示影响已经采取措施缓解,仍在观察稳定性;后者是供应商正式结束这场事故的状态。11月13日的Pull Requests合并超时事件先进入监控,随后于北京时间11月14日02:29标记为已解决。
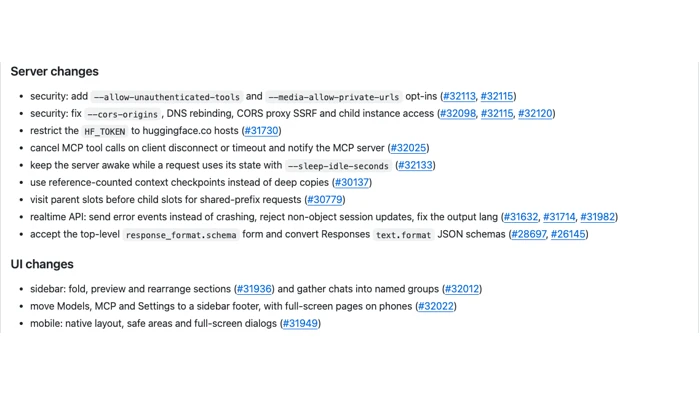
llama.cpp v1.0.0改善聊天组织、长消息编辑和附件预览;界面变化与底层API迁移、缓存及访问边界需要分别理解。
Postman 12.36.4 更新后仍有异常时,可按应用、API请求和平台服务区分问题范围,避免把补丁版本当作故障原因。
按正式、预发布和1.x维护渠道对应补丁,再结合Redis、Agent端点和Pinecone索引判断适用范围。
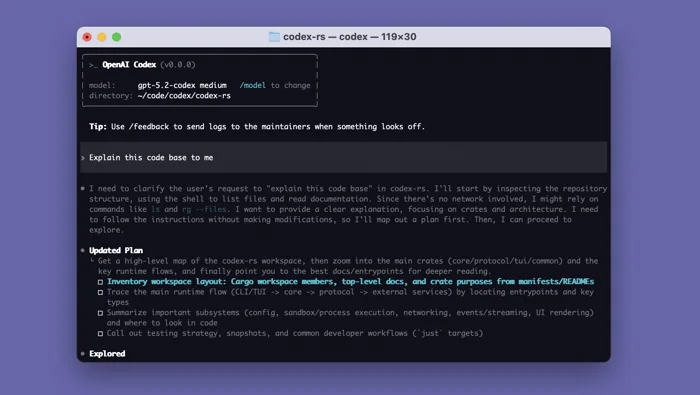
Codex CLI 0.169.0提供有明确说明的终端工作区能力;0.171.0-alpha.2为预发布,当前没有功能清单,选用时应分开评估。
llama.cpp b12345的预发布构建为Hexagon HTP后端增加Q5_0和Q5_1支持。选择模型时需要核对完整量化名称及实际运行后端,不能只看到“Q5”就视为同一种格式。
llama.cpp b12344的预发布构建调整了MCP工具调用的取消行为:客户端断连或调用超时时,服务器会向MCP服务发送带请求ID的取消通知。使用服务端工具的Web界面也属于这项变更范围。
GitHub对11月5日Actions与Checks事件的新增复盘指出:数据库服务在高并发大读请求下耗尽资源,导致部分运行无法排队或执行失败。检查类似问题时,先比对平台事件时间与失败状态,再决定是否重试自己的工作流。
GitHub对11月9日Actions事件的新增复盘说明:数据库迁移后,新区域容量与速率限制不足导致请求被拒,部分运行在服务恢复后仍占用并发。排查自己的工作流时,应把平台状态、运行状态与应用代码错误分开核对。
llama.cpp b12342新增面向少列矩阵计算的CUDA量化内核,覆盖2至24个src1列等场景,例如推测解码的验证阶段。新增内核针对Ampere及更新的NVIDIA GPU,并限定于发行说明列出的量化类型;它不是所有硬件与模型都会得到相同收益的通用开关。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



