

重新表达的标题为:字节跳动与华东师大的合作:探索小模型的上下文学习能力
众所周知,大型语言模型(LLM)可以通过上下文学习的方式从少量示例中学习,无需进行模型微调。目前,这种上下文学习现象只能在大型模型中观察到。例如,像GPT-4、Llama等大型模型在许多领域中都表现出了卓越的性能,但由于资源限制或实时性要求较高,许多场景无法使用大型模型那么,常规大小的模型是否具备这种能力呢?为了探索小模型的上下文学习能力,字节和华东师大的研究团队在场景文本识别任务上进行了研究。目前,在实际应用场景中,场景文本识别面临着多种挑战:不同的场景、文字排版、形变、光照变化、字迹模糊、字体多样性等
众所周知,大型语言模型(LLM)可以通过上下文学习的方式从少量示例中学习,无需进行模型微调。目前,这种上下文学习现象只能在大型模型中观察到。例如,像GPT-4、Llama等大型模型在许多领域中都表现出了卓越的性能,但由于资源限制或实时性要求较高,许多场景无法使用大型模型
那么,常规大小的模型是否具备这种能力呢?为了探索小模型的上下文学习能力,字节和华东师大的研究团队在场景文本识别任务上进行了研究。
目前,在实际应用场景中,场景文本识别面临着多种挑战:不同的场景、文字排版、形变、光照变化、字迹模糊、字体多样性等,因此很难训练一个能应对所有场景的统一的文本识别模型。
解决该问题的一个直接方法是收集相应的数据,并在具体场景中微调模型。然而,这个过程需要重新训练模型,计算量很大,并且需要保存多个模型权重以适应不同的场景。如果文本识别模型能够具备上下文学习能力,在面对新场景时,只需要少量标注数据作为提示,就能提升在新场景上的性能,从而解决上述问题。然而,场景文本识别是一个资源敏感型任务,将大模型作为文本识别器会消耗大量资源。通过初步的实验观察,研究人员发现传统的大模型训练方法并不适用于场景文本识别任务
为了解决这个问题,来自字节跳动和华东师大的研究团队提出了自进化文本识别器,E2STR(Ego-Evolving Scene Text Recognizer)。这是一个融合了上下文学习能力的常规大小的文本识别器,能够快速适应不同的文本识别场景,而无需微调
论文链接:https://arxiv.org/pdf/2311.13120.pdf
E2STR 配备了一种上下文训练和上下文推理模式,不仅在常规数据集上达到了 SOTA 的水平,而且可以使用单一模型提升在各个场景中的识别性能,实现对新场景的快速适应,甚至超过了经过微调后专用模型的识别性能。E2STR 证明,常规大小的模型足以在文本识别任务中实现有效的上下文学习能力。
方法
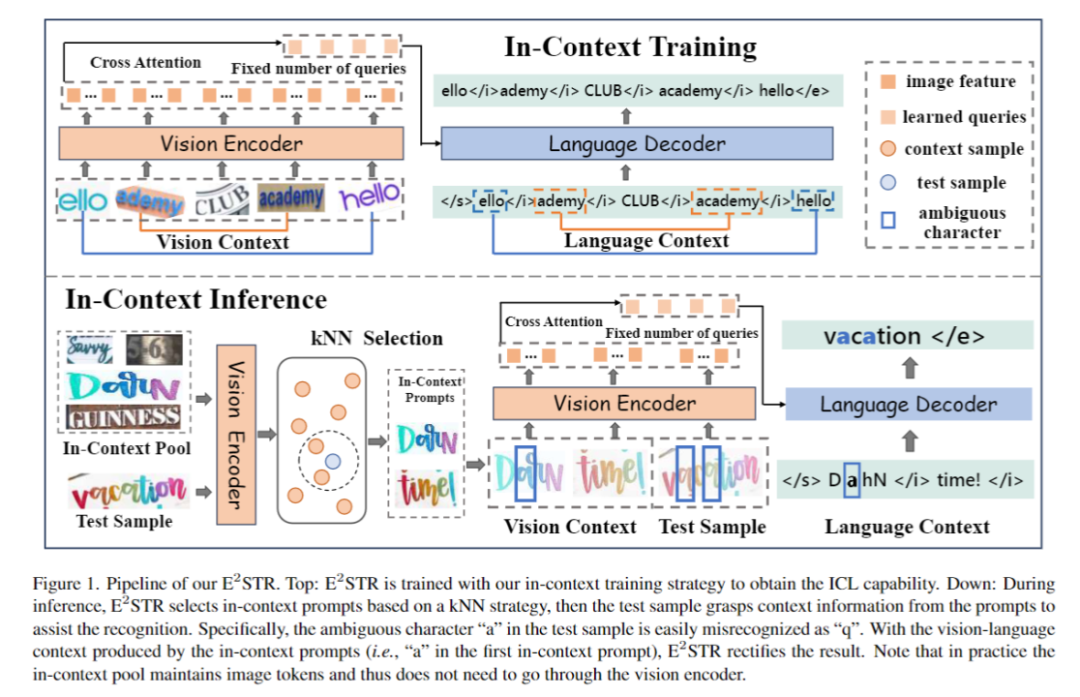
在图1中,展示了E2STR的训练和推理过程
1. 基础文本识别训练
基础文本识别训练阶段采用自回归框架训练视觉编码器和语言解码器,目的为了获取文本识别能力:
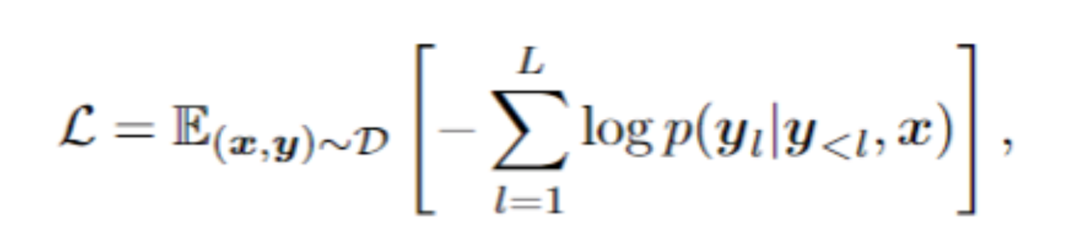
2. 上下文训练
上下文训练阶段 E2STR 将根据文中提出的上下文训练范式进行进一步训练。在这一阶段,E2STR 会学习理解不同样本之间的联系,从而从上下文提示中获取推理能力。
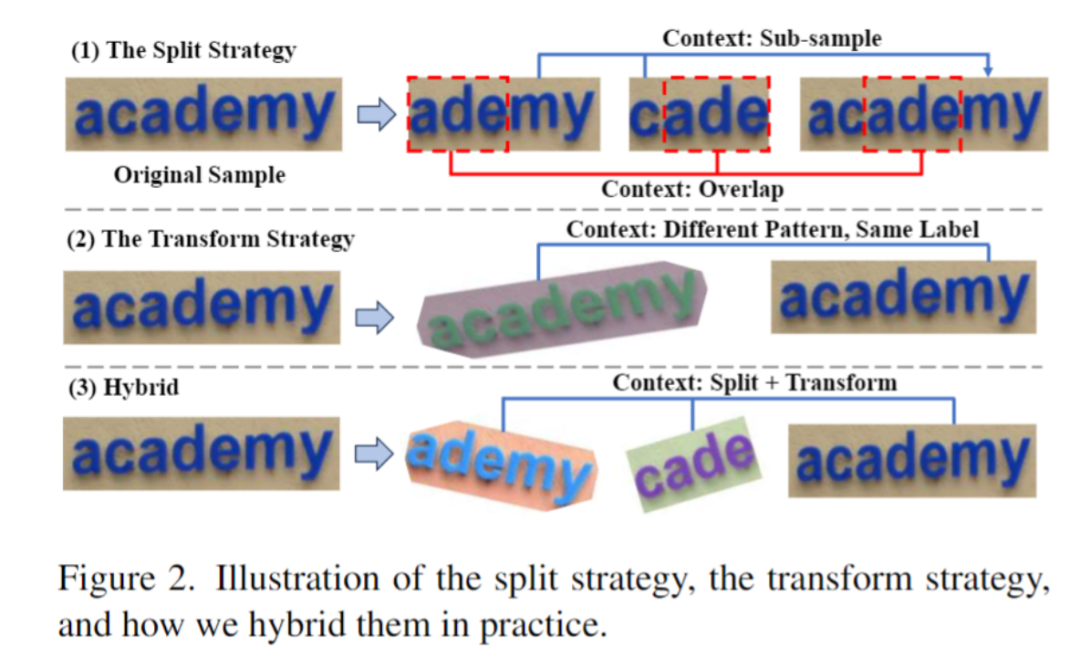
如图 2 所示,这篇文章提出 ST 策略,在场景文本数据中进行随机的分割和转换,从而生成一组 "子样本"。子样本在视觉和语言方面都是内在联系的。这些内在联系的样本被拼接成一个序列,模型从这些语义丰富的序列中学习上下文知识,从而获取上下文学习的能力。这一阶段同样采用自回归框架进行训练:
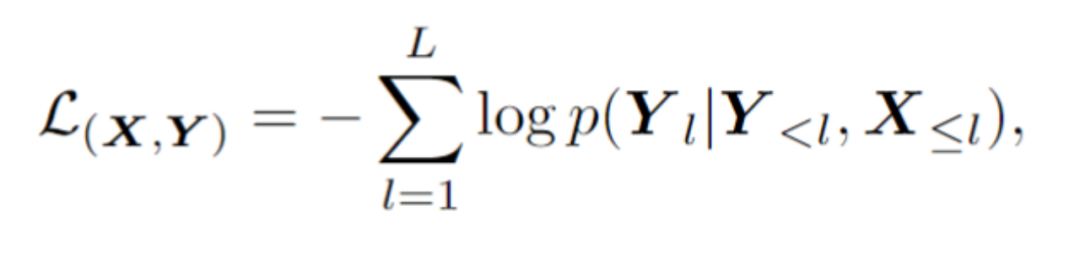
需要进行改写的内容是:3. 上下文推理 改写后的内容:3. 根据上下文进行推理
针对一个测试样本,该框架会从上下文提示池中选择 N 个样本,这些样本在视觉隐空间与测试样本具有最高的相似度。具体来说,这篇文章通过对视觉 token 序列做平均池化,计算出图像 embedding I 。然后,从上下文池中选择图像嵌入与 I 的余弦相似度最高的前 N 个样本,从而形成上下文提示。
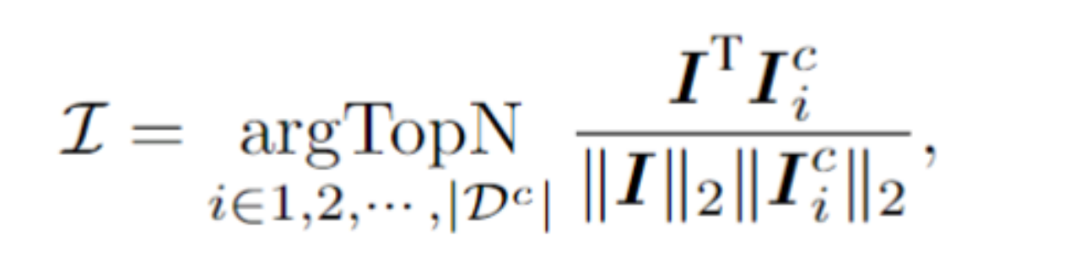
将上下文提示和测试样本拼接在一起送入模型后,E2STR会以无需训练的方式从上下文提示中学习新的知识,从而提高测试样本的识别准确率。需要注意的是,上下文提示池只保留视觉编码器输出的令牌,使得上下文提示的选择过程非常高效。此外,由于上下文提示池很小,并且E2STR无需训练即可进行推理,因此额外的计算开销也被降至最低
实验
实验主要从三个方面进行:分别是传统文本识别集、跨域场景识别和困难样本修正
1. 传统数据集
从训练集中随机抽取很少的样本(1000 个,训练集 0.025% 的样本数量)组成上下文提示池,在 12 个常见的场景文本识别测试集中进行的测试,结果如下:
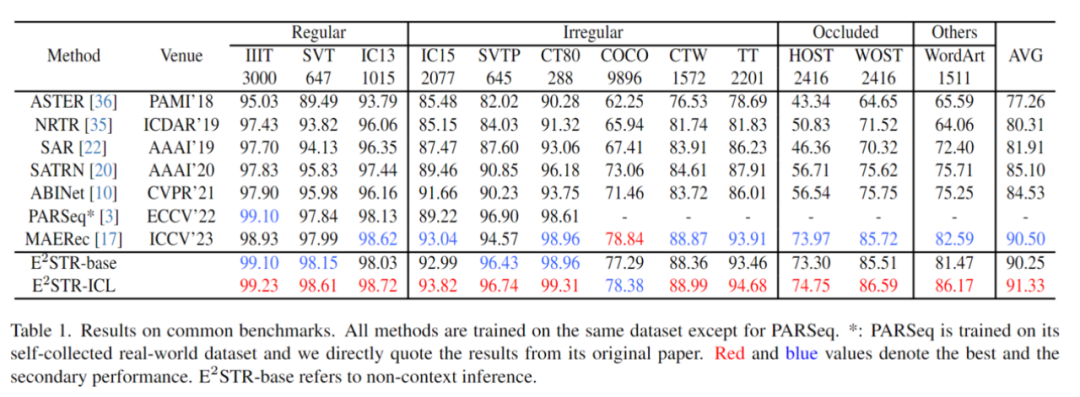
可以发现 E2STR 在识别性能差不多已经饱和的传统数据集上依然有所提升,超越了 SOTA 模型的表现。
需要进行改写的内容是:2. 跨域场景
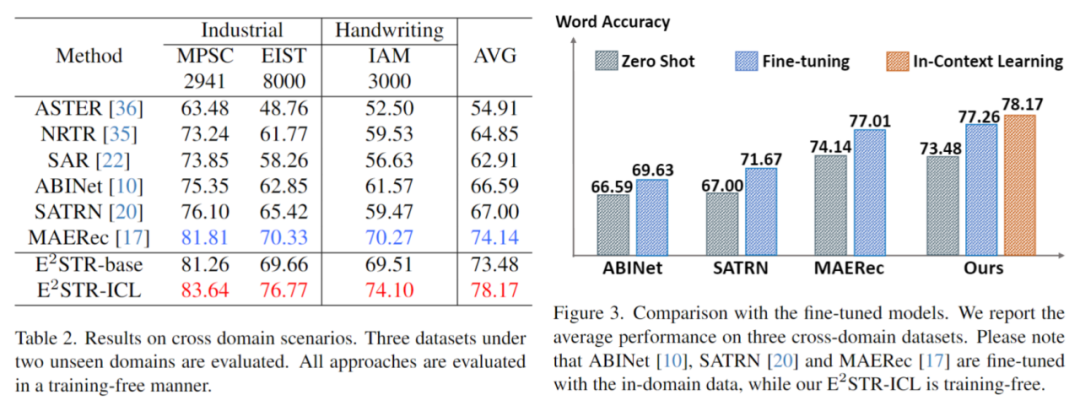
跨域场景下每个测试集仅提供 100 个域内训练样本,无训练和微调对比结果如下,E2STR 甚至超过了 SOTA 方法的微调结果。
需要进行改写的内容是:3. 修改困难样本
研究人员收集了一批困难样本,对这些样本提供了 10%~20% 的标注,对比 E2STR 的无需训练的上下文学习方法和 SOTA 方法的微调学习方法,结果如下:
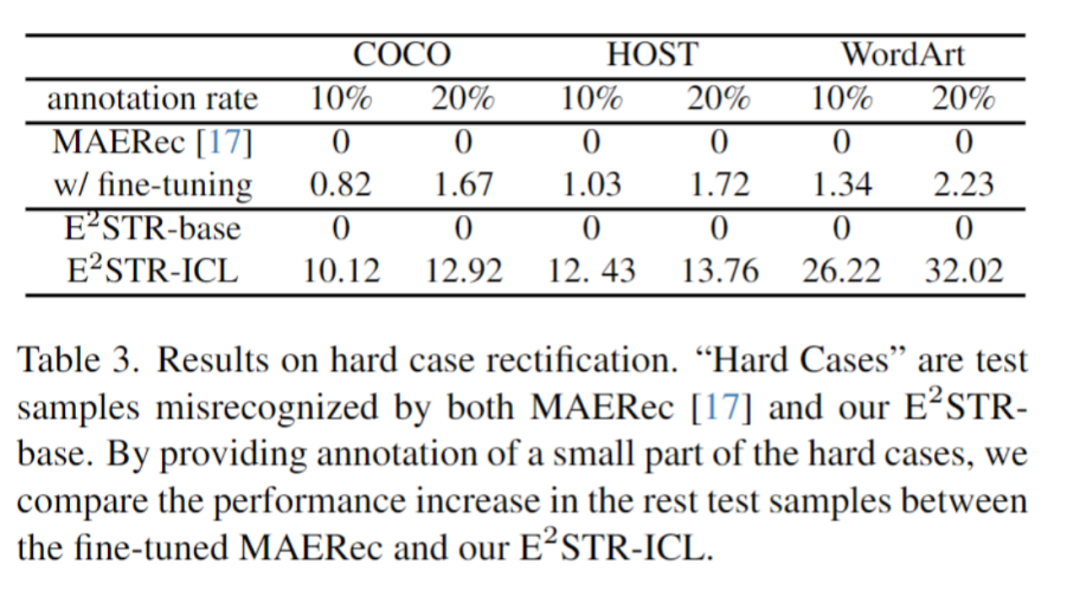
相比微调方法,E2STR-ICL显著降低了困难样本的错误率
未来展望
E2STR 证明了使用合适的训练和推理策略,小模型也可以拥有和 LLM 类似的 In-context Learning 的能力。在一些实时性要求比较强的任务中,使用小模型也可以对新场景进行快速的适应。更重要的是,这种使用单一模型来实现对新场景快速适应的方法使得构建统一高效的小模型更近了一步。
文本 Unicode 码加密与解密:一个简单实用的工具 今天我们来聊聊一种有趣的文本加密方式——Unicode码加密与解密。这个工具利用Unescape脚本的转换机制,能够将普通文本转换成看似乱码的Unicode编码,实现信息的隐藏与保护。 主要用途 这个工具的应用场景其实相当广泛: 加密中文信函,
在处理文本时,有时我们需要根据某个条件或模式,把文件里特定几行标记出来——比如给满足条件的行打个星号。这个活儿用 awk 做起来相当顺手,也是它很实用的功能之一。 举个例子,假设你有一个购物清单文件 food_prices.list,里面列出了想买的食物和单价,内容长这样: $ cat food_p

5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
现在,请大家一起来数一下"1"、"2"。OK,仅仅2秒的时间,一个接近万亿规模的MoE大模型就已经掌握了如何解答一道高等数学难题的方法!而且呢,这个大模型还是完全依靠国产设备进行训练的,整个流程都体现了浓浓的“国产”特色。这就是华为借助"昇腾+PanguUltraMoE"这一组合实现的成果——不仅达成了国产算力与国产模型在全流程上的自主可控训练闭环,还在集群训练系统的性能方面达到了行业顶尖水平。有多顶尖?来看一组数据:预训练阶段:昇腾Atlas800TA2万卡集群的MFU提升
只需动动嘴,就能操控GUI代理?由美团与浙江大学联合推出的GUIRoboTron-Speech——让你彻底解放双手,直接对设备“发号施令”。这是首个可以直接通过语音指令和屏幕截图进行端到端(End-to-End)决策的自主GUI智能体,致力于为用户提供更自然、高效且无障碍的人机交互方式。从文本到语音,智能代理的新一轮进化目前,基于大语言模型(LLMs)的自主GUI智能体已经能够通过文本指令自动完成跨应用、多步骤的复杂操作,显著提升用户效率。然而,这种依赖文本输入的方式在某些场景中存在明显局限
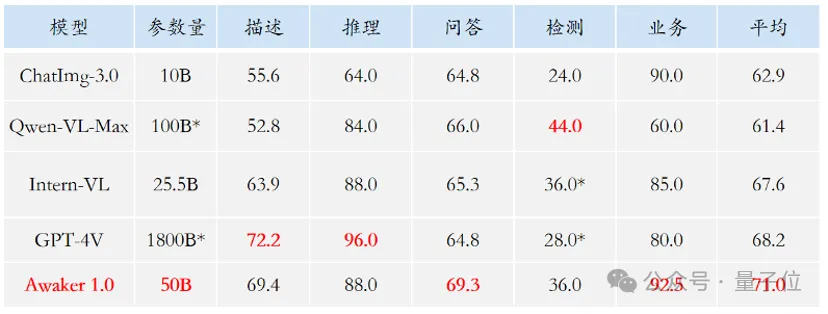
哭死啊,全球狂炼大模型,一互联网的数据不够用,根本不够用。训练模型搞得跟《饥饿游戏》似的,全球AI研究者,都在苦恼怎么才能喂饱这群数据大胃王。尤其在多模态任务中,这一问题尤为突出。一筹莫展之际,来自人大系的初创团队,用自家的新模型,率先在国内把“模型生成数据自己喂自己”变成了现实。而且还是理解侧和生成侧双管齐下,两侧都能生成高质量、多模态的新数据,对模型本身进行数据反哺。模型是啥?中关村论坛上刚刚露面的多模态大模型Awaker1.0。团队是谁?智子引擎。由人大高瓴人工智能学院博士生高一钊创立,高瓴人工智能
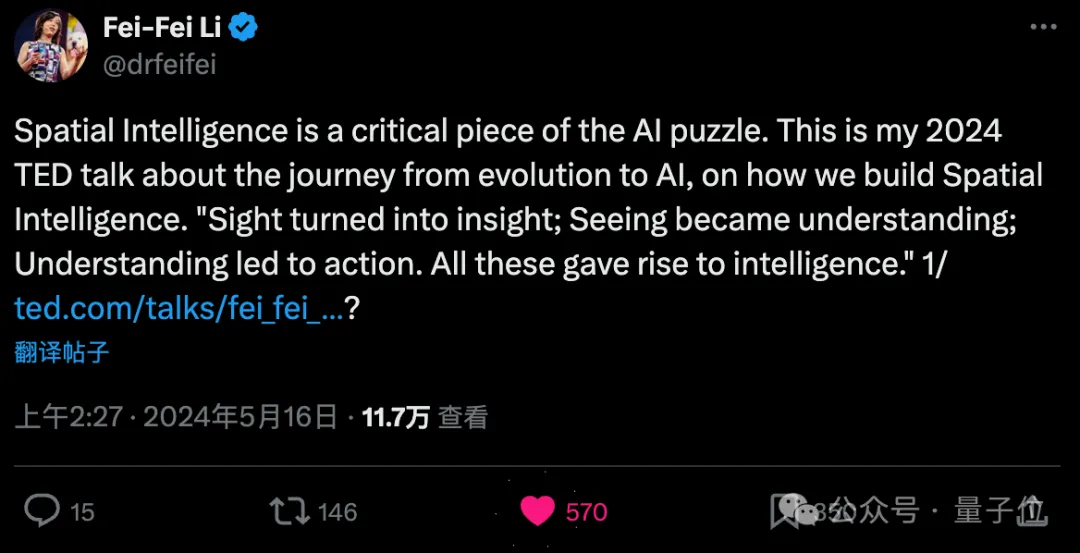
斯坦福李飞飞创业后,首次揭秘新概念“空间智能”。这不仅是她的创业方向,也是指引她的“北极星”,被她认为是“解决人工智能难题的关键拼图”。视觉化为洞察;看见成为理解;理解导致行动。在李飞飞15分钟TED演讲完整公开的基础上,从数亿年前生命进化的起源开始,到人类如何不满足于自然赋予而发展人工智能,直到下一步如何构建空间智能。9年前,李飞飞在同一个舞台上,向世界介绍了刚诞生不久的ImageNet——这一轮深度学习爆发的起点之一。她本人也向网友自我安利:如果把两个视频都看了,你就能对过去10年的计算机视觉、空间智
本文将向您介绍如何在Excel单元格中创建新的文本行。在Excel中,文本行是以文本形式显示在电子表格中的内容块。这些内容可以涵盖姓名、数字、电子邮件地址等信息。为什么要在Excel单元格中开始新的文本行?在Excel中创建新的文本行不仅可以提高电子表格的整洁度和视觉吸引力,还可以更好地组织数据并使其更易于理解。这种分行方法可以使文本内容更清晰地呈现在单元格中,有助于减少混乱和提高数据的可读性。此外,适当的文本分行还可以帮助用户快速浏览和比较不同单元格中的信息,从而提高工增强可读性更有效地组织信息避免单元
在机器人学习方面,一种常用方法是收集针对特定机器人和任务的数据集,然后用其来训练策略。但是,如果使用这种方法来从头开始学习,每一个任务都需要收集足够数据,并且所得策略的泛化能力通常也不佳。“原理上讲,从其他机器人和任务收集的经验能提供可能的解决方案,能让模型看到多种多样的机器人控制问题,而这些问题也许能提升机器人在下游任务上的泛化能力和性能。但是,即便现在已经出现了能处理多种自然语言和计算机视觉任务的通用模型,构建『通用机器人模型』依然困难重重。”要让机器人训练一个统一的控制策略非常困难,其中包括涉及诸多





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



