

Python屏蔽subprocess输出方法
在Python中屏蔽subprocess调用的命令输出,最直接且推荐的方法是使用subprocess.run函数并将stdout和stderr参数设置为subprocess.DEVNULL以彻底丢弃输出,或设置为subprocess.PIPE以捕获输出而不打印;若需彻底屏蔽所有输出,必须同时处理stdout和stderr,否则可能因忽略stderr或子进程衍生进程未重定向而导致输出仍显示在控制台,最终应根据实际需求选择丢弃、捕获或重定向到文件或日志系统的方式完成操作。
在 Python 中屏蔽 subprocess 调用的命令输出,最直接且推荐的方法是使用 subprocess.run 函数并将 stdout 和 stderr 参数设置为 subprocess.DEVNULL 以彻底丢弃输出,或设置为 subprocess.PIPE 以捕获输出而不打印;若需彻底屏蔽所有输出,必须同时处理 stdout 和 stderr,否则可能因忽略 stderr 或子进程衍生进程未重定向而导致输出仍显示在控制台,最终应根据实际需求选择丢弃、捕获或重定向到文件或日志系统的方式完成操作。
在 Python 中,要屏蔽 subprocess 调用的命令输出,最直接且推荐的方法是利用 subprocess.run 函数的 stdout 和 stderr 参数,将它们设置为 subprocess.DEVNULL 来彻底丢弃输出,或者设置为 subprocess.PIPE 来捕获输出但不打印到控制台。选择哪种方式,取决于你是想让这些信息“消失”,还是想在后台默默收集起来以备后用。
解决方案
处理 subprocess 输出,尤其是想要屏蔽它们,现代 Python 推荐使用 subprocess.run()。这个函数简化了与子进程的交互,并且提供了非常直观的参数来控制标准输出(stdout)和标准错误(stderr)。
核心思想是控制子进程的 I/O 流。当你运行一个外部命令时,它通常会将其正常输出写入到标准输出流,错误或诊断信息写入到标准错误流。Python 的 subprocess 模块允许你重定向这些流。
1. 彻底屏蔽输出(丢弃):
如果你根本不关心子进程的输出,也不想存储它,最简单有效的方式就是将 stdout 和 stderr 都指向 subprocess.DEVNULL。这就像把子进程的喊话筒直接对着一个黑洞,所有的声音都消失了。
import subprocess
import sys # 导入sys是为了演示DEVNULL

# 假设有一个会输出到stdout的命令
# 例如:'echo Hello World' 或 'ls -l'
try:
    # 彻底屏蔽stdout和stderr
    result = subprocess.run(
        ['echo', 'Hello World from stdout and stderr!'],
        stdout=subprocess.DEVNULL,
        stderr=subprocess.DEVNULL,
        check=True, # 检查命令是否成功执行,非零退出码会抛出CalledProcessError
        shell=True # 在Windows上,echo通常需要shell=True
    )
    print("命令执行完毕,输出已被屏蔽。")
except subprocess.CalledProcessError as e:
    print(f"命令执行失败,错误码:{e.returncode}")
    # 注意:如果屏蔽了stderr,这里可能看不到原始错误信息
    # 除非你在DEVNULL之前捕获了它
except FileNotFoundError:
    print("命令未找到,请检查路径或拼写。")

print("-" * 30)

# 另一个例子:一个可能产生stderr的命令
# 例如:'ls non_existent_file' (Linux/macOS) 或 'dir non_existent_file' (Windows)
try:
    # 仅屏蔽stderr,stdout保持默认(打印到控制台)
    result = subprocess.run(
        ['ls', 'non_existent_file'], # 假设这个命令会报错
        stdout=None, # None表示使用默认的stdout(通常是父进程的stdout)
        stderr=subprocess.DEVNULL,
        check=False # 这里不检查,以便我们能看到返回码
    )
    print(f"命令执行完毕,返回码:{result.returncode},stderr已被屏蔽。")
except Exception as e:
    print(f"发生异常:{e}")
2. 捕获输出但不打印(存储):
有时候,你可能不想让输出直接显示在屏幕上,但又希望能在 Python 代码中获取到这些输出,以便后续处理、分析或记录日志。这时,你可以将 stdout 和 stderr 设置为 subprocess.PIPE。这意味着子进程的输出会被重定向到一个“管道”,Python 可以通过这个管道读取数据。
import subprocess

try:
    # 捕获stdout和stderr
    result = subprocess.run(
        ['ls', '-l', '/tmp'], # 假设/tmp存在且有内容
        stdout=subprocess.PIPE,
        stderr=subprocess.PIPE,
        text=True, # 将输出解码为文本(默认UTF-8)
        check=True,
        shell=False # 通常不建议shell=True,除非必要
    )
    print("命令执行成功。")
    print("捕获到的标准输出:")
    print(result.stdout)
    print("捕获到的标准错误(如果存在):")
    print(result.stderr) # 通常这里是空的,除非命令本身有错误输出
except subprocess.CalledProcessError as e:
    print(f"命令执行失败,错误码:{e.returncode}")
    print("捕获到的标准输出:")
    print(e.stdout) # 错误时,输出可能在异常对象中
    print("捕获到的标准错误:")
    print(e.stderr)
except FileNotFoundError:
    print("命令未找到,请检查路径或拼写。")
text=True 是一个非常方便的参数,它告诉 subprocess 模块自动将字节流解码为字符串。如果不设置,result.stdout 和 result.stderr 将会是字节串(bytes 类型),你需要手动 decode()。
在我的日常工作中,subprocess.DEVNULL 和 subprocess.PIPE 是我用得最多的两个选项。前者适用于那些“我只关心它是否成功运行,不关心它说了什么”的场景,比如执行一个清理脚本;后者则常用于需要解析命令输出的自动化任务,比如获取某个工具的版本号,或者解析 git log 的结果。选择哪一个,完全取决于你的具体需求和对信息的处理方式。
处理 subprocess 输出时常见的误区有哪些?
在与 subprocess 模块打交道时,我发现有些坑是大家,包括我自己,都可能不小心踩到的。理解这些误区,能帮助我们更稳健地构建自动化脚本。
一个很常见的误区是忽略 stderr。很多时候,我们只关注 stdout,觉得只要没有正常输出,就万事大吉。然而,许多命令行工具,尤其是在遇到问题时,会把错误信息输出到 stderr。如果你只屏蔽或捕获了 stdout,那么错误信息依然会一股脑儿地打印到你的控制台,或者更糟的是,你以为命令成功了,但实际上它在 stderr 默默地报错了。我曾因为忽略 stderr 而在调试时走了不少弯路,最后才发现问题出在命令的某个参数不对,而这个错误信息就躺在 stderr 里。所以,无论你是想屏蔽还是捕获,请记住,stdout 和 stderr 最好一起处理。
另一个需要注意的点是处理大型输出。当使用 subprocess.PIPE 来捕获输出时,如果子进程产生了海量的输出,这可能会导致几个问题。首先是内存消耗,所有输出都会被加载到内存中。其次,在某些旧的 Popen 用法中(虽然 run 已经封装得很好),如果管道缓冲区满了,而你又没有及时读取,可能会导致子进程阻塞,甚至死锁。所以,如果预计输出会非常大,而你又不需要完整内容,那么 subprocess.DEVNULL 才是更明智的选择。如果确实需要处理大量输出,可以考虑使用 Popen 配合循环读取,或者直接将输出重定向到文件。
再就是编码问题。在 Python 3 中,subprocess 默认返回的是字节串(bytes)。如果直接打印,你可能会看到 b'...' 这样的形式,或者在处理非 ASCII 字符时遇到 UnicodeDecodeError。虽然 text=True 解决了大部分问题,它默认使用系统默认编码(通常是 UTF-8),但如果子进程的输出编码与此不符(比如某些遗留系统可能使用 GBK),那么还是会出错。这时,你可能需要手动指定 encoding 参数,例如 text=True, encoding='gbk'。我个人在处理跨平台或旧系统交互时,经常会遇到编码问题,这确实是个细致活儿。
最后,关于 shell=True 的使用。虽然它让命令执行变得方便,可以直接传入一个字符串命令,由 shell 来解析。但它也引入了安全风险(命令注入)和平台差异性。例如,在 Windows 上,echo 命令的行为可能与 Linux/macOS 不同,或者某些内置的 shell 命令在 shell=True 下才能正常运行。但如果不是必须,我通常会避免使用 shell=True,而是将命令和参数作为列表传递,这样更安全,也更清晰。
如何将 subprocess 输出重定向到文件或日志?
将 subprocess 的输出重定向到文件或集成到日志系统,是自动化脚本中非常常见的需求。这比简单地屏蔽或捕获到内存中要灵活得多,尤其是在需要长期保存运行记录或进行后续分析时。
重定向到文件:
最直接的方式就是将 stdout 和 stderr 参数设置为一个文件对象。Python 的 open() 函数返回的文件对象可以直接作为 subprocess 的 I/O 目标。
import subprocess
import os

output_file = "command_output.log"
error_file = "command_error.log"

# 确保文件不存在,或以写入模式打开
with open(output_file, 'w') as out_f, open(error_file, 'w') as err_f:
    try:
        # 执行一个命令,将其stdout写入output_file,stderr写入error_file
        result = subprocess.run(
            ['ls', '-l', '/tmp', 'non_existent_dir'], # 假设/tmp存在,non_existent_dir不存在
            stdout=out_f,
            stderr=err_f,
            check=False # 不检查,以便我们能看到错误输出到文件
        )
        print(f"命令执行完毕,输出已重定向到 '{output_file}' 和 '{error_file}'。")
        print(f"命令返回码:{result.returncode}")
    except FileNotFoundError:
        print("命令未找到,请检查路径或拼写。")
    except Exception as e:
        print(f"执行命令时发生异常:{e}")

# 验证文件内容(可选)
if os.path.exists(output_file):
    print(f"\n'{output_file}' 的内容:")
    with open(output_file, 'r') as f:
        print(f.read())

if os.path.exists(error_file):
    print(f"\n'{error_file}' 的内容:")
    with open(error_file, 'r') as f:
        print(f.read())
这里,我们用 with open(...) 语句来确保文件在操作完成后会被正确关闭。这种方式非常适合将命令的详细运行日志保存下来,方便后续排查问题。
集成到日志系统:
如果你已经在使用 Python 的 logging 模块来管理应用程序的日志,你可能希望将 subprocess 的输出也整合进去,而不是单独保存到文件。这通常通过捕获输出(subprocess.PIPE),然后将捕获到的内容作为日志消息来完成。
import subprocess
import logging

# 配置日志
logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(levelname)s - %(message)s')
logger = logging.getLogger(__name__)

try:
    # 捕获stdout和stderr
    result = subprocess.run(
        ['ping', '-c', '3', 'google.com'], # Linux/macOS ping,Windows用'ping -n 3 google.com'
        stdout=subprocess.PIPE,
        stderr=subprocess.PIPE,
        text=True,
        check=True
    )
    logger.info("命令执行成功。")
    if result.stdout:
        logger.info("标准输出:\n" + result.stdout.strip())
    if result.stderr:
        logger.warning("标准错误:\n" + result.stderr.strip()) # 错误通常用WARNING或ERROR级别
except subprocess.CalledProcessError as e:
    logger.error(f"命令执行失败,返回码:{e.returncode}")
    if e.stdout:
        logger.error("标准输出(失败时):\n" + e.stdout.strip())
    if e.stderr:
        logger.error("标准错误(失败时):\n" + e.stderr.strip())
except FileNotFoundError:
    logger.error("命令未找到,请检查路径或拼写。")
except Exception as e:
    logger.exception("执行命令时发生意外异常。") # exception会自动记录详细的栈信息
将 subprocess 的输出集成到日志系统,使得所有的应用程序事件都集中管理,无论是正常运行的信息,还是潜在的错误和警告,都能在同一个地方进行查看和分析。这对于构建健壮的、可维护的自动化工具来说,简直是必备技能。我个人在部署自动化服务时,总是会确保所有的外部命令输出都能被日志系统捕获,这样在出问题时,才能有迹可循。
为什么我屏蔽了 subprocess 输出,却仍然看到信息?
这确实是个让人头疼的问题,明明设置了 DEVNULL 或 PIPE,结果控制台还是时不时蹦出一些信息。在我多年的开发经验中,遇到这种情况,通常有以下几个原因,值得我们仔细排查。
1. 仅仅屏蔽了 stdout,忘记了 stderr:
这是最常见的情况。很多程序在正常运行时将信息输出到 stdout,但在遇到警告、错误或诊断信息时,会把它们发送到 stderr。如果你只设置了 stdout=subprocess.DEVNULL,那么 stderr 仍然会默认打印到父进程的控制台。解决办法很简单,同时设置 stderr=subprocess.DEVNULL。
2. 子进程又启动了新的子进程,且新子进程未被重定向:
这是一个比较隐蔽的问题。你启动的命令(父子进程)可能在内部又启动了另一个命令(孙子进程)。如果这个孙子进程没有继承父进程的 I/O 重定向设置,或者它有自己的独立 I/O 逻辑,那么它的输出就可能绕过你的 subprocess 配置,直接打印到你的终端。例如,你运行一个 shell 脚本,脚本内部又调用了另一个程序。这种情况下,你可能需要修改那个 shell 脚本,让它内部的命令也进行输出重定向,或者在调用脚本时,确保整个 shell 环境的输出都被重定向。
3. 命令本身将输出写入了其他文件描述符或特殊设备:
虽然不常见,但某些特殊的程序可能不会将所有输出都写入标准的 stdout 或 stderr。它们可能直接写入 /dev/tty(在类 Unix 系统上)或者其他特定的文件描述符,甚至直接操作控制台 API(在 Windows 上)。这种情况下,subprocess 的标准重定向机制就无能为力了。要诊断这种问题,在 Linux 上可以使用 strace -e write 来跟踪命令写入了哪些文件描述符。在 Windows 上,Process Monitor 这样的工具也能帮助你观察进程的 I/O 活动。
4. shell=True 的副作用:
当你使用 shell=True 时,实际上是启动了一个 shell 进程(如 bash 或 cmd.exe),然后由这个 shell 来执行你的命令。有些 shell 在执行某些操作时,自身可能会产生一些输出,比如命令未找到的错误信息,或者某些内置命令的行为。这些输出可能并非来自你调用的实际程序,而是来自中间的 shell。虽然这种情况不至于完全绕过重定向,但有时会导致一些意料之外的“杂音”。如果不是绝对必要,尽量避免使用 shell=True,或者确保你的命令是列表形式,让 subprocess 直接执行,而不是通过 shell。
5. 调试信息或日志级别设置:
有时,你看到的输出可能不是来自你调用的命令本身,而是来自你的 Python 脚本或者其他库的调试信息。例如,如果你使用了 logging 模块,并且某个库的日志级别设置得比较低,那么即使你的 subprocess 输出了被屏蔽,日志系统依然会打印它自己的信息。这需要你检查你的 Python 代码中的日志配置。
遇到这种情况,我的第一反应通常是检查 stderr 是否也被正确处理了。如果不是,那就补上。如果是,我就会开始怀疑是不是有“孙子进程”在作怪,或者命令本身是不是有什么特别的输出机制。一步步排查,最终总能找到原因。
深入解析在FastAPI框架中实现文件下载接口的完整方案,涵盖基于FileResponse的本地静态文件传输、基于StreamingResponse的分块流式传输、RFC 5987中文文件名编码规范、路径穿越安全防御及BackgroundTasks临时文件清理,并配备详细代码示例与架构解析图。
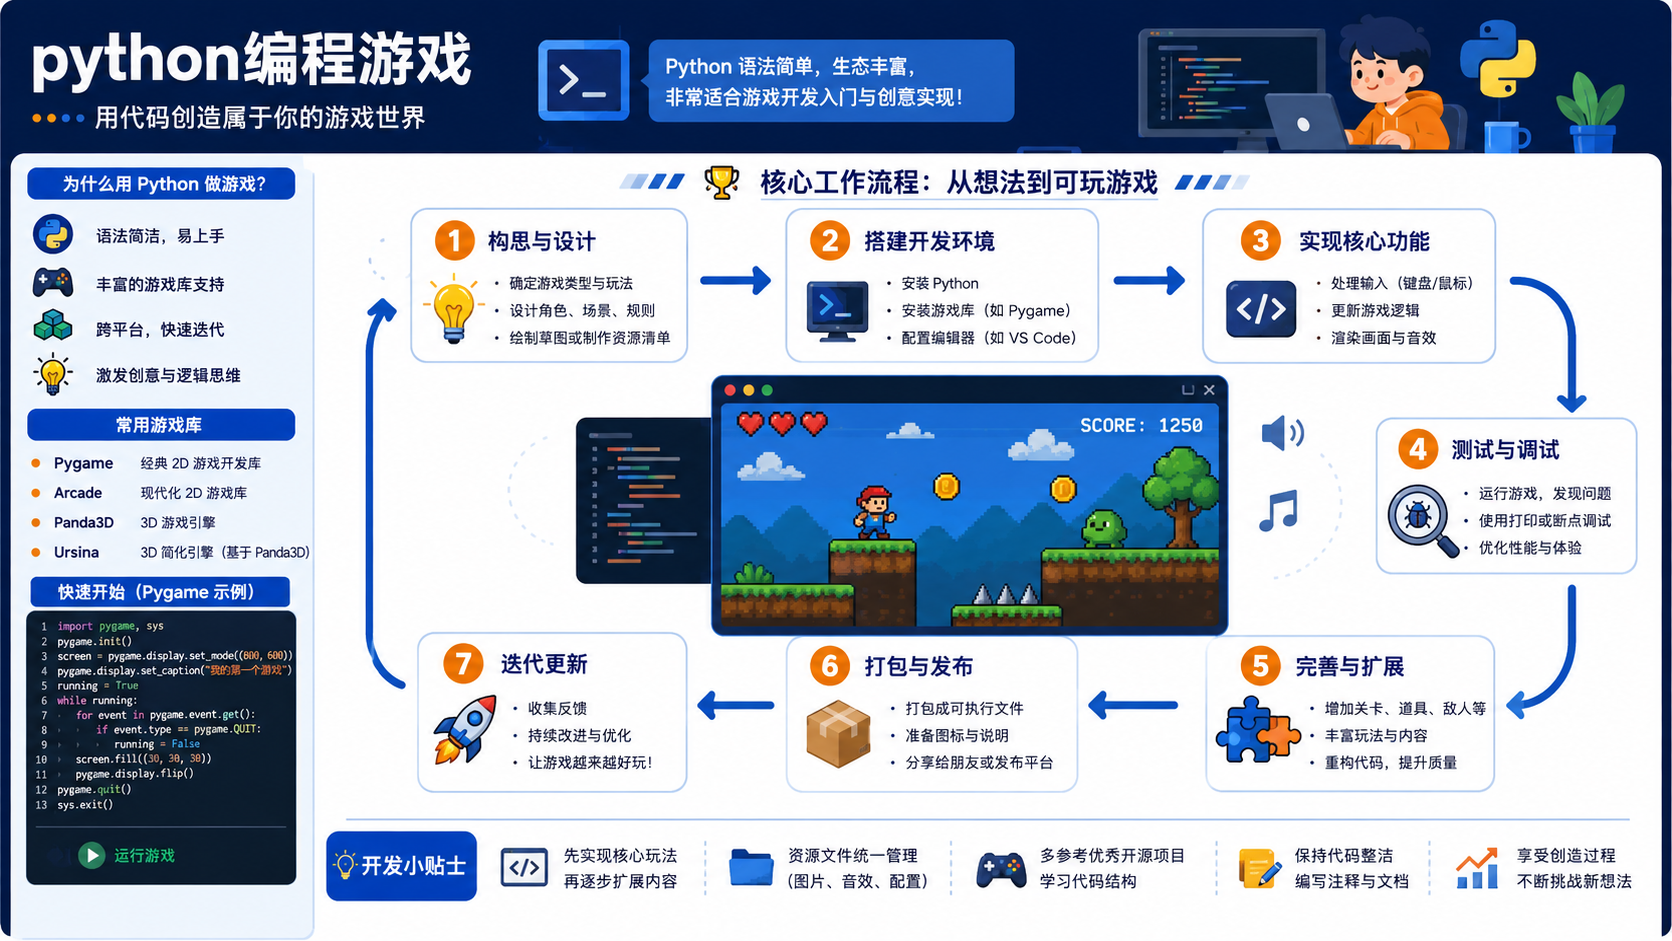
解析 python编程游戏 的核心开发流程,提供基于官方文档的环境准备、依赖安装命令及验证方法,包含清晰的决策图与排错路径,适用于具备基础命令行能力的后端开发者。
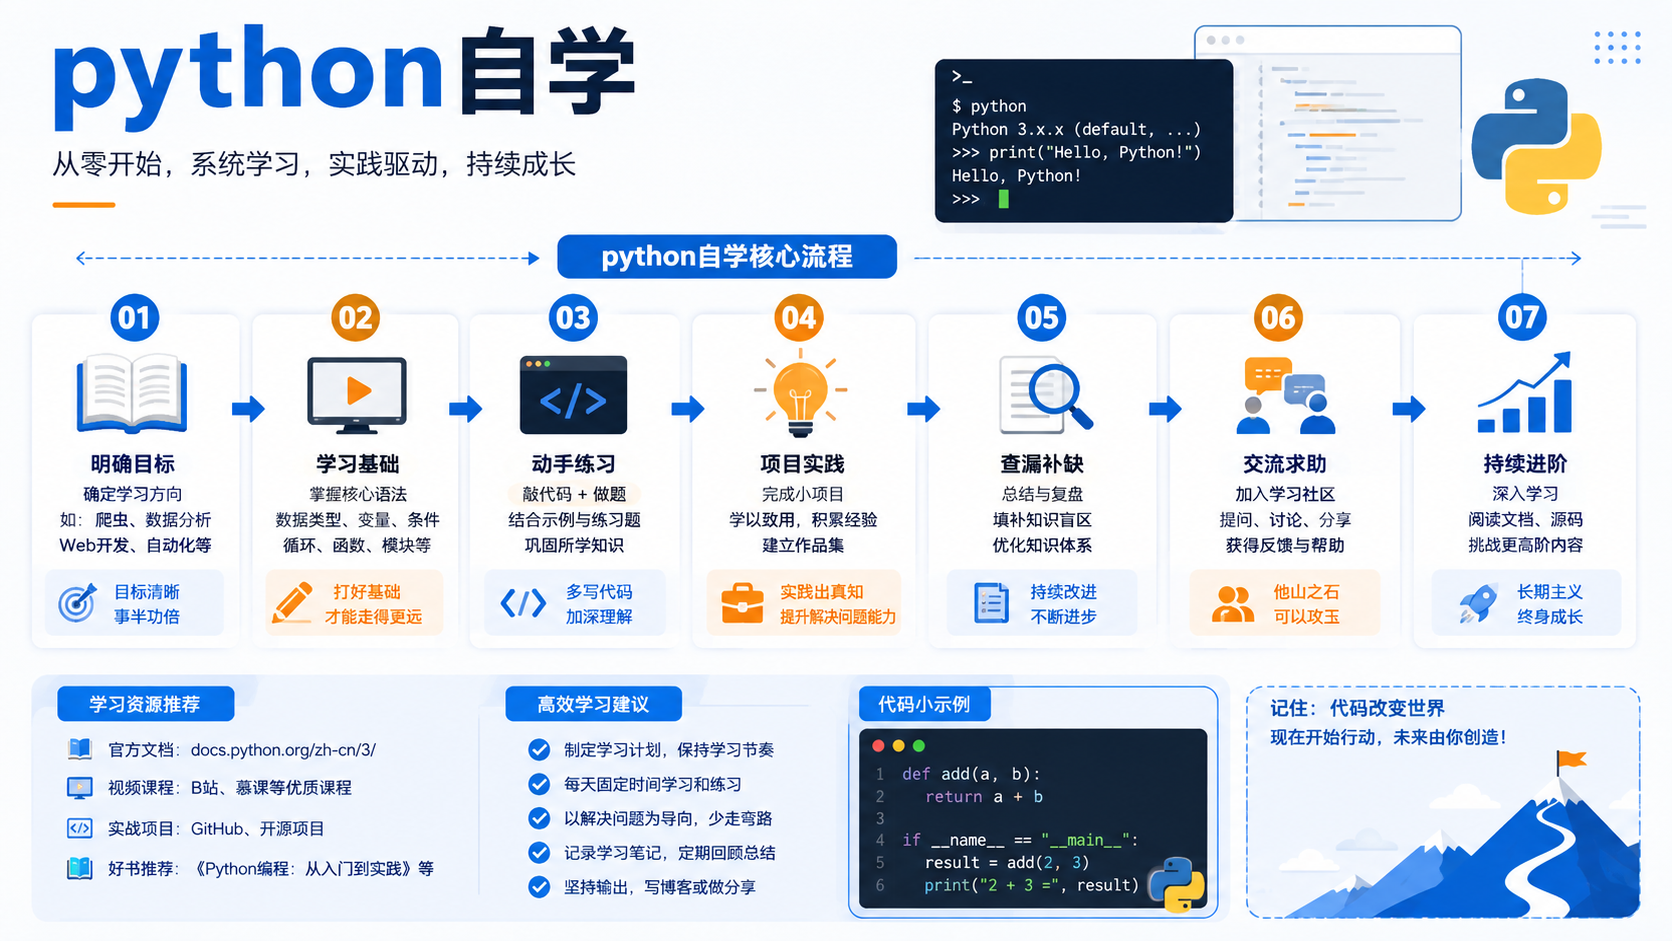
面向后端开发者的 python自学实操指南。涵盖 Python 官方概念界定、虚拟环境创建、依赖安装验证及常见排错路径,提供可执行的 Bash 命令与决策流程图。
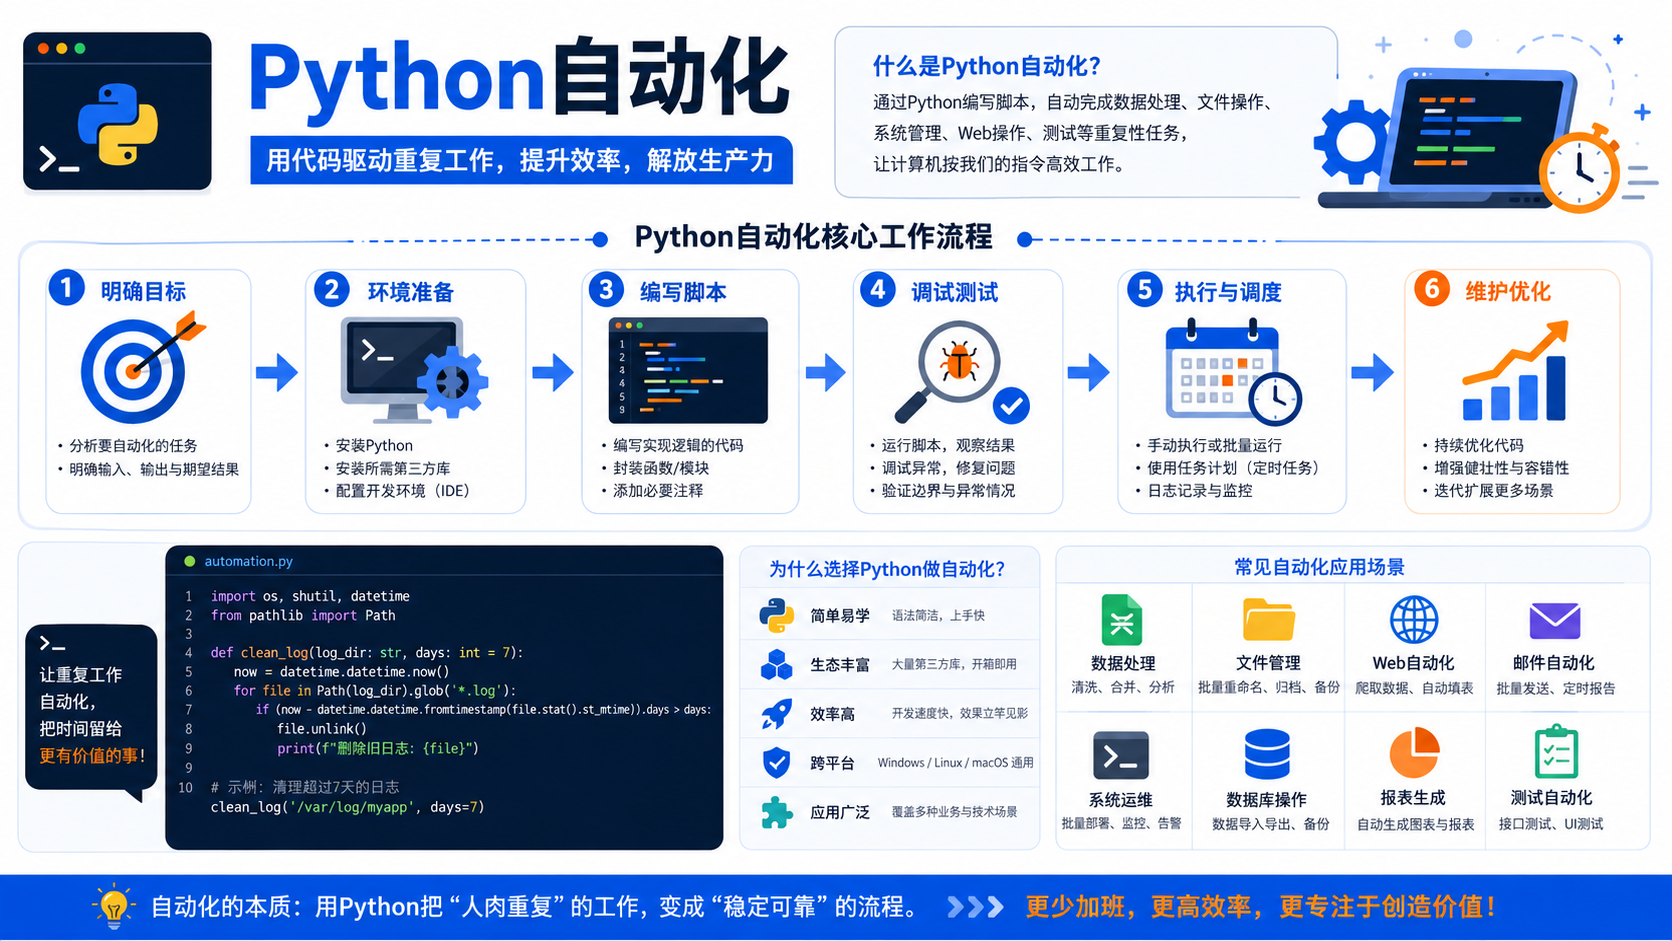
针对后端开发者的 python自动化 入门指南,涵盖 venv 虚拟环境创建、pip 依赖管理及官方文档依据的验证步骤,提供清晰的决策图与排错建议。
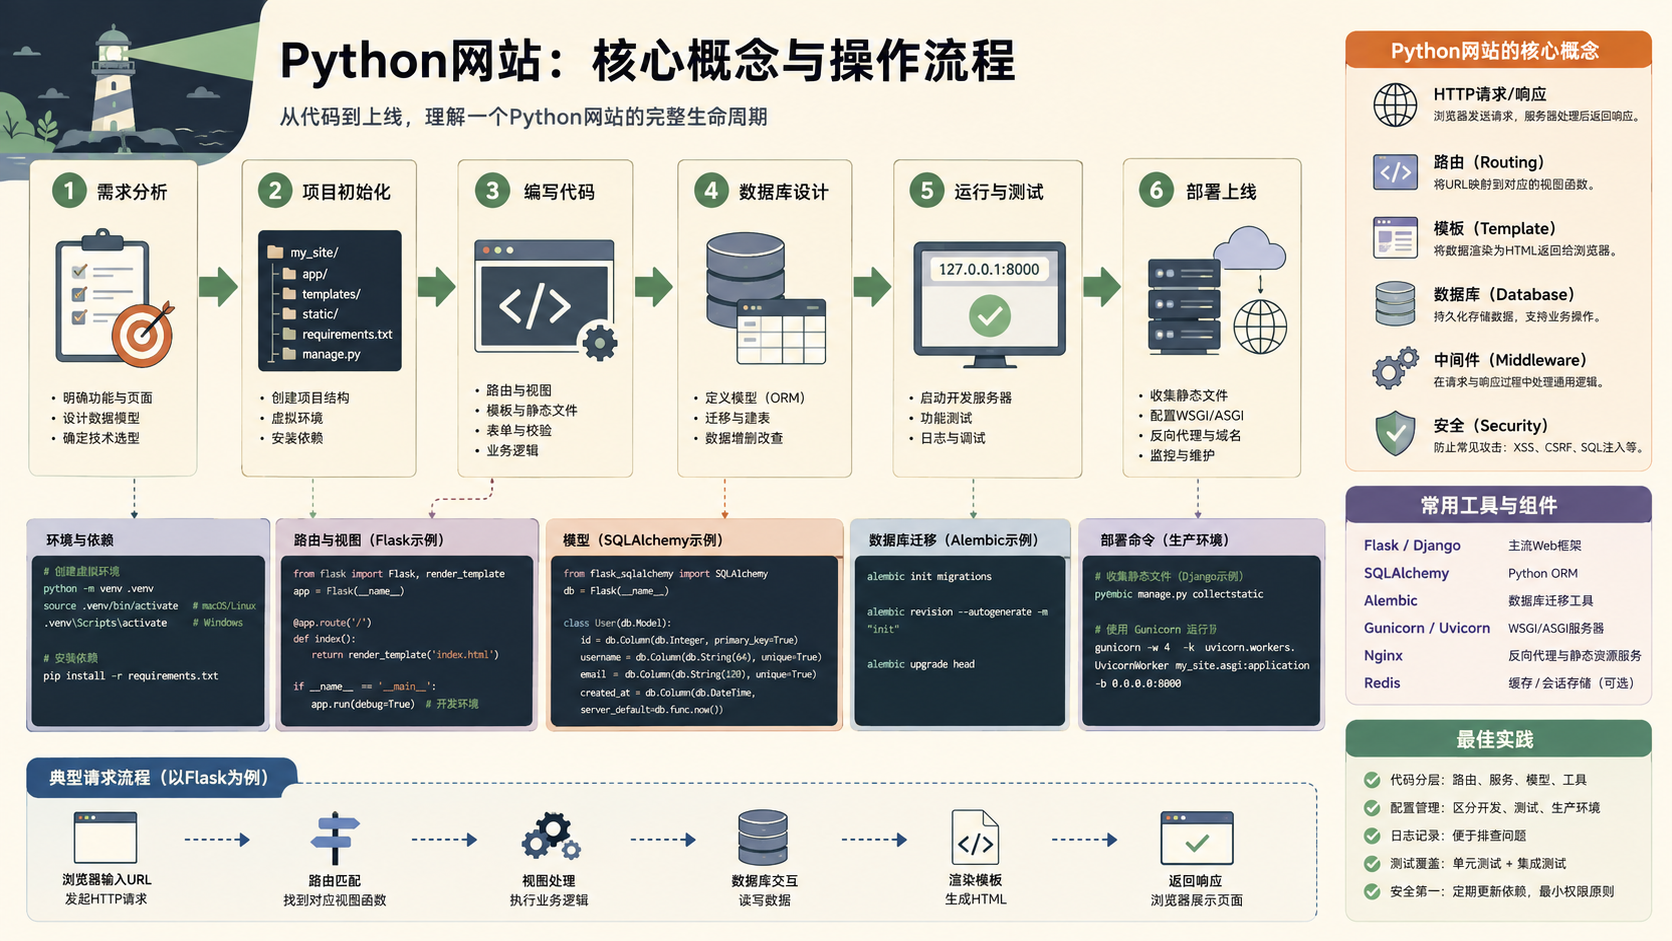
面向后端开发者的 python文档 实操指南。涵盖环境检查、venv创建、pip升级及依赖验证,提供清晰的决策图与命令示例,避免常见配置错误。
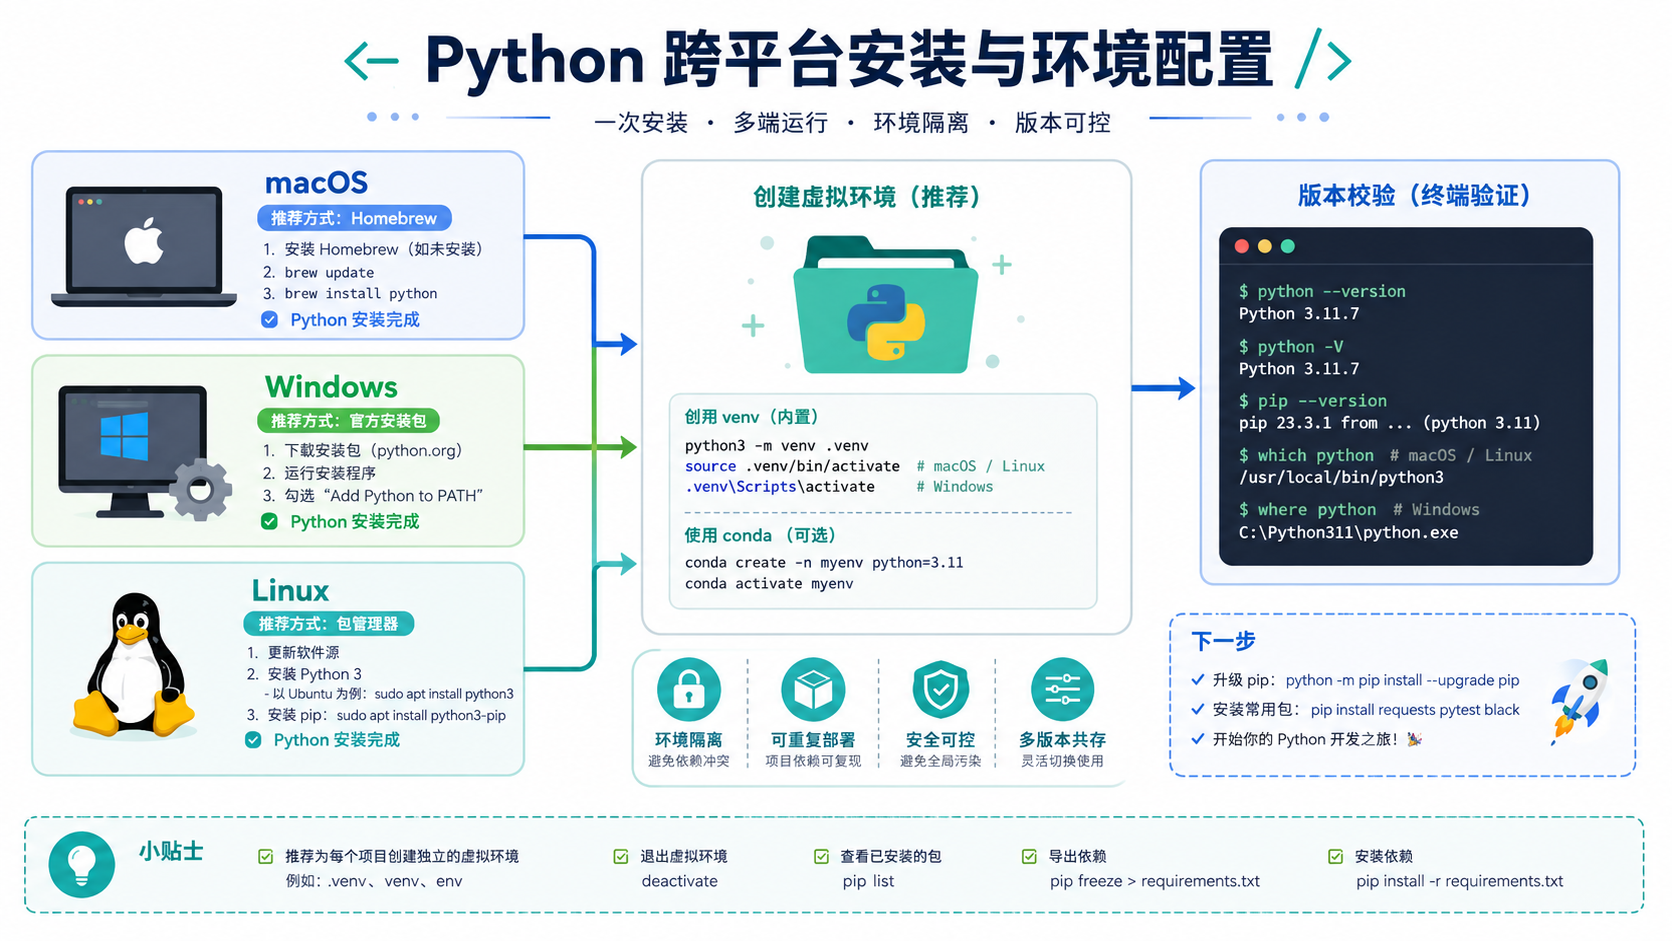
面向后端开发者的 python循环 实操指南。涵盖环境检查、虚拟环境创建、依赖安装及验证步骤,结合官方文档与决策图,确保操作可复现且边界清晰。
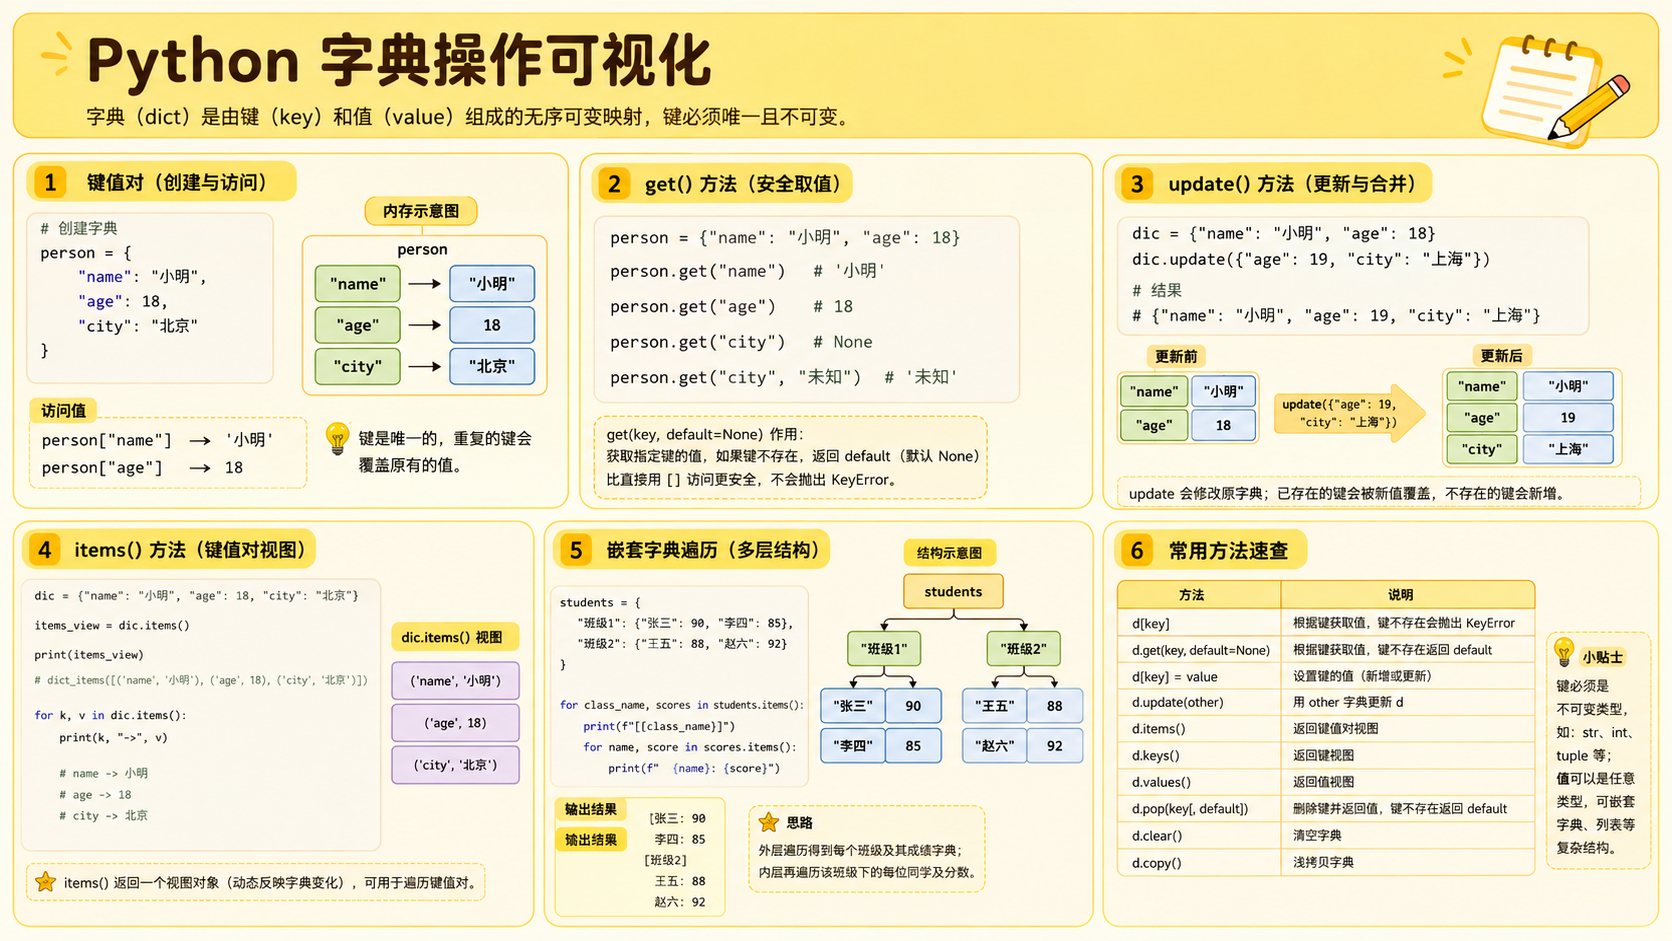
详解 Python 字典的键值访问、遍历与嵌套结构,并提供基于官方文档的 Python 环境搭建、虚拟环境隔离及依赖管理步骤,帮助开发者建立可复现的开发工作流。
针对后端开发者,详解 Python 编程基础的环境搭建、依赖隔离与验证方法。基于官方文档提供可复现命令,明确工具边界,帮助读者建立最小可测试代码闭环。
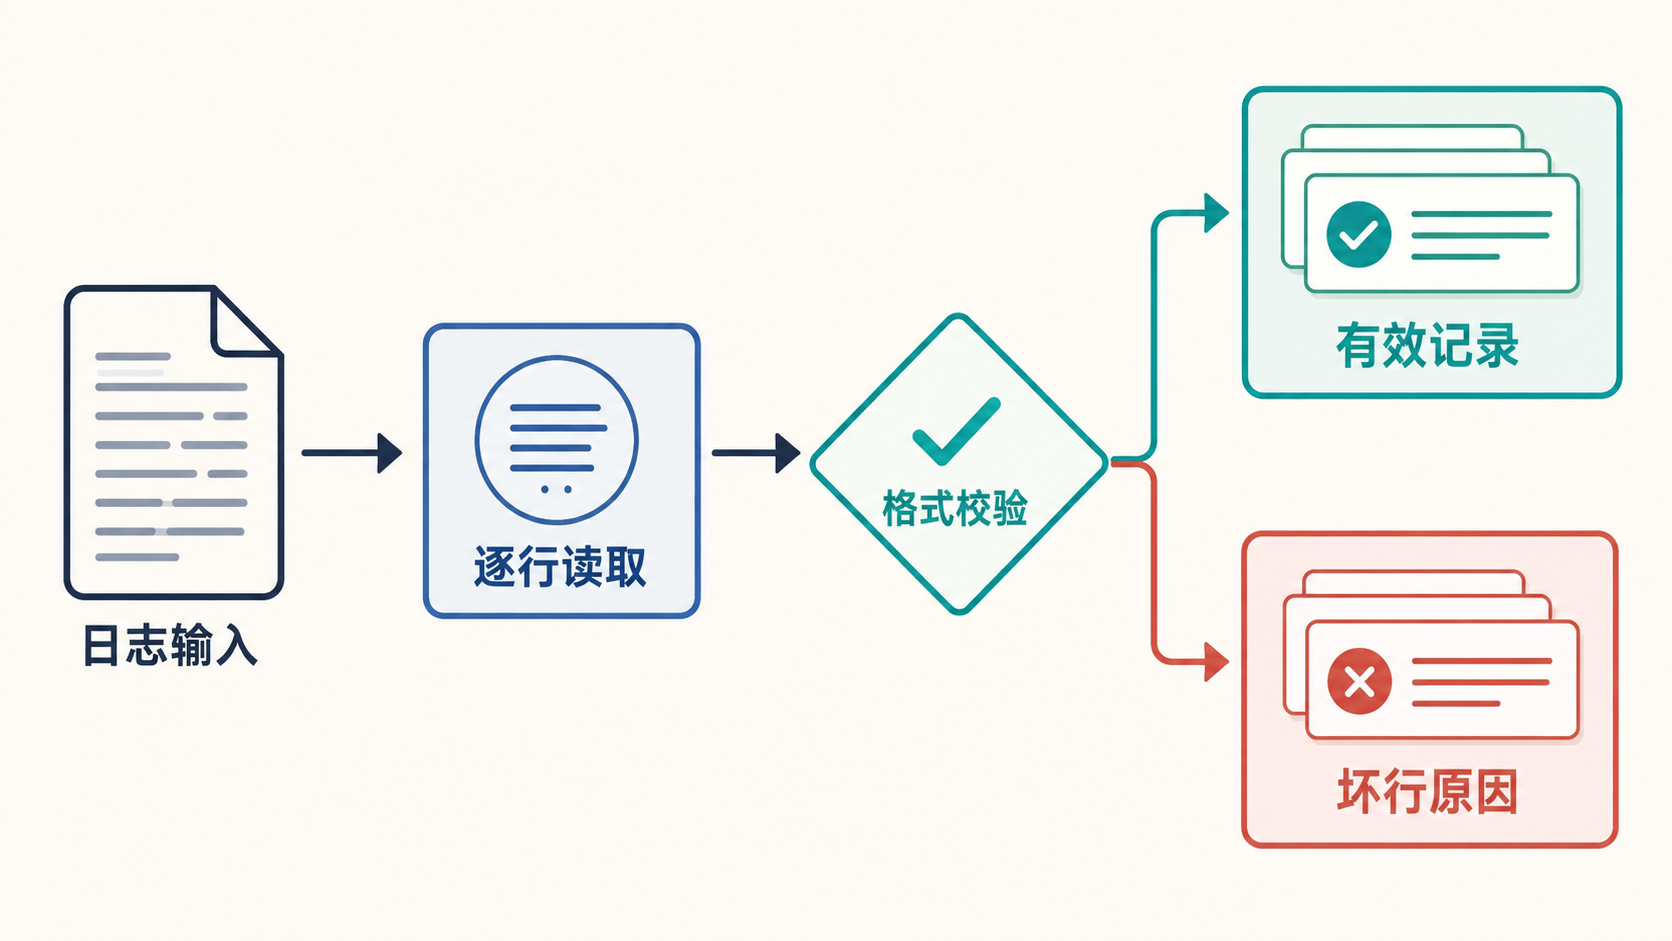
这篇 Python 教程通过一个真实可运行的日志清洗工具,讲解自定义异常、异常链、生成器、Counter、严格模式和退出状态。
选择服务器类型对Python项目部署的影响在于性能、可伸缩性、维护成本和部署复杂性。1.VPS适合中小型项目,成本可控且环境可控,但需自行维护;2.云平台集成丰富服务,适合用户增长后的复杂架构,但学习成本高;3.PaaS部署简便,适合快速原型开发,但控制权受限;4.容器化适合大型项目,提供部署一致性和扩展性,但学习成本高。配置Nginx与Gunicorn实现稳定运行需:1.Gunicorn绑定Unixsocket并设置合理worker数;2.Nginx配置反向代理指向socket、处理静态文件和SSL;3





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



