

Python屏蔽日志级别输出技巧
要屏蔽Python输出需分日志与普通输出处理:首先通过设置logging模块的Logger和Handler级别、使用logging.disable()控制日志输出级别;其次对print等普通输出,可重定向sys.stdout和sys.stderr至空流;常见问题如不必要输出多因日志传播至rootLogger或第三方库日志未关闭,可通过调整对应Logger级别或设propagate=False解决;高级控制包括使用Filter过滤日志、自定义Handler处理输出及通过dictConfig从配置文件管理日志
要屏蔽Python输出需分日志与普通输出处理:首先通过设置logging模块的Logger和Handler级别、使用logging.disable()控制日志输出级别;其次对print等普通输出,可重定向sys.stdout和sys.stderr至空流;常见问题如不必要输出多因日志传播至root Logger或第三方库日志未关闭,可通过调整对应Logger级别或设propagate=False解决;高级控制包括使用Filter过滤日志、自定义Handler处理输出及通过dictConfig从配置文件管理日志。
在Python里,要屏蔽输出信息,特别是精细控制日志模块(logging)的特定级别输出,核心在于理解并恰当配置logging模块的级别设定、处理器(Handler)和过滤器(Filter)。对于非日志模块的普通输出(比如print()),则需要通过重定向标准输出流来达到目的。
解决方案
要有效管理Python的输出,我们通常会从两个层面入手:一个是针对logging模块,另一个是针对print()等直接输出。
1. 精细控制logging模块的输出
logging模块是Python处理日志的标准库,它设计得非常灵活。要屏蔽或控制特定级别的输出,你需要关注以下几个关键点:
Logger的级别设置(
setLevel):每个Logger都有一个级别。只有当日志记录的级别高于或等于Logger设定的级别时,这条记录才会被Logger处理。import logging # 获取一个Logger实例 logger = logging.getLogger('my_app') logger.setLevel(logging.INFO) # 设置Logger的最低处理级别为INFO # 创建一个控制台处理器 ch = logging.StreamHandler() ch.setLevel(logging.DEBUG) # 设置处理器的最低处理级别为DEBUG # 定义日志格式 formatter = logging.Formatter('%(asctime)s - %(name)s - %(levelname)s - %(message)s') ch.setFormatter(formatter) # 将处理器添加到Logger logger.addHandler(ch) logger.debug("这是一条调试信息,通常不会显示,因为Logger级别是INFO。") logger.info("这是一条普通信息,会显示。") logger.warning("这是一条警告信息,会显示。")在这个例子里,
logger.setLevel(logging.INFO)意味着任何低于INFO级别的消息(如DEBUG)都会被这个logger本身忽略,即使处理器(ch)的级别设得再低也没用。Handler的级别设置(
setLevel):除了Logger,每个Handler也有自己的级别。一条日志记录只有同时满足Logger和Handler的级别要求,才会被Handler实际输出。这给我们提供了更多灵活性,比如你可以让所有DEBUG级别的日志都写入文件,但只有INFO及以上级别的日志才显示在控制台。import logging logger = logging.getLogger('my_app_advanced') logger.setLevel(logging.DEBUG) # Logger本身处理所有级别 # 控制台处理器:只显示INFO及以上 console_handler = logging.StreamHandler() console_handler.setLevel(logging.INFO) console_handler.setFormatter(logging.Formatter('%(levelname)s: %(message)s')) logger.addHandler(console_handler) # 文件处理器:记录所有DEBUG及以上 file_handler = logging.FileHandler('app.log') file_handler.setLevel(logging.DEBUG) file_handler.setFormatter(logging.Formatter('%(asctime)s - %(levelname)s - %(message)s')) logger.addHandler(file_handler) logger.debug("这条调试信息不会在控制台显示,但会写入文件。") logger.info("这条信息会在控制台显示,也会写入文件。")使用
logging.disable():如果你想在某个特定时期(比如测试或部署时)完全关闭所有或某个级别以下的日志输出,logging.disable()是一个非常直接的全局控制方法。import logging logging.basicConfig(level=logging.INFO) # 基础配置,默认输出INFO及以上 logger = logging.getLogger(__name__) logger.info("这条信息会显示。") # 禁用所有低于WARNING的日志(即只显示WARNING、ERROR、CRITICAL) logging.disable(logging.WARNING) logger.info("这条信息现在不会显示了。") logger.warning("这条警告信息仍然会显示。") # 恢复日志输出(设置为NOTSET会恢复到默认行为,即由Logger和Handler的级别决定) logging.disable(logging.NOTSET) logger.info("日志功能已恢复,这条信息又会显示了。")这招在某些场景下特别好用,比如你想暂时压制第三方库那些你根本不关心的DEBUG信息。
2. 屏蔽print()等普通输出
对于不是通过logging模块输出的内容,比如直接使用print()函数,或者某些库内部直接打印到标准输出(sys.stdout)或标准错误(sys.stderr)的信息,我们需要通过重定向这些流来屏蔽。
import sys
import os
from io import StringIO

# 保存原始的stdout和stderr
original_stdout = sys.stdout
original_stderr = sys.stderr

# 创建一个假的输出流,所有写入都会被丢弃
# 或者可以重定向到os.devnull,但StringIO在内存中更灵活
devnull = StringIO() # 或者 open(os.devnull, 'w')

try:
    sys.stdout = devnull
    sys.stderr = devnull

    print("这条信息不会显示在控制台。")
    # 假设某个库内部有直接的print语句
    # library_function_that_prints()

except Exception as e:
    # 错误处理,确保最终恢复stdout/stderr
    print(f"发生错误: {e}", file=original_stderr)
finally:
    # 恢复原始的stdout和stderr,非常重要!
    sys.stdout = original_stdout
    sys.stderr = original_stderr

print("这条信息会正常显示在控制台。")这种方法比较暴力,它会屏蔽所有通过print或直接写入sys.stdout/sys.stderr的内容。通常只在特定、需要完全静默的场景下使用,比如运行一些有副作用的第三方脚本时。
为什么我设置了日志级别,但还是看到了不想要的输出?
这绝对是初学者,甚至是一些有经验的开发者都会遇到的困惑。我个人就遇到过好几次,明明我把自己的Logger级别设得很高了,怎么还能看到一堆DEBUG信息蹦出来?这背后其实有几个核心原因,理解它们能帮你彻底搞定日志的“噪音”。
日志器的层级与传播(Propagation)机制: Python的
logging模块有一个很重要的概念叫做“日志器层级”。当你创建一个logging.getLogger('my_module.sub_module')时,它其实是继承自它的父级日志器my_module,而my_module又继承自root日志器。默认情况下,日志记录会从子日志器向上传播到父日志器,直到根日志器(rootlogger)。 如果你的子日志器级别设置得很高(比如WARNING),但它的父日志器(或者rootlogger)级别设置得很低(比如DEBUG),并且父日志器有处理器,那么即使子日志器不处理这条DEBUG消息,它也可能把这条消息传递给父日志器,然后父日志器再把它输出出来。 要阻止这种传播,你可以设置logger.propagate = False。import logging # 默认root logger是WARNING级别,但很多框架会把它设为INFO或DEBUG # logging.basicConfig(level=logging.DEBUG) # 假设root logger是DEBUG app_logger = logging.getLogger('my_app') app_logger.setLevel(logging.INFO) # 我只想看INFO及以上 # app_logger.propagate = False # 尝试禁用传播 # 给root logger添加一个handler,如果root logger有handler且级别较低,就可能输出 # 如果没有这一行,且没有basicConfig,root logger默认是WARNING,可能不会输出DEBUG if not logging.root.handlers: # 避免重复添加 logging.basicConfig(level=logging.DEBUG) # 确保root logger有handler且级别较低 app_logger.debug("这条调试信息理论上不该出现,但如果root logger处理,它就会出现!")很多时候,你看到的不想要的输出,其实是
root日志器在“捣乱”,因为很多库或者默认配置都会把日志流最终导向root日志器。处理器(Handler)的级别比日志器(Logger)的级别更低: 我们前面提到过,一个日志事件要被输出,必须同时满足Logger和其附加的Handler的级别要求。但反过来想,如果Logger的级别是
INFO,而它附加的Handler的级别是DEBUG,那么只有INFO及以上的消息才能通过Logger这一关,DEBUG消息在Logger那里就被过滤掉了,根本到不了Handler。但如果Logger的级别是DEBUG,而Handler的级别是INFO,那么DEBUG消息会通过Logger,但在Handler那里被过滤掉,INFO及以上的消息才能被Handler输出。 所以,确保你的Logger和Handler的级别设置是协同工作的。第三方库的日志器: 这是一个非常常见的问题。你可能配置好了自己应用的日志,但当你引入像
requests、urllib3、SQLAlchemy等第三方库时,它们内部也可能使用logging模块,并且有自己的日志器实例(例如logging.getLogger('requests.packages.urllib3'))。这些库的日志器默认级别可能很低(比如DEBUG),而且它们通常会将日志传播到root日志器。 要解决这个问题,你需要显式地去调整这些特定第三方库的日志器级别:import logging import requests # 禁用requests库的DEBUG日志 logging.getLogger('requests').setLevel(logging.WARNING) logging.getLogger('urllib3').setLevel(logging.WARNING) # requests依赖urllib3 # 确保自己的应用日志正常 app_logger = logging.getLogger('my_app') app_logger.setLevel(logging.INFO) if not app_logger.handlers: # 避免重复添加 app_logger.addHandler(logging.StreamHandler()) app_logger.info("我的应用信息。") requests.get('https://www.example.com') # 这次应该不会看到requests的DEBUG信息了这需要你对你使用的库有所了解,或者在运行程序时留意那些不属于你代码的日志来源,然后针对性地去调整它们的日志器。
除了调整级别,还有哪些更高级的日志输出控制技巧?
仅仅调整级别有时候还不够,特别是在需要更细粒度控制,或者日志量非常大的时候。Python的logging模块提供了非常强大的机制,可以让你玩出更多花样。
日志过滤器(Filters): 这是我觉得
logging模块里最被低估但又异常强大的功能。过滤器允许你在日志记录被处理之前,根据任何自定义逻辑来决定是否通过。你可以附加过滤器到Logger或Handler上。 一个常见的应用场景是,你只想记录来自特定模块的日志,或者排除包含某些敏感信息的日志。import logging class SpecificModuleFilter(logging.Filter): def __init__(self, name=''): super().__init__(name) self.module_name = name def filter(self, record): # 只允许来自特定模块的日志通过 # record.name 是Logger的名字,record.module 是产生日志的模块名 # 这里我们根据Logger的名字来过滤 return record.name.startswith(self.module_name) logger = logging.getLogger('my_app.sub_module') logger.setLevel(logging.DEBUG) ch = logging.StreamHandler() ch.setLevel(logging.DEBUG) ch.setFormatter(logging.Formatter('%(name)s - %(levelname)s - %(message)s')) # 添加过滤器到Handler ch.addFilter(SpecificModuleFilter('my_app')) # 只允许'my_app'及其子Logger的日志通过 logger.addHandler(ch) # 另一个Logger other_logger = logging.getLogger('another_module') other_logger.setLevel(logging.DEBUG) other_logger.addHandler(ch) # 共享同一个handler logger.debug("这是my_app.sub_module的调试信息,会被过滤通过。") other_logger.debug("这是another_module的调试信息,会被过滤器阻止。")通过自定义
filter方法,你可以实现任何复杂的过滤逻辑,比如根据日志消息内容、日志记录的额外属性(extra参数)、甚至当前用户身份来决定是否记录。自定义处理器(Custom Handlers): 如果内置的
StreamHandler、FileHandler、RotatingFileHandler等无法满足你的需求,你可以继承logging.Handler类来创建自己的处理器。这在需要将日志发送到非标准目的地时非常有用,比如:- 发送到消息队列(Kafka, RabbitMQ)。
- 发送到数据库。
- 发送到远程API服务。
- 在特定条件下执行回调函数。
- 甚至可以创建一个
NullHandler,它什么都不做,但可以用来防止“No handlers could be found for logger”的警告。import logging
class CustomDiscardHandler(logging.Handler): def emit(self, record):
这个处理器什么都不做,只是丢弃日志记录
    # 你可以在这里加入复杂逻辑,比如只记录特定类型的错误
    pass
logger = logging.getLogger('discard_logger') logger.setLevel(logging.INFO)
添加自定义的丢弃处理器
discard_handler = CustomDiscardHandler() logger.addHandler(discard_handler)
默认的控制台处理器,用于对比
console_handler = logging.StreamHandler() console_handler.setLevel(logging.INFO) logger.addHandler(console_handler)
logger.info("这条信息会显示在控制台,但也会被CustomDiscardHandler接收但丢弃。")
自定义处理器提供了极大的灵活性,让你可以完全控制日志记录的最终去向和处理方式。
通过配置文件进行日志管理(
dictConfig/fileConfig): 当你的日志配置变得复杂时,比如有多个Logger、多个Handler、不同的Formatter和Filter时,用代码一行一行地配置会变得非常冗长且难以维护。Python的logging.config模块提供了从字典(dictConfig)或文件(fileConfig,支持INI格式)加载配置的功能。 这使得日志配置可以与代码分离,方便修改和部署,也更清晰。# logging_config.yaml (示例YAML配置,需要安装PyYAML) # version: 1 # disable_existing_loggers: False # # formatters: # simpleFormatter: # format: '%(asctime)s - %(name)s - %(levelname)s - %(message)s' # # handlers: # console: # class: logging.StreamHandler # level: INFO # formatter: simpleFormatter # stream: ext://sys.stdout # file_handler: # class: logging.handlers.RotatingFileHandler # level: DEBUG # formatter: simpleFormatter # filename: app.log # maxBytes: 10485760 # 10MB # backupCount: 5 # # loggers: # my_app: # level: DEBUG # handlers: [console, file_handler] # propagate: False # 不向上级传播 # another_module: # level: WARNING # handlers: [console] # # root: # level: INFO # handlers: [console]
然后,在你的Python代码中:
import logging.config
import yaml # pip install pyyaml

# 假设logging_config.yaml在同一目录下
with open('logging_config.yaml', 'r') as f:
    config = yaml.safe_load(f.read())
    logging.config.dictConfig(config)

logger = logging.getLogger('my_app')
other_logger = logging.getLogger('another_module')

logger.debug("这是my_app的调试信息,会写入文件,但不会在控制台显示(因为console handler是INFO)。")
logger.info("这是my_app的普通信息,会写入文件,也会在控制台显示。")
other_logger.info("这是another_module的普通信息,不会显示(因为another_module是WARNING)。")
other_logger.warning("这是another_module的警告信息,会在控制台显示。")
使用配置文件是管理复杂日志策略的黄金标准,它让日志配置变得声明式,清晰易读,也方便团队协作。
如何临时或全局性地关闭Python的日志输出?
有时候,我们可能需要更粗暴、更直接的方式来关闭日志,无论是为了性能测试、调试特定问题,还是在部署环境中临时屏蔽所有非关键日志。这里有几种方法,各有侧重。
使用
logging.disable(level)进行全局控制: 这是logging模块提供的一个非常方便的全局开关。当你调用logging.disable(level)时,它会告诉logging模块:所有级别低于level的日志记录都将被忽略,无论它们的Logger或Handler设置了什么级别。 如果你想完全关闭所有日志,可以传入logging.CRITICAL + 1,或者一个足够高的值。import logging # 假设我们已经有了一些日志配置 logging.basicConfig(level=logging.DEBUG, format='%(levelname)s: %(message)s') logger = logging.getLogger('my_app') logger.debug("这条调试信息会显示。") logger.info("这条普通信息会显示。") print("\n--- 临时禁用所有INFO及以下的日志 ---") # 禁用所有低于WARNING的日志 logging.disable(logging.WARNING) logger.debug("这条调试信息现在不会显示了。") logger.info("这条普通信息现在也不会显示了。") logger.warning("这条警告信息仍然会显示。") print("\n--- 临时禁用所有日志 ---") # 禁用所有日志(通过设置一个比CRITICAL更高的级别) logging.disable(logging.CRITICAL + 1) logger.error("这条错误信息现在也不会显示了。") print("\n--- 恢复日志功能 ---") # 恢复日志功能(设置为NOTSET会取消禁用) logging.disable(logging.NOTSET) logger.info("日志功能已恢复,这条信息又会显示了。")
深入解析在FastAPI框架中实现文件下载接口的完整方案,涵盖基于FileResponse的本地静态文件传输、基于StreamingResponse的分块流式传输、RFC 5987中文文件名编码规范、路径穿越安全防御及BackgroundTasks临时文件清理,并配备详细代码示例与架构解析图。
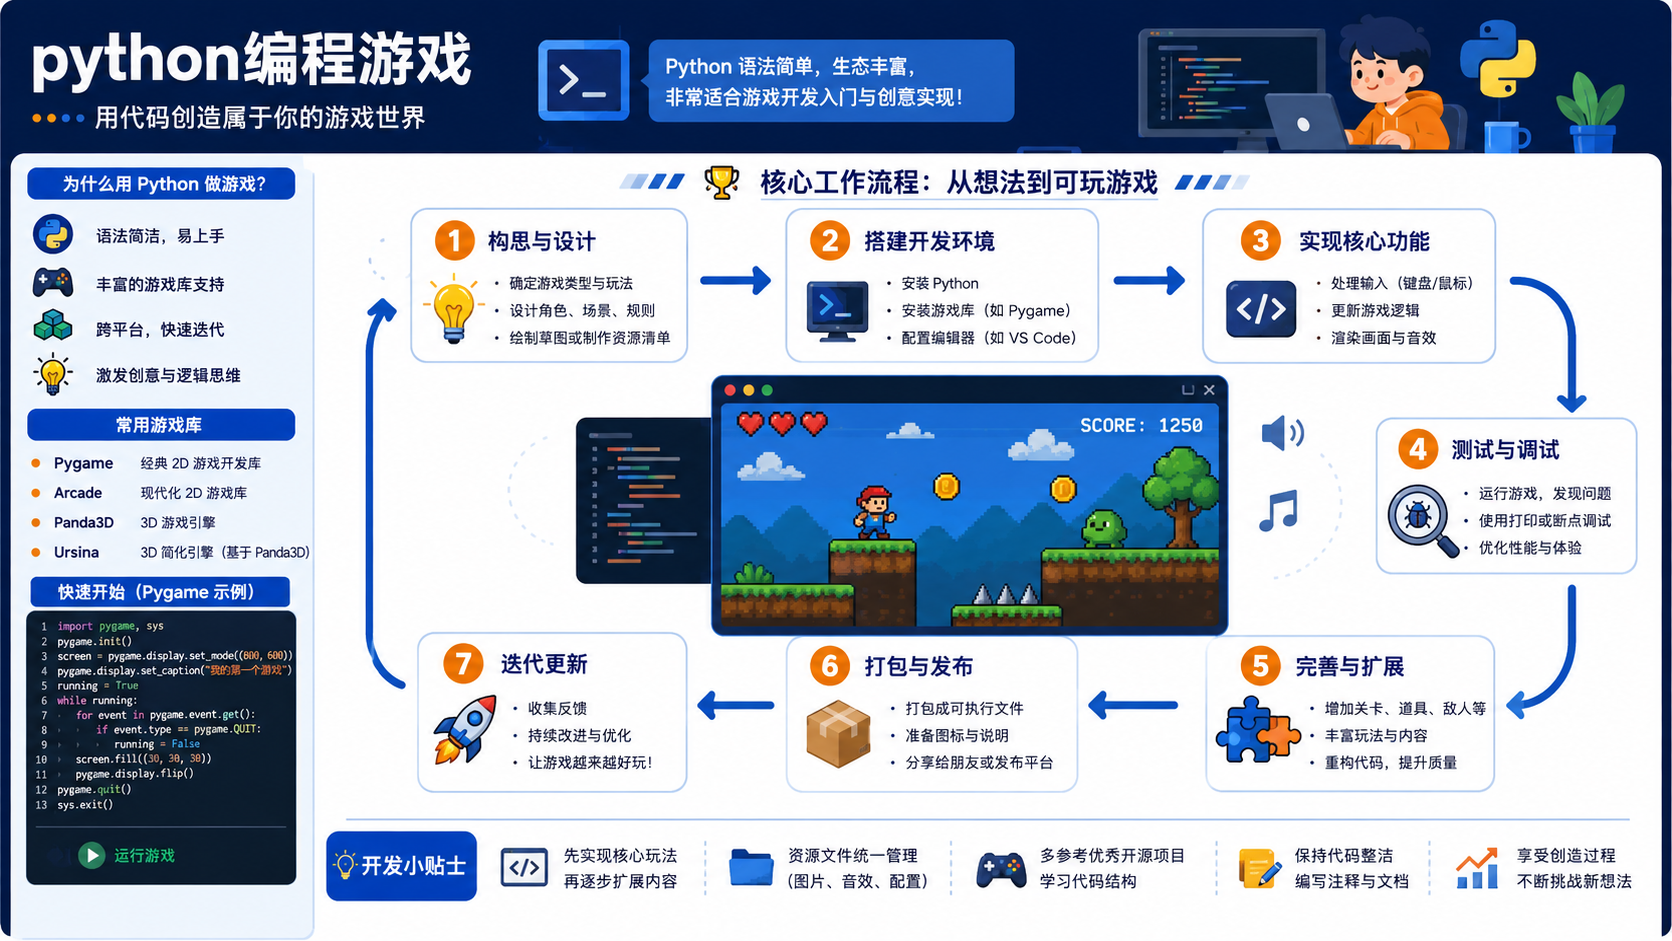
解析 python编程游戏 的核心开发流程,提供基于官方文档的环境准备、依赖安装命令及验证方法,包含清晰的决策图与排错路径,适用于具备基础命令行能力的后端开发者。
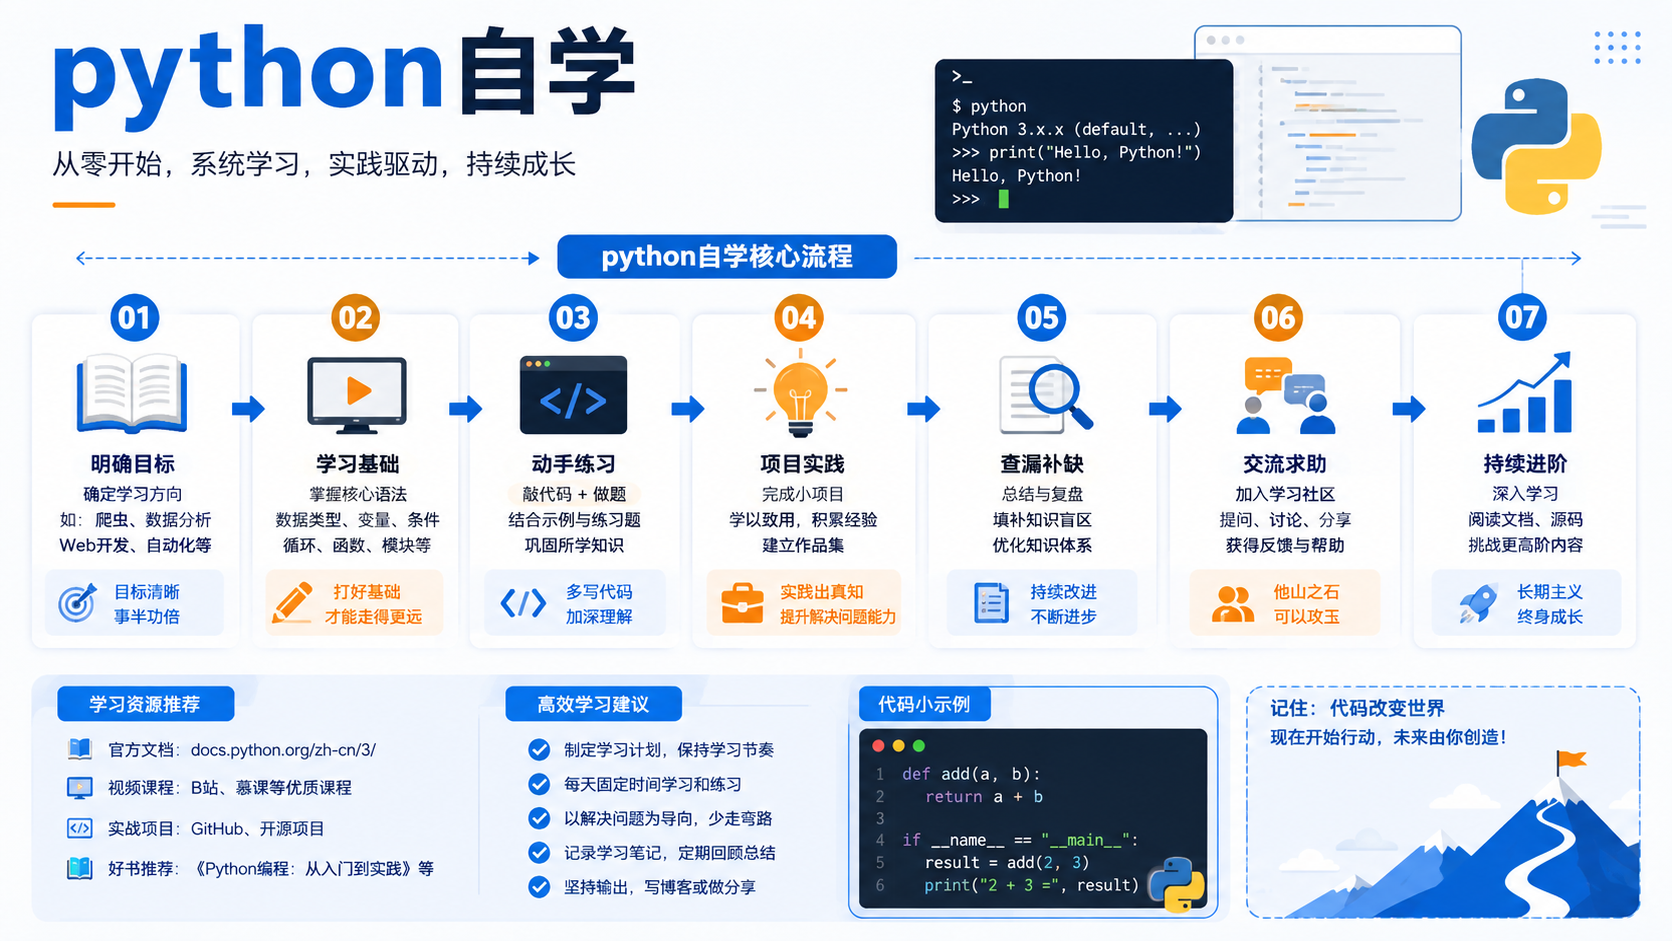
面向后端开发者的 python自学实操指南。涵盖 Python 官方概念界定、虚拟环境创建、依赖安装验证及常见排错路径,提供可执行的 Bash 命令与决策流程图。
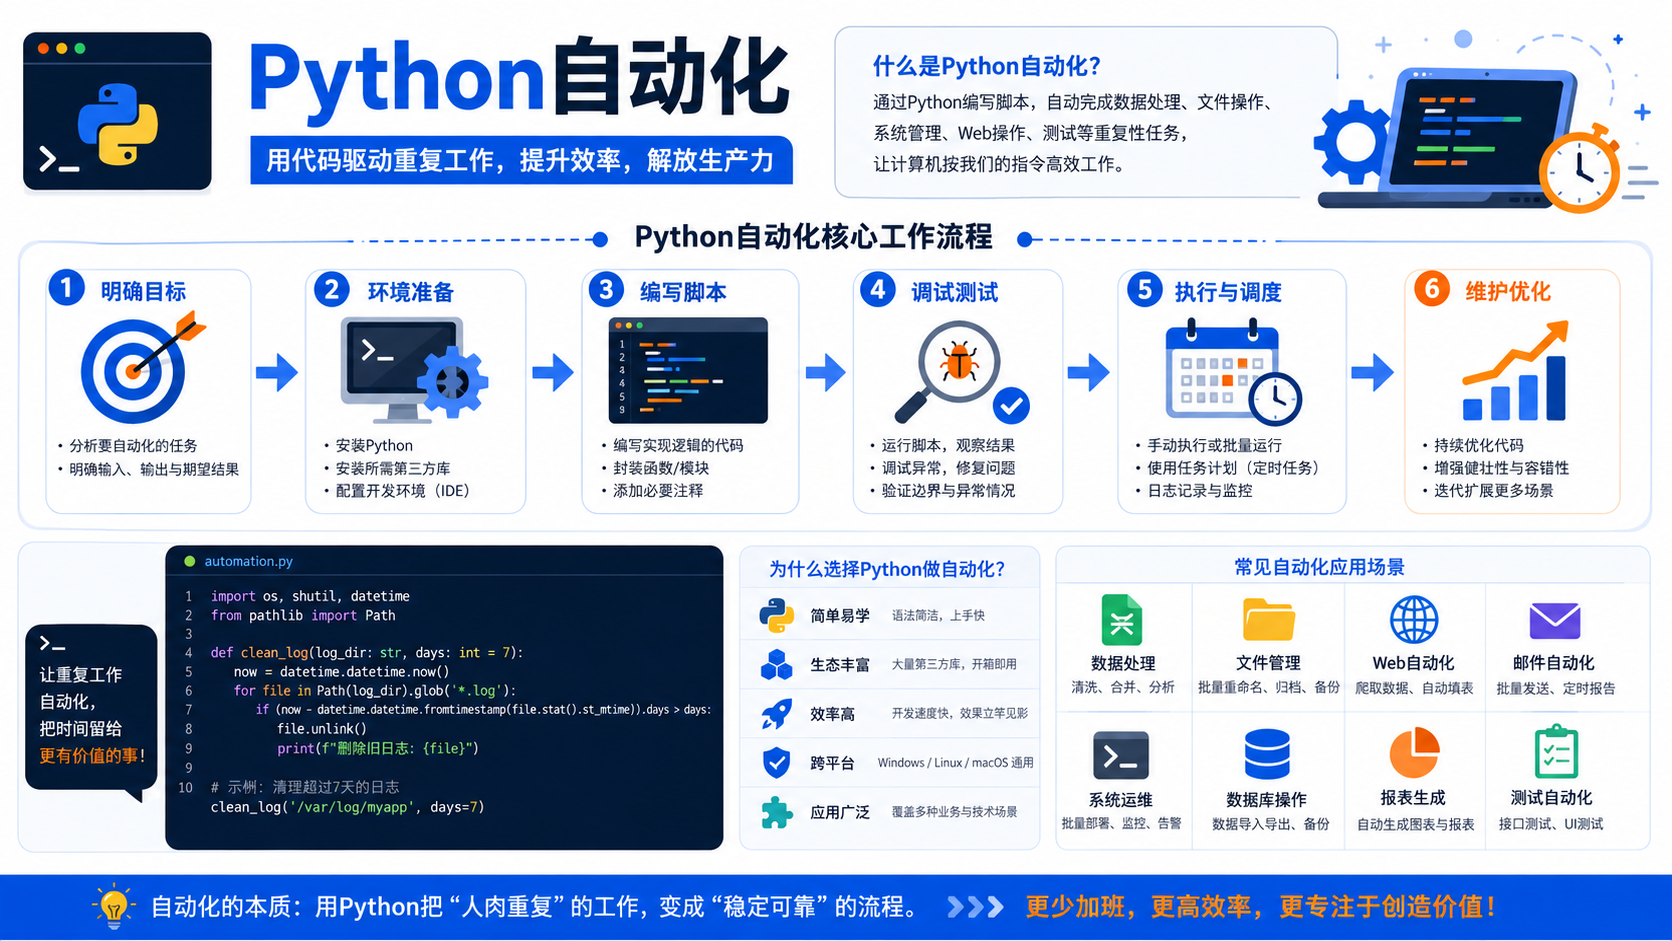
针对后端开发者的 python自动化 入门指南,涵盖 venv 虚拟环境创建、pip 依赖管理及官方文档依据的验证步骤,提供清晰的决策图与排错建议。
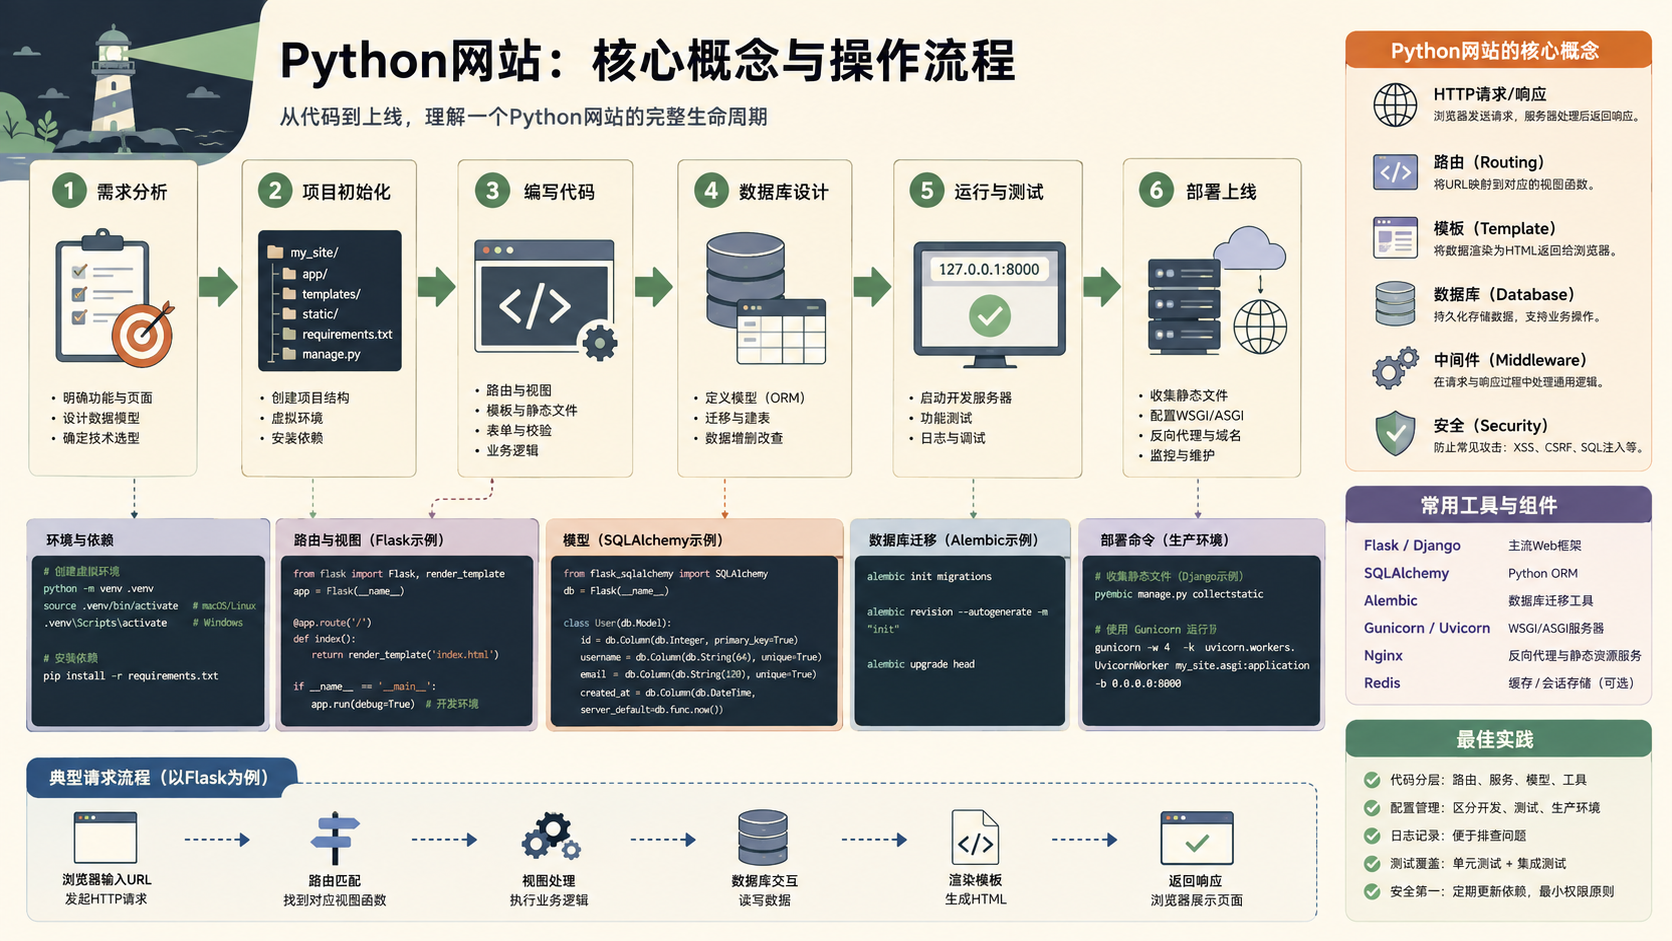
面向后端开发者的 python文档 实操指南。涵盖环境检查、venv创建、pip升级及依赖验证,提供清晰的决策图与命令示例,避免常见配置错误。
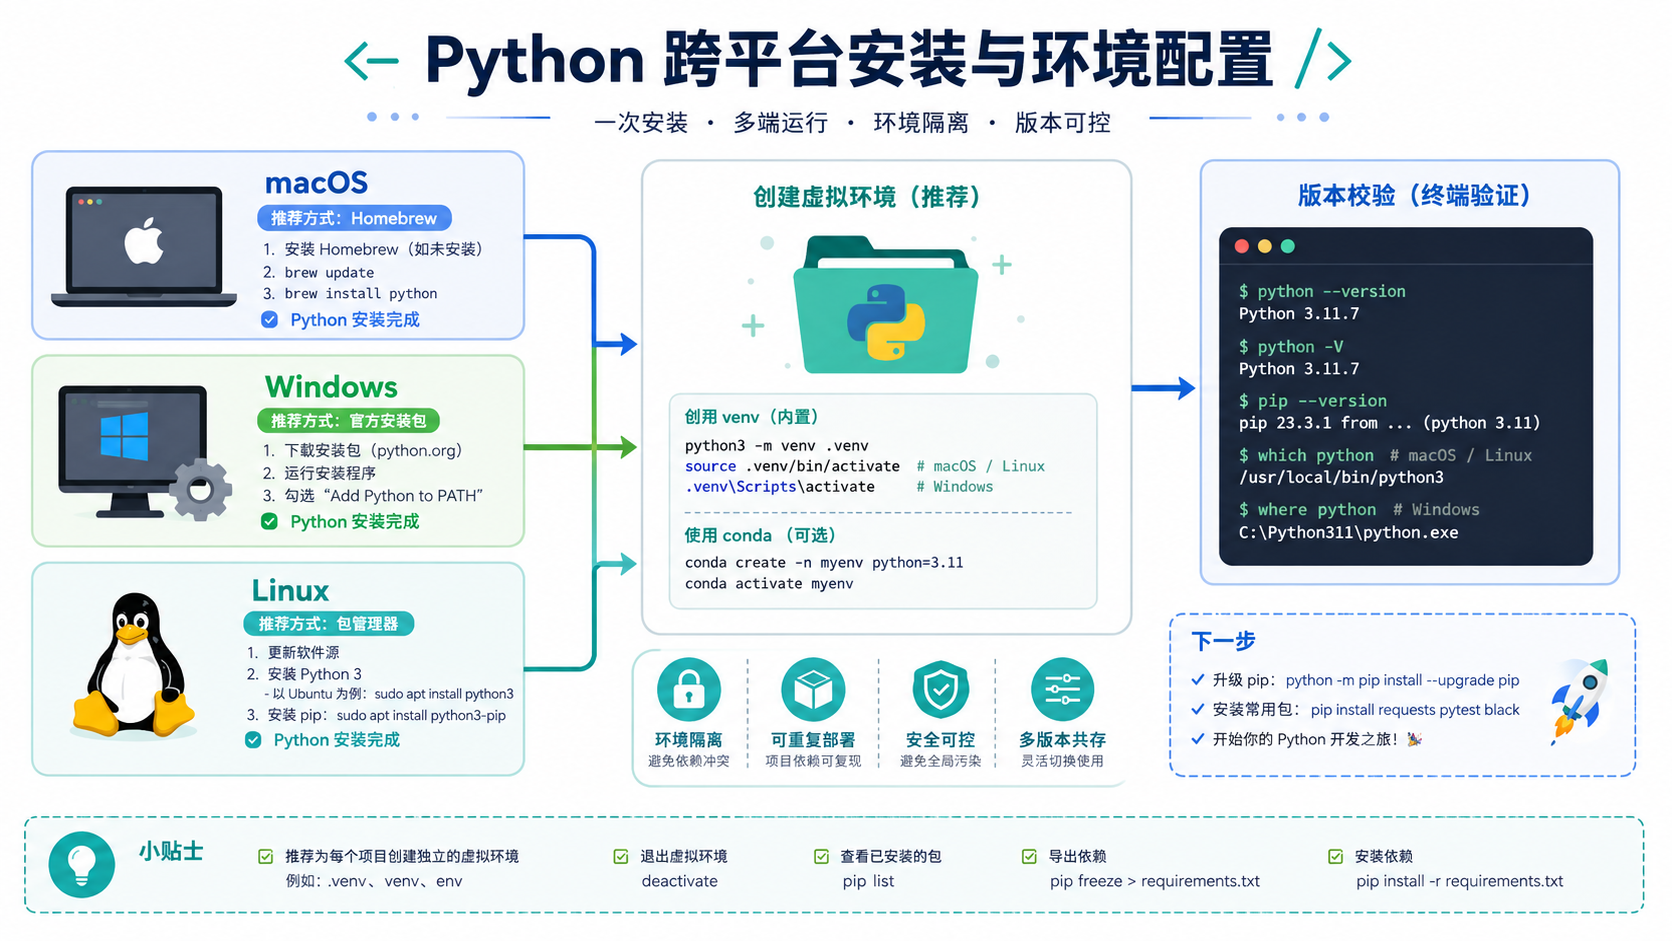
面向后端开发者的 python循环 实操指南。涵盖环境检查、虚拟环境创建、依赖安装及验证步骤,结合官方文档与决策图,确保操作可复现且边界清晰。
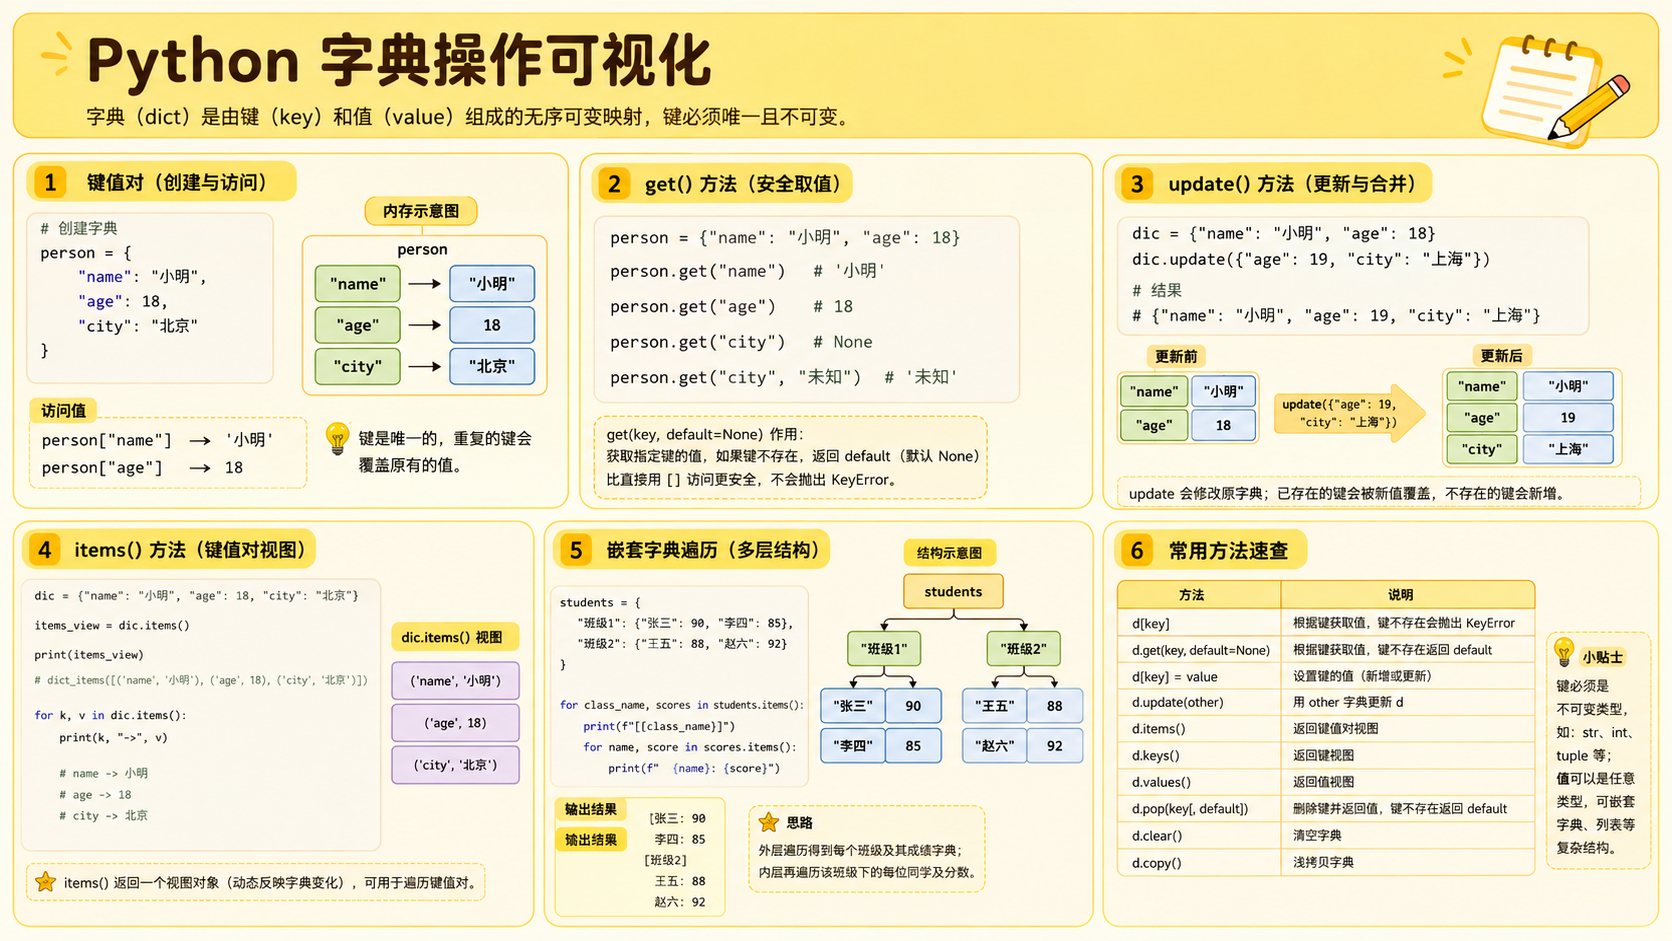
详解 Python 字典的键值访问、遍历与嵌套结构,并提供基于官方文档的 Python 环境搭建、虚拟环境隔离及依赖管理步骤,帮助开发者建立可复现的开发工作流。
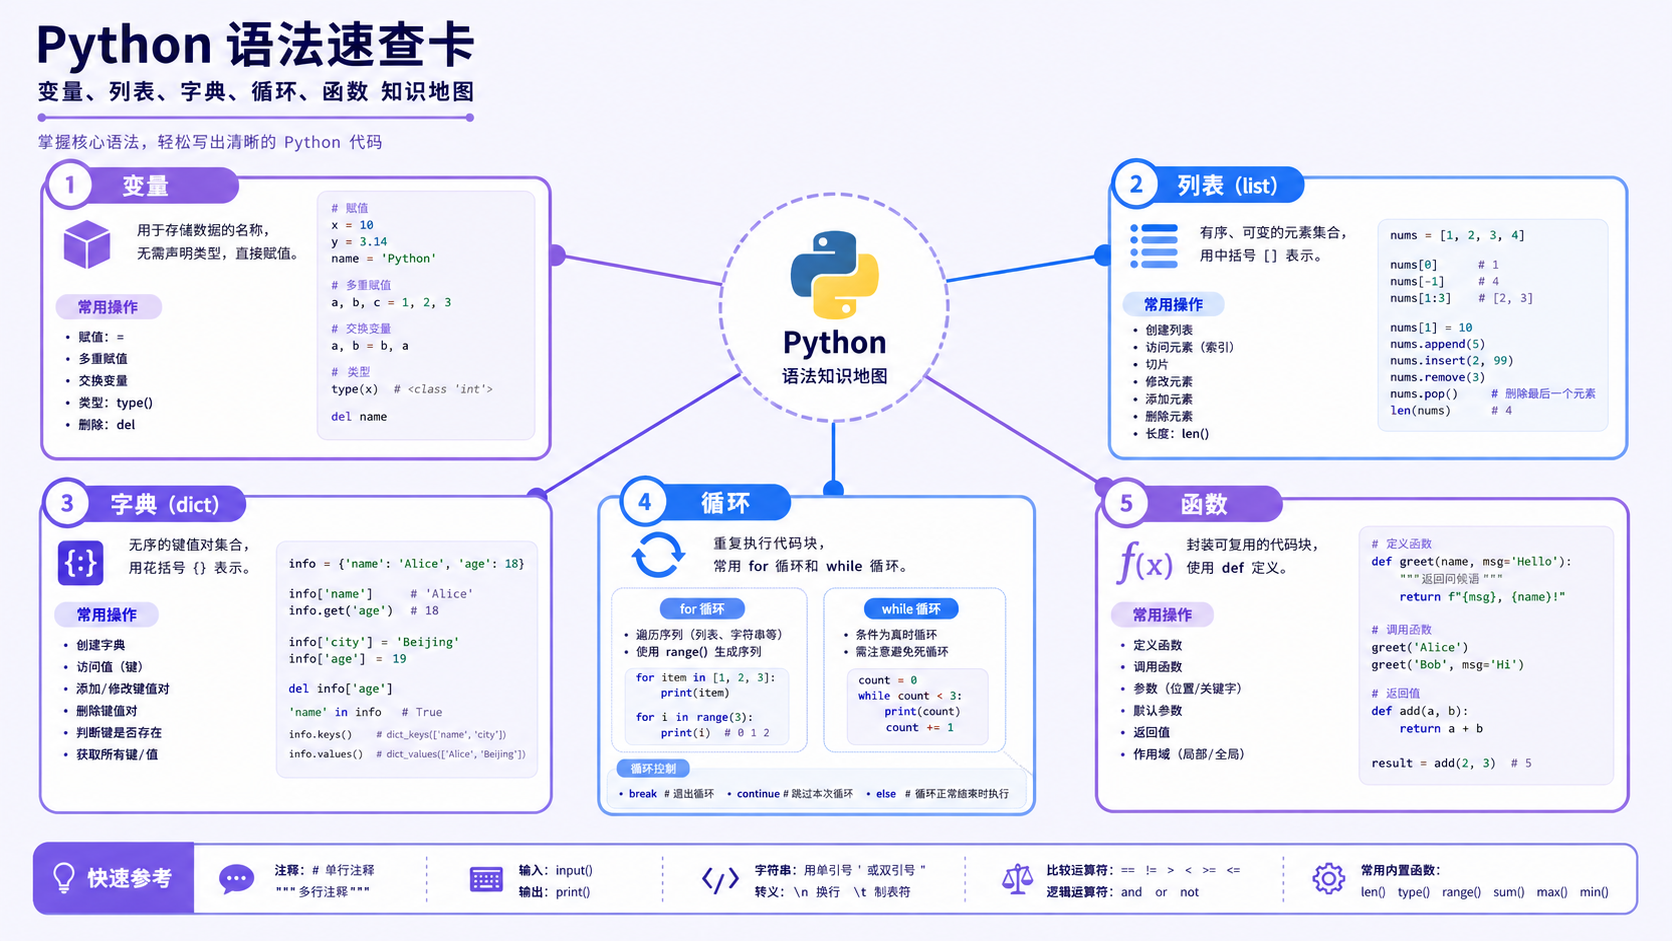
针对后端开发者,详解 Python 编程基础的环境搭建、依赖隔离与验证方法。基于官方文档提供可复现命令,明确工具边界,帮助读者建立最小可测试代码闭环。
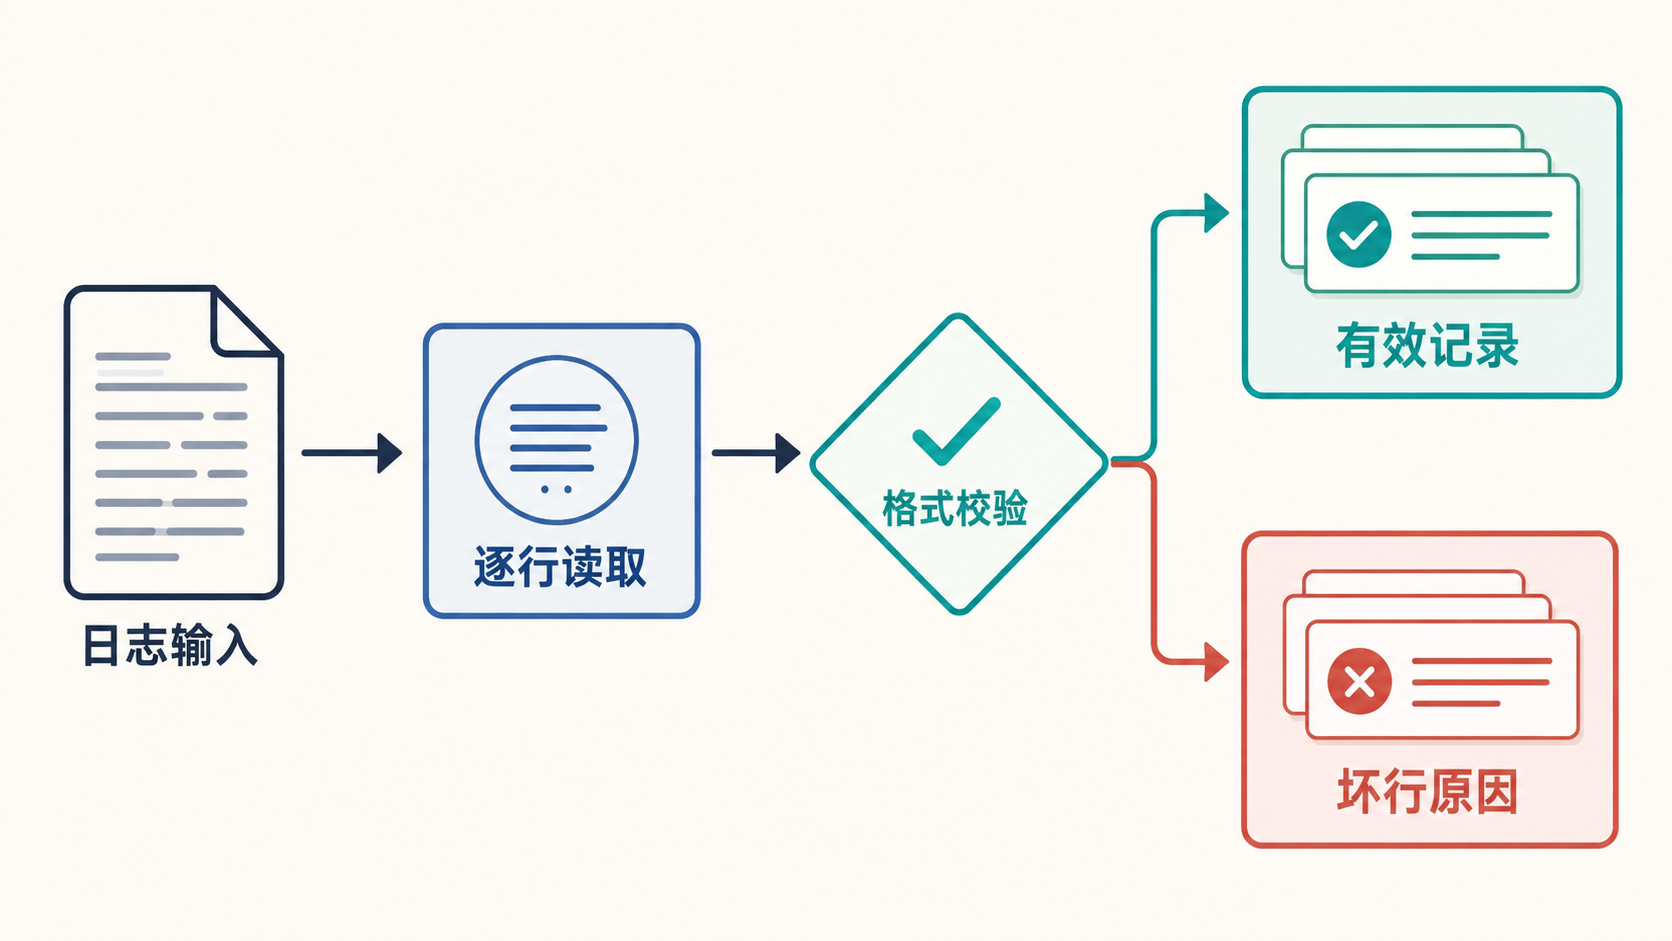
这篇 Python 教程通过一个真实可运行的日志清洗工具,讲解自定义异常、异常链、生成器、Counter、严格模式和退出状态。
选择服务器类型对Python项目部署的影响在于性能、可伸缩性、维护成本和部署复杂性。1.VPS适合中小型项目,成本可控且环境可控,但需自行维护;2.云平台集成丰富服务,适合用户增长后的复杂架构,但学习成本高;3.PaaS部署简便,适合快速原型开发,但控制权受限;4.容器化适合大型项目,提供部署一致性和扩展性,但学习成本高。配置Nginx与Gunicorn实现稳定运行需:1.Gunicorn绑定Unixsocket并设置合理worker数;2.Nginx配置反向代理指向socket、处理静态文件和SSL;3





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



