

Redshift批量插入优化:JDBC与COPY最佳实践
本文深入探讨了在AmazonRedshift中,JDBCPreparedStatement.addBatch()方法批量插入数据效率低下的原因,并分析了构建单条大型INSERT语句的优化效果及其局限性。基于Redshift的列式存储和分布式架构特性,文章最终推荐使用COPY命令结合AmazonS3进行并行数据加载,以实现最高效、可扩展的批量数据导入。

本文深入探讨了在Amazon Redshift中,JDBC `PreparedStatement.addBatch()` 方法批量插入数据效率低下的原因,并分析了构建单条大型`INSERT`语句的优化效果及其局限性。基于Redshift的列式存储和分布式架构特性,文章最终推荐使用`COPY`命令结合Amazon S3进行并行数据加载,以实现最高效、可扩展的批量数据导入。
Redshift数据加载挑战:理解JDBC批量插入的性能瓶颈
在使用JDBC连接Redshift进行数据插入时,开发者常会遇到一个普遍的性能问题:传统的PreparedStatement.addBatch()方法在Redshift上的表现远不如在PostgreSQL等行式数据库上。尽管两者都支持JDBC协议,但底层架构的根本差异导致了数据写入策略的巨大不同。理解这些差异是优化Redshift数据加载效率的关键。
首先,我们来看一个典型的JDBC批处理插入代码示例,它在PostgreSQL上可能表现良好,但在Redshift上却效率低下:
String query = "INSERT INTO table (id, name, value) VALUES (?, ?, ?)";
PreparedStatement ps = connection.prepareStatement(query);
for (Record record : records) {
    ps.setInt(1, record.id);
    ps.setString(2, record.name);
    ps.setInt(3, record.value);
    ps.addBatch(); // 添加到批处理
}
ps.executeBatch(); // 执行批处理
这段代码在Redshift上处理数千条记录时,可能需要10分钟甚至更长时间,而在PostgreSQL上几乎是瞬间完成。
深入剖析:addBatch()在Redshift上低效的原因
Redshift是一个列式存储、分布式、OLAP(在线分析处理)数据库,而PostgreSQL是行式存储、单实例、OLTP(在线事务处理)数据库。这种根本性的架构差异决定了它们处理插入操作的方式。
列式存储与行式存储的根本差异:
- PostgreSQL(行式): 每条INSERT操作只需在磁盘上追加一行数据。
- Redshift(列式): 数据按列存储。每次单行INSERT操作,Redshift需要读取涉及到的每一列的1MB数据块,在其中添加新元素,然后将更新后的数据块写回。尽管Redshift不是操作整个列,但频繁地读取、修改、写入数据块的开销巨大。
Redshift集群架构下的数据写入机制:
- Redshift数据分布在集群中的多个计算节点(slice)上。每次单行INSERT,都可能需要访问集群中不同计算节点上的不同数据块。
- 由于上述JDBC代码是单线程执行的,每个对单个数据块的访问都必须串行完成,才能发出下一个INSERT请求。这完全抵消了Redshift集群的并行处理能力。
简而言之,对于Redshift而言,每次addBatch()添加的单行数据都被视为独立的插入操作,导致了大量的I/O开销和并行性丧失。
优化尝试:构建单条大型INSERT语句的优势与局限
为了解决上述问题,一种常见的优化方法是将多条记录合并成一条大型的INSERT语句。以下是这种方法的示例代码:
String query = "INSERT INTO table (id, name, value) VALUES ";
for (Record record : records) {
    // 假设name字段需要转义单引号,实际应用中应使用参数化查询或更安全的字符串拼接方式
    query += "(" + record.id + ",'" + record.name.replace("'", "''") + "'," + record.value + "),";
}
query = query.substring(0, query.length() - 1); // 移除末尾的逗号
PreparedStatement ps = connection.prepareStatement(query);
ps.executeUpdate();
这种方法在Redshift上的性能显著提升,因为它将所有数据作为一个整体发送到数据库。
利用Redshift并行性: 当Redshift收到一条包含多行数据的INSERT语句时,它会将数据并行地分发到各个计算节点。每个节点只处理与自身相关的数据,并且只需打开和写入一次1MB的数据块。这极大地利用了Redshift的并行处理能力。
潜在的性能瓶颈与局限:
- 查询编译与网络带宽: 尽管性能有所提升,但所有数据仍然需要通过查询编译器,并被发送到集群中的 所有 计算节点(即使有些节点最终会丢弃不属于它们的数据)。这可能导致编译时间延长和网络带宽浪费。
- Leader节点瓶颈: 所有数据都必须流经Redshift的Leader节点。Leader节点负责许多数据库功能,处理大量数据会导致其成为性能瓶颈,影响整个集群的性能。
- 查询长度限制: 这种方法受限于SQL查询字符串的最大长度(通常为16MB字符)。对于非常大的数据集,这种方法将不可行。
因此,尽管这种方法比addBatch()更优,但它并非Redshift数据加载的理想方案。
Redshift数据加载的最佳实践:COPY命令
Redshift被设计用于大规模的OLAP工作负载,其最佳的数据加载方式是利用其内置的COPY命令。COPY命令专门为并行批量数据加载而优化,并且与Amazon S3服务紧密集成。
COPY命令的设计理念与并行优势:
- COPY命令允许Redshift集群中的每个计算节点独立地连接到Amazon S3,并行读取输入数据文件。
- 这意味着数据加载过程可以完全并行化:S3文件的读取、网络传输以及数据的处理都可以在各个计算节点上同时进行,从而实现极高的吞吐量。
- 数据直接从S3流入计算节点,绕过了Leader节点的数据传输瓶颈,减少了Leader节点的负担。
结合S3的并行数据加载策略: 实现最高效的Redshift数据加载,推荐以下步骤:
- 数据准备: 将要插入的数据整理成文件(如CSV、JSON等格式)。
- 并行上传S3: 使用多线程或并行工具将这些数据文件上传到Amazon S3存储桶。为了最大化COPY的并行性,建议将数据分割成多个小文件(每个文件大小适中,例如几十MB到几百MB),并确保文件数量与Redshift集群的计算节点数量或切片数量相匹配,或者至少是其倍数。
- 执行COPY命令: 从Redshift中发出COPY命令,指向S3存储桶中的数据文件。
一个概念性的COPY命令示例如下:
COPY table_name
FROM 's3://your-bucket-name/your-data-folder/'
IAM_ROLE 'arn:aws:iam::123456789012:role/YourRedshiftCopyRole'
DELIMITER ','
CSV
IGNOREHEADER 1 -- 如果文件包含标题行
REGION 'your-aws-region';
请注意,实际使用中强烈推荐使用IAM角色进行授权,而非直接暴露AWS访问密钥。
总结与建议
选择正确的数据加载策略对于Redshift的性能至关重要。
- 理解数据库特性: Redshift作为列式、分布式OLAP数据库,其设计哲学与传统的行式OLTP数据库截然不同。单行插入和传统JDBC批处理效率低下,因为它无法充分利用Redshift的并行处理能力。
- 避免序列化操作: 任何将Redshift的并行操作序列化的方法都会导致性能瓶颈。
- 优先使用COPY命令: 对于批量数据插入,COPY命令是Redshift官方推荐且性能最佳的方案。它通过与S3的深度集成,实现了数据的并行加载,绕过了Leader节点瓶颈,并最大限度地发挥了集群的计算能力。
- 优化COPY流程: 结合多线程并行生成和上传S3文件,并合理规划文件大小和数量,可以进一步提升COPY命令的效率。
总之,为了在Redshift中实现高效的数据插入,务必摒弃传统关系型数据库的思维模式,转而采用为大规模并行处理设计的COPY命令及其生态系统。
按维护分支、利用权限与节点类型对应四项修复,区分正式补丁、Beta和临时缓解的适用边界。

GitHub合并故障中的“已缓解并监控”和“已解决”不能互换。前者表示影响已经采取措施缓解,仍在观察稳定性;后者是供应商正式结束这场事故的状态。11月13日的Pull Requests合并超时事件先进入监控,随后于北京时间11月14日02:29标记为已解决。
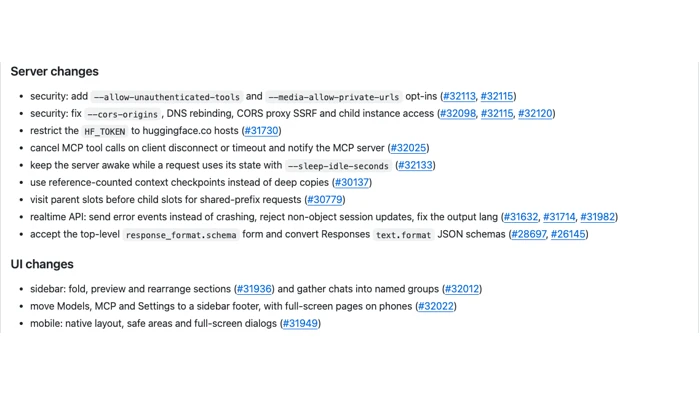
llama.cpp v1.0.0改善聊天组织、长消息编辑和附件预览;界面变化与底层API迁移、缓存及访问边界需要分别理解。
Postman 12.36.4 更新后仍有异常时,可按应用、API请求和平台服务区分问题范围,避免把补丁版本当作故障原因。
按正式、预发布和1.x维护渠道对应补丁,再结合Redis、Agent端点和Pinecone索引判断适用范围。
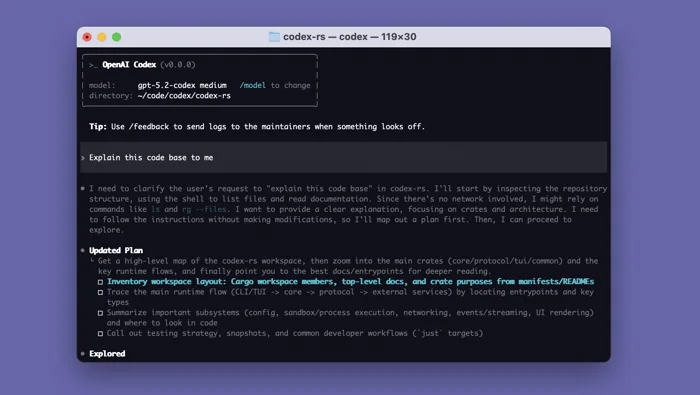
Codex CLI 0.169.0提供有明确说明的终端工作区能力;0.171.0-alpha.2为预发布,当前没有功能清单,选用时应分开评估。
llama.cpp b12345的预发布构建为Hexagon HTP后端增加Q5_0和Q5_1支持。选择模型时需要核对完整量化名称及实际运行后端,不能只看到“Q5”就视为同一种格式。
llama.cpp b12344的预发布构建调整了MCP工具调用的取消行为:客户端断连或调用超时时,服务器会向MCP服务发送带请求ID的取消通知。使用服务端工具的Web界面也属于这项变更范围。
GitHub对11月5日Actions与Checks事件的新增复盘指出:数据库服务在高并发大读请求下耗尽资源,导致部分运行无法排队或执行失败。检查类似问题时,先比对平台事件时间与失败状态,再决定是否重试自己的工作流。
GitHub对11月9日Actions事件的新增复盘说明:数据库迁移后,新区域容量与速率限制不足导致请求被拒,部分运行在服务恢复后仍占用并发。排查自己的工作流时,应把平台状态、运行状态与应用代码错误分开核对。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



