

C++适配器模式怎么用 接口兼容包装器详解
适配器模式是解决接口不兼容问题的设计模式,它通过创建一个中间层(适配器),让原本接口不匹配的类可以协同工作。其核心思想是“封装变化”,避免直接修改已有代码,从而安全地复用旧功能。实现上通常采用对象适配器方式,通过组合持有被适配对象实例,并在其内部将目标接口调用转换为对被适配对象接口的调用。该模式常用于集成第三方库、统一多数据源接口、支持系统重构及简化测试依赖等场景。C++中主要有两种实现:对象适配器(推荐)和类适配器(较少使用),前者基于组合更灵活且避免多重继承问题,后者则通过多重继承实现但耦合度高且适用
适配器模式是解决接口不兼容问题的设计模式,它通过创建一个中间层(适配器),让原本接口不匹配的类可以协同工作。其核心思想是“封装变化”,避免直接修改已有代码,从而安全地复用旧功能。实现上通常采用对象适配器方式,通过组合持有被适配对象实例,并在其内部将目标接口调用转换为对被适配对象接口的调用。该模式常用于集成第三方库、统一多数据源接口、支持系统重构及简化测试依赖等场景。C++中主要有两种实现:对象适配器(推荐)和类适配器(较少使用),前者基于组合更灵活且避免多重继承问题,后者则通过多重继承实现但耦合度高且适用性受限。
C++中的适配器模式,说白了,就是一种“翻译官”或者“万能转换插头”的角色。它的核心思想是让原本接口不兼容的类能够协同工作。我们常常会遇到这样的情况:手头有一个功能完善的类,但它的接口和我们当前系统需要的接口对不上。与其大动干戈去修改原有类(这通常不现实,特别是当它是第三方库或者历史遗留代码时),不如造一个“适配器”,让这个适配器去包装那个不兼容的类,然后对外提供我们系统期望的接口。这样一来,客户端代码就可以通过适配器来使用原有类的功能,而无需知道背后的接口差异。
解决方案
要实现C++中的适配器模式,我们通常会采用“对象适配器”的方式,因为它更灵活,也更符合C++的习惯。具体来说,就是通过组合(composition)来持有被适配对象的一个实例。
想象一下,我们有一个老旧的日志系统OldLogger,它用的是C风格字符串和特定的logMessage方法:
#include#include // 被适配者:老旧的日志系统 class OldLogger { public: void logMessage(const char* msg) { std::cout << "[Old Logger] " << msg << std::endl; } };
而我们现在的新系统期望所有的日志功能都通过一个统一的NewLoggerInterface接口来调用,并且使用std::string:
// 目标接口:新系统期望的日志接口
class NewLoggerInterface {
public:
    virtual void write(const std::string& data) = 0;
    virtual ~NewLoggerInterface() = default;
};现在,问题来了,我们想在新系统里用OldLogger的功能,但它不符合NewLoggerInterface。这时,适配器就派上用场了:
// 适配器:将OldLogger适配到NewLoggerInterface
class OldLoggerAdapter : public NewLoggerInterface {
private:
    OldLogger* oldLogger; // 通过组合持有被适配者实例

public:
    // 构造函数,传入被适配者的实例
    OldLoggerAdapter(OldLogger* logger) : oldLogger(logger) {}

    // 实现NewLoggerInterface的write方法,并在内部调用OldLogger的logMessage
    void write(const std::string& data) override {
        oldLogger->logMessage(data.c_str()); // 关键的适配逻辑:string转char*
    }
};
这样,客户端代码就可以这样使用了:
// 客户端代码:只知道NewLoggerInterface
void clientCode(NewLoggerInterface* logger) {
    logger->write("This is a message from the new system.");
}

// 在main函数中使用
// int main() {
//     OldLogger* myOldLogger = new OldLogger();
//     NewLoggerInterface* adapter = new OldLoggerAdapter(myOldLogger);
//
//     clientCode(adapter);
//
//     delete adapter;
//     delete myOldLogger;
//     return 0;
// }通过OldLoggerAdapter,clientCode完全不需要知道它实际操作的是一个OldLogger,接口的差异被适配器巧妙地抹平了。这就像你拿着一个两孔插头(OldLogger),想插到三孔插座(NewLoggerInterface)上,适配器就是那个转换头,让你能顺利通电。
为什么我们需要适配器模式?
说实话,很多人一开始接触设计模式,会觉得有点绕,觉得直接改代码不就行了?但实际项目里,情况远比想象的复杂。我个人觉得,适配器模式存在的理由,主要就是为了解决那些“想用但用不了”的尴尬局面。
最直接的原因,当然是接口不兼容。这简直是个老大难问题。你可能引入了一个第三方库,它功能强大,但API设计和你的项目风格格不入;或者你的系统里有一块历史悠久、稳定运行的代码,但它的对外接口在新的需求下显得陈旧了。这时候,你总不能为了兼容性就去修改别人的库代码,或者冒着风险去动那些没人敢碰的“祖传代码”吧?适配器就是那个安全阀,它在不改变原有代码的前提下,提供一个符合新需求的接口。
它还大大促进了代码的复用性。与其为了匹配接口而重写一套类似的功能,不如直接适配。这不仅省去了开发时间,更重要的是,你复用的是经过时间考验、可能已经非常健壮的代码。这种“拿来主义”在软件开发中是极其高效的。
再者,适配器模式也为系统演进和重构提供了便利。当你的系统需要从一个旧接口过渡到新接口时,不可能一蹴而就地替换所有使用旧接口的地方。你可以先引入一个适配器,让新旧接口并行存在一段时间,逐步替换客户端对旧接口的依赖,从而实现平滑过渡,减少对现有业务的影响。这在大型、复杂的系统中尤其重要,能有效降低重构风险。
C++中适配器模式的两种主要实现方式有什么区别?
在C++里,适配器模式主要有两种实现方式:对象适配器(Object Adapter)和类适配器(Class Adapter)。它们的核心目的都是一样的,但实现细节和适用场景上,还是有些微妙的差异。
对象适配器,就是我们上面例子里用的那种,它通过组合(Composition)的方式,在适配器类中包含一个被适配者对象的实例。说白了,适配器“拥有”一个被适配者。
- 优点:
- 灵活性高:适配器可以和被适配者的任何子类一起工作,因为它是通过指针或引用来持有被适配者的,运行时可以动态绑定。这意味着一个适配器可以服务于一系列相关的被适配者。
- 避免多重继承的复杂性:C++的多重继承有时候挺让人头疼的,比如菱形继承问题。对象适配器完全避免了这个问题。
- 可以适配多个被适配者:如果需要,一个适配器甚至可以组合多个被适配者来提供一个统一的接口。
- 缺点:
- 需要额外的对象实例,可能会引入一点点运行时开销(通常可以忽略不计)。
- 被适配者的方法调用需要通过适配器进行一次转发,多了一层间接性。
类适配器则有点不一样,它通过多重继承来实现。适配器类同时继承目标接口(Target Interface)和被适配者(Adaptee)。这样,适配器既是目标接口的实现者,又继承了被适配者的功能。
// 示例(不推荐在大多数C++场景中使用)
// 类适配器:同时继承目标接口和被适配者
class ClassOldLoggerAdapter : public NewLoggerInterface, private OldLogger {
public:
    // 实现NewLoggerInterface的write方法
    void write(const std::string& data) override {
        this->logMessage(data.c_str()); // 直接调用继承来的logMessage
    }
};- 优点:
- 无需额外对象:因为适配器本身就是被适配者,所以不需要额外的成员变量来持有被适配者实例。
- 直接调用:可以直接调用继承来的被适配者方法,没有额外的间接性。
- 缺点:
- C++多重继承的限制:这是最大的问题。它要求被适配者必须是一个类,而不是一个接口或抽象类(虽然C++中接口也是通过抽象类实现的)。而且,如果被适配者不是纯虚函数类,可能会引入一些继承的复杂性。
- 缺乏灵活性:适配器只能适配特定的被适配者类,不能适配它的子类。因为它是通过继承建立的编译时关系。
- 耦合度高:适配器和被适配者在编译时就紧密耦合在一起。
总的来说,在C++中,对象适配器是更常用、更推荐的选择。它提供了更好的灵活性和更低的耦合度,并且避免了多重继承可能带来的复杂性。类适配器在某些特定场景下可能会有其用武之地,但通常需要更谨慎地评估。
适配器模式在实际项目中的应用场景有哪些?
这玩意儿听起来有点抽象,但在实际开发中,适配器模式的影子无处不在,只是我们可能没意识到它就是适配器。
一个很常见的场景就是集成遗留系统或第三方库。设想一下,你的新项目需要用到一个很古老的C++库,它可能用的是原始指针、C风格字符串,甚至连异常处理都和现代C++格格不入。但这个库的功能非常核心且稳定,你不能轻易替换。这时候,你就可以为这个老库创建一个适配器,对外提供现代C++风格的接口(比如使用智能指针、std::string、STL容器等),这样你的新代码就可以无缝地调用老库的功能,而不用去处理那些历史遗留的“脏活累活”。这就像给老房子装上了现代化的智能家居控制面板。
另一个典型例子是统一不同数据源或服务接口。比如,你的应用可能需要从不同的地方获取用户数据:一部分来自旧的SQL数据库,一部分来自新的NoSQL数据库,还有一部分可能来自某个RESTful API。这些数据源的查询接口、返回格式可能千差万别。你可以为每种数据源都创建一个适配器,让它们都实现一个统一的UserDataFetcher接口。这样,你的业务逻辑层只需要调用fetchUserData(),而不用关心数据到底是从哪儿来的,也不用写一堆if-else来判断数据源类型。
还有,在重构大型系统时,适配器模式也是个好帮手。当你决定修改一个核心模块的接口时,直接替换可能会导致大量依赖该模块的代码报错。你可以先引入一个适配器,让旧接口的用户通过适配器来调用新接口。这样,你可以逐步地修改客户端代码,而不是一次性地进行大规模改动,大大降低了重构的风险和工作量。这就像在修路的时候,先建一条临时便道,确保交通不中断。
甚至在一些测试场景下,适配器也有奇效。比如,你有一个非常复杂的外部服务依赖,在单元测试时很难模拟。你可以创建一个适配器,在生产环境中使用真实的外部服务,但在测试环境中,这个适配器可以被替换为一个模拟(mock)或桩(stub)对象,它只返回预设的数据,从而简化测试环境的搭建。
总而言之,只要你遇到“我有A,想用B的接口来操作A”或者“我需要多种不同的A,但想用统一的B接口来操作它们”的情况,适配器模式就值得你考虑。它是一个非常实用的工具,能帮你优雅地处理接口不兼容问题,提升代码的复用性和系统的可维护性。

了解 Claude Code 的基础交互流程,包括文件生成确认、使用 /compact 管理对话上下文、通过 CLAUDE.md 设定项目规则以及调用技能复用输出格式,提升开发协作效率。

详细介绍在 Visual Studio 2022 中关闭编辑器垂直滚动条代码缩略图(地图模式)的具体操作方法,包含右键快捷路径与全局选项设置,帮助恢复紧凑清晰的传统滚动条。

详细介绍在 Visual Studio 2022 中使用官方 Microsoft Visual Studio Installer Projects 扩展生成 Windows 桌面应用程序安装包(.msi / setup.exe)的完整操作步骤与配置细节。

客观全面评析大地老师的Node.js教程:从技术栈覆盖、实战讲解风格到局限短板与进阶路径,帮助初学者和前端开发者客观评估是否适合自身学习需求。

在为大模型Agent接入外部工具时,是选择MCP的结构化参数定义,还是使用CLI的通用命令入口?本文通过图片筛选与上传的实际案例,分析两种方式在上下文开销、任务组合效率及安全风险上的差异,提供选型参考。
初次接触Codex不知从何下手?本文通过一个具体的HTML笔记应用案例,带你走完从建立项目、输入需求、批准执行到验收结果的完整流程,快速掌握Codex的基础使用方法。
学习如何通过结构化测试、精准断言和参数化设计提升JUnit测试效率,避免常见陷阱,实现高质量、可维护的单元测试代码。
遇到.klib文件打不开?它通常是Kotlin/Native的库文件而非普通文档。本文教你如何在Windows下确认文件来源、安全查看内部结构,以及开发者如何正确使用klib工具,避免误操作。
学习如何在Vue项目中设置文件上传格式限制。本文介绍使用HTML accept属性进行基础过滤,以及结合JavaScript进行严格后缀名校验的方法,确保只允许指定类型的文件被上传。
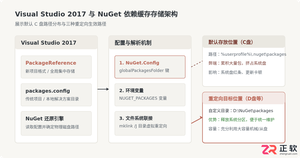
本文详细介绍在Visual Studio 2017中修改NuGet包全局缓存存放路径的实用方案,包括修改全局NuGet.Config文件、配置系统环境变量以及利用NTFS目录联接进行透明迁移,并提供验证与旧缓存清理步骤。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,
火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


