

给AI智能体的"技能包"造一台专属编译器,执行效率最高提升50倍
这项由上海交通大学计算机科学团队主导的研究,以预印本形式发布于2026年4月,编号为arXiv:2604.03088v3,有兴趣深入了解的读者可通过该编号查阅完整论文。 想象一下,你聘请了一位新助理,递给他一本厚达数百页的《工作标准操作手册》,然后说:“照着这个做就行。”如果这位助理是经验丰富的专家
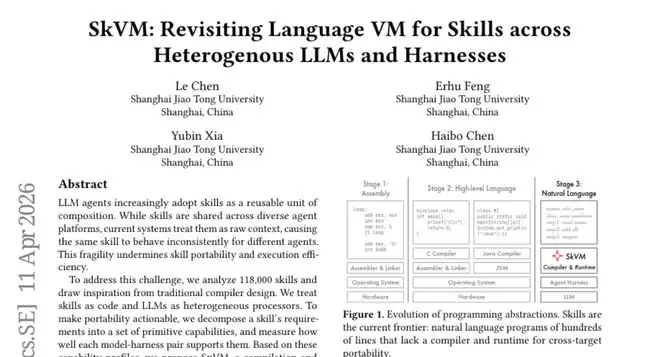
这项由上海交通大学计算机科学团队主导的研究,以预印本形式发布于2026年4月,编号为arXiv:2604.03088v3,有兴趣深入了解的读者可通过该编号查阅完整论文。
想象一下,你聘请了一位新助理,递给他一本厚达数百页的《工作标准操作手册》,然后说:“照着这个做就行。”如果这位助理是经验丰富的专家,他扫一眼就能心领神会,流畅地完成任务。但如果换成一位刚毕业的新人,情况就完全不同了——手册里那些默认他懂的术语、跳过的步骤,都可能成为理解的障碍。更糟糕的是,手册里要求使用某个特定工具,而办公室里根本没有,新人就只能卡在那里,手足无措地浪费时间。
这并非虚构的场景,而是当前AI智能体在使用“技能包”时每天都在上演的真实困境。上海交通大学的研究团队在分析了超过11.8万个公开技能包后,发现这个问题的普遍性和严重性远超预期。为此,他们设计了一套名为SkVM的系统,其角色堪称技能包与AI模型之间的“高级翻译官”兼“智能调度中心”,目标是让任何能力水平的AI模型,都能正确且高效地执行技能包中的复杂指令。
一、“技能包”是什么,为什么AI现在离不开它
要理解这项研究的价值,首先得厘清“技能包”究竟是什么。现代AI智能体的工作模式,很像一个不断进行“思考-行动”循环的智能工人:它接收任务,进行推理,调用工具,观察结果,再基于结果继续推理,直至任务完成。这个被称为“ReAct”的循环,模拟了人类解决问题时“计划-执行-反馈-调整”的基本逻辑。
技能包的出现,就是为了给这个“智能工人”配备一本高度专业化的《领域操作指南》。一个典型的技能包通常包含三个核心部分:首先是“名片”,明确技能包的名称、适用场景和目标;其次是“正文”,用自然语言详细描述操作步骤、工具使用方法及关键注意事项;最后是“附件”,可能包含可执行的脚本、代码模板或配置文件。
举个具体的例子:一个处理PDF文档的技能包,会详细指导AI如何使用`pdfplumber`库精确提取表格数据,同时提醒它,在合并PDF时应选择`pypdf`而非已过时的`PyPDF2`。这类技能包的本质,是将领域专家的隐性经验和最佳实践,封装成AI可读的显性知识,使其无需从零摸索。
目前,在clawhub.ai和skills.sh等主流平台上,已汇集了超过11.8万个技能包,覆盖数据分析、金融建模、办公自动化乃至编程开发等众多场景。然而,绝大多数技能包仅仅是一份Markdown格式的纯文本文件,被直接“扔”给AI去阅读理解。这种粗放的方式,埋下了严重的效率与效能隐患。
二、同一本手册,不同的人读出了完全不同的结果
研究团队对八个能力各异的AI模型进行了系统性测试,结果令人深思。启用技能包后,竟有15%的任务完成得分不升反降——也就是说,看了“手册”,AI反而更不会干活了。另有17%的任务得分毫无变化(排除那些本就无需技能包也能完美完成的任务)。更值得关注的是,在高达87%的任务上,至少有一个AI模型在使用技能包后未能获得任何提升。
这背后隐藏着三种典型的“失配”故障模式:模型失配、执行环境失配和运行环境失配。
模型失配最为直观。不同AI模型的认知与执行能力差异巨大,而技能包的撰写往往默认面向“高材生”。研究记录了一个生动案例:一个用于生成PPT的技能包,推荐使用`PptxGenJS`这个Ja vaScript库。像Claude Opus 4.6和Gemini 3 Flash这样的顶级模型,能准确识别这是一个编程库,轻松拿到满分。而能力较弱的Devstral Small模型,却将其误解为一个命令行工具,反复执行错误指令导致任务失败。讽刺的是,如果不加载这个技能包,Devstral Small反而会自主选择它熟悉的`python-pptx`库,并获得95分的高分。
执行环境失配则更为隐蔽。同一个AI模型,使用同一个技能包处理同一项任务,仅仅因为切换了不同的“执行框架”(即提供工具和运行环境的底层软件),结果就可能天差地别。例如,Gemini 3 Flash在简单的BareAgent框架中使用原始技能包处理工作日排班任务,能得满分;但换到OpenCode框架中,得分却直接归零。失败原因在于,OpenCode框架会在对话开头注入大量工具说明文档,导致上下文过长,最终使AI输出了格式错误的JSON而无法被解析。
运行环境失配是最实际的痛点。技能包白纸黑字写着“需要用到某某库”,但用户的实际运行环境中根本没有安装。测试发现,当必要依赖缺失时,Qwen系列模型的成功率骤降至33%-67%,同时还会产生2到4倍的冗余输出——因为模型在不断尝试各种错误的变通方案。即便是最强的Claude Opus 4.6,虽然最终能自行诊断并安装缺失库,但也因此多消耗了56%到69%的Token。每一次缺失的依赖,都在让AI重复缴纳高昂的“试错税”。
三、编译器的思路:把自然语言技能包当成代码来对待
面对这三重失配,研究团队的灵感来源于计算机发展史上一个里程碑式的解决方案:编译器。
回顾历史,早期程序员需直接编写晦涩难懂的机器码或汇编语言,效率低下且极易出错。高级编程语言(如C语言)的出现,让程序员能以更符合人类思维的方式书写逻辑,再由编译器将其“翻译”成机器能执行的指令。而Ja va虚拟机(JVM)的理念更进一步,实现了“一次编写,到处运行”的跨平台梦想。
研究团队敏锐地意识到,在AI智能体时代,技能包就是需要被执行的“源代码”,而AI模型则是千差万别的“处理器硬件”。现有的处理方式,相当于把高级语言源代码直接扔给不同架构的CPU,却期望它们能产生一致的结果,这显然是不现实的。中间缺少的,正是“编译”和“优化”这个关键环节。
于是,SkVM应运而生——一个专为技能包设计的编译与运行时系统。它巧妙借鉴了传统编译技术中的两大核心思想:提前编译(AOT)与即时编译(JIT)。
四、提前编译:装好技能包就把活儿做到位
SkVM的提前编译器在用户安装技能包时便自动启动,针对当前特定的AI模型和执行框架,对技能包进行三轮深度优化。
1. 基于能力的编译:解决模型失配
这一步的核心,是建立一套精细的“原始能力”度量体系。团队从1.5万多个技能包中抽象出26种“原始能力”,归为四大类。每种能力还进一步划分了熟练度等级。
例如,“执行命令行工具”能力被分为三级:L1仅能执行`ls`、`cat`等基础命令;L2能处理带参数和相对路径的命令;L3则能编写包含管道、重定向和循环的复杂命令链。编译器通过一系列微基准测试(如同驾考科目)来为每个AI模型建立“能力档案”,此档案可被所有技能包复用,无需重复测评。
有了模型的能力档案,编译器便能精准定位技能包要求与模型实际水平之间的“能力鸿沟”,并采取相应策略。差距较小时,采用“补偿”策略:在技能包中插入更明确的说明、示例或约束,降低任务难度以弥合差距。差距过大时,则启用“替换”策略:寻找一条能达到相同目标但所需能力不同的替代路径。例如,若技能包要求用Python的pandas进行数据分析,但模型Python能力不足,编译器可尝试将其替换为模型擅长的SQL实现方案。
以前述PPT生成为例,编译器发现该技能包需要“处理相对文件路径”(L2能力),而目标模型仅具备L1水平。由于差距仅一级,编译器选择补偿策略,直接在技能包指令中加入:“请将所有相对路径转换为基于技能包安装目录的绝对路径”。问题迎刃而解。
2. 环境绑定:解决运行环境失配
编译器会提取技能包声明的所有依赖项(第三方库、命令行工具、系统服务等),并检查当前环境是否已安装。对于缺失项,它会生成一个“环境绑定脚本”,在每次执行技能包前自动运行,确保所有工具就位。这相当于将“边开车边修路”变成了“先铺好路再出发”,让AI能专注于核心任务。
3. 并发提取:挖掘隐藏的并行机会
研究发现,76%的技能包包含明确的步骤流程,但这些步骤常被顺序描述,并不意味着它们必须串行执行。就像烹饪时,烧水的同时完全可以准备食材。
编译器会将技能包步骤分解为一张“依赖关系图”,识别出步骤间的先后依赖与独立关系,进而提取三种层级的并行机会: - 数据级并行:对大量独立数据执行相同操作(如分析15个独立的CSV文件),编译器会重写步骤使其并发执行。 - 指令级并行:多个独立的工具调用请求(如运行8个互不依赖的代码分析脚本),可被批量打包发出。 - 线程级并行:任务可分解为多个完全独立的子任务(如同时调试三个独立的微服务),编译器会将其标注为独立的“子智能体任务”,由执行框架并行调度。
五、即时编译:在实战中越用越聪明
提前编译解决了安装时可见的问题,但有些问题只有在运行时才会暴露。SkVM的即时编译器负责处理这些动态情况。
1. 自适应重编译
系统持续追踪任务执行结果。当某个技能包反复失败或需要重试时,系统会分析这是偶然性错误还是系统性能力缺陷。确认为后者后,将触发重编译:将失败日志和模型自我纠错的记录反馈给编译器,生成优化补丁。若新版本效果变差,系统会自动回滚,确保稳定性。优化过程始终基于历史最佳版本进行迭代。
2. 代码固化
这是一个极具巧思的优化。研究发现,75%的技能包包含“结构固定、仅参数变化”的代码片段(如PDF合并代码)。正常情况下,每次执行AI都需要重新“思考”一遍整个代码生成过程,耗时耗力。
代码固化分三步走: - 提前分析:编译器识别有固化潜力的代码片段,为其生成关键词、特征签名、带参数槽的模板及参数提取规则。 - 运行时监控:系统比对AI实际生成的代码与预测的特征签名是否匹配。 - 触发固化:仅在连续多次成功匹配后,才触发固化。此后,系统将绕过AI推理,直接提取参数、填入模板、执行代码,速度大幅提升。
一个关键的安全机制是:如果监控发现AI生成的代码结构不稳定,与预测签名不符,系统将永不触发固化,始终使用AI推理路径。研究用天气查询技能包验证了这一点:查询“当前天气”的代码结构稳定,成功固化;而“天气预报”的代码格式灵活,系统正确识别其不稳定性,放弃了固化,所有8次调用均走AI路径。
3. 资源感知调度
并行虽好,但需考虑现实约束:API有速率限制,内存有上限。SkVM的调度器会实时监控API延迟、HTTP 429错误、CPU/内存使用率。当资源压力超过阈值时,它会暂停启动新任务,或挂起部分运行中的任务以减少竞争。每次执行后,调度器会记录实际有效的并发度,作为下次调度的基准。
六、实验结果:数字说话
研究团队在八个不同能力等级的AI模型(涵盖顶级、中级、小型)和三种执行框架上进行了全面测试,覆盖118个任务,每个任务5个不同输入实例。
任务完成率:SkVM优化后的技能包在所有模型-框架组合上均取得了最高得分。相比原始技能包,平均提升任务完成率15.3%。能力越弱的模型受益越大。SkVM导致任务得分下降的比例仅为4.5%,而原始技能包的这一比例为15%,降低了三分之二以上。
跨框架一致性:使用原始技能包时,不同框架间的得分差距最高达13分;经SkVM优化后,最大差距缩小至5分,表现更稳定。
与竞品对比:与Anthropic公司的Skill-Creator(同样使用顶级Claude模型优化)相比,SkVM在较弱模型上优势明显。在BareAgent框架下,SkVM在Qwen3-30B模型上领先25分,在Devstral Small模型上领先10分。
分阶段效果:选取14类技能进行细分分析发现,其中11类任务使用原始技能包的表现反而不如不用。经过AOT编译后,平均得分提升88%;再经过三轮JIT优化,14类中有10类达到满分。这直观展示了编译优化的巨大威力。
执行效率:代码固化效果显著。PDF文本提取任务,原始执行时间为10,469-15,116毫秒;固化后降至206-568毫秒,提速19-50倍。并行化提取最高实现3.2倍的端到端加速。
资源消耗:在最强模型与最简框架的组合(DeepSeek V3.2 + BareAgent)下,SkVM减少了近40%的Token消耗。
环境绑定效果:对比“完整环境”、“缺失依赖”和“使用环境绑定”三种情况。缺失依赖时,Qwen模型成功率跌至33%-67%,Token消耗翻2-4倍;使用环境绑定后,所有测试模型表现均恢复至完整环境水平。
能力档案成本:为devstral-small模型建立完整的26项能力档案需7.3分钟,费用约0.033美元;为qwen3-30b建立需31.1分钟,费用约0.079美元。这是一次性成本,可在海量技能包复用中被快速摊薄。
七、这套系统的边界与未来
研究团队也客观探讨了SkVM的局限性与开放问题。
自然语言固有的不确定性,使得技能包编译过程会引入一定的非确定性。不过,AI模型本身对输入变化有一定容忍度,加之SkVM的回滚机制,这种非确定性在实践中是可控的。
当前的26种原始能力覆盖了所分析技能包中95%的需求。随着生态扩张,可能会出现新需求。团队设计了扩展流程:当某种新需求在语料库中间出现频率超过1%时,才考虑新增能力,避免体系过度膨胀。
AOT编译需要调用AI模型进行分析改写,会产生一定的Token费用。但由于每个技能包只需编译一次,且结果可全球用户共享,其单次使用的边际成本极低。
Q&A
Q1:SkVM的“原始能力”体系是如何建立起来的?
研究团队从1.5万多个技能包中手工挑选50个代表性样本,借助AI辅助分析,初步提炼出19种原始能力。研究人员依据“可组合性、通用性、语义独立性”三原则逐一验证。随后用这19种能力去覆盖全部技能包,对无法覆盖且出现频率超过1%的需求,补充新能力。此过程最终收敛至26种能力,覆盖95%的需求。每种能力进一步划分熟练等级,并通过微基准测试在实际模型上验证等级划分的合理性。
Q2:代码固化失败了怎么办?
SkVM设计了两层保护机制。第一层是“促进门”:在连续多次调用中,若AI生成的代码结构与预测特征签名匹配不稳定,系统将永不触发固化,始终走AI推理路径(如天气预报案例)。第二层是运行时回退:即使固化已触发,若固化代码在某次执行中导致失败或异常,系统会立即回退至AI推理路径完成本次任务,确保正确性不受损。
Q3:SkVM对顶级AI模型有用吗,还是只对弱模型有价值?
对强弱模型均有价值,但收益侧重点不同。对于能力较弱的模型,SkVM主要带来任务完成率的显著提升,因为其与技能包要求的能力鸿沟更大,优化空间更广。对于顶级模型,其任务完成率本身已接近天花板,SkVM的主要价值在于显著降低Token消耗并提升执行速度——例如,最强的DeepSeek V3.2模型在最简框架下,Token节省接近40%,这对于大规模应用而言意味着可观的成本节约。
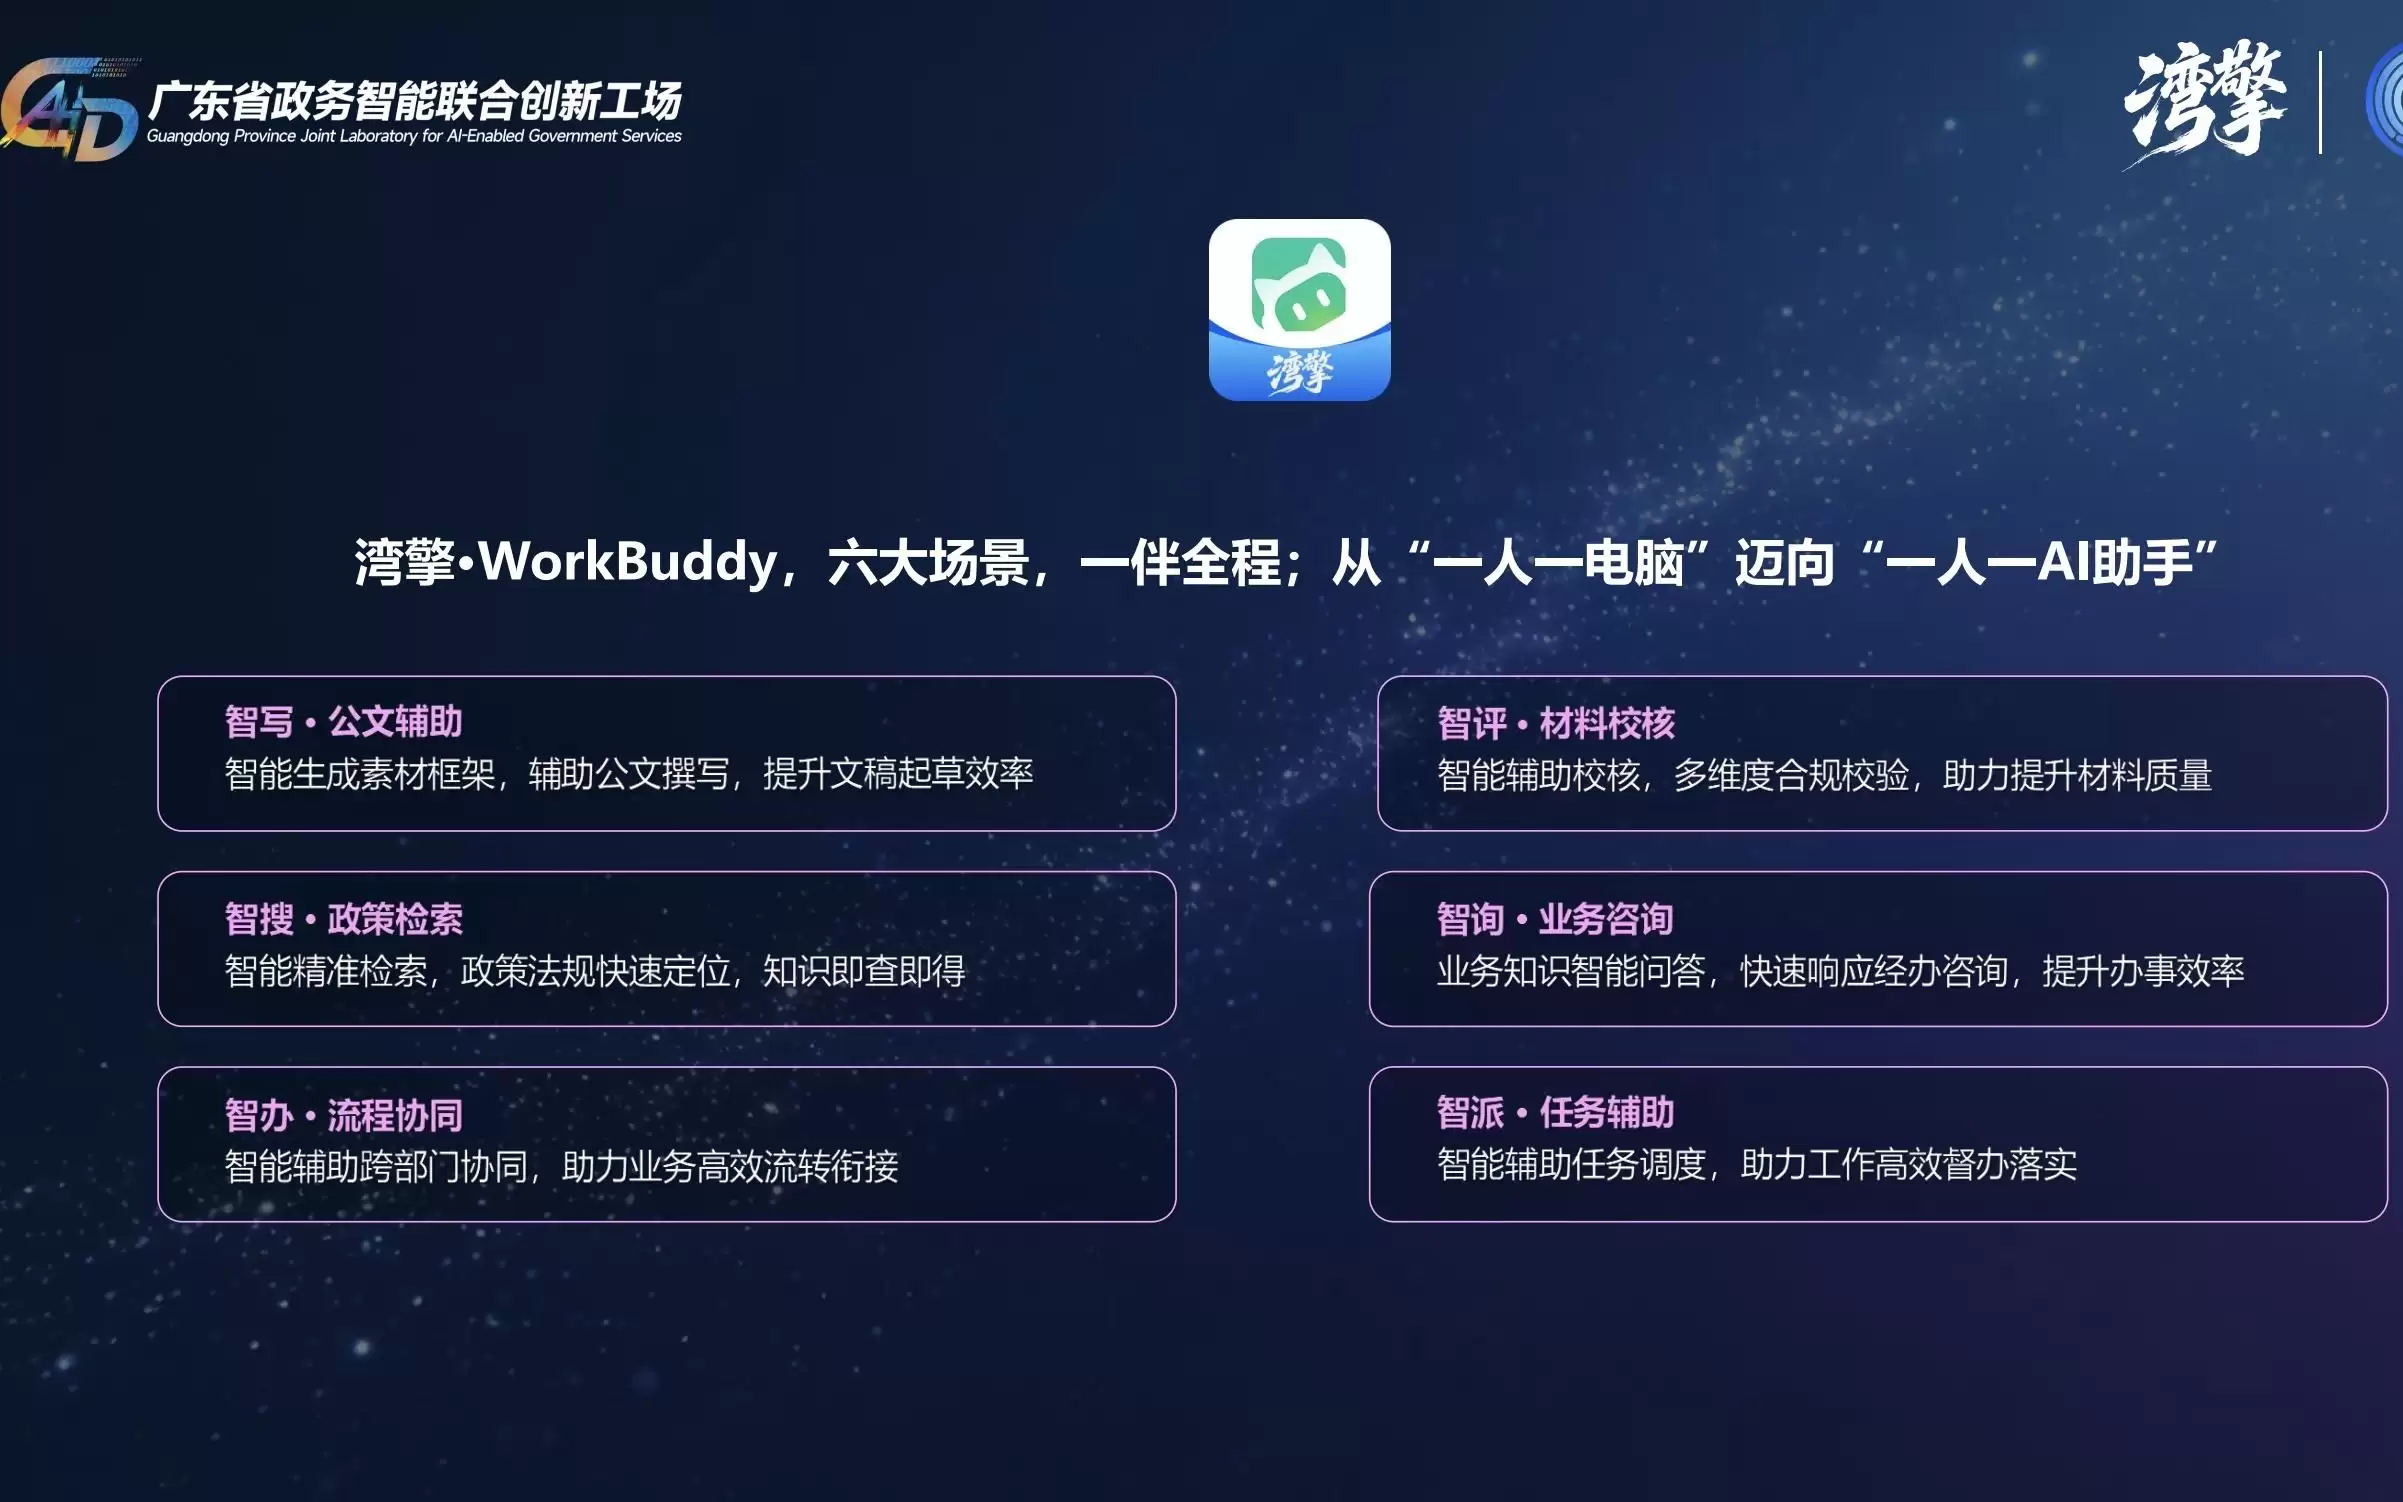
全国首个省级政务智能中枢“湾擎”上线试运行,腾讯AI工作台WorkBuddy作为核心组件接入,提供公文处理、政策研究等专业化能力,支持国产化部署与数据安全,助力政务AI从碎片化走向集约化运营。
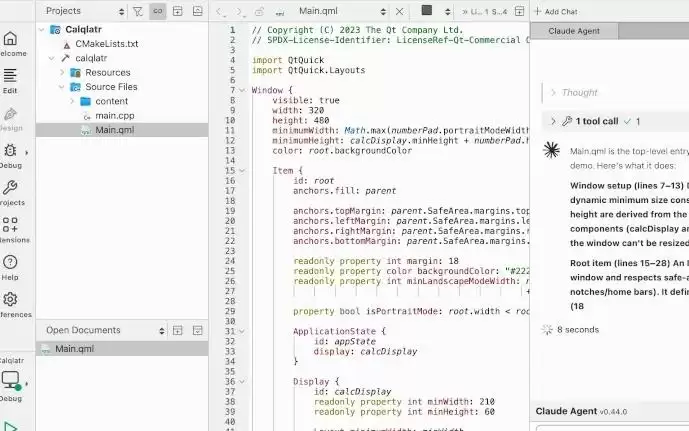
QtCreator20跨平台IDE发布,引入ACP框架支持接入ClaudeCode、OpenAICodex等AI智能体,开发者可在聊天面板直接交互无需切换窗口。已有MCP协议扩展AI生态,新增沉浸式禅模式。这一更新极大提升开发效率与AI协作体验,推动智能编程发展,为开发者带来全新体验。
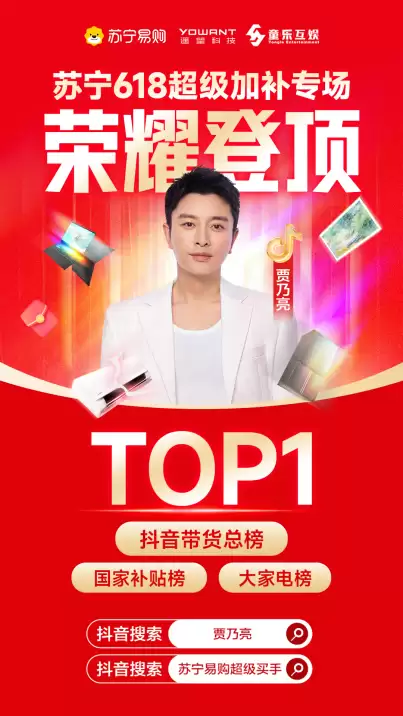
苏宁易购618联手贾乃亮举办沉浸式云测评直播,现场展示手机泡水、空调静音等真实测试,用户纷纷点赞。平台给予大幅补贴,最终成交额超过3300万元,人工智能新品瞬间售罄,其中华硕天选7Pro、vivoY6m、美的酷省电空调销量均领先。
奇安信启动“AI时代,攻防先行”新品发布周,推出聚焦安全智能与智能安全的产品组合,标志网络安全进入AI智能体对抗新阶段。首发“威胁分析数字专家”,支持对话即研判,覆盖IOC研判、样本归因、APT分析等场景,即日起面向全行业免费公测。
英伟达GEAR实验室的AutoResearch系统首次在真实物理世界运行,基于ENPIRE架构,AI智能体自主完成机器人感知、决策、执行与迭代,实现扎带捆扎、显卡插装等高难度操作,人工干预极少,计划开源以推动具身智能技术普及。
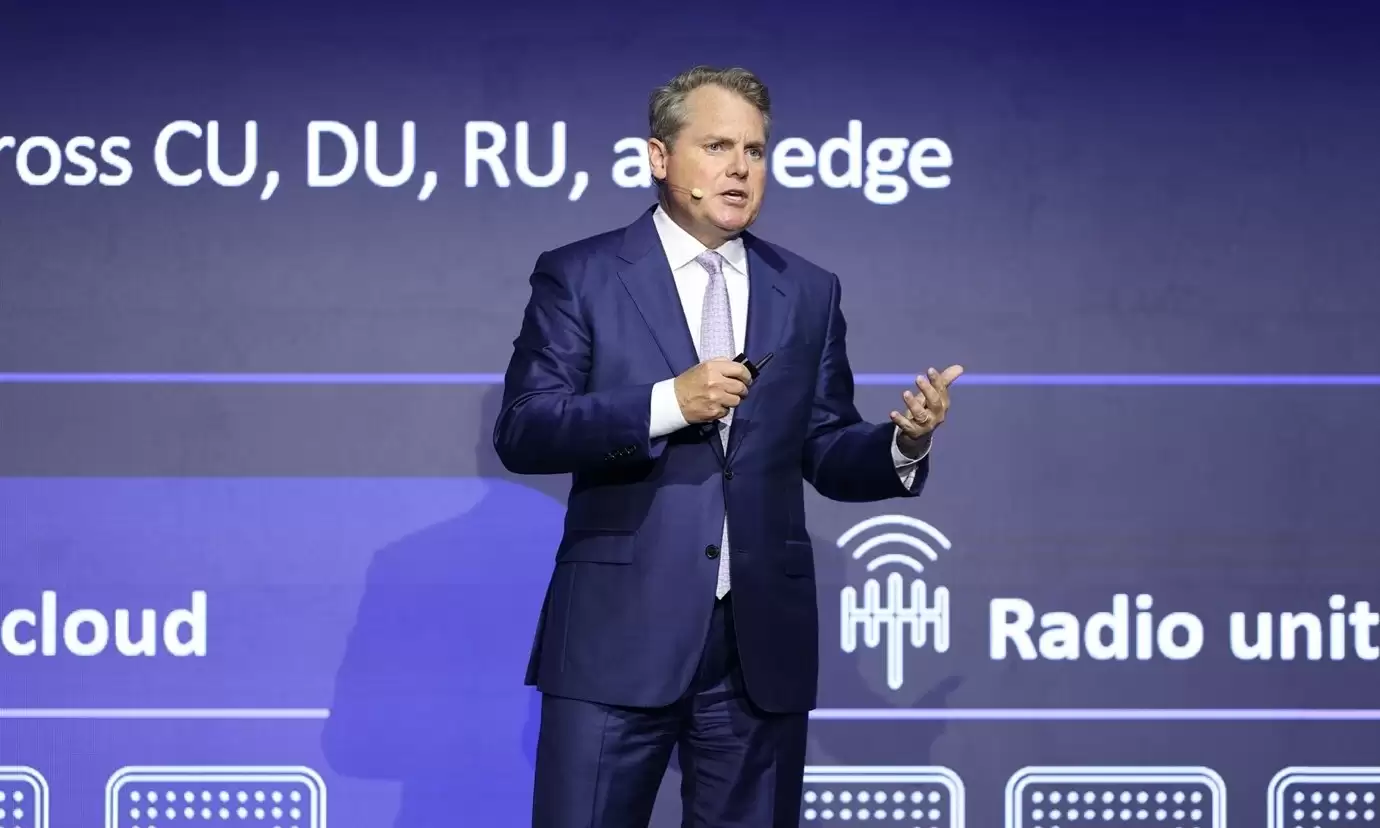
高通庄思民在2026MWC上海指出,AI智能体正重塑价值创造路径,通信从传输比特转向支撑词元流动。6G需融合连接、计算与感知,提升上行能力,构建计算连续体实现终端-边缘-云端协同。计划2028年展示预商用终端,2029年商用。
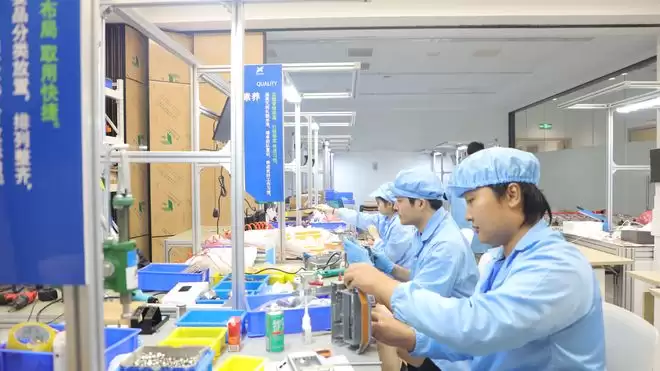
重庆首个AI智能终端共享工厂将于7月1日在两江新区明月湖科创园投产,提供一站式硬科技产品共性技术及制造服务。试运营期间,打样周期从15天压缩至3天,开发周期缩短近一半,正式投产后预计产品成功率提升30%,开发成本降低20%。
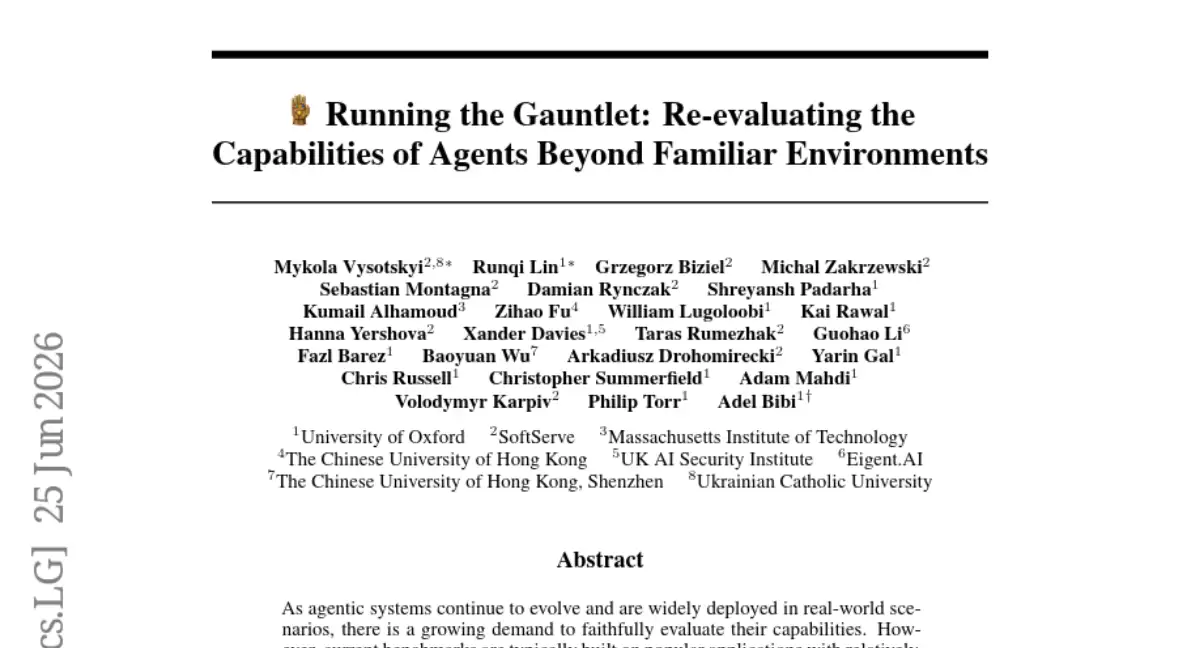
牛津大学等机构联合发布的GauntletBench测试平台显示,当前最强AI智能体在复杂任务中完成率不足20%,而普通人类完成率超80%。AI在时间感知、图形理解、三维空间推理等能力上存在明显短板,真实能力与普遍印象差距显著。
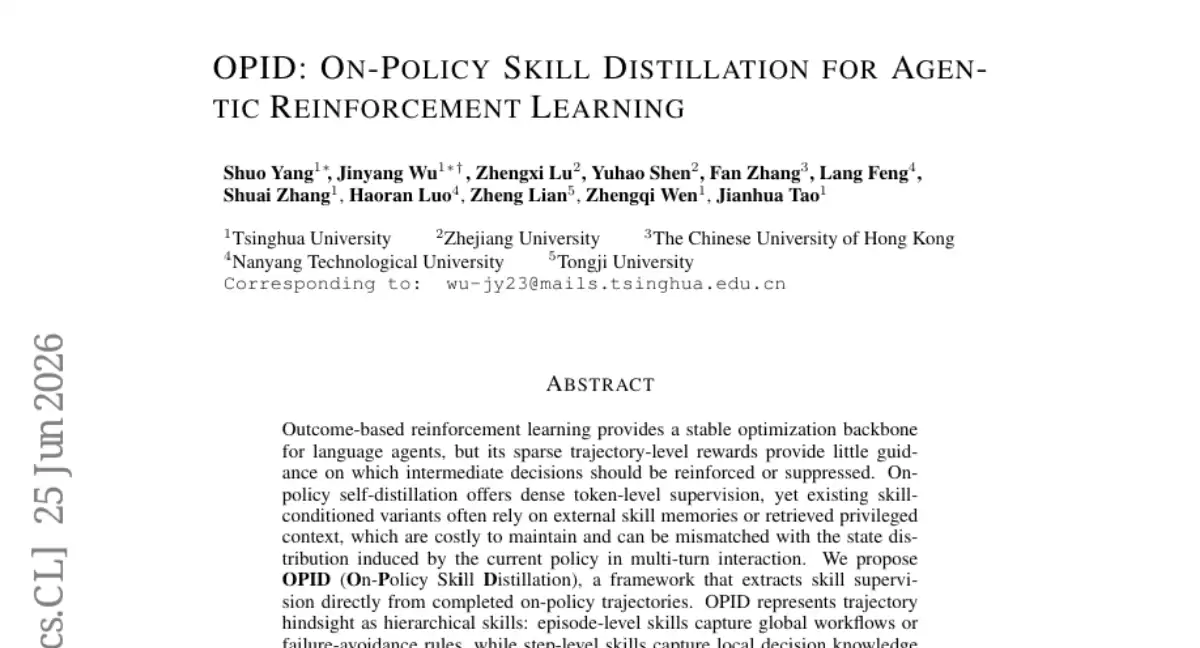
清华大学、浙江大学等高校提出OPID框架,解决AI智能体在长程任务中仅依靠最终成败信号训练的低效问题。该方法从在线轨迹中提取情节级与步骤级技能,通过关键优先路由生成密集训练信号。在ALFWorld、WebShop等基准上,OPID显著优于纯结果导向方法,小模型提升尤为明显,且技能被有效内化,具备迁移能力。
龙岗区坪地街道上线民生诉求分拨智能助手,利用自然语言识别和权责知识库,实现工单毫秒级智能分拨,解决人工派单慢、权属模糊等难题,缩短处置周期,提升精准度和群众满意度。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



