

利用知识图谱优化RAG性能,避免大模型错觉
在使用大型语言模型(LLM)时,幻觉是一个常见问题。尽管LLM可以生成流畅连贯的文本,但其生成的信息往往不准确或不一致。为了防止LLM产生幻觉,可以利用外部的知识来源,比如数据库或知识图谱,来提供事实信息。这样一来,LLM可以依赖这些可靠的数据源,从而生成更准确和可靠的文本内容。向量数据库和知识图谱向量数据库向量数据库是一组表示实体或概念的高维向量。它们可以用于度量不同实体或概念之间的相似性或相关性,通过它们的向量表示进行计算。一个向量数据库可以根据向量距离告诉你,“巴黎”和“法国”比“巴黎”和“德国”更
在使用大型语言模型(LLM)时,幻觉是一个常见问题。尽管LLM可以生成流畅连贯的文本,但其生成的信息往往不准确或不一致。为了防止LLM产生幻觉,可以利用外部的知识来源,比如数据库或知识图谱,来提供事实信息。这样一来,LLM可以依赖这些可靠的数据源,从而生成更准确和可靠的文本内容。
向量数据库和知识图谱
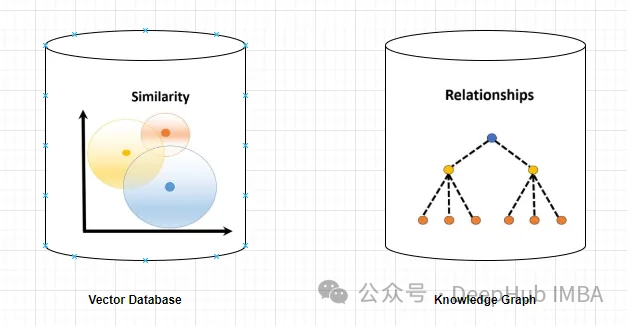
向量数据库
向量数据库是一组表示实体或概念的高维向量。它们可以用于度量不同实体或概念之间的相似性或相关性,通过它们的向量表示进行计算。
一个向量数据库可以根据向量距离告诉你,“巴黎”和“法国”比“巴黎”和“德国”更相关。
查询向量数据库通常涉及搜索相似的向量或基于特定标准的向量检索。以下是一个查询向量数据库的简单示例。
假设有一个高维向量数据库,存储了客户配置文件。您想找到与给定参考客户相似的客户。
首先,为了将客户定义为一个向量表示,我们可以提取相关特征或属性并将其转换为向量形式。
可以使用适当的算法(如k近邻或余弦相似度)在向量数据库中进行相似度搜索,以识别最相似的邻居。
检索与确定的最近邻向量对应的客户配置文件,这些概要文件表示与参考客户相似的客户,根据定义的相似性度量。
向用户展示检索到的客户配置文件或相关信息,如姓名、人口统计数据或购买历史。
知识图谱
知识图谱是表示实体或概念及其关系(如事实、属性或类别)的节点和边的集合。基于它们的节点和边缘属性,可用于查询或推断关于不同实体或概念的事实信息。
例如,一个知识图可以根据边缘标签告诉你“巴黎”是“法国”的首都。
查询图数据库涉及遍历图结构并根据特定标准检索节点、关系或模式。
假设你有一个表示社交网络的图数据库,其中用户是节点,他们的关系表示为连接节点的边。如果为给定用户找到朋友的朋友(共同联系),那么我们应该进行如下操作:
1、在图数据库中标识表示参考用户的节点。这可以通过查询特定的用户标识符或其他相关标准来实现。
2、使用图查询语言,例如Cypher(在Neo4j中使用)或Gremlin,从参考用户节点遍历图。指定要探索的模式或关系。
MATCH (:User {userId: ‘referenceUser’})-[:FRIEND]->()-[:FRIEND]->(fof:User) RETURN fof这个查询从参考用户开始,沿着FRIEND关系找到另一个节点(FRIEND),然后沿着另一个FRIEND关系找到朋友的朋友(fof)。
3、对图数据库执行查询,根据查询模式检索结果节点(朋友的朋友),可以获得关于检索节点的特定属性或其他信息。
图数据库可以提供更高级的查询功能,包括过滤、聚合和复杂的模式匹配。具体的查询语言和语法可能会有所不同,但一般的过程涉及遍历图结构以检索符合所需标准的节点和关系。
知识图谱解决“幻觉”问题的优势
知识图谱比向量数据库提供更精确和具体的信息。向量数据库表示两个实体或概念之间的相似性或相关性,而知识图可以更好地理解它们之间的关系。例如知识图谱可以告诉你“埃菲尔铁塔”是“巴黎”的地标,而向量数据库只能表明这两个概念的相似程度,但是具体他们之间如何相关的却没有说明。
知识图支持比向量数据库更多样化、更复杂的查询。向量数据库主要可以回答基于向量距离、相似性或最近邻的查询,这些查询仅限于直接的相似性测量。而知识图可以处理基于逻辑运算符的查询,例如“具有属性Z的所有实体是什么?”或“W和V的共同范畴是什么?”这可以帮助LLM产生更多样化和有趣的文本。
知识图比向量数据库更能进行推理和推断。向量数据库只能提供存储在数据库中的直接信息。而知识图可以提供从实体或概念之间的关系派生的间接信息。例如,一个知识图谱可以根据“巴黎是法国的首都”和“法国位于欧洲”这两个事实推断出“埃菲尔铁塔位于欧洲”。这可以帮助LLM生成更具逻辑性和一致性的文本。
所以知识图谱是一个比向量数据库更好的解决方案。可以为LLM提供了更准确、相关、多样、有趣、合乎逻辑和一致的信息,使它们更可靠地生成准确和真实的文本。但这里的关键是文档文档之间需要有清晰的关系,否则知识图谱将无法捕捉到它。
但是,知识图谱的使用并没有向量数据库那么直接简单,不仅在内容的梳理(数据),应用部署,查询生成等方面都没有向量数据库那么方便,这也影响了它在实际应用中的使用频率。所以下面我们使用一个简单的例子来介绍如何使用知识图谱构建RAG。
代码实现
我们需要使用3个主要工具/组件:
1、LlamaIndex是一个编排框架,它简化了私有数据与公共数据的集成,它提供了数据摄取、索引和查询的工具,使其成为生成式人工智能需求的通用解决方案。
2、嵌入模型将文本转换为文本所提供的一条信息的数字表示形式。这种表示捕获了所嵌入内容的语义含义,使其对于许多行业应用程序都很健壮。这里使用“thenlper/gte-large”模型。
3、需要大型语言模型来根据所提供的问题和上下文生成响应。这里使用Zephyr 7B beta模型
下面我们开始进行代码编写,首先安装包
%%capture pip install llama_index pyvis Ipython langchain pypdf
启用日志Logging Level设置为“INFO”,我们可以输出有助于监视应用程序操作流的消息
import logging import sys # logging.basicConfig(stream=sys.stdout, level=logging.INFO) logging.getLogger().addHandler(logging.StreamHandler(stream=sys.stdout))
导入依赖项
from llama_index import (SimpleDirectoryReader,LLMPredictor,ServiceContext,KnowledgeGraphIndex) # from llama_index.graph_stores import SimpleGraphStore from llama_index.storage.storage_context import StorageContext from llama_index.llms import HuggingFaceInferenceAPI from langchain.embeddings import HuggingFaceInferenceAPIEmbeddings from llama_index.embeddings import LangchainEmbedding from pyvis.network import Network
我们使用Huggingface推理api端点载入LLM
HF_TOKEN = "api key DEEPHUB 123456" llm = HuggingFaceInferenceAPI(model_name="HuggingFaceH4/zephyr-7b-beta", token=HF_TOKEN )
首先载入嵌入模型:
embed_model = LangchainEmbedding(HuggingFaceInferenceAPIEmbeddings(api_key=HF_TOKEN,model_name="thenlper/gte-large") )
加载数据集
documents = SimpleDirectoryReader("/content/Documents").load_data() print(len(documents)) ####Output### 44构建知识图谱索引
创建知识图谱通常涉及专业和复杂的任务。通过利用Llama Index (LLM)、KnowledgeGraphIndex和GraphStore,可以方便地任何数据源创建一个相对有效的知识图谱。
#setup the service context service_context = ServiceContext.from_defaults(chunk_size=256,llm=llm,embed_model=embed_model ) #setup the storage context graph_store = SimpleGraphStore() storage_context = StorageContext.from_defaults(graph_store=graph_store) #Construct the Knowlege Graph Undex index = KnowledgeGraphIndex.from_documents( documents=documents,max_triplets_per_chunk=3,service_context=service_context,storage_context=storage_context,include_embeddings=True)
Max_triplets_per_chunk:它控制每个数据块处理的关系三元组的数量
Include_embeddings:切换在索引中包含嵌入以进行高级分析。
通过构建查询引擎对知识图谱进行查询
query = "What is ESOP?" query_engine = index.as_query_engine(include_text=True,response_mode ="tree_summarize",embedding_mode="hybrid",similarity_top_k=5,) # message_template =f"""<|system|>Please check if the following pieces of context has any mention of the keywords provided in the Question.If not then don't know the answer, just say that you don't know.Stop there.Please donot try to make up an answer. <|user|> Question: {query} Helpful Answer: """ # response = query_engine.query(message_template) # print(response.response.split("<|assistant|>")[-1].strip()) #####OUTPUT ##################### ESOP stands for Employee Stock Ownership Plan. It is a retirement plan that allows employees to receive company stock or stock options as part of their compensation. In simpler terms, it is a plan that allows employees to own a portion of the company they work for. This can be a motivating factor for employees as they have a direct stake in the company's success. ESOPs can also be a tax-efficient way for companies to provide retirement benefits to their employees.可以看到,输出的结果已经很好了,可以说与向量数据库的结果非常一致。
最后还可以可视化我们生成的图谱,使用Pyvis库进行可视化展示
from pyvis.network import Network from IPython.display import display g = index.get_networkx_graph() net = Network(notebook=True,cdn_resources="in_line",directed=True) net.from_nx(g) net.show("graph.html") net.save_graph("Knowledge_graph.html") # import IPython IPython.display.HTML(filename="/content/Knowledge_graph.html")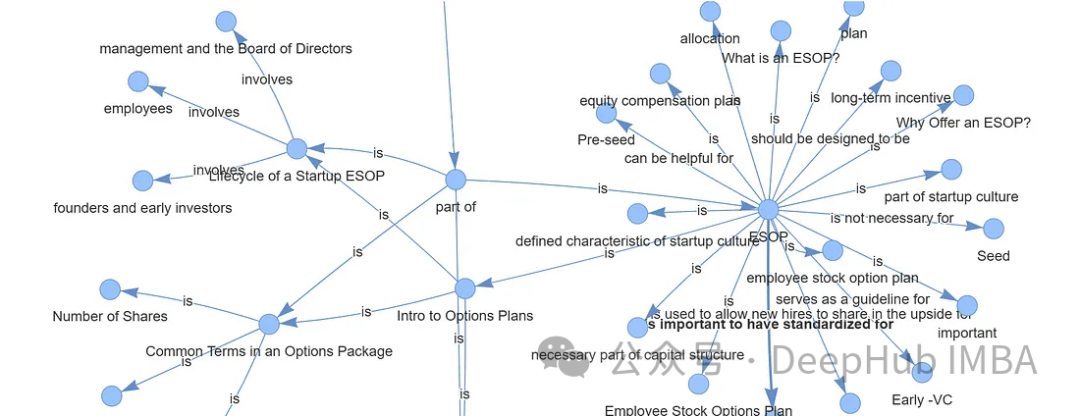
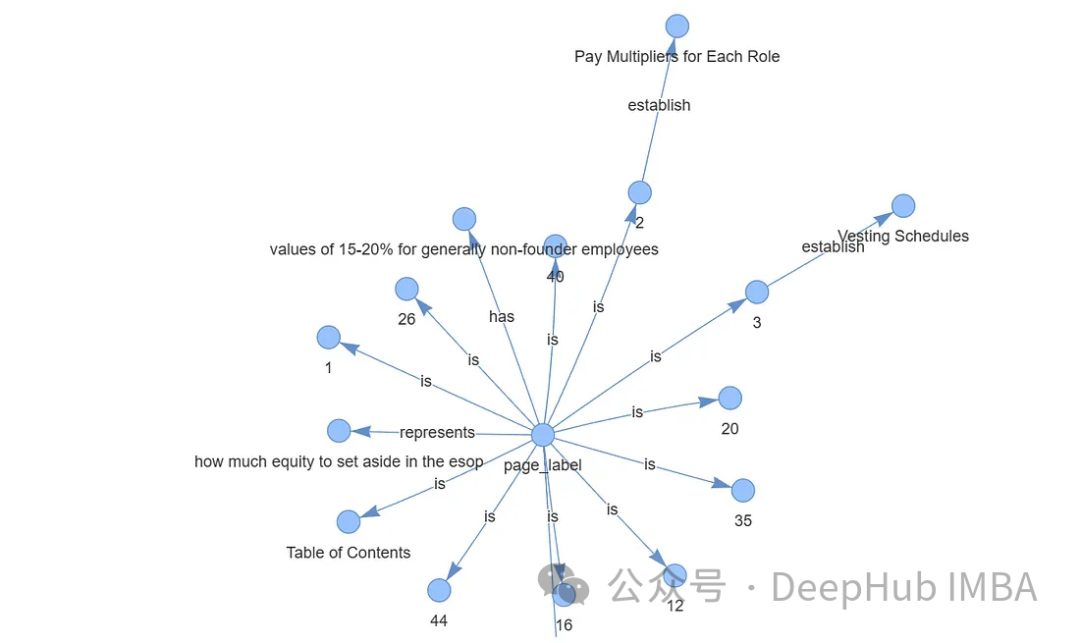
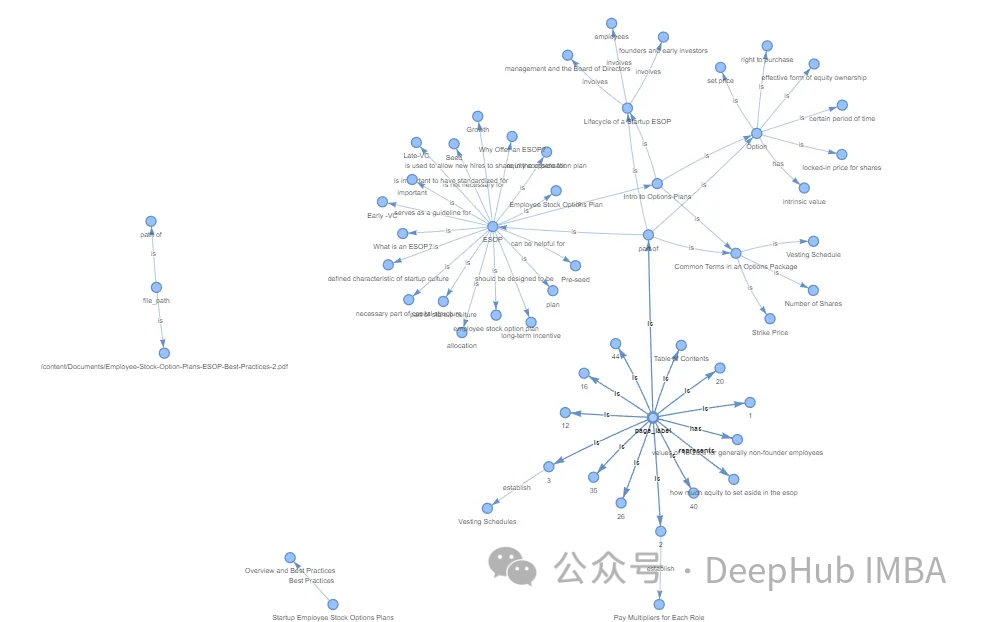
通过上面的代码我们可以直接通过LLM生成知识图谱,这样简化了我们非常多的人工操作。如果需要更精准更完整的知识图谱,还需要人工手动检查,这里就不细说了。
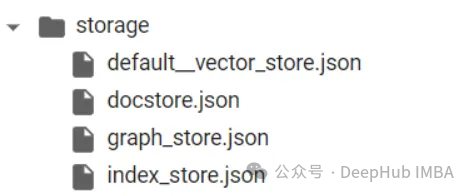
数据存储,通过持久化数据,可以将结果保存到硬盘中,供以后使用。
storage_context.persist()
存储的结果如下:
总结
向量数据库和知识图谱的区别在于它们存储和表示数据的方法。向量数据库擅长基于相似性的操作,依靠数值向量来测量实体之间的距离。知识图谱通过节点和边缘捕获复杂的关系和依赖关系,促进语义分析和高级推理。
对于语言模型(LLM)幻觉,知识图被证明优于向量数据库。知识图谱提供了更准确、多样、有趣、有逻辑性和一致性的信息,减少了LLM产生幻觉的可能性。这种优势源于它们能够提供实体之间关系的精确细节,而不仅仅是表明相似性,从而支持更复杂的查询和逻辑推理。
在以前知识图谱的应用难点在于图谱的构建,但是现在LLM的出现简化了这个过程,使得我们可以轻松的构建出可用的知识图谱,这使得他在应用方面又向前迈出了一大步。对于RAG,知识图谱是一个非常好的应用方向。
大型语言模型(LLM)是在巨大的文本数据库上训练的,在那里它们获得了大量的实际知识。这些知识嵌入到它们的参数中,然后可以在需要时使用。这些模型的知识在训练结束时被“具体化”。在预训练结束时,模型实际上停止学习。对模型进行对齐或进行指令调优,让模型学习如何充分利用这些知识,以及如何更自然地响应用户的问题。但是有时模型知识是不够的,尽管模型可以通过RAG访问外部内容,但通过微调使用模型适应新的领域被认为是有益的。这种微调是使用人工标注者或其他llm创建的输入进行的,模型会遇到额外的实际知识并将其整合到参数中。
大型语言模型(LLM)已成为各种规模企业的游戏规则改变者,但它们对初创企业的影响尤为显著。为了理解其中的原因,让我们来看看初创企业相对于老牌企业有哪些优势,以及为什么AI是它们的重要推动力。首先,与传统企业相比,初创企业有更大的灵活性。它们通常没有过多的层级和繁琐的决策程序,可以更迅速地适应市场变化和顾客需求。这种敏捷性使得初创企业能够更快地推出新产品和服务,并灵活调整战略。其次,初创企业通常更加创初创企业往往面临预算有限、时间紧迫的局面,即便是规模更大的行业参与者也可能争夺的是规模更大的行业参与者可能争
从非结构化文本中提取有价值的信息是金融行业的关键应用。然而,这项任务往往超出了简单的数据提取,需要高级推理能力。一个典型的例子是确保信贷协议中的到期日,这通常涉及及时遵守和破译一个复杂的指令,如“到期日应在生效日期三周年之前的最后一个工作日”。这种级别的复杂推理对大型语言模型(LLM)提出了挑战。它需要结合外部知识,如假日日历,以准确地解释和使用给定的指示。集成知识图是一种很有前途的解决方案,具有几个关键优势。Transformer的出现彻底改变了文本矢量化,实现了前所未有的精度。这些嵌入封装了深刻的语义
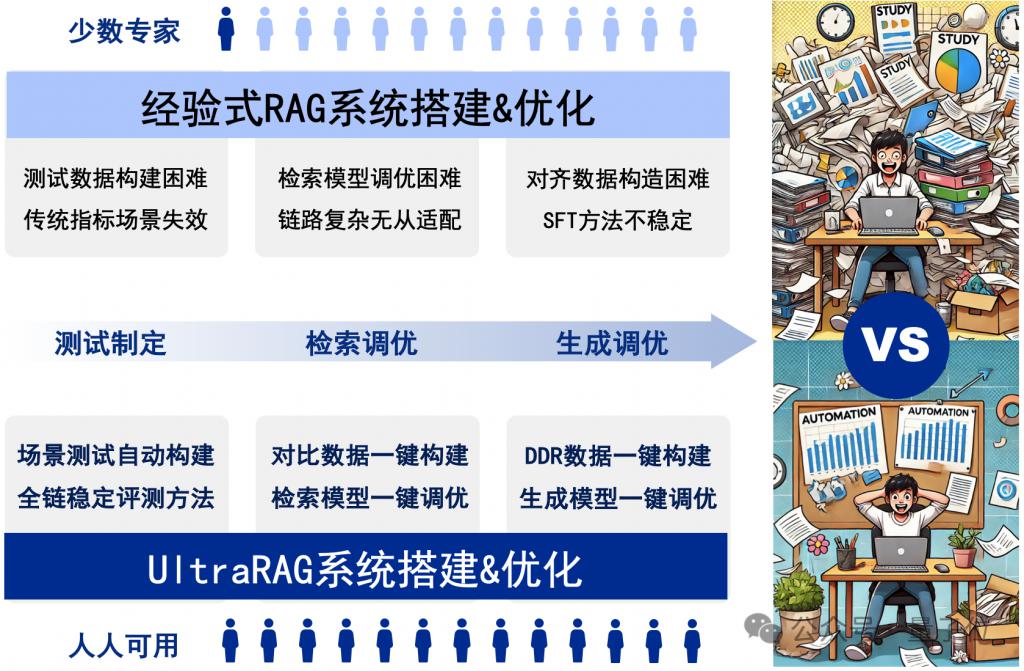
清华大学THUNLP团队联合多家机构推出UltraRAG框架,简化RAG系统搭建流程。传统RAG系统搭建复杂,UltraRAG框架提供“单反相机”级精细化配置和“卡片机”级一键式操作,显著降低学习成本和开发周期。UltraRAG框架的核心优势在于其对模型与知识库的适配,避免了反复的模型选型。其模块化设计也方便科研人员快速迭代。用户可轻松完成数据到模型的全流程管理。零代码WebUI,一键式数据构建UltraRAG的零代码WebUI是其一大亮点,即使没有编程经验的用户也能轻松构建、训练和评估模型。框架
想了解更多AIGC的内容,请访问:51CTOAI.x社区https://www.51cto.com/aigc/简介生成类似人类的文本和语音曾经只有在科幻小说中才成为可能。但是,GPT-3和PaLM等大型语言模型(LLM)的快速发展使得这一愿景更接近现实,并且相应地出现一系列基于它们的聊天机器人到内容创建等领域颇有前景的商业应用程序。然而,通用的基础模型往往无法满足特定行业场景的具体需求。企业对其生成的人工智能应用程序有不同的要求,涉及到从性能、成本、延迟性乃至可解释性等诸多方面。此外,可用于模型训练的数据
想了解更多AIGC的内容,请访问:51CTOAI.x社区https://www.51cto.com/aigc/提示的力量十分神奇,我们只需抛出几个近似人类语言的单词,就能得到一个格式和结构都良好的答案。没有什么话题是晦涩难懂的,没有什么事实是触不可及的。至少只要它是训练语料库的一部分,并得到模型的影子控制器(ShadowyController)的批准,我们都能通过简单的提示获取到答案。然而,一些人已经开始注意到提示的魔力并非绝对的。我们的提示并非总能产生我们想要的结果。甚至有些提示语言要比其他的更有效。究
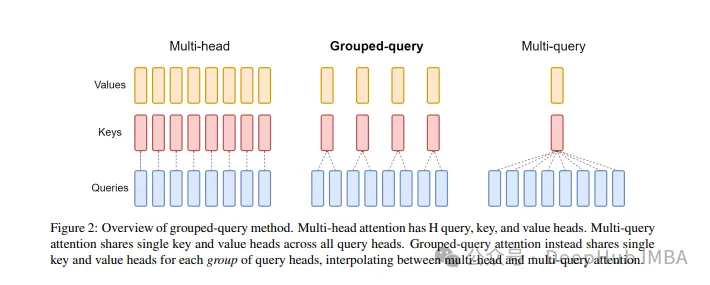
组查询注意力(GroupedQueryAttention)是大型语言模型中的一种多查询注意力力方法,它的目标是在保持MQA速度的同时实现MHA的质量。GroupedQueryAttention将查询分组,每个组内的查询共享相同的注意力权重,这有助于降低计算复杂度和提高推理速度。这篇文章中,我们将解释GQA的思想以及如何将其转化为代码。GQA是在论文GQA:TrainingGeneralizedMulti-QueryTransformerModelsfromMulti-HeadCheckpointspape
出品|51CTO技术栈(微信号:blog51cto)昨天,普林斯顿的CS/NLP硕士生JohnYang在Github上开源了一款比Devin更优秀的工具。不久之后,在Github上斩获了1.3k星,异常生猛。据悉,4月10日,详细的技术论文将会公开!图片1.让语言模型秒变编程Agent!SWE-agent是一款用于自主解决Github存储库问题的新系统,在SWE-bench上取得了与Devin相似的准确度,平均耗时只有93s,而且重要的是,开源!!图片此外,SWE-agent通过与专用终端交互来工作,这使
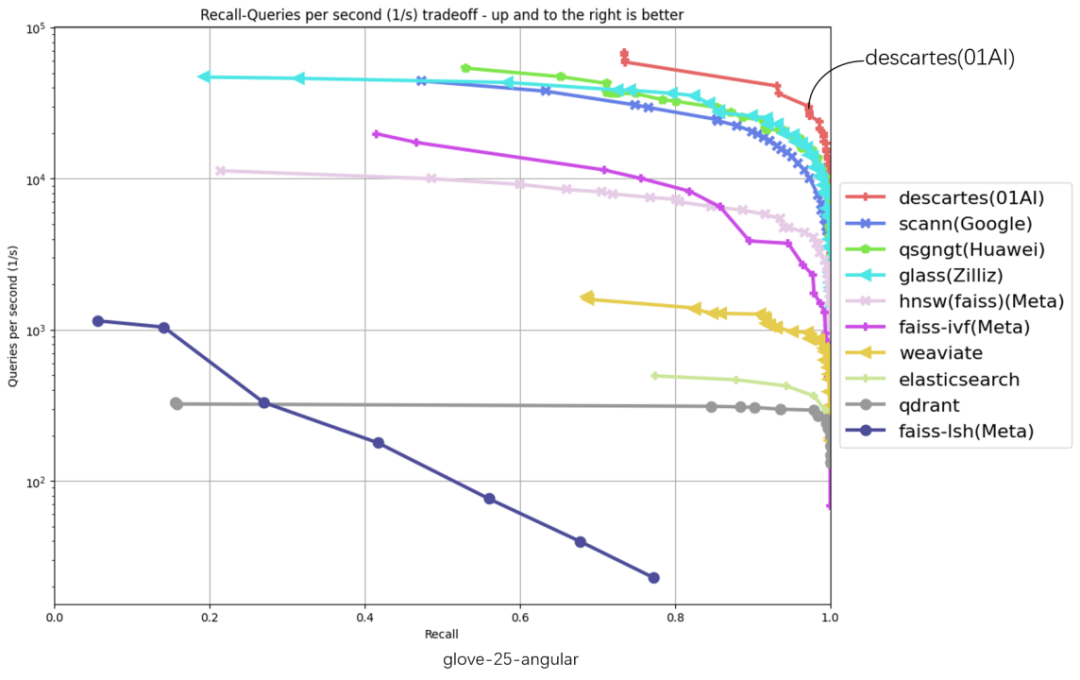
3月11日,零一万物宣布推出基于全导航图的新型向量数据库「笛卡尔(Descartes)」,已包揽权威榜单ANN-Benchmarks6项数据集评测第一名。向量数据库,又被称为AI时代的信息检索技术,是检索增强生成(Retrieval-AugmentedGeneration,RAG)内核技术之一。对大模型应用开发者来说,向量数据库是非常重要的基础设施,在一定程度上影响着大模型的性能表现。在国际权威评测平台ANN-Benchmarks离线测试中,零一万物笛卡尔(Descartes)向量数据库登顶6份数据集评测
译者|晶颜审校|重楼业务领导者一直深感压力,他们需要找到将生成式人工智能(GenAI)纳入其战略的最佳方式,以便为其组织和利益相关者带来最佳收益。根据Gartner的调查,38%的业务领导者指出,客户体验和留存率是他们投资GenAI的主要目的,这对其业务的未来至关重要。然而,尽管这看起来很诱人,但在制定人工智能战略之前,考虑LLM是否适合您的业务同样至关重要。虽然市场上的LLM选项很多且易于访问,但有效使用现成的LLM却存在诸多挑战。这些问题包括缺乏个性化的客户体验,外包嵌入模型的成本增加,以及由于与外部





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



