

在开发大规模语言模型(LLM)之前需要考虑的五个重要问题
译者|晶颜审校|重楼业务领导者一直深感压力,他们需要找到将生成式人工智能(GenAI)纳入其战略的最佳方式,以便为其组织和利益相关者带来最佳收益。根据Gartner的调查,38%的业务领导者指出,客户体验和留存率是他们投资GenAI的主要目的,这对其业务的未来至关重要。然而,尽管这看起来很诱人,但在制定人工智能战略之前,考虑LLM是否适合您的业务同样至关重要。虽然市场上的LLM选项很多且易于访问,但有效使用现成的LLM却存在诸多挑战。这些问题包括缺乏个性化的客户体验,外包嵌入模型的成本增加,以及由于与外部
译者 | 晶颜
审校 | 重楼
业务领导者一直深感压力,他们需要找到将生成式人工智能(GenAI)纳入其战略的最佳方式,以便为其组织和利益相关者带来最佳收益。根据Gartner的调查,38%的业务领导者指出,客户体验和留存率是他们投资GenAI的主要目的,这对其业务的未来至关重要。然而,尽管这看起来很诱人,但在制定人工智能战略之前,考虑LLM是否适合您的业务同样至关重要。
虽然市场上的LLM选项很多且易于访问,但有效使用现成的LLM却存在诸多挑战。这些问题包括缺乏个性化的客户体验,外包嵌入模型的成本增加,以及由于与外部共享数据而引发的隐私问题。训练内部AI模型可以直接解决这些问题,同时还可以激发团队内部的创造力和创新精神,以便将该模型用于其他项目。一旦您决定需要一个特定领域的人工智能,那么在开始创建自己的内部模型之前,您应该先问问自己以下五个关键问题。
问题1:您面临的业务问题是什么?人工智能如何解决这个问题?
在深入研究基础模型和LLM之前,首先需要明确自己要解决的问题。这一步将有助于更好地确定所需的自然语言处理任务,例如摘要生成、命名实体识别、语义文本相似性和问答系统等。确定问题的关键点有助于为研究和应用提供方向,并确保选择适合的工具和方法来解决问题。
理解下游任务(Downstream Task)和领域意识(Domain Awareness)之间的差异至关重要。虽然像GPT、Llama和PaLM这样的LLM模型在下游任务(如问答和总结)中表现出色,但它们通常需要很少的提示或微调。这些基础模型可能在广泛的上下文中表现良好,但它们缺乏运行于大多数应用程序中所需的特定行业或业务领域的专业知识。因此,在取得下游任务方面的巨大成就并不能保证其在您特定行业中具备领域意识。
问题2:是否已有特定于行业的人工智能工具可用?
作为人工智能战略研究阶段的一部分,密切评估现有工具非常重要,因为其中一些工具可能是针对特定行业的,但仍忽略了您业务的具体细微差别。当审计可用的工具时,重点是确保AI模型能够理解上下文,以及您所选语言中的单词,以最好地掌握提示并生成与用户相关的响应。
举个例子,一家公司在经过研究和测试后发现,缺乏专门针对第三方风险的强大网络安全LLM。因此,其团队便选择了一个基于BERT的模型来进行网络安全微调。此外,在构建人工智能模型时,他们注意到,当分析网络安全领域的各种文本时,结果始终落在一个特定的范围内。分析后发现其使用的基础模型将文本视为同质的,并将相似性归因于其源自同一领域。最终,他们努力为模型提供了网络安全行业的背景和细微差别,才成功解决了LLM模型缺乏领域意识的问题。
除此之外,上下文/情境也很重要,因为即使在今天,GenAI在特定问题上也会产生“幻觉”,不应该100%信任。这也是拜登-哈里斯政府发布关于安全、可靠和值得信赖的人工智能的行政命令的众多原因之一。在使用人工智能工具作为服务之前,政府机构需要确保他们使用的服务是安全和值得信赖的,这一点通常并不明显,也无法通过查看示例输出集来捕获。虽然行政命令不适用于私营企业,但这些组织如果要采取类似的政策,也应该考虑到这一点。
尽管与内部模型相关的训练和微调过程将包括彻底的测试、弱点识别和模型分析,并且相当漫长,但从长远来看,这是值得的。
问题3:您的数据准备好了吗?
在训练自己的LLM之前,组织的数据是最重要的资产。随着时间的推移,那些积累了高质量数据的公司在今天的LLM时代无疑是最幸运的,因为几乎每个过程的每一步都需要数据,包括训练、测试、再训练和beta测试。在训练LLM时,高质量的数据是成功的关键,因此考虑这真正意味着什么很重要。答案当然会根据任务和领域的不同而变化,但一般规则是,需要最少管理和更少再训练的数据。
一旦公司开始训练LLM,他们通常会发现其数据在很多方面还没有准备好。由于专家选择不佳或分配给专家的时间有限,数据可能会变得过于嘈杂,或无效标记。或者数据可能包含隐藏的重复,这些重复对训练过程提供最小(甚至没有)的价值,并且不能完全代表领域或任务,这可能导致最终的AI模型过拟合(overfit)。
数据很容易成为项目的瓶颈,这一点很重要,因为它需要花费大量的时间来组织。有时,甚至可能需要数年时间,数据才能真正为人工智能做好准备。
问题4:您有足够的专家来训练人工智能模型吗?
专家在生成数据和确定数据质量方面发挥着重要作用。因为我们仍然需要人类来生成可靠的数据,这些数据将在训练过程中使用。合成生成的数据集确实存在,但除非经过人类专家的评估和鉴定,否则这些数据集是没有用的。
在选择专家时,建议选择具有深厚行业知识的人(内部专家或外包专家)来微调您的模型。更具体地说,您将需要专家来标记数据,给出关于数据的反馈,测试数据,并根据反馈进行再训练。这是通过训练有素的人工智能模型获得准确、可靠结果的重要部分。
问题5:您的时间限制是什么?
训练内部人工智能模型是一个昂贵而漫长的过程。业务问题、现成可用数据的质量以及所涉及的专家和人工智能工程师的数量都会影响项目的长度和质量。因为这个过程依赖于试错,所以在解决方案准备好使用之前需要更长的时间。
除了可能源于数据的问题之外,在设置训练算法的超参数(hyperparameter)时还可能出现其他挑战,例如学习率、epoch数量和层数。这就是人工智能专家可能需要重新设计的地方,以解决在测试阶段明显出现的过拟合和灾难性遗忘问题,这可能会花费项目额外的时间。
尽管经过深思熟虑的过程可以减少压力,但始终存在出现新LLM解决方案淘汰旧解决方案的风险。考虑到人工智能技术的快速发展,组织需要在时机和质量之间寻求平衡。
与许多创新解决方案一样,没有“放之四海而皆准”的方法。在开始公司的人工智能之旅时,权衡适合您业务的模型是第一步。对于业务领导者来说,从头开始训练LLM可能听起来令人望而生畏,但如果您有通用LLM无法解决的特定领域的“业务问题”,那么从长远来看,这将是值得投资的选择。
原文标题:Is creating an in-house LLM right for your organization?,作者: Gokcen Tapkan
想了解Claude怎么收费?本文梳理了Claude Free、Pro及Team版的最新月费价格、消息限额与高级功能权益,并对比了不同层级的性价比,助你快速找到适合的AI办公伙伴。

本文详细解析Sora在国内的使用现状,指出目前官方未对公众开放注册,提醒用户警惕虚假链接,并提供关注官方动态及替代方案的实用建议。
南京邮电大学“光擎智算”团队联合南京大学,攻克GaN基Micro-LED器件技术,成功搭建实验室级光计算验证系统。团队自主研发的5×5 Micro-LED光电计算阵列芯片已进入流片封装阶段,实现了图像识别等算力任务验证,推动光计算技术从理论走向工程落地。

苹果与铠侠签署为期3-5年的NAND闪存长期供应协议,且可能不设价格上限。此举旨在应对AI数据中心需求激增导致的芯片供应紧张,从单纯压价转向确保稳定供货。
一项研究揭示大语言模型在文本嵌入任务中表现平庸的根源:反嵌入矩阵边缘频谱引入高频词偏见。提出的EmbedFilter方法通过滤除该噪声,在MTEB49项任务上显著提升性能,且无需重新训练,兼容多种基线方法。
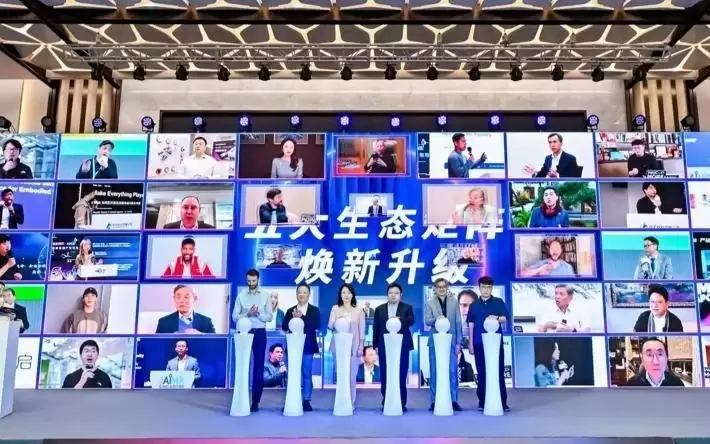
2026年世界人工智能大会将于7月17日至20日举办,超过300款人工智能新品全球首发,1400多位嘉宾参会,近140场论坛,展览面积超过10万平方米,促成意向合作金额达162亿元,并且推出首个自主举办的国际顶级人工智能学术会议。
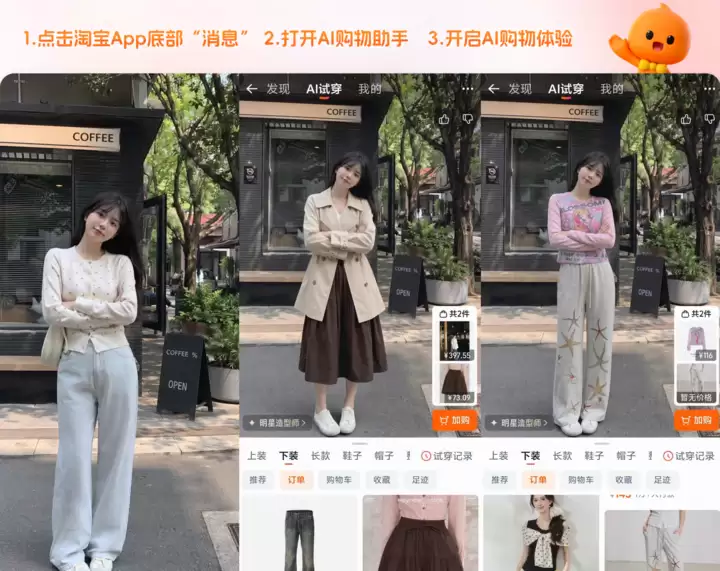
618”期间,AI全面渗透电商,超百万商家使用AI工具提升效率。政策补贴拉动绿色智能家电及汽车消费,市场回暖。供应链升级实现仓配一体化,时效大幅提升,多链协同激活内需活力。
AI生成作品虽完美却缺乏“活人感”,这一悖论贯穿艺术史。《红楼梦》中已批判套路化创作。真正活人感源于创作者内化形式美规律后的即兴发挥与平衡,而非单纯拒绝美化。能否尊重生活细节、容忍碰撞,决定作品是否鲜活,这也是艺术的根本功用。
商务部等8部门发布《关于加快“人工智能+消费”发展的实施意见》,围绕服务消费和商品消费两大领域,明确居家、养老、文旅、教育等场景的AI应用方向,推广智能家居、养老机器人等产品,并适度超前布局城市智能设施。
商汤与香港科技园合作共建国产AI算力中心,目标2030年前实现超40000P算力规模,首阶段预计今年完成。该中心配备国产GPU集群,支撑模型训练与推理,服务本地及国际客户。商汤临港AIDC已有4.04万P算力运营经验。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



