

Java实现字节数组转int(IEEE754标准)的完整指南
在计算机的世界里,数据如何存储和解释,往往比我们想象的要复杂。就拿浮点数来说,IEEE 754标准定义了它的数学灵魂,但如何把这串灵魂的二进制编码塞进内存,却引出了另一个经典问题——字节序。当我们在Ja va中试图将一段字节数组还原成一个整数(或浮点数)时,本质上是在进行一次“跨边界的数据语义重建”
在计算机的世界里,数据如何存储和解释,往往比我们想象的要复杂。就拿浮点数来说,IEEE 754标准定义了它的数学灵魂,但如何把这串灵魂的二进制编码塞进内存,却引出了另一个经典问题——字节序。当我们在Ja va中试图将一段字节数组还原成一个整数(或浮点数)时,本质上是在进行一次“跨边界的数据语义重建”。今天,我们就来深入聊聊这个过程,从IEEE 754的底层结构开始,结合Ja va平台的特性,把字节数组转int的机制、字节序的影响以及工程实践中的那些关键点,一次讲清楚。
一、IEEE 754 标准:浮点数的二进制语义
IEEE 754标准,堪称是浮点数运算领域的“世界语”。它不仅仅规范了硬件如何实现,更是跨平台数据交换的通用协议。要想玩转字节数组转换,吃透它的结构是第一步。
1. 单精度浮点数(32 位)的三段式结构
一个32位的float类型数值,其二进制被清晰地划分为三个功能区:
- 符号位(Sign,1 位):占据最高位(第31位),0代表正数,1代表负数。这个设计非常直观,判断正负和整数一样简单。
- 指数域(Exponent,8 位):这里采用了“偏移码”的表示法,偏移量是127。也就是说,你看到的存储值减去127,才是实际的指数值。这么做的好处显而易见:指数可以表示正负,省去了单独的符号位;同时,这种编码方式让数值比较变得更容易(指数大的数通常绝对值也更大),还为特殊值预留了编码空间。
- 尾数域(Mantissa/Significand,23 位):这里存储的是有效数字的小数部分。这里有个关键技巧:对于规范化数,最高位的1是隐含的,不直接存储。这23位尾数,加上那个隐含的整数位,共同提供了大约7位十进制数字的精度。
2. 特殊值的编码约定
IEEE 754的精妙之处还在于它定义了几个特殊的“居民”:
- 零:指数和尾数全为0,靠符号位区分+0和-0。
- 无穷大:指数全为1,尾数全为0,同样有正负之分。
- NaN(非数):指数全为1,尾数非0,用来表示像0除以0这类非法运算的结果。
- 非规范化数:指数全为0,尾数非0。这是为了表示那些极其接近零的数,防止数值下溢时突然变成零,从而实现了精度的平滑损失。
在进行字节数组转换时,这些特殊值的位模式必须被完整无误地保留,任何改动都可能导致数值意义的彻底错乱。
二、字节序:内存排列的隐形契约
字节序,可以说是理解字节数组转换时最大的“拦路虎”。同样一个32位的数据,在不同架构的计算机内存里,字节的排列顺序可能完全相反。
1. 大端序(Big-Endian)
高位字节存放在低地址。举个例子,数值0x12345678在内存中是这样排列的:
地址+0: 0x12
地址+1: 0x34
地址+2: 0x56
地址+3: 0x78
这种顺序和我们人类书写数字的习惯一致(从左到右,高位在前),因此被广泛用于网络协议(如TCP/IP)和许多文件格式(如Ja va类文件、JPEG图像),也被称为“网络字节序”。
2. 小端序(Little-Endian)
低位字节存放在低地址。同样的0x12345678,排列就变成了:
地址+0: 0x78
地址+1: 0x56
地址+2: 0x34
地址+3: 0x12
小端序在x86/x64架构的CPU中占统治地位,其历史渊源可以追溯到早期硬件加法器从低位开始处理的自然流程。
3. 混合端序与位序
除了这两种主流,还有一些特殊情况。比如某些架构(如ARM)支持可配置的字节序。更古老的系统甚至采用混合顺序。此外,理论上还存在“位序”的概念,即单个字节内部位的排列方向,不过在现代系统中,它通常与字节序保持一致。
4. Ja va 的平台立场
Ja va虚拟机规范明确要求采用大端序作为类文件和网络数据的标准格式。像ja va.io.DataInputStream和ja va.nio.ByteBuffer这类API,默认都按照大端序来解析多字节数值。这一设计巧妙地屏蔽了底层硬件的差异,是Ja va实现“一次编写,到处运行”承诺的重要基石。当然,这也意味着当Ja va程序需要处理来自小端序系统(比如一个C++程序)的数据时,开发者必须手动进行字节顺序的调整。
三、字节数组到 int 的语义重建
在Ja va里,一句“把字节数组转成int”,背后可能对应着两条完全不同的技术路径,必须根据业务场景仔细区分。
1. 路径一:原始位模式的直接解释
简单来说,就是把4个字节按照特定的字节序拼成一个32位的int,不涉及任何数值语义的转换。这适用于:
- 解析原始二进制协议头。
- 读取文件格式中的长度字段或标志位。
- 进行底层的位操作和掩码分析。
走这条路径,字节数组的内容被直接当作整数的二进制补码表示。例如,字节序列[0x00, 0x00, 0x00, 0x41](大端序)直接对应int值65。
2. 路径二:IEEE 754 浮点语义的重解释
这才是标题中“采用IEEE 754标准”的核心。即先把4个字节按照IEEE 754标准解释成一个float值,然后再考虑如何得到int。这里又细分为两种子情况:
- 子路径 A:数值转换。将float的数学值通过取整或截断,变成一个int。比如,3.14f会变成3。这个过程必然伴随精度损失,并且需要处理溢出(浮点数超出int范围)和NaN的映射问题。
- 子路径 B:位模式重解释。保持32位二进制模式纹丝不动,只是改变Ja va类型系统看待它的方式。也就是说,把float的底层位模式,原封不动地当作一个int来解释。在Ja va中,这可以通过
Float.floatToIntBits()或Float.floatToRawIntBits()来实现,前者会将所有NaN规范化为同一种表示,后者则保留NaN原始的位模式差异。
我们讨论的重点,正是路径二中的位模式重解释。它要求严格遵循IEEE 754的编码规则,确保字节序列被精准地重建为浮点数的语义,然后再通过类型系统映射为int的位模式。
四、Ja va 平台的转换机制
1. 标准库的支持
Ja va为这类转换提供了多层次、全方位的API支持:
DataInput 接口DataInputStream提供了readInt()、readFloat()等方法,默认按大端序解析。这是处理标准网络数据流最直接的方式。
ByteBuffer 与 NIOja va.nio.ByteBuffer是现代Ja va中更灵活、更强大的选择:
- 可以通过order(ByteOrder)方法显式设置字节序。
- 支持直接缓冲区(Direct Buffer),减少JVM堆与原生内存之间的数据拷贝。
- 提供了getInt()、getFloat()、asIntBuffer()、asFloatBuffer()等多种视图方法,方便以不同“视角”读取同一块数据。
位运算手动组合
最底层的方式是手动进行移位和或运算:((bytes[0] & 0xFF) << 24) | ((bytes[1] & 0xFF) << 16) | ...。这种方式性能最优(JIT编译器可以对其进行高度优化),但代码冗长且容易出错。
2. 类型重解释的安全边界
Ja va作为一门类型安全的语言,禁止直接的指针类型转换。因此,float到int的位模式重解释,必须通过官方提供的API这座“桥梁”来完成:
Float.intBitsToFloat(int bits):将int的位模式重新解释为float。Float.floatToIntBits(float value):将float转换为规范化的int位模式。Float.floatToRawIntBits(float value):保留NaN的原始位模式,不做规范化处理。
五、代码实现
/**
 * 字节数组转int
 * 采用IEEE 754标准
 *
 * @param bytes
 * @return float
 */
public int bytesToInt(byte[] bytes) {
    // 获取字节数组转化成的2进制字符串
    String binaryStr = bytesToBinaryStr(bytes);
    // 符号位S
    Long s = Long.parseLong(binaryStr.substring(0, 1));
    // 指数位E
    Long e = Long.parseLong(binaryStr.substring(1, 9), 2);
    // 位数M
    String length = binaryStr.substring(9);
    float m = 0, a, b;
    for (int i = 0; i < length.length(); i++) {
        a = Integer.valueOf(length.charAt(i));
        b = (float) Math.pow(2, i + 1);
        m = m + (a / b);
    }
    Float f = (float) ((Math.pow(-1, s)) * (1 + m) * (Math.pow(2, (e - 127))));
    return (int) (f * 100);
}
/**
 * 将字节数组转换成2进制字符串
 *
 * @param bytes
 * @return
 */
public String bytesToBinaryStr(byte[] bytes) {
    StringBuilder binaryStr = new StringBuilder();
    for (int i = 0; i < bytes.length; i++) {
        String str = Integer.toBinaryString((bytes[i] & 0xFF) + 0x100).substring(1);
        binaryStr.append(str);
    }
    return binaryStr.toString();
}
六、关键场景与工程实践
1. 网络协议解析
解析自定义二进制协议时,协议规范通常会明确定义每个字段的字节序和数值类型。例如,一个4字节字段声明为“大端序 IEEE 754 float”,那么处理流程就很清晰:
- 按照协议指定的字节序读取4个字节。
- 将其组合为float值(或者直接获取其int位模式用于校验)。
- 根据业务需求,决定是保留浮点语义进行后续计算,还是将其转换为整数值。
2. 跨语言数据交换
当Ja va系统需要与C/C++、Python或嵌入式C系统交换二进制数据时,双方必须在以下几个方面严格对齐:
- 字节序约定:Ja va默认大端,而x86平台的C程序通常是小端。
- 结构对齐规则:C编译器可能会在结构体成员间插入填充字节,而Ja va的布局通常是紧凑的。
- 类型宽度:确保int和float在双方都是32位(某些嵌入式平台可能使用非标准长度)。
3. 文件格式处理
许多专业文件格式使用IEEE 754存储采样值,例如:
- WA V音频文件的采样数据通常是小端序的float或int。
- TIFF图像文件支持多种字节序,并在文件头中明确标识。
- NetCDF/HDF等科学数据格式,通常采用大端序作为跨平台标准。
解析这些格式时,必须根据文件头中的元数据,动态调整字节序和类型解释策略。
4. 加密学与哈希运算
在实现某些特定的加密算法(例如基于浮点型噪声的生成器,或利用IEEE 754位模式进行混淆的技术)时,需要精确地控制浮点数的位模式。这时,通过字节数组精确构造出特定的float位模式,再将其转换为int进行后续的位运算,就成了实现算法的关键步骤。
七、精度、边界与异常处理
1. NaN 与无穷大的传播
IEEE 754定义了多种NaN位模式。Float.floatToIntBits()方法会将所有NaN统一规范化为一种表示(0x7fc00000),而floatToRawIntBits()则会保留原始的位差异。在需要区分不同NaN来源的场景(比如硬件调试或协议诊断),必须使用后者。
2. 下溢与渐进精度损失
当浮点数值无限接近零时,非规范化数(Denormalized Numbers)提供了渐进式的精度损失,而不是突然归零。在字节数组转换中,必须完整保留这些非规范化数的位模式,任何过早的规范化处理都会导致数值失真。
3. 溢出与饱和策略
将float转为int数值时,对于那些超出int范围(-2³¹ 到 2³¹-1)的浮点数,必须明确定义处理策略:
- Ja va的强制类型转换
(int)floatValue会向零截断,溢出时会发生回绕。 - 某些场景可能需要饱和处理,即限制在int的最大值或最小值。
- 另一些场景则可能要求抛出异常或返回一个特殊的标记值。
4. 字节数组长度校验
转换前的长度校验是必不可少的防御性编程。对于32位的int或float,要求输入字节数组的长度恰好是4个字节。长度不足时应抛出异常或返回错误;长度超出时,也需要明确是截断前4个字节、忽略多余字节,还是直接报错。
八、性能优化策略
1. 避免自动装箱
在需要批量转换数据的场景中,频繁使用Float和Integer包装类会导致大量的临时对象创建,增加GC压力。应优先使用原始类型数组(int[]、float[]、byte[]),仅在必要时才转换为包装类。
2. 直接缓冲区的零拷贝
使用ByteBuffer.allocateDirect()分配的缓冲区位于JVM堆外,可以通过JNI直接与原生代码交互,避免了数据在Ja va堆与原生内存之间的复制。这对于高频I/O操作或大规模数据处理,性能提升非常显著。
3. JIT 编译器的优化
Ja va的JIT编译器对位运算和数组访问有高度的优化能力。那些手动进行移位组合的代码,一旦被JIT识别为热点代码并编译成本地代码,其性能通常可以与原生C代码相媲美。相反,过早引入复杂的缓存策略等“优化”,反而可能干扰JIT的自动优化。
4. 批量处理与向量化
现代JVM支持SIMD向量化(通过HotSpot的自动向量化或新的Vector API)。在处理连续的、大数据块时,保持数据访问的局部性和规律性,有助于触发CPU的向量化指令,从而实现并行加速。
九、知识扩展
在Ja va中,提到“按照IEEE 754标准将字节数组转换”,通常指的是将4个或8个字节解析为单精度(float)或双精度(double)浮点数。但你的需求是“转int”,这可能有以下两种理解:
- 将4字节按IEEE 754单精度格式转换为float,再强制类型转换为int(这会丢失小数部分)。
- 直接将4字节按大端序组合成int(这是普通的整型转换,不涉及IEEE 754浮点语义)。
既然明确提到了“IEEE 754标准”,那么最合理的解释是第一种情况:把字节数组所代表的二进制数据,先还原成浮点数,再取整为int。下面提供两种主流的实现方式。
方法一:使用 ByteBuffer(推荐)
import ja va.nio.ByteBuffer;
public class ByteArrayToInt {
    public static void main(String[] args) {
        // 示例:单精度浮点数 12.34 的 4 字节表示(大端)
        byte[] bytes = {0x41, 0x45, 0x70, (byte) 0xA4};  // 12.34 的十六进制表示
        float f = ByteBuffer.wrap(bytes).getFloat();
        int result = (int) f;
        System.out.println("float: " + f);   // 12.34
        System.out.println("int: " + result); // 12
    }
}
如果数组是小端序(低位在前),则需要设置字节顺序:
float f = ByteBuffer.wrap(bytes).order(ByteOrder.LITTLE_ENDIAN).getFloat();
方法二:手动位运算(不依赖 ByteBuffer)
基于IEEE 754单精度格式(1位符号 + 8位指数 + 23位尾数),手动将4个字节组合成一个int型的二进制位模式,再调用Float.intBitsToFloat()还原为float。
public static float bytesToFloat(byte[] b, boolean isBigEndian) {
    int bits = 0;
    if (isBigEndian) {
        bits = ((b[0] & 0xFF) << 24) |
               ((b[1] & 0xFF) << 16) |
               ((b[2] & 0xFF) << 8)  |
               (b[3] & 0xFF);
    } else {
        bits = ((b[3] & 0xFF) << 24) |
               ((b[2] & 0xFF) << 16) |
               ((b[1] & 0xFF) << 8)  |
               (b[0] & 0xFF);
    }
    return Float.intBitsToFloat(bits);
}
// 使用示例
byte[] bytes = {0x41, 0x45, 0x70, (byte) 0xA4};
float f = bytesToFloat(bytes, true);   // 12.34
int result = (int) f;                  // 12
补充:直接字节数组转普通 int(无 IEEE 754)
如果实际需求仅仅是将4个字节按大端序组合成一个32位整数(不涉及浮点解释),可以直接使用以下方法:
public static int bytesToInt(byte[] b) {
    return ((b[0] & 0xFF) << 24) |
           ((b[1] & 0xFF) << 16) |
           ((b[2] & 0xFF) << 8)  |
           (b[3] & 0xFF);
}
十、总结
在Ja va中,基于IEEE 754标准将字节数组转换为int,是一项横跨数据表示层、类型系统层和硬件抽象层的复合操作。它要求开发者同时具备以下几方面的认知:
- IEEE 754的数学语义:理解符号位、指数域和尾数域是如何协作表示一个浮点数的。
- 字节序的物理现实:清楚大端序和小端序在内存中的排列差异,以及Ja va的默认立场。
- Ja va的类型安全边界:掌握通过官方API进行位模式重解释的正确途径。
- 工程场景的多样性:能够根据网络通信、文件处理、跨语言交互、加密计算等不同上下文,做出恰当的设计决策。
只有掌握了这些维度,才能在构建健壮系统时游刃有余——无论是选择ByteBuffer的便捷、DataInputStream的标准,还是追求手动位运算的极致性能。在二进制数据的世界里,每一个字节的排列顺序都承载着精确的语义承诺,而对这份承诺的尊重与实现,正是构建高质量、可互操作软件系统的基石。
索尼SIECEO西野秀明在投资者问答中透露,次世代主机将突破客厅限制,实现无缝游戏体验。玩家未来可自然地在客厅外享受游戏乐趣,索尼将继续推出自有游戏机,但理念转向“拿起来就能玩”。
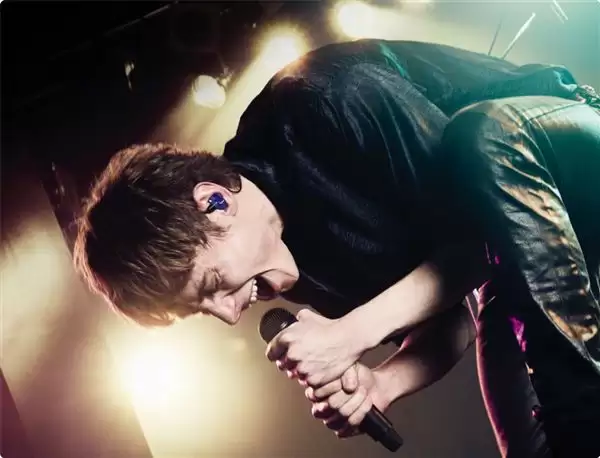
索尼发布入耳式专业监听耳机IER-M500,面向专业歌手。采用人体工学曲面与耳撑结构,佩戴稳固防掉落。搭载定制微型动圈单元,覆盖40kHz高频,低频有力不浑浊。全封闭腔体搭配泡沫耳塞,隔音优秀,机身防汗,支持MMCX换线。
工业工程师聚焦现场系统优化,统筹人、设备、物料等要素提升效率;工艺工程师侧重产品技术方案设计与改进。两者分工明确,分别解决“怎么做得更好”与“用什么技术方案干活”。
CooperPhotometricToolbox可读取路灯IES文件,自带异常检测功能。操作流程:打开文件,加载后选择需显示参数,通过“工具”中的“IES道路报告生成器”生成BUG光通量分布图,显示上射、中射、下射光通量等级,评判配光质量。
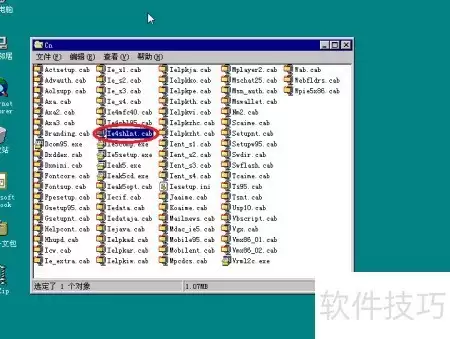
本文介绍在NT系统中安装IE5桌面更新的方法,让界面风格更接近Windows 98的视觉效果。整个过程并不复杂,跟着下面的步骤来就行。 首先,在IE5的安装目录里找到ie4shlnt.cab这个文件。这是个压缩包,用WinZIP把它解压到指定文件夹。 解压完成后,进入那个文件夹,找到ie4shell
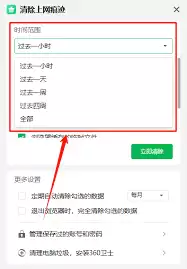
用久了Pie Pilot,设备空间是不是感觉越来越紧张?这多半是视频缓存悄悄占用了大量存储。定期清理这些缓存,不仅能释放空间,还能让设备运行更流畅。下面这份指南,将带你一步步彻底清理Pie Pilot的视频缓存。 清理的第一步,自然是打开Pie Pilot应用。进入主界面后,别急着看视频,先找到并点
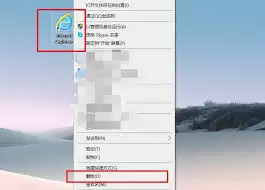
Windows10提供了移除或隐藏IE图标的官方方法。可通过控制面板关闭IE功能,或使用组策略编辑器隐藏桌面图标。如需彻底禁止访问,可在组策略中启用相应限制。恢复时反向操作即可。用户可根据实际需求选择合适方式。
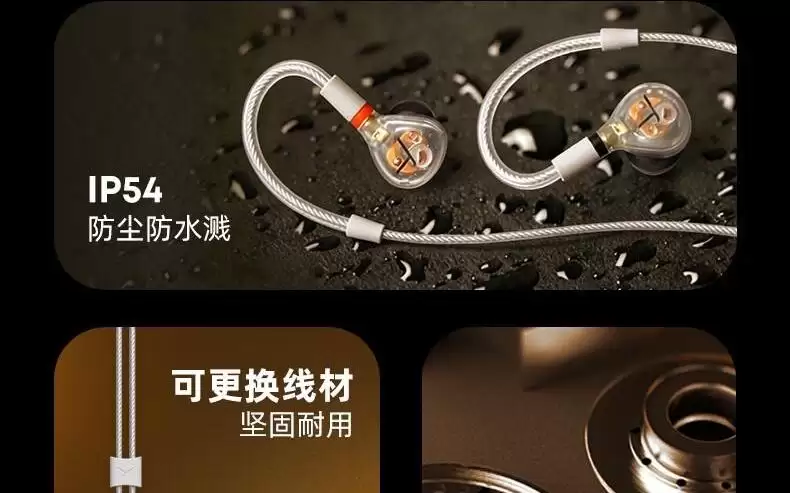
拜雅DT30IE入耳式监听耳机开售,首发价1199元(原价1480元),透明外壳搭配凯夫拉MMCX可换线,支持IP54防水。专业舞台监听调音,均衡自然,被动降噪达-39dB。
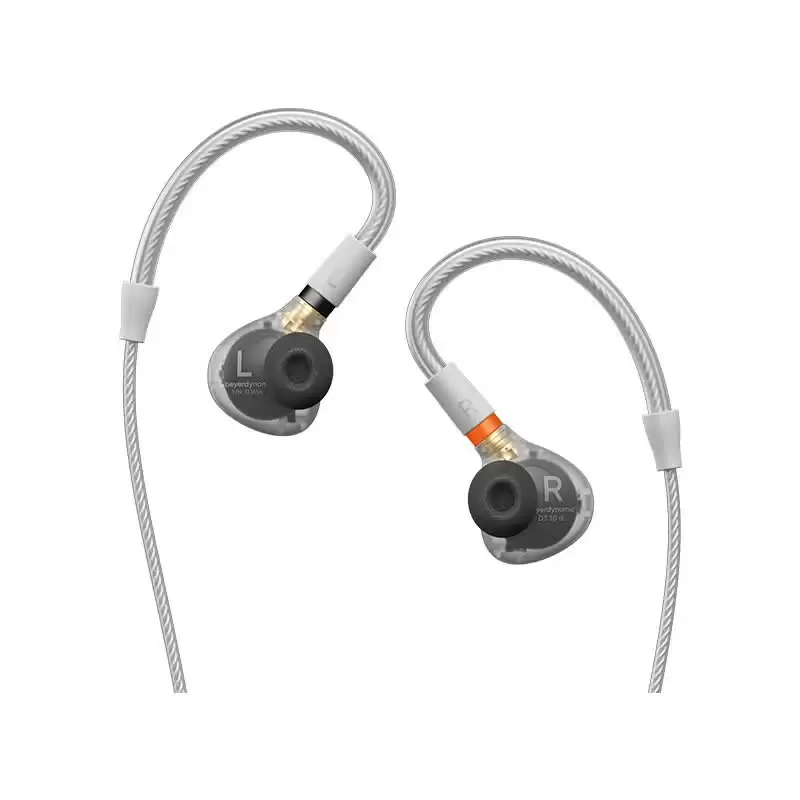
6月15日消息,拜雅(beyerdynamic)DT 30 IE入耳式专业监听耳机正式开售了。价格方面,原价1480元,首发到手价只要1199元。 这款耳机最直观的亮点就是透明外壳设计——机身内部构造一览无余,科技感拉满。线材用的是凯夫拉材质,耐用性有保障;接口采用MMCX系统,方便用户更换线缆。另
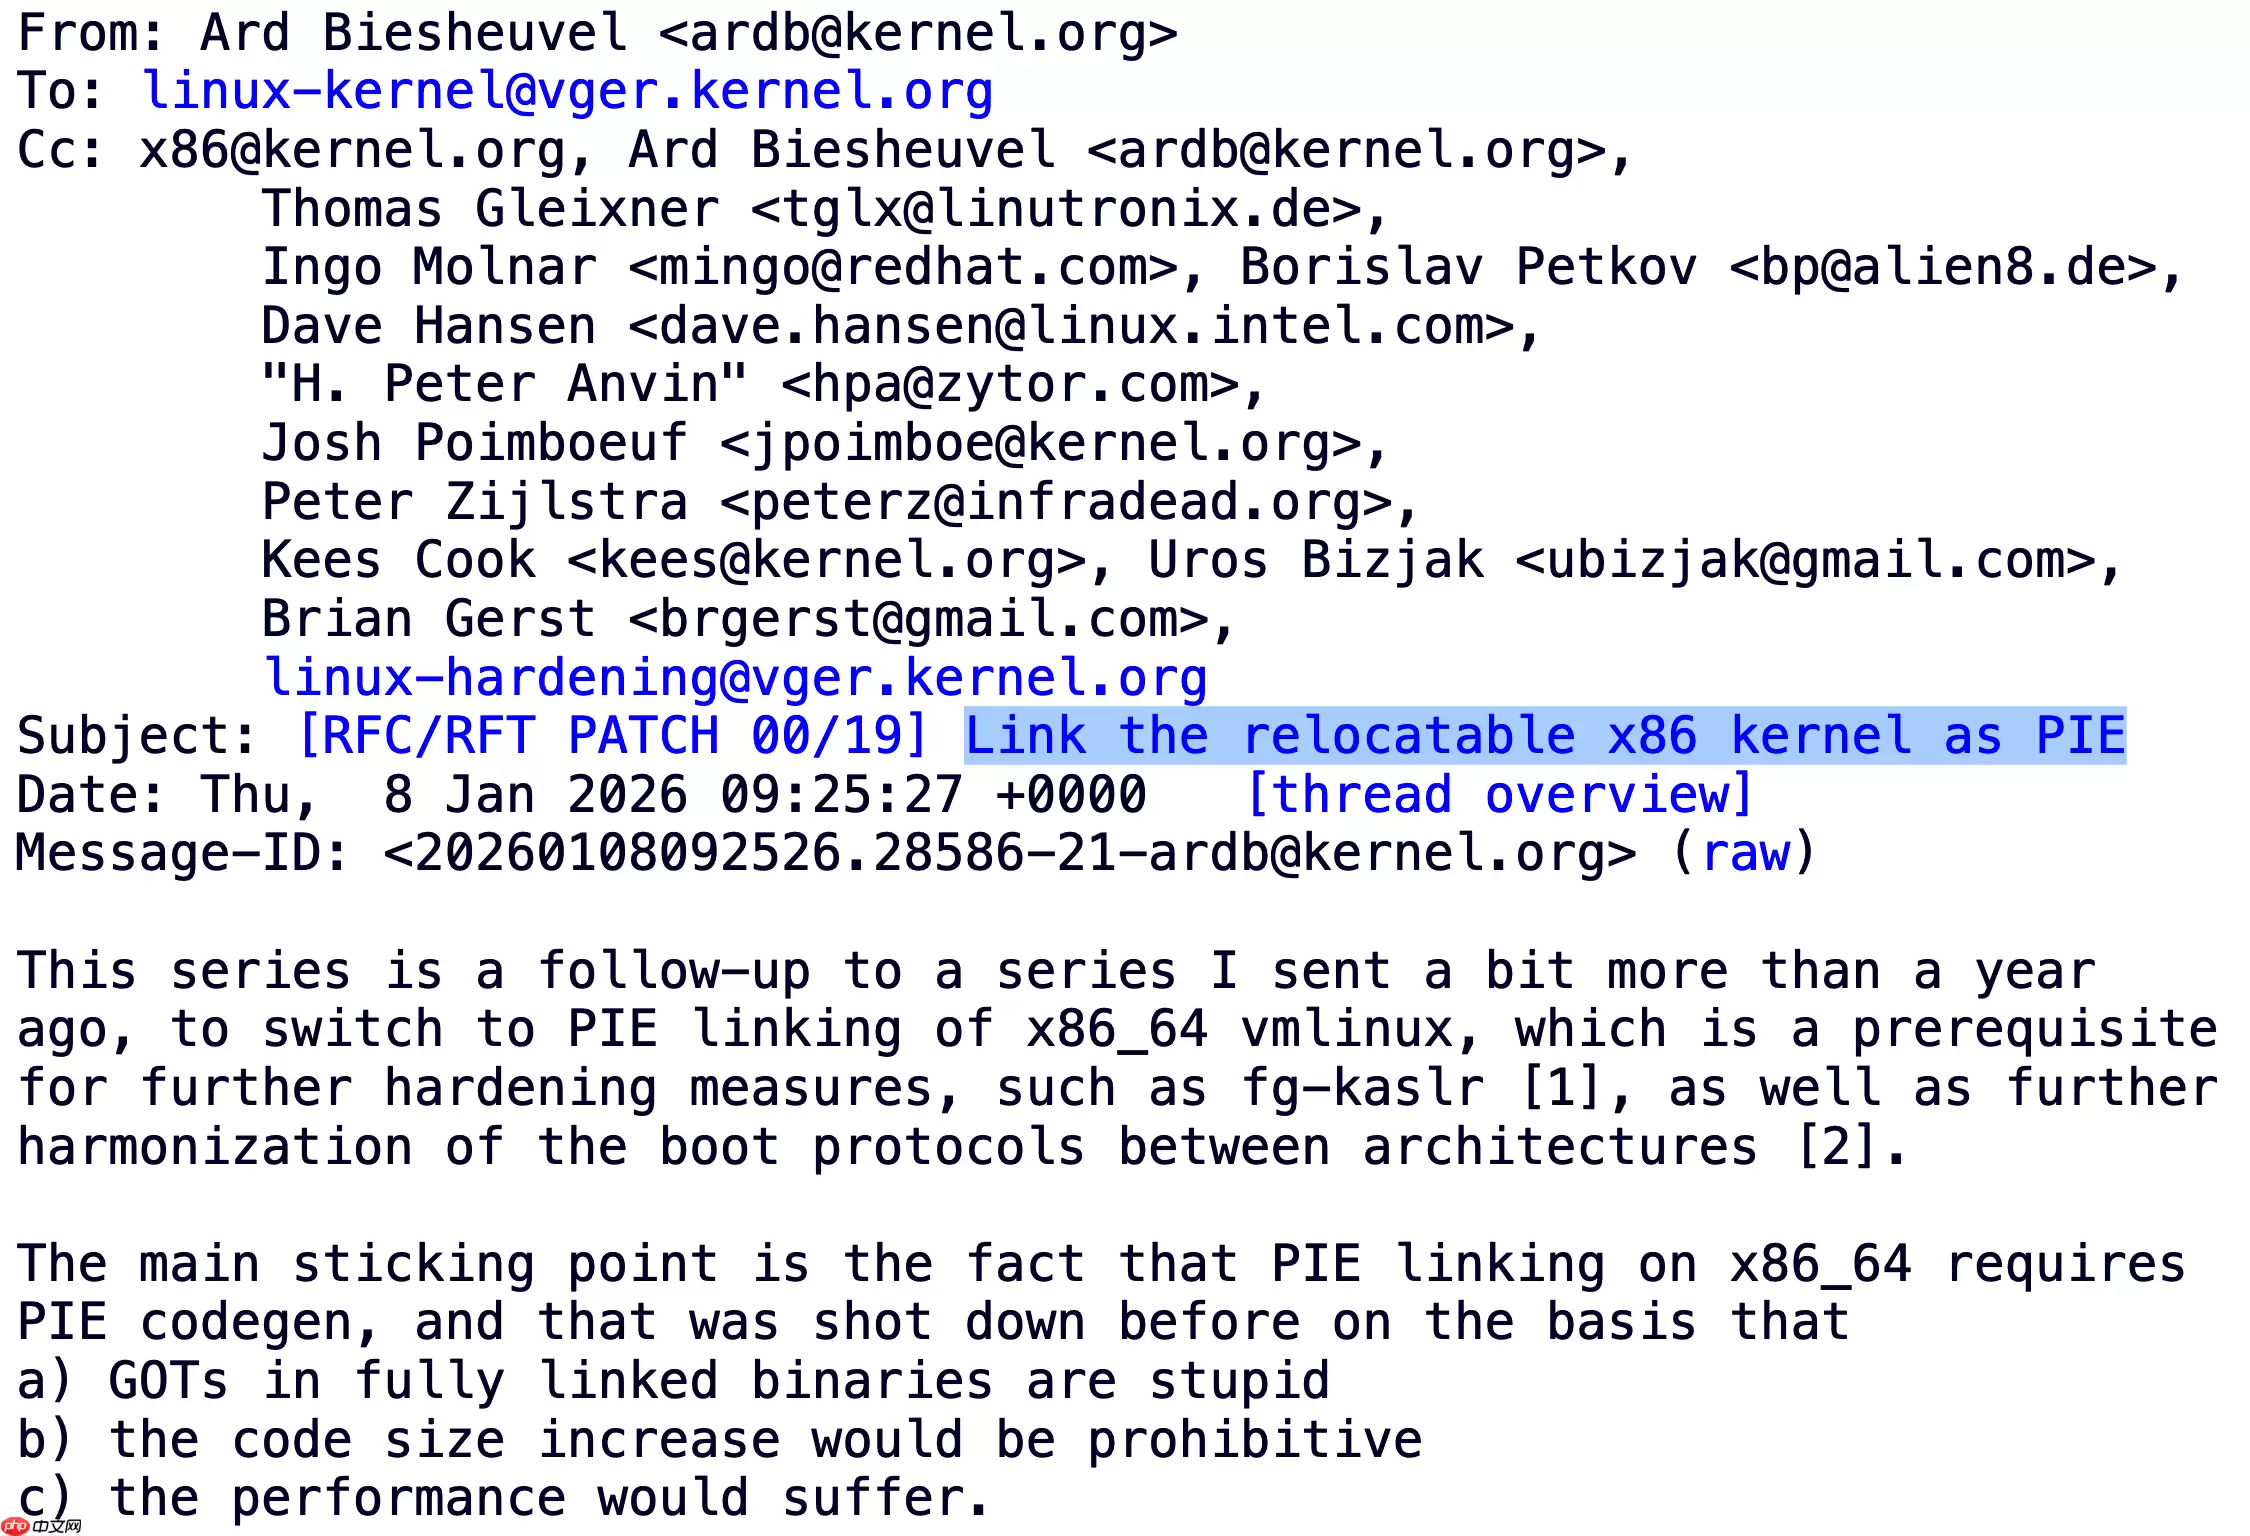
Linux内核开发社区提出RFC补丁,计划将x86_64内核以PIE格式链接,以增强地址空间布局随机化安全机制。补丁避免使用GOT,代码尺寸增幅约0.2%至0.5%,未发现性能下降。目前处于征求意见阶段,有望2026年正式支持。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。