

华盛顿大学研究发现"乱码前缀"让AI推理能力大幅提升
华盛顿大学研究发现,在AI提示词前添加一段无意义的拉丁文“乱码”(LOPE方法),能打破其思维定式,提升推理能力。该方法通过适度陌生的前缀引导AI探索新思路,且不影响原题理解。实验在多个规模模型上验证了效果,并指出有效扰动需使用低困惑度的非英语文本以避免语义干扰。
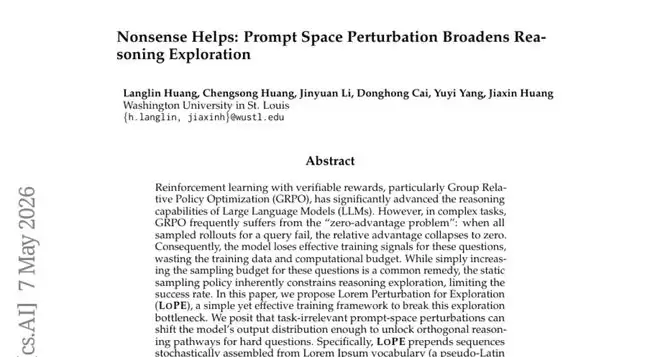
你有没有过这样的体验:一道难题卡了半天,换个地方、或者跟朋友闲聊几句,灵感突然就来了。这种“环境转换激发灵感”的现象,在人类思维中很常见。有趣的是,华盛顿大学的研究团队发现,AI大语言模型在解题时,竟然也表现出类似的特性——更让人意想不到的是,在题目前面加一段毫无意义的拉丁文“乱码”,居然真能帮AI解出原本束手无策的难题。
这项研究以预印本形式发布于2026年5月,论文编号为arXiv:2605.05566。听起来或许有些荒诞,但其背后有一套严密的逻辑支撑。研究团队将这个方法命名为“Lorem Perturbation for Exploration”,简称LOPE,核心目标是解决AI强化学习训练中的一个顽固痛点:当AI对一道题完全无解时,整个训练进程就会陷入停滞,计算资源被白白浪费。而LOPE提出的解决方案,简单得出奇:在题目前面贴上一段随机生成的拉丁语占位文本,再让AI重新尝试。
一、AI训练中的“死局”:当所有尝试都失败时
要理解这项工作的价值,得先看看AI是如何学会推理的。目前主流方法是强化学习,具体而言是一种称为GRPO(组相对策略优化)的技术。这个过程可以类比为学生备考:AI(学生)针对一个问题同时生成多个答案(思路),系统(老师)通过对比这些答案的优劣来提供反馈,指导AI调整策略。
这里存在一个关键瓶颈:如果AI生成的所有答案都错了,那么对比就失去了意义,系统无法给出有效的训练信号。研究团队将这种情况称为“零优势问题”。这不仅意味着当前题目的训练失败,也连带浪费了整个批次的算力。
面对此问题,一个直观的思路是“增加尝试次数”。许多研究也确实在探索如何更智能地分配重试预算。但问题在于,对于真正超出AI当前能力范围的题目,单纯增加从同一个“思维池”里抽样的次数,重复失败的概率依然很高。这就好比学生在同一张草稿纸上用同一种思路反复演算,换再多张纸也可能无济于事。
华盛顿大学的团队换了个角度思考:既然症结在于AI陷入了同一种思维定式,那么能否通过改变输入的“环境”——即题目的上下文——来迫使AI探索不同的路径?
二、“换个环境”的实验:乱码竟然有效
在正式构建LOPE框架前,研究团队先进行了一项验证性实验,对比了三种条件:标准提示词、提高“温度”参数以增加随机性,以及在标准提示词前添加一段随机Lorem Ipsum文本。
Lorem Ipsum是一种特殊的占位文本,它模仿自然语言的词长和句子结构,但不传达实际意义。实验中,团队从63个拉丁词汇中随机组合,生成100到300个词元长度的乱码前缀。
实验在500道数学题上进行,使用了Qwen3-1.7B-Base模型。结果颇具启发性:添加Lorem扰动的方法,其整体解题数量不输于其他方法,更重要的是,它独立解决了许多连“高温随机”方法都无法攻克的题目。这说明,这种“废话前缀”确实引导AI进入了原本未被探索的“思路空间”。
在针对352道高难度题目(标准方法8次尝试全败)的深入分析中,差异更为明显:Lorem扰动方法独立解决了50道连高温采样都无能为力的题目。
为了探究机制,团队进一步分析了生成答案的“熵”(不确定性)和“困惑度”(模型对输出的自信程度)。标准方法生成的答案集中在低熵、低困惑度区间,显得自信但保守。高温方法则使熵和困惑度急剧升高,探索空间虽大,但答案质量参差不齐。而Lorem扰动方法仅使熵温和右移,困惑度微升,它在不显著牺牲答案质量的前提下,适度拓宽了AI的生成分布。这就像让一位厨师在烹饪前听一段异国音乐——思路被轻微打开,但手艺依然稳定。
三、LOPE的运作方式:一套经过精心设计的训练流程
现象得到验证后,研究团队将其系统化,设计出完整的LOPE训练框架。
流程始于常规步骤:AI对每道题生成一组答案(默认8个)。只要其中有一个正确,就按标准流程训练。只有当全部答案都错误时,LOPE才被激活:在原始题目前拼接一段随机Lorem Ipsum序列,然后用这个新提示词重新生成24个答案。
如果在重采样中找到了正确答案,下一步是将成功与失败的答案混合,形成一个训练批次。这里有个精妙的设计:从成功答案中随机选取若干,替换掉部分失败答案,但必须保留至少一个失败答案。这是为了确保组内存在对比,从而产生有效的训练信号。
随之而来的是一个技术挑战:这些成功答案是在“扰动提示词”下产生的,但训练时需要将其视为在“正常提示词”下产生,以保持训练与推理环境一致。这种“伪推演”需要通过“重要性采样比”这一数学系数来修正梯度权重,防止训练方向出现偏差。
此外,LOPE移除了标准GRPO流程中的KL散度正则项。该正则项本意是防止模型偏离原始版本太远,但它同时也抑制了Lorem扰动所能带来的多样性,因此在LOPE框架下被舍弃。
四、训练信号塑形:让稀有的成功更值钱
仅有基本框架还不够。团队发现,即便重采样找到了正确答案,训练效果有时仍不理想,问题出在两方面。
首先是“偏离策略训练导致梯度消失”。对于那些通过扰动才找到的答案,AI在正常提示词下赋予它们的概率通常极低。这导致这些珍贵的“另辟蹊径”的成功经验,在训练中的权重被系统性地压低,无法被有效学习。
为此,团队引入了“策略塑形”机制。它通过一个特定的函数调整每个词元的训练权重:对AI原本就高概率的词元适度降权,对低概率词元适度提权。这使得来自新路径的关键步骤能得到更多关注,同时保证了训练过程的稳定性。
其次是“优势估算偏低”。在GRPO中,优势值是通过组内答案对比计算的。如果训练批次中大部分是失败答案,仅混入少数成功答案,那么这些成功答案的优势值会被低估——因为对比的基准被大量低分答案拉低了。
“优势塑形”机制解决了这个问题:在计算优势时,将所有原始失败答案和重采样答案全部纳入统计,但只对最终选中的那组答案应用梯度更新。这样,统计基础更真实,成功答案的优势值能被放大2到5倍,确保了稀有成功经验获得应有的重视。
五、实验结果:三个模型、五项测试,全线提升
研究团队在三个不同规模的模型上进行了全面评估:Qwen3-1.7B-Base(17亿参数)、Qwen3-4B-Base(40亿参数)和Qwen2.5-Math-7B(70亿参数)。测试涵盖了从基础到顶尖难度的数学推理基准。
在17亿参数模型上,结合了训练信号塑形的LOPE平均得分为39.82,显著高于标准GRPO的37.03,也优于单纯“增加重试次数”的朴素重采样方法(38.16)。
在40亿参数模型上,效果更为突出:LOPE平均得分53.99,比标准GRPO(49.37)高出4.62分。值得注意的是,朴素重采样方法在此模型上效果反而下降(48.95),而LOPE则实现了大幅超越。分析认为,朴素重采样在移除KL约束后容易导致“策略漂移”,而LOPE通过引入高质量的多样性答案,客观上起到了隐性的正则化作用。
在70亿参数模型上,不带信号塑形的LOPE效果与朴素重采样相近,但加入信号塑形后,得分从标准GRPO的47.68跃升至53.88,提升超过6.2分,这是三个模型中提升幅度最大的。这表明,对于能力更强的模型,Lorem扰动能找到更多成功答案,而训练信号塑形是将这些成果高效转化为能力提升的关键。
从训练动态看,LOPE在整个训练周期内都维持着更高的“题目级成功率”(即重采样能找到至少一个正确答案的题目比例)。这意味着LOPE能让更多种类的难题获得训练信号,而不是反复优化AI已经接近掌握的题目。
六、什么样的“废话”才算好废话?
既然Lorem Ipsum有效,一个自然而然的问题是:为什么是它?是拉丁语的特性,还是某种更普适的规律在起作用?为此,团队系统测试了七种不同类型的文本扰动。
测试范围从“类语言”到“纯噪音”,包括:随机假英语、随机ASCII字符、随机词元、英语高频词组合、拉丁语高频词组合、基于三元语法生成的拉丁语句子,以及过滤后的真实拉丁语文本。
评估的核心指标是这些文本在AI眼中的“困惑度”。实验结果呈现出一个清晰规律:困惑度越低(即越接近AI熟悉的语言模式),扰动效果越好;困惑度越高,效果越差,甚至有害。Lorem Ipsum(困惑度25.12)、过滤真实拉丁语(46.09)和拉丁语高频词(51.32)效果最佳;而随机ASCII字符(492.93)和随机假英语(2429.9)效果欠佳;完全随机的词元(困惑度均值达46万)则比不做扰动还要差。
进一步分析表明,高困惑度的扰动会破坏AI对题目本身的理解,导致即便生成“答案”,也可能是在误解基础上产生的。而像Lorem Ipsum这样困惑度适中的拉丁语扰动,能在改变AI处理方式的同时,不损害其对题目核心内容的把握。
另一个有趣发现是:英语高频词组合的困惑度(85.30)低于拉丁语三元语法模型(91.45),但最终表现却更差。原因在于,英语词汇会与题目本身的英语内容产生语义干扰,混淆AI。而拉丁语由于与题目语境天然隔离,成为一种“干扰力度足够但不破坏理解”的理想载体。
由此可以总结出有效扰动的两个关键特征:第一,使用拉丁语系词汇,避免与英语推理上下文产生语义干扰;第二,保持较低的困惑度,确保扰动后的题目对AI而言仍是“可理解”的任务。Lorem Ipsum恰好完美契合了这两点。
说到底,这项研究揭示了一个反直觉却深刻的见解:提升AI的推理能力,有时并不依赖于注入更多有效信息,反而可以通过引入一段无意义的“背景噪音”,来打破其固有的思维惯性。这与人类在创意枯竭时选择散步、听音乐或改变环境的行为,有着奇妙的共鸣。
当然,研究也存在局限性。团队在论文中指出,自动生成的随机拉丁语序列无法保证完全不包含不当内容,过强的扰动也可能导致输出失控。这些安全挑战是未来需要认真对待的方向。
对于关注AI训练效率的实践者而言,这项工作提供了一个成本极低、操作简单但效果显著的改进思路。而对于广大AI爱好者来说,它则是一个生动的提醒:AI的推理行为,远比我们想象的更为微妙和有趣——一段恰到好处的“废话”,或许就是打开思维枷锁的那把钥匙。
Q&A
Q1:LOPE方法在训练AI时具体是怎么操作的?
A:其操作流程可概括为:AI先用正常提示词对一道题生成8个答案。若全部错误,则在题目前随机添加一段Lorem Ipsum拉丁文,并用这个新提示词再生成24个答案。若其中找到正确答案,则将成功答案与原始失败答案混合成一组进行训练,同时运用数学方法修正训练梯度,确保学习方向准确。
Q2:为什么拉丁文乱码能帮AI解出更难的题目?
A:核心机制在于打破思维定式。AI解题时容易陷入固定模式,改变输入上下文能迫使其走出惯性。拉丁文乱码的效果在于其“恰到好处的陌生感”:困惑度足够低,不破坏题目理解;又是非英语词汇,不与题目语义产生干扰。这种“既熟悉又不同”的前缀,促使AI以略微不同的角度处理问题,从而发现原本被忽略的解题路径。
Q3:LOPE在不同规模的AI模型上效果相同吗?
A:效果存在差异。在17亿参数模型上平均提升约3分,在40亿参数模型上提升约4.6分,在70亿参数模型上,配合训练信号塑形后提升最大,达到约6.2分。总体趋势是,模型能力越强,LOPE配合信号塑形带来的收益越显著,因为大模型能从重采样中找到更多成功样本,但需要配套的训练技术来充分转化这些经验。
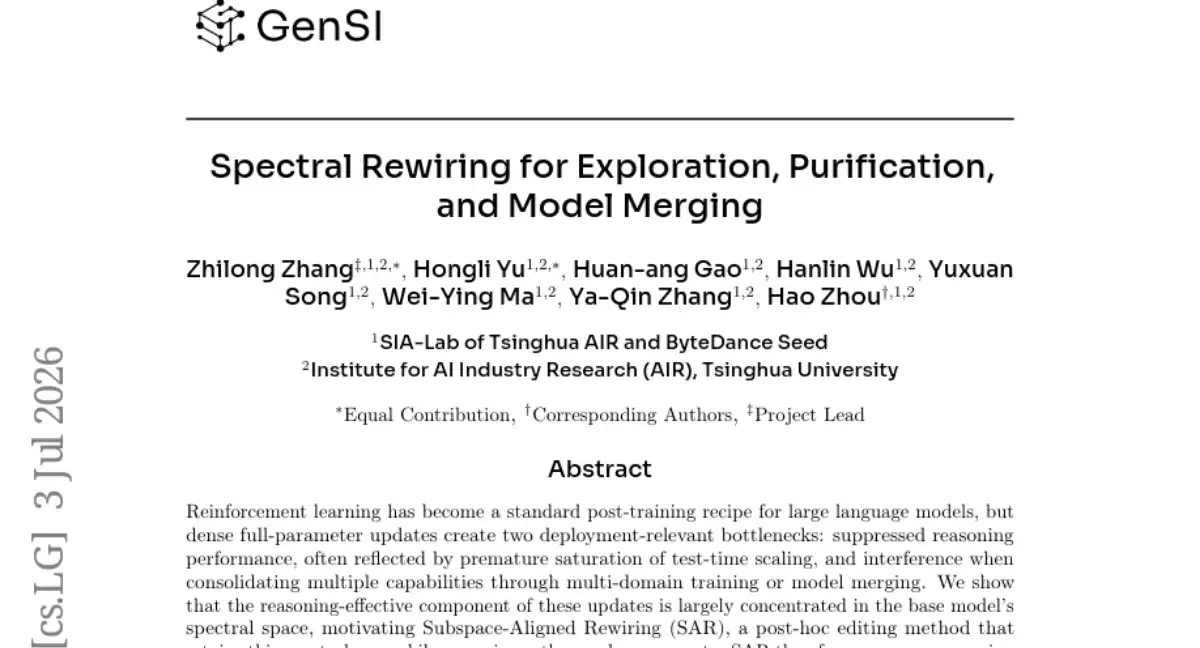
清华大学与字节跳动团队提出子空间对齐重连线(SAR)方法,仅需保留模型0.58%的参数即可维持99%以上推理能力,同时去除冗余更新、提升探索多样性,并缓解多领域训练中的能力压制问题。

llama.cpp b12489、b12490、b12491、b12492、b12493、b12494、b12496、b12497、b12498 均为预发布构建,分别涉及服务器、语音模型及特定后端;适用范围须按模型、硬件和请求条件区分。
MiniMax-H3-Image新增DiffSynth-Studio文档推荐后,配置选择应围绕具体推理配方和独立训练流程展开。文档中的24GB GPU方案分别配合32GB或8GB主机RAM,所用量化、CPU或磁盘卸载方式不同;新增文档入口本身没有发布模型新权重或标注一个新的框架版本。
识别Ollama完整rc0预发布标签,区分MLX并发、Vulkan集成显卡mmap、llama.cpp b12257与CLI集成更新边界。
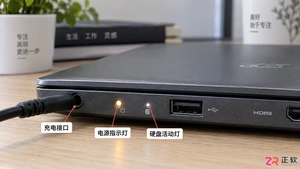
宏基笔记本遇到开机没反应、电源灯亮但屏幕黑屏,或者按下电源键完全无反应的情况该怎么办?本文通过界面与状态指示灯的观察,分步骤介绍静电释放、内存重插及外接显示器测试等实用方法,助你自行解决常见启动故障。
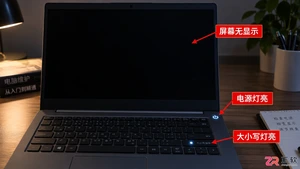
惠普笔记本开机时电源键和大小写锁定键亮起,但屏幕无反应?这通常是嵌入式控制器(EC)逻辑错误或静电干扰所致。本文详解如何通过移除外设、长按电源键进行硬件复位来恢复正常启动,并提供BIOS恢复及进一步硬件检测的建议。
遇到电脑黑屏伴随显卡风扇狂转?这往往是显卡过热保护、供电不足或驱动崩溃的信号。本文详解如何通过观察指示灯、重置驱动、检查线缆及清理灰尘来解决该问题,避免盲目更换硬件。
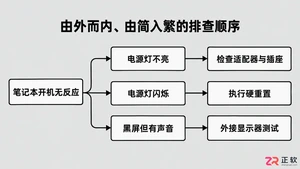
惠普笔记本无法开机、电源灯异常或屏幕黑屏?本文详解通过移除外设、执行硬重置(静电释放)、检查适配器及内存重插等步骤,快速定位并解决常见启动故障。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



