

南开大学与阿里联合攻关:让AI画图从"百步成图"变成"四步出图"
Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
南开大学与阿里巴巴提出“连续时间分布匹配”框架,提升扩散模型蒸馏效率。该方法采用连续随机采样与主动纠偏机制,仅用四步即可生成高质量图像,且支持灵活调整推理步数,为高效AI图像生成提供了新思路。
想象一下,如今最顶尖的AI图像生成模型,就好比一位追求极致的大厨。每创作一幅作品,都需要经历几十甚至上百道精细工序,反复雕琢,才能最终呈现。效果固然惊艳,但每次“点单”都要等上半天,这在实际应用中显然是个痛点。于是,研究者们开始思考:能不能训练出一批“速成厨师”,只用寥寥几步就能端出同样水准的佳肴?这正是“扩散模型蒸馏”的核心目标——将一个庞大、缓慢的“老师模型”的知识,压缩传授给一个轻快、高效的“学生模型”。
但现有的主流蒸馏方案,普遍面临一个尴尬的局面:学生模型生成的图像,往往细节模糊、风格趋同,像是流水线快餐,缺乏老师作品里那种层次丰富的质感和精细的笔触。问题究竟出在哪里?
近期,一项由南开大学、阿里巴巴集团和吉林大学联合完成的研究,提出了一套名为“连续时间分布匹配”(CDM)的全新框架。它无需借助生成对抗网络(GAN)或外部奖励模型等“额外调料”,仅通过优化训练过程本身,就显著提升了四步蒸馏模型的图像质量。这项研究已于2026年5月以预印本形式发布(论文编号:arXiv:2605.06376)。
一、瓶颈何在:为何“速成”总失细节?
要理解突破点,先得回顾一下扩散模型的基本原理。它的工作方式,可以看作是将一张清晰图片逐步加入噪声,直至变成完全随机的雪花屏,然后训练模型学习如何将这个加噪过程逆向还原。这条从噪声回归清晰的“逆扩散之路”,通常需要几十到上百步才能走完。
当前主流的蒸馏方法之一,是分布匹配蒸馏(DMD)。其核心思想是让学生模型生成的图像分布,尽可能贴近老师模型的分布。然而,传统DMD方法存在一个根深蒂固的习惯:训练时,学生模型只能在几个与最终推理步数严格对应的固定时间节点上接受监督。例如,目标是用4步生成图像,训练就只盯着第1、2、3、4步这几个“打卡点”,中间的所有过渡状态全部跳过。
这种“离散锚点”式的训练,带来了两个明显弊端。首先,学生只在几个孤立时刻接受指导,无法形成对连续生成过程的流畅掌控感,导致其预测的“行进方向”(速度场)不够平滑。其次,DMD采用的优化目标(反向KL散度)本身存在“模式坍缩”倾向,即学生容易只模仿老师最擅长的几种输出模式,而忽略了数据的整体多样性,结果就是图像过于平滑、缺乏细节,甚至产生瑕疵。为了弥补这些缺陷,现有方法往往需要引入额外的GAN或奖励模型来“打补丁”,增加了系统复杂性和训练成本。
二、关键发现一:训练不必死守“打卡点”
研究团队首先做了一个看似简单却结论碘伏的实验:他们放弃了固定的离散时间节点,改为在整个连续的时间轴上随机采样进行训练。每次迭代,随机选择一个起始时间点,随机决定模拟的步数长度。
结果出人意料。这种动态调度策略不仅没有损害性能,反而带来了全面提升:在衡量人类偏好的HPSv3指标上,分数从10.08提升至10.65,同时生成的图像细节更丰富,视觉瑕疵减少。这一发现直接挑战了“训练与推理时间点必须严格对齐”的固有假设,表明分布匹配的有效性与具体使用哪几个固定节点无关,严格的离散对齐反而可能是一种不必要的束缚。
从数学角度看,当学生模型的时间节点和老师模型的扰动步长都从同一连续分布中独立采样时,两者的梯度信号在期望上会均匀覆盖整个时间域,而非局限于几个稀疏点。这就好比培训厨师时,不再是只考核切菜、翻炒、调味这几个固定动作,而是随机抽查烹饪流程中的任意环节,这样培养出的手感自然更为全面和扎实。
三、关键发现二:重新认识“分布匹配损失”
在理解动态调度的优势后,团队进一步澄清了一个长期存在的误解。此前有观点认为,DMD的训练目标可拆分为两部分:负责图文对齐的“CFG增强”损失是主角,而分布匹配损失更像一个辅助稳定训练的“配角”,其核心作用并不明确。
然而,通过视觉对比和定量分析,研究团队推翻了这一论断。他们训练了一批仅使用分布匹配损失、不使用CFG增强损失的学生模型,并将其输出与老师模型在开启和关闭“分类器无关引导”时的输出进行比较。结果非常清晰:仅凭分布匹配损失蒸馏出的学生,其生成图像与老师模型在**不开启CFG引导**时的输出高度相似,无论是视觉风格还是量化指标都几乎一致。这一现象在SD3-Medium和Longcat-Image两个不同基础模型上都得到了验证。
这意味着,分布匹配损失并非无关紧要的稳定器,它实际上是在驱动学生模型学习老师模型在“无引导状态”下的自然数据分布——一种更原始、未经CFG强化的输出模式。理解这一点至关重要,它明确了分布匹配损失独立且确定的功能定位。在CDM框架中,CFG增强损失负责将图像“拉向”正确的文本描述,而分布匹配损失则负责维持图像的真实感和分布一致性,二者相辅相成,缺一不可。
四、CDM框架设计:连续时间与“主动纠偏”
基于以上两大发现,CDM框架的核心设计应运而生,主要包括两个组件。
第一个是动态连续时间调度。在每次训练迭代中,模拟的推理步数N在1到最大值(实验中设为28)之间随机采样;时间节点序列则在整个连续区间(0, 1]上随机生成一组严格递减的值。这使得学生模型在训练中能接触到各种长度、各种位置的轨迹片段,相当于用不同的节奏和跨度反复练习整个生成过程。
第二个是CDM损失函数,旨在解决“轨迹偏离”这一核心难题。
什么是“轨迹偏离”?当学生模型用极少的步数(如4步)走完从噪声到图像的漫长路程时,每一步的跨度都很大。这就像在山路急转弯时猛打方向盘,车辆很容易冲出道路。数学上可以证明,每步积分引入的误差与步长的平方成正比,而累积的总误差与最大步长成正比,其大小还取决于模型预测的速度场在相邻时刻的变化剧烈程度。
为了抑制这种偏离,CDM损失设计了一种巧妙的“主动探测”机制。具体而言,在某个时间点,先根据学生模型预测的速度方向,向前外推一小步,到达一个可能偏离理想轨迹的“假设点”。然后,将这个偏离点再次输入学生模型,得到一个新的预测。接着,利用冻结的老师模型和一个在线更新的“影子老师”模型,分别对这个新预测进行评估,并将两者的差异作为监督信号,来修正学生模型。
其背后的直觉是:如果学生在某一点的预测方向有误,那么沿着这个错误方向走出的一步,必然会偏离正轨。CDM损失在这个偏离点上施加监督,相当于及时给出反馈:“你走偏了,请调整。” 从数学上可以推导,这种在相邻点施加约束的做法,实质上是在约束速度场的“物质导数”(即其随时间和空间的综合变化率),而这正是影响局部误差的关键、且可通过训练优化的部分。因此,CDM损失通过模仿老师模型速度场的变化平滑性,将那种流畅、稳定的“行车风格”迁移给了学生。
最终,CDM的总训练目标是三个损失的加权和:CFG增强损失、分布匹配损失以及新提出的CDM损失,三者的权重被设置为相等。
五、实验结果:量化指标与视觉质量双赢
研究团队在Stability AI的SD3-Medium和美团的Longcat-Image两个不同规模的基础模型上进行了全面评估,生成分辨率均为1024×1024。评测涵盖了美学评分、提示词遵从度、人类偏好评分、语义对齐等多个维度。
在SD3-Medium模型上,CDM在仅用4步推理的条件下,在美学评分、DPGBench、PickScore和HPSv3等关键指标上均取得了对比方法中的最高分。特别值得注意的是,其4步学生模型在DPGBench和HPSv3上甚至超越了需要100步推理的原始老师模型,这意味着蒸馏过程并非简单复制,而是在某些维度上实现了超越。
在Longcat-Image模型上,同样的优势趋势得到复现,CDM在多项指标上排名第一。此外,在衡量生成分布与真实数据接近程度的FID指标上,CDM也表现最佳;在评估图像中文字渲染准确率的OCR测试中,也名列前茅。
在效率方面,CDM的训练时间约为基线方法的1.8倍,显存占用略有增加,但这些开销完全局限于训练阶段。在推理时,CDM模型与基线模型结构相同、步数相同,每张图像的生成时间均为246毫秒,没有任何额外负担。
六、消融实验:每个设计都不可或缺
为了验证每个组件的必要性,研究团队进行了系统的消融分析。
损失函数组合:单独使用CFG增强损失会导致图像结构崩溃;单独使用分布匹配损失或CDM损失虽能恢复视觉质量,但图文对齐能力严重下降;三者结合则达到最佳效果,证明了功能上的互补性。
核心机制对比:将动态连续调度换回固定离散调度,各项指标均出现下滑。将CDM损失中的速度场外推替换为简单的加噪扰动,或取消扰动直接在原轨迹点监督,性能也会下降,说明模拟真实推理偏差的“主动探测”机制更为有效。将CDM损失的局部监督信号替换为全局信号,同样会导致性能损失,印证了局部化纠偏的直接性优势。
七、实用灵活性:训练定4步,推理可多变
CDM还展现出一个颇具实用价值的特性:虽然学生模型是针对4步推理进行蒸馏的,但由于训练覆盖了连续时间域,且CDM损失约束了速度场的变化平滑性,使得同一个模型在推理时可以灵活地使用3步、4步、6步或8步,无需针对不同步数重新训练。
实验显示,使用相同模型检查点和随机种子,在不同推理步数下都能生成连贯且符合提示词的图像。步数越多,细节越精细;即使减少步数,输出依然稳定。这种灵活性为实际部署提供了便利。
八、局限与展望
研究团队也客观指出了CDM当前的局限。约1.8倍的训练成本增加,对于大规模工业应用仍需权衡。此外,作为蒸馏方法,其性能上限受制于老师模型本身的能力。目前的实验集中于文生图领域,未来团队希望将CDM框架拓展至图文编辑和视频生成等场景,后者在时序一致性上将带来新的挑战。
归根结底,CDM工作的核心价值在于思维范式的转变:与其将训练严格绑定在有限的推理“打卡点”,不如让监督信号均匀覆盖整个生成轨迹,并主动探测、纠正推理中实际可能发生的偏离。两个关键发现——调度可解耦、分布匹配损失学习无引导分布——为这一设计提供了坚实的理论支撑。实验数据反复证实,这些改进是实质性的,而非技巧性的指标提升。对于所有在生成速度与质量间寻求平衡的应用而言,CDM提供了一个不依赖复杂外部模块、相对简洁高效的参考方案。
Q&A
Q1:CDM蒸馏方法与普通的扩散模型蒸馏有何本质区别?
A:普通DMD方法仅在固定、离散的推理时间节点进行监督。CDM打破了这一限制,采用连续时间随机采样进行训练,并引入了“主动纠偏”机制:沿学生预测方向外推至偏离点,在该点施加额外约束,直接抑制因大步长积分导致的误差累积。
Q2:CDM为何无需GAN或奖励模型就能生成高质量图像?
A:传统方法因离散监督稀疏且模式单一,易产生平滑和瑕疵,故需引入GAN等模块补救。CDM通过连续调度使监督更密集均匀,并通过CDM损失约束速度场平滑性,从根源上减少了误差积累和瑕疵产生,因此无需额外复杂模块。
Q3:CDM蒸馏出的4步模型,推理时能否调整步数?
A:可以。得益于动态连续调度和CDM损失对速度场变化率的约束,同一模型检查点支持3、4、6、8等不同推理步数,无需重新训练或调参。步数越多,细节越精细;步数减少,输出依然保持连贯与对齐。
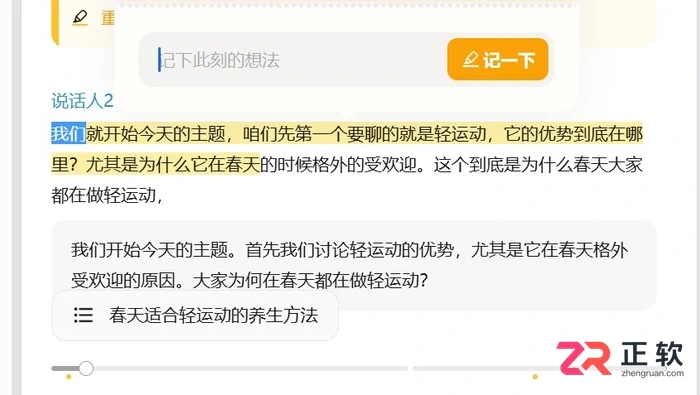
录音中点工具栏的记一下即可打点,也可直接输入短文字做书签,转写后在文稿里点标记跳回对应录音,配合标签和AI纪要快速整理。
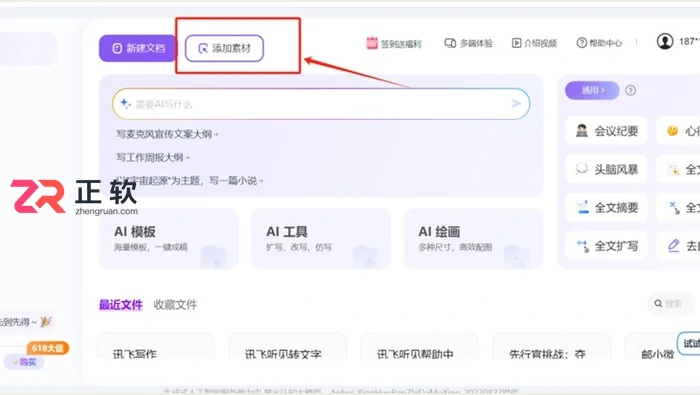
在文稿页进AI写作,把录音稿作为素材勾选进去,选职场或公众号模板生成初稿,再用扩写、缩写、改写逐段打磨,最后导出Word。
蛙蛙写作完成小说后,直接投稿容易遗漏平台规则、章节顺序和版本差异。本文讲发布条件、章节导出、投稿预览及线上线下版本管理,让最终提交内容更完整。
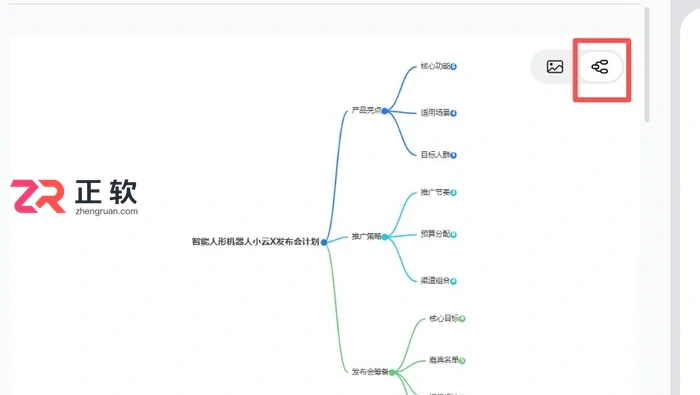
打开转写稿进AI纪要,切到思维导图视图即可自动生成层级节点树,节点可改可拖;它挂在AI纪要下面,不在导出或设置里。
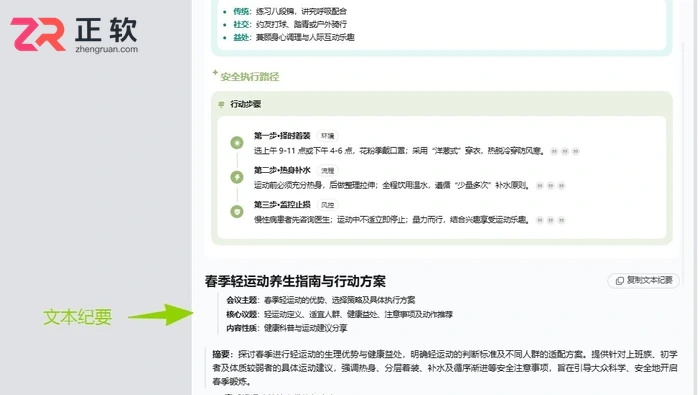
打开转写稿点顶部AI纪要,自动生成摘要、章节要点和待办,每条可点回原文定位;右上角导出选Word或PDF,导出范围记得勾上原文。
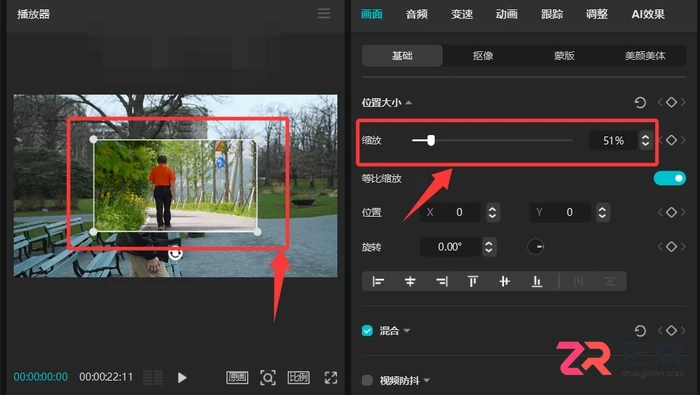
选中视频段,右侧属性栏最右的「AI 效果」里选超清画质,挑强度后云端处理;锐化和特效补不回分辨率,源文件压缩过重时效果有限。




基本都是 Chromium 单核,在「关于」里能看到具体内核版本;单核更轻快,但只支持老 IE 的站点需另找办法。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



