

中国科学院与腾讯微信联手攻克AI"排队慢"难题
中国科学院与腾讯微信联合提出UniPrefill框架,通过预扫描筛选关键词块并跨层复用决策,显著减少长文本处理计算量。实验表明,其首字延迟最高提升2.1倍,且回答质量几乎无损。该框架尤其适合混合架构模型,易于集成现有引擎,在多用户并发场景下效果更佳。
如果你曾让AI助手处理过一份几万字的合同,或者要求它读完一份百页报告后回答问题,那你一定经历过那种等待——在AI吐出第一个字之前,那段似乎格外漫长的沉默。这种等待,在技术术语里被称为“首字延迟”(Time-To-First-Token, TTFT),它直接取决于AI需要消化多少输入内容。输入越长,等待越久,这几乎成了铁律。
最近,一项由中国科学院自动化研究所、中国科学院大学与腾讯微信联合完成的研究,为这个普遍存在的效率瓶颈提供了一个巧妙的解法。这项于2026年5月发布在arXiv预印本平台(编号arXiv:2605.06221)的工作,提出了一个名为UniPrefill的框架。实验证明,它能将AI处理长文本的速度最高提升2.1倍,且几乎不影响回答质量。更重要的是,当服务器同时服务大量用户时,加速效果反而更显著——这恰好击中了AI服务商最头疼的现实痛点。
一、为什么“读完再说”会成为大问题
要理解UniPrefill的价值,得先看看现代大模型处理长文本时面临的“计算泥潭”。当前主流大模型的核心是“自注意力”机制,你可以把它想象成一场极其严谨的圆桌会议:输入文本的每个词都是一位与会者,而规则要求,任何人在发言前,必须与房间里其他所有人逐一握手、交换信息。这意味着,如果输入1000个词,就需要进行约100万次“握手”;输入1万个词,这个数字会暴增至1亿次。计算量呈平方级爆炸,等待时间自然水涨船高。
为了应对这个挑战,业界近年来涌现出一批“混合架构”模型。它们的思路大致分两类:一是用计算效率更高的“线性循环”层替换部分“全体握手”层,将复杂度从平方级降回线性级,代表如Qwen3-Next-80B-A3B;二是让大多数层只与邻近的“邻居”握手,仅保留少数全局层,代表如Gemma-3-12B。这些设计在理论上大幅削减了计算负担,并已被多家厂商用于生产级模型。
然而,现有的主流加速方法,如MInference、FlexPrefill等,几乎都聚焦于优化“全体握手”这一步。它们在纯全注意力模型上效果显著,但一旦遇到混合架构,短板就暴露无遗。试想,如果一个模型有四层,只有一层需要“全体握手”,那么即便把这一层的握手速度优化到极致,其他三层的计算时间依然雷打不动。这就好比一段包含飞机、火车和汽车的旅程,你只优化了飞行段,对总耗时的影响自然有限。数据也证实了这一点:在处理128K长文本时,MInference在Gemma-3-12B上的加速倍数仅为1.03倍,近乎无效。
此外,这些方法还有一个更根本的“硬伤”:它们与现代AI推理引擎的核心调度机制——“连续批处理”不兼容。这种机制允许服务器像公交车一样,动态打包处理多个用户的请求。而FlexPrefill等方法假设每次只处理一个固定请求,无法适应这种“乘客随时上下车”的动态场景,因此始终难以走出实验室,进入真实的生产环境。
二、图书馆管理员的聪明剪枝法
UniPrefill的思路,可以用一个更聪明的“图书馆管理员”比喻来理解。现在,这位管理员学精了:在开始逐页阅读之前,他会先花一分钟快速扫视所有书架,判断哪些区域与你的问题完全无关,然后果断跳过,只精读真正相关的部分。更妙的是,一旦他决定跳过某个书架,这个决定对整栋图书馆的每一层都生效——后续所有楼层的查阅都自动跳过它。省下的时间,是每一层节省时间的总和。
技术实现上,UniPrefill分三步走,环环相扣。
第一步是“重要性估计”。当模型运行到一个“全体握手”层时,系统不会立刻让所有词两两计算,而是先抽取输入序列末尾的一小部分词(默认128个)作为“提问者”,让它们与全文所有词进行一次快速握手,从而为每个词估算出一个初步的“重要性分数”。这个操作的计算量远小于完整的全注意力计算。
这里需要厘清一个关键区别:UniPrefill的这一步,与另一个知名方法SnapKV有表面相似,但目的截然不同。SnapKV是在处理完整个输入后,用分数来压缩后续生成时需要存储的“记忆”(KV缓存),并不减少处理输入时的计算量。而UniPrefill是在处理输入的当下,就用这个分数来决定跳过哪些计算,节省的是眼前的时间。
第二步是“Top-p词块筛选”。系统将整个输入序列按固定大小(默认64个词一组)切分成“词块”,把第一步得到的重要性分数在词块内取平均,得到每个词块的综合重要性。然后,系统按重要性从高到低排列词块,保留重要性之和刚好达到总重要性99%的最小词块集合,其余全部丢弃。
选择“Top-p”而非固定数量的“Top-k”,有其统计学的考量。注意力分布因文本内容而异:有时高度集中于几个关键词,有时则均匀分散。固定保留50个词块,在前一种情况下会混入大量无关内容,在后一种情况下又可能丢失关键信息。Top-p策略则能自适应:注意力集中时保留得少,分散时保留得多,始终确保丢弃部分的重要性占比不超过1%,为信息损失设定了严格的上限。
此外,有两类词块享有“免裁特权”:序列开头的128个词(它们在注意力机制中扮演特殊的“锚点”角色)和序列末尾的128个词(即那些“提问者”本身)。
第三步,也是UniPrefill最核心的一步,叫做“稀疏性跨层传播”。被判定为不重要的词块,不仅在当前这个“全体握手”层被跳过,而且在当前层之后的所有计算层——无论是线性循环层、滑动窗口层,还是前馈神经网络层——都被永久跳过,直到下一个“全体握手”层重新评估为止。这些被跳过的词的隐藏状态会被“冻结”并传递下去,以备需要时“复活”。
这个设计的收益是叠加的。假设某次筛选保留了60%的词,那么后续每一个计算层都只需处理这60%的词,节省的计算量随层数累加。理论分析表明,在序列极长的情况下,UniPrefill能节省的计算量,相对于传统稀疏注意力方法的优势,会随着序列长度增长而趋向无穷大。
三、把这套逻辑塞进工业级服务器
精巧的算法若不能在生产环境中落地,便是空中楼阁。研究团队在系统工程上投入了大量精力,将UniPrefill深度集成到了业界广泛使用的推理引擎vLLM中。
首先,整个重要性估计和筛选流程被封装成四个紧密融合的GPU计算核,全程在显卡上完成,避免了在GPU和CPU之间来回搬运数据的开销。流程包括:计算注意力得分、在线归一化、词块内分数聚合,最终生成一个决定去留的二值掩码。
在多GPU并行计算时,每个GPU只负责部分注意力头,看到的是局部重要性分数。团队的解决方案是,在做出筛选决定前,先将所有GPU的局部分数汇总为全局分数,确保所有GPU对“留谁丢谁”达成一致,避免出现数据混乱。
更大的挑战在于与vLLM的“连续批处理”调度器协同工作。vLLM会动态打包多个用户请求,用统一的数据结构管理所有词的物理位置、KV缓存地址等信息。当UniPrefill丢弃部分词后,这套数据结构必须同步更新,否则后续计算会出错。
为此,团队设计了一套精细的状态维护机制。每次丢弃操作发生时,系统会记录下丢弃发生的层编号和保留的词数,形成一份“丢弃历史账单”。在后续的文本生成阶段,当模型需要查阅之前存储的“记忆”时,系统会根据这份账单,准确告知每一层实际写入了多少条记忆。整个过程无需修改模型权重,也无需改动vLLM底层的内存分配器,可以像一个透明的加速插件无缝嵌入现有系统。
四、在真实测试中的表现究竟如何
研究团队使用目前评估长文本能力最全面的基准测试之一——RULER来检验回答质量,同时在vLLM框架内测量实际处理速度。
在三个代表性模型上,UniPrefill都显著优于其他加速方法。以纯全注意力架构的LLaMA-3.1-8B为例,在128K上下文长度下,UniPrefill的RULER分数为79.87,比未加速的基准(76.89)甚至略有提升(注意力更聚焦所致),同时将首字延迟缩短了2.26倍。相比之下,LazyLLM在同等长度下分数暴跌至49.71;MInference虽保住了78.21的分数,但加速倍数仅为1.34倍。
在混合架构模型上,UniPrefill的优势更为明显。对于Qwen3-Next-80B-A3B(线性与全注意力3:1混合),MInference在128K上的加速倍数只有1.05倍,而UniPrefill达到了1.68倍。对于Gemma-3-12B(滑动窗口与全注意力5:1混合),MInference仅加速1.03倍,UniPrefill则加速1.49倍。这印证了核心判断:当全注意力层占比变小时,只优化它的方法收益骤减,而UniPrefill的跨层传播机制让它依然有效。
吞吐量测试揭示了另一个维度的效益。单用户使用128K文本时,LLaMA-3.1-8B的处理吞吐量从每秒21013个词提升到43672个词,增幅达107%。当同时服务16个用户时,增幅进一步扩大到109%。Qwen3-Next-80B-A3B在128K单用户场景下提升48%,16用户场景下提升68%。Gemma-3-12B的提升相对较小(128K单用户42%),这与其全注意力层占比最低(仅六分之一)直接相关。
一个有趣的现象是,在文本极短(4K)且用户极少(单用户)的场景下,Qwen3-Next-80B-A3B的吞吐量反而有3%到5%的轻微下降。原因在于,文本太短时几乎没有可丢弃的词块,重要性估计本身的计算开销反而成了负担。这恰恰说明,UniPrefill的优势主战场在于长文本和高并发场景——而这正是生产环境中最普遍、最需要优化的情形。
五、微调参数时的规律与取舍
研究团队还系统测试了两个关键超参数的影响,为实际应用提供了直观指南。
词块大小G决定了丢弃操作的粒度,好比管理员是跳过“一层书架”还是“一排书架”。G=64是精度与速度的平衡点。G=32更精细,在长文本下能丢弃更多无关内容,但判断开销也更大;G=128更粗放,适合短文本,判断快但灵活性低。实验显示,G=32在LLaMA-3.1-8B的128K场景下可实现121%的吞吐量提升,代价是在4K场景下精度从96.53微降至93.42。
末尾查询数量n决定了“提问者”的规模。n过少(如32),估计样本不足,结果方差大,容易误判,导致RULER平均分从90.45下滑至87.77。n过多(如512),估计更准但开销增加。n=128在精度与开销间达到了最佳平衡,被设为默认值。
说到底,UniPrefill的理念清晰而直接:让AI在深度处理前,先做一次快速的“重要性预扫描”,随后在所有计算层中只聚焦于关键部分。它的巧妙之处在于,突破了“仅优化注意力层”的局限,将一次判断的收益扩散至整个模型,从而在混合架构上依然有效。通过与vLLM的深度集成,这套方法得以在真实的多用户、高并发场景中运行,而非停留在论文里。
对普通用户而言,这意味着未来用AI处理长篇文档时,等待时间有望缩短一半以上,尤其在服务器繁忙时。对AI服务提供商而言,同等硬件能服务更多用户,或在不增购服务器的情况下支持更长的上下文。
当然,这项研究也明确了自身边界:UniPrefill目前专注于“输入读取”阶段的加速,对于文本“生成输出”阶段以及模型训练本身的效率,尚未涉及,这被列为未来的探索方向。
Q&A
Q1:UniPrefill是如何决定哪些词可以被跳过的?
A:它在每个全注意力层处,先用序列末尾的128个词快速扫描全文,为每个词块打出重要性分数,然后保留重要性之和达到99%的最小词块集合,其余跳过。序列开头和末尾的128个词会被强制保留。
Q2:UniPrefill加速长文本处理会不会让AI的回答质量变差?
A:在RULER基准测试中,与未加速的版本相比,其精度损失极小,部分情况下甚至因注意力更聚焦而略有提升。相比之下,其他加速方法在同等加速比下常出现明显的精度下降。
Q3:UniPrefill对混合架构模型(比如Qwen3或Gemma-3)有效吗?
A:有效,这正是其核心优势。由于它能将丢弃决定传播到之后的所有层,因此在混合架构上依然能获得可观加速。而传统稀疏注意力方法在这类模型上加速效果通常微乎其微(不足1.1倍)。
链式推理在数学推理任务上有效,但用于视觉定位、数物体等感知任务时准确率下降。研究揭示,AI在推理过程中注意力逐渐从图片转向自身生成的文字,形成“轻视觉、重语言”的核心缺陷,导致多模态推理名不副实。
中国科学院自动化研究所与国科大联合研究发现,大型语言模型在多轮工具调用中强化学习崩溃的真相是格式结构崩溃,而非能力丧失。提出过程反思监督等交错训练方案,有效稳定训练并提升性能,最高得分达25.75分。
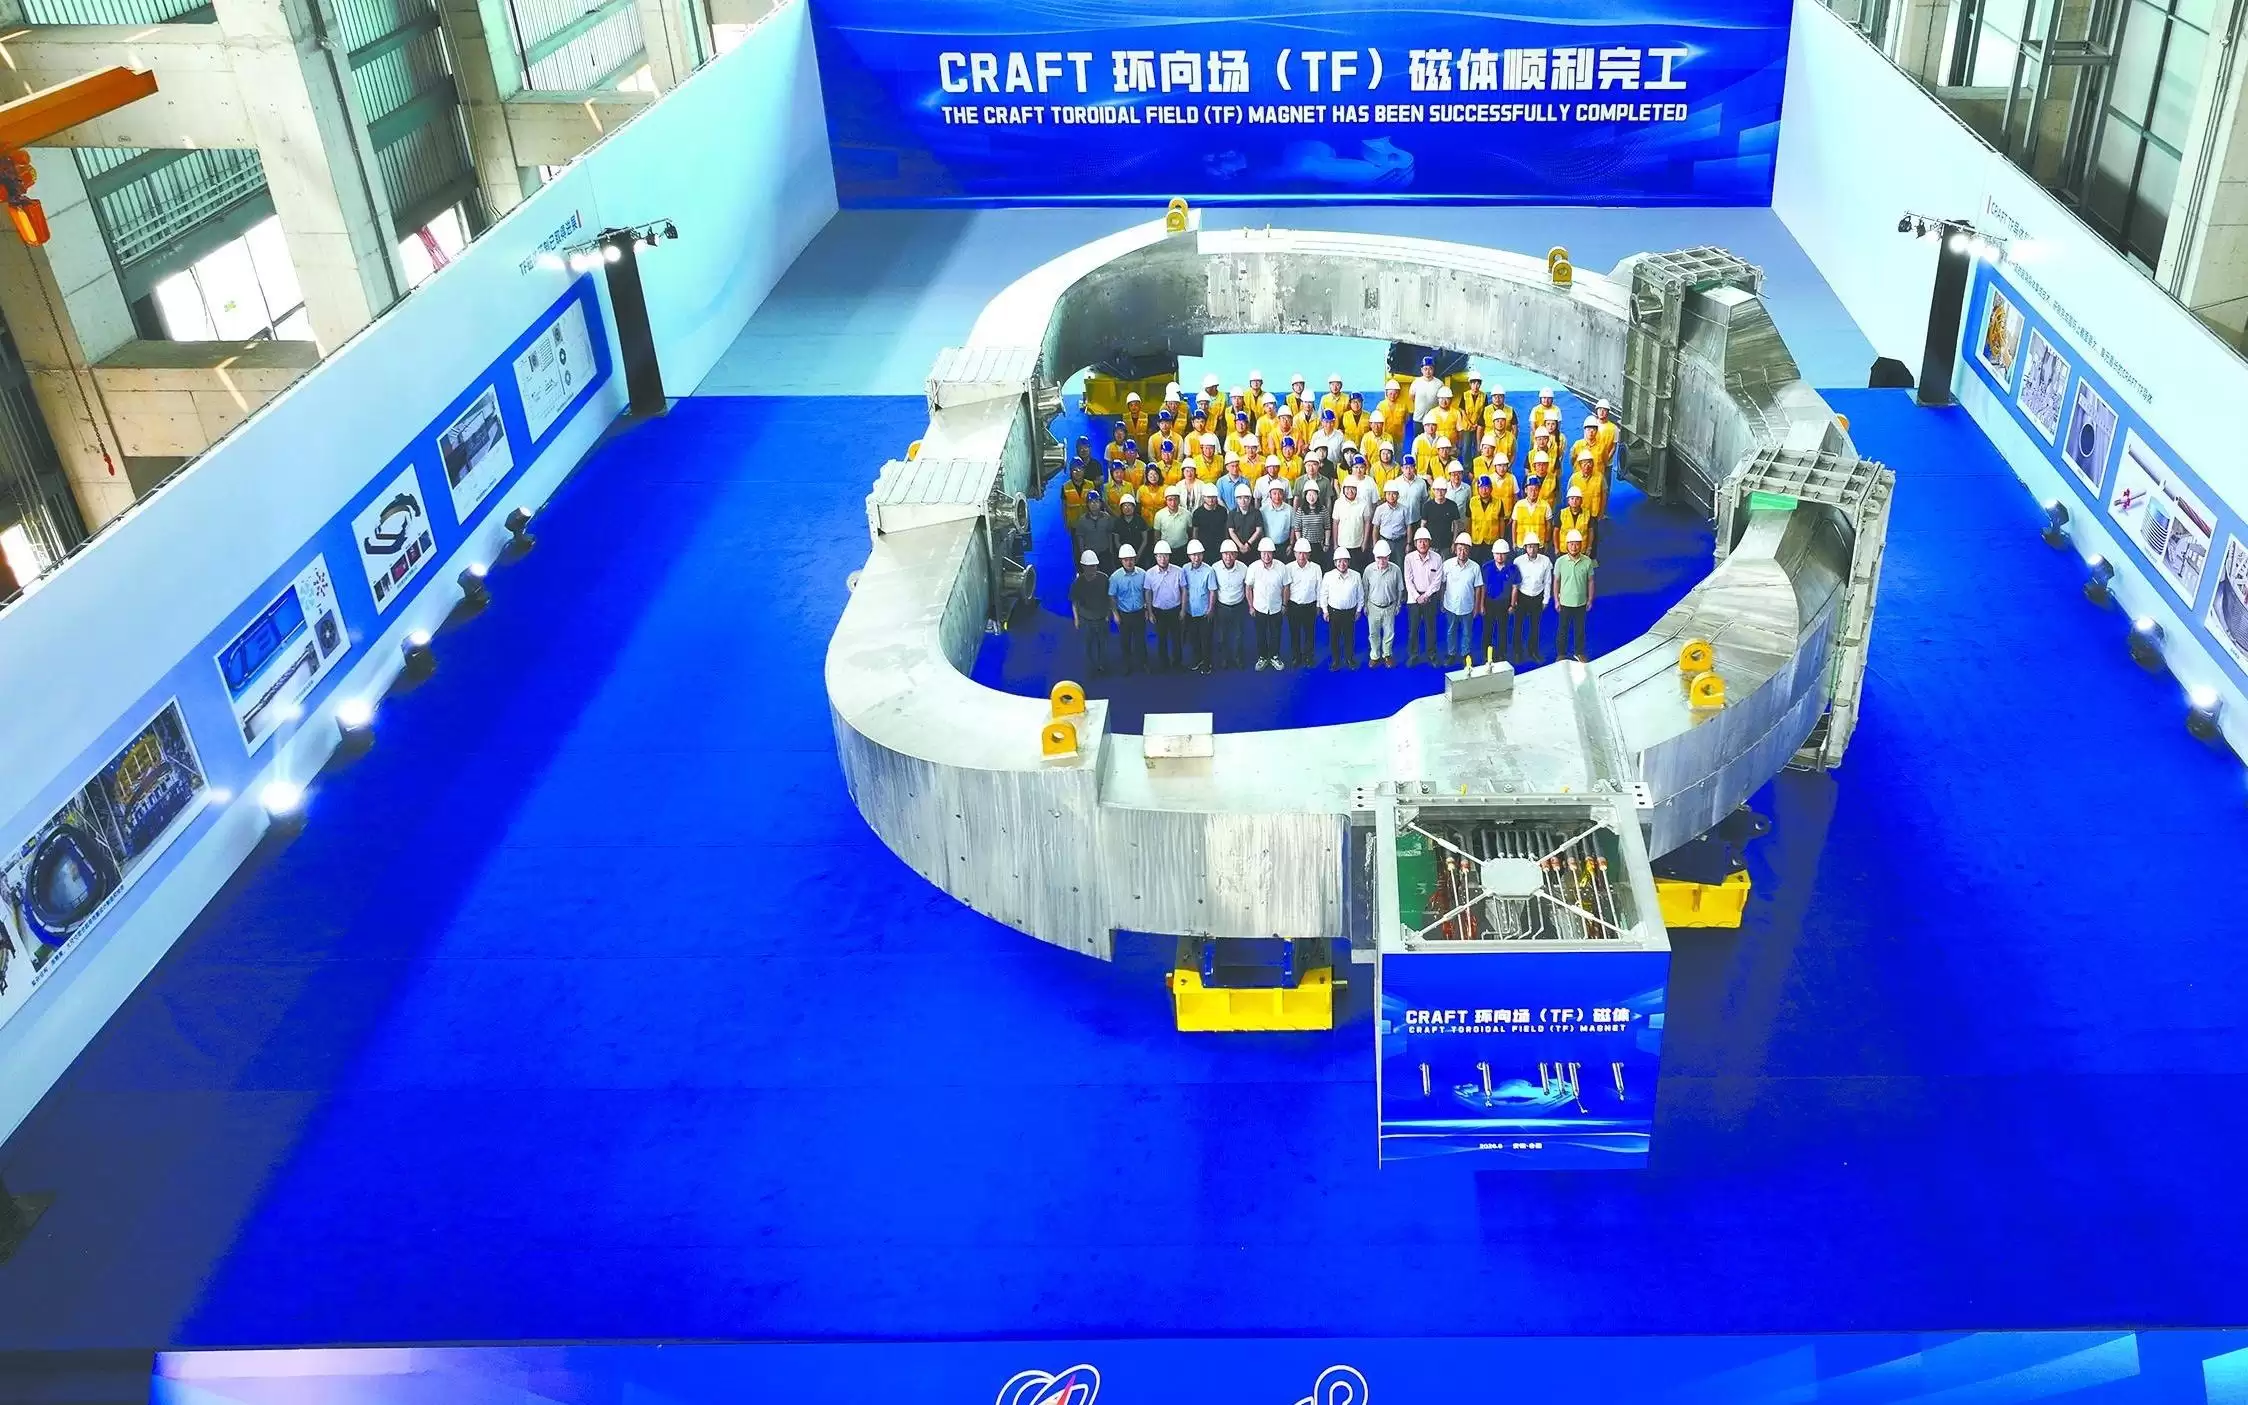
中国自主研制的聚变堆关键超导磁体通过验收,包括全球最大超导磁体和高性能中心螺管线圈,性能达国际领先水平,实现100%国产化。我国规划聚变能“三步走”战略,紧凑型聚变能实验装置计划2027年底建成,力争2030年前后实现核聚变发电。
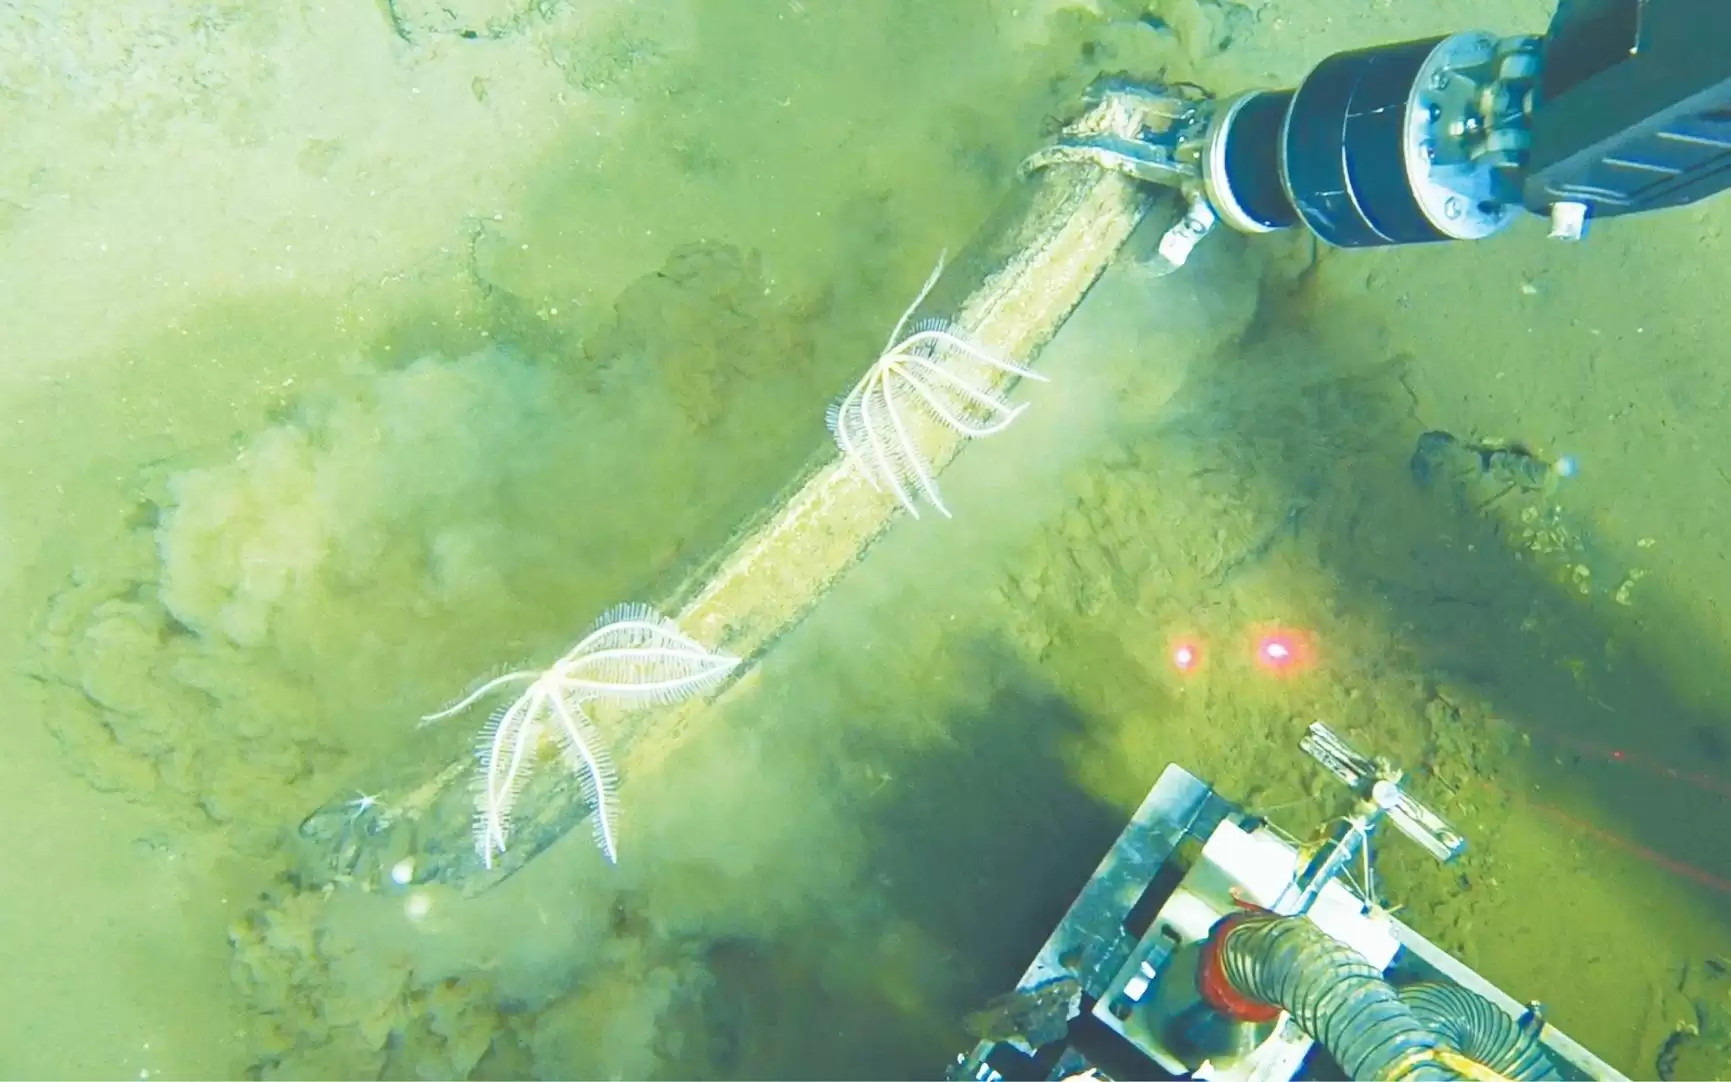
近7000米深的东南印度洋海底,一片规模惊人的鲸类遗骸群正缓缓浮现。这些遗骸散落在绵延约1200公里的海底,据估算,它们已经沉睡了至少530万年——这可能是目前全球已知最深、规模最大的鲸类化石群和鲸落生态系统。中科院深海所的科研团队,与意大利比萨大学、新西兰地球科学研究所等机构合作,依托“探索一号”
通过构建受控合成环境,揭示AI长程规划机制:预训练中,世界模型内化优于直接预测,少量长程示范激活组合泛化,次优数据致错误累积;后训练中,强化学习仅中质数据有效,知识蒸馏因冲突易失败;多教师融合需模式兼容。
中国科学院安光所方勇华团队研制出双差分球—管耦合光声-散射系统,实现气溶胶在450纳米和532纳米波段吸收与散射参数的时空同步高精度测量,为大气环境研究提供新手段,成果发表于《光声学》。
中国科学院自动化研究所研发的磐石2.0科学基础大模型实现通专一体化,在天文、力学、化学等领域秒级处理,效率提升50倍,依托国产算力与多学科协同,推动科研从工具辅助迈向自主发现新范式。
在二维材料的前沿探索中,又有了一项令人振奋的突破。中国科学院宁波材料技术与工程研究所等团队,这回使出了“化学剪刀”的绝活——通过亚层编辑策略,成功将镧系元素“嵌入”MXene晶格,首次合成出兼具半导体特性和铁磁性的新型二维材料,即镧系MXene材料。 先简单回顾一下背景。MXene是一类二维层状过渡
中国科学院物理研究所研究员黄学杰指出,手机每次充满电会加速电池老化,日常充至80%即可停止;同时避免深度放电至0%和边充边玩大型游戏,以免高温造成不可逆损伤。遵循这些建议,能有效延长电池使用寿命。
中国科学院院士陈十一指出,物理AI的核心在于理解、预测和影响物理世界,CAE作为提供物理规律与验证闭环的关键底座,是物理AI进入工业世界的基础。同时,AI正将CAE改造为可交互、推理的工业智能体,抓住融合窗口期有望建立自主工业软件与AI平台优势。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



