

让AI自我构建的RSI火了!Google泼冷水,DeepSeek们摸到了边
递归式自我改进(RSI)让AI自我训练,成为行业焦点。GoogleCEO认为尚未达到该阶段,但Anthropic已有AI自主编写代码实践。国内DeepSeek通过算法优化间接实现RSI逻辑。但存在模型坍缩、算力与数据等瓶颈,RSI需开放世界支撑。
“递归”这个词,最近突然在AI圈子里炸开了。
有两家初创公司直接拿它当了招牌,不少实验室的路线图里,也悄悄塞进了一个缩写——RSI。对应英文是Recursive Self-Improvement,翻译过来就是“递归式自我改进”。这感觉,有点像当年的AGI,正变成一个让人既兴奋又忐忑的行业暗号。不过说回来,大家对它的具体定义,其实还没完全对齐。
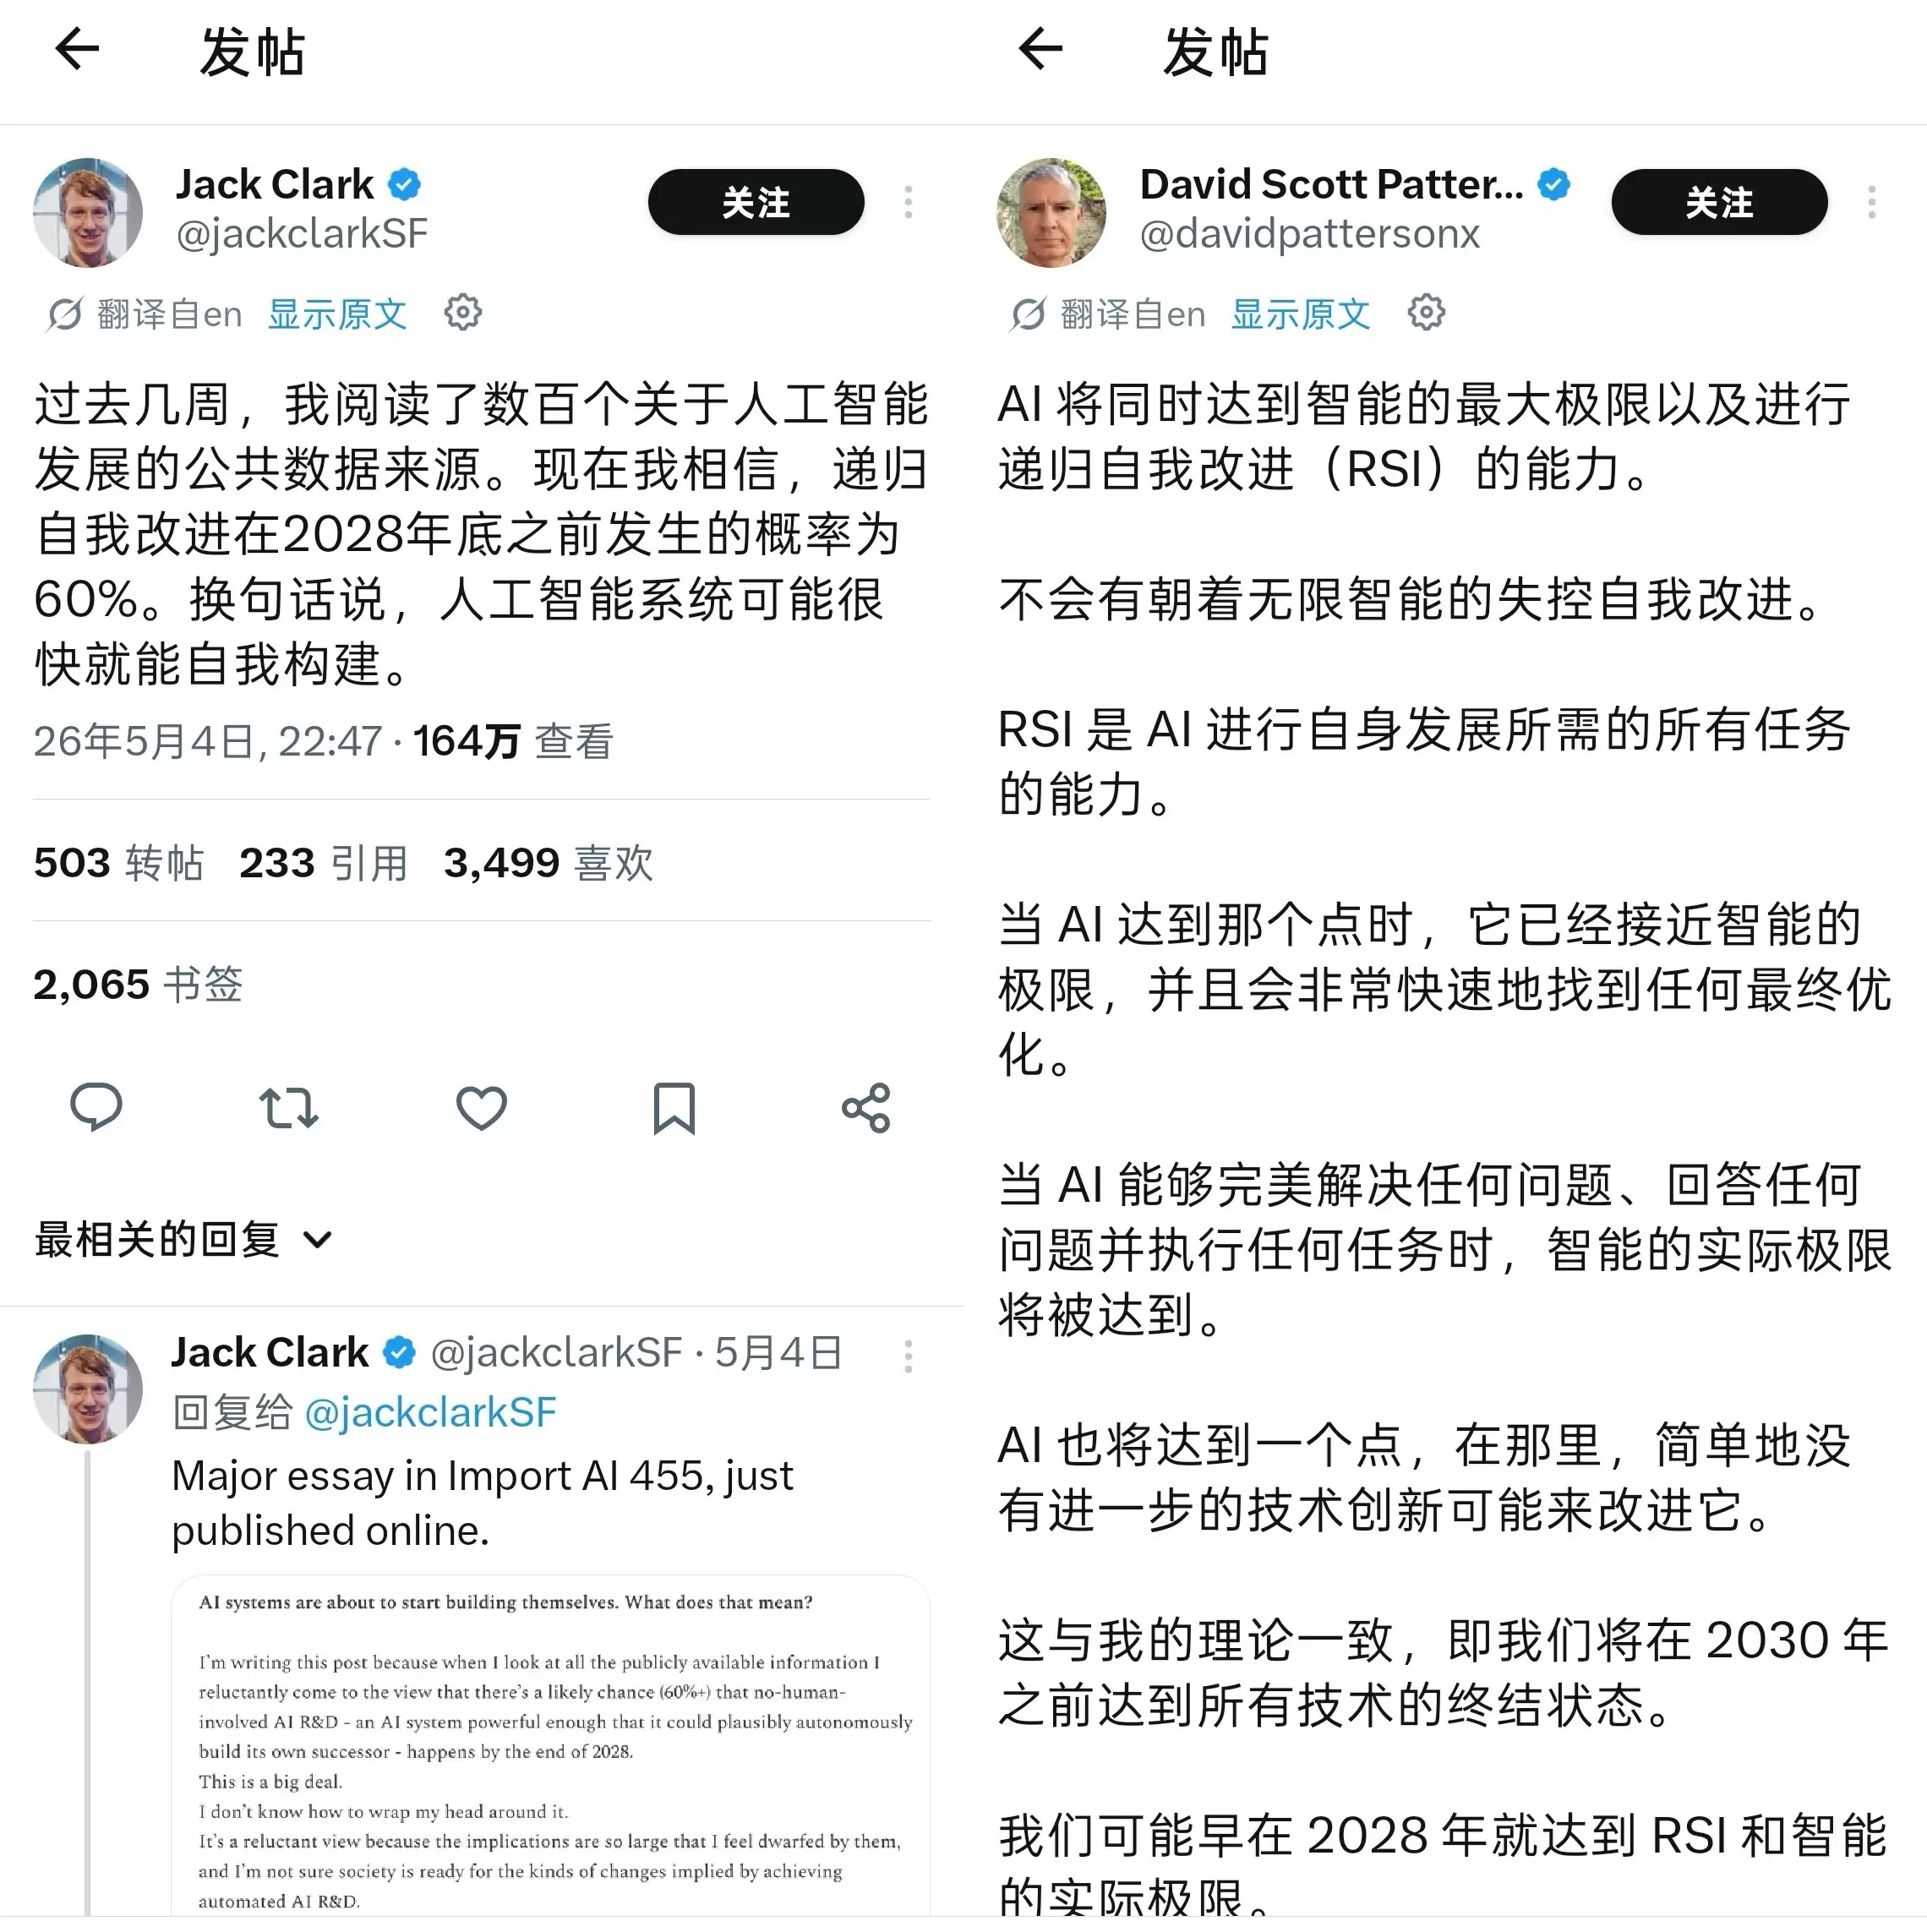
(图源:X)
那么,RSI到底是什么?通俗点讲,就是让AI自己训练自己。在技术圈,RSI一直被视为人工智能进步的核心标志之一,跟记忆、推理和多模态能力排在一起。唯一限制它的,是算力。而人类在这个过程里,已经不是必要条件了,甚至连帮手都算不上。
听起来很酷?或者,听起来有点吓人?但冷静下来想,这也不是AI行业第一回这么狂热了。从2016年的AlphaGo,到2023年的ChatGPT,再到现在各家大模型轮番上阵的参数军备竞赛,AI这个行业的天性,就是追逐下一个“改变一切”的东西。在很多人看来,RSI很可能就是下一场狂欢。
RSI火了:当AI能靠“递归”进行自我构建
今年5月,AI界大佬级研究员Richard Socher,高调创办了一家名为“Recursive Superintelligence”的新公司,名字直接就挂着RSI。他表示,核心目标就是构建真正意义上的递归式自我改进超级智能,整个研究的构思、实现和验证过程,全部自动搞定。
另一个让圈内人更津津乐道的案例,是安德烈·卡帕西(Andrej Karpathy)在推进的一个叫Auto-Research的项目。他用智能体集群来训练语言模型,让模型自己做一些简单的研究任务,然后自己去改进自己。
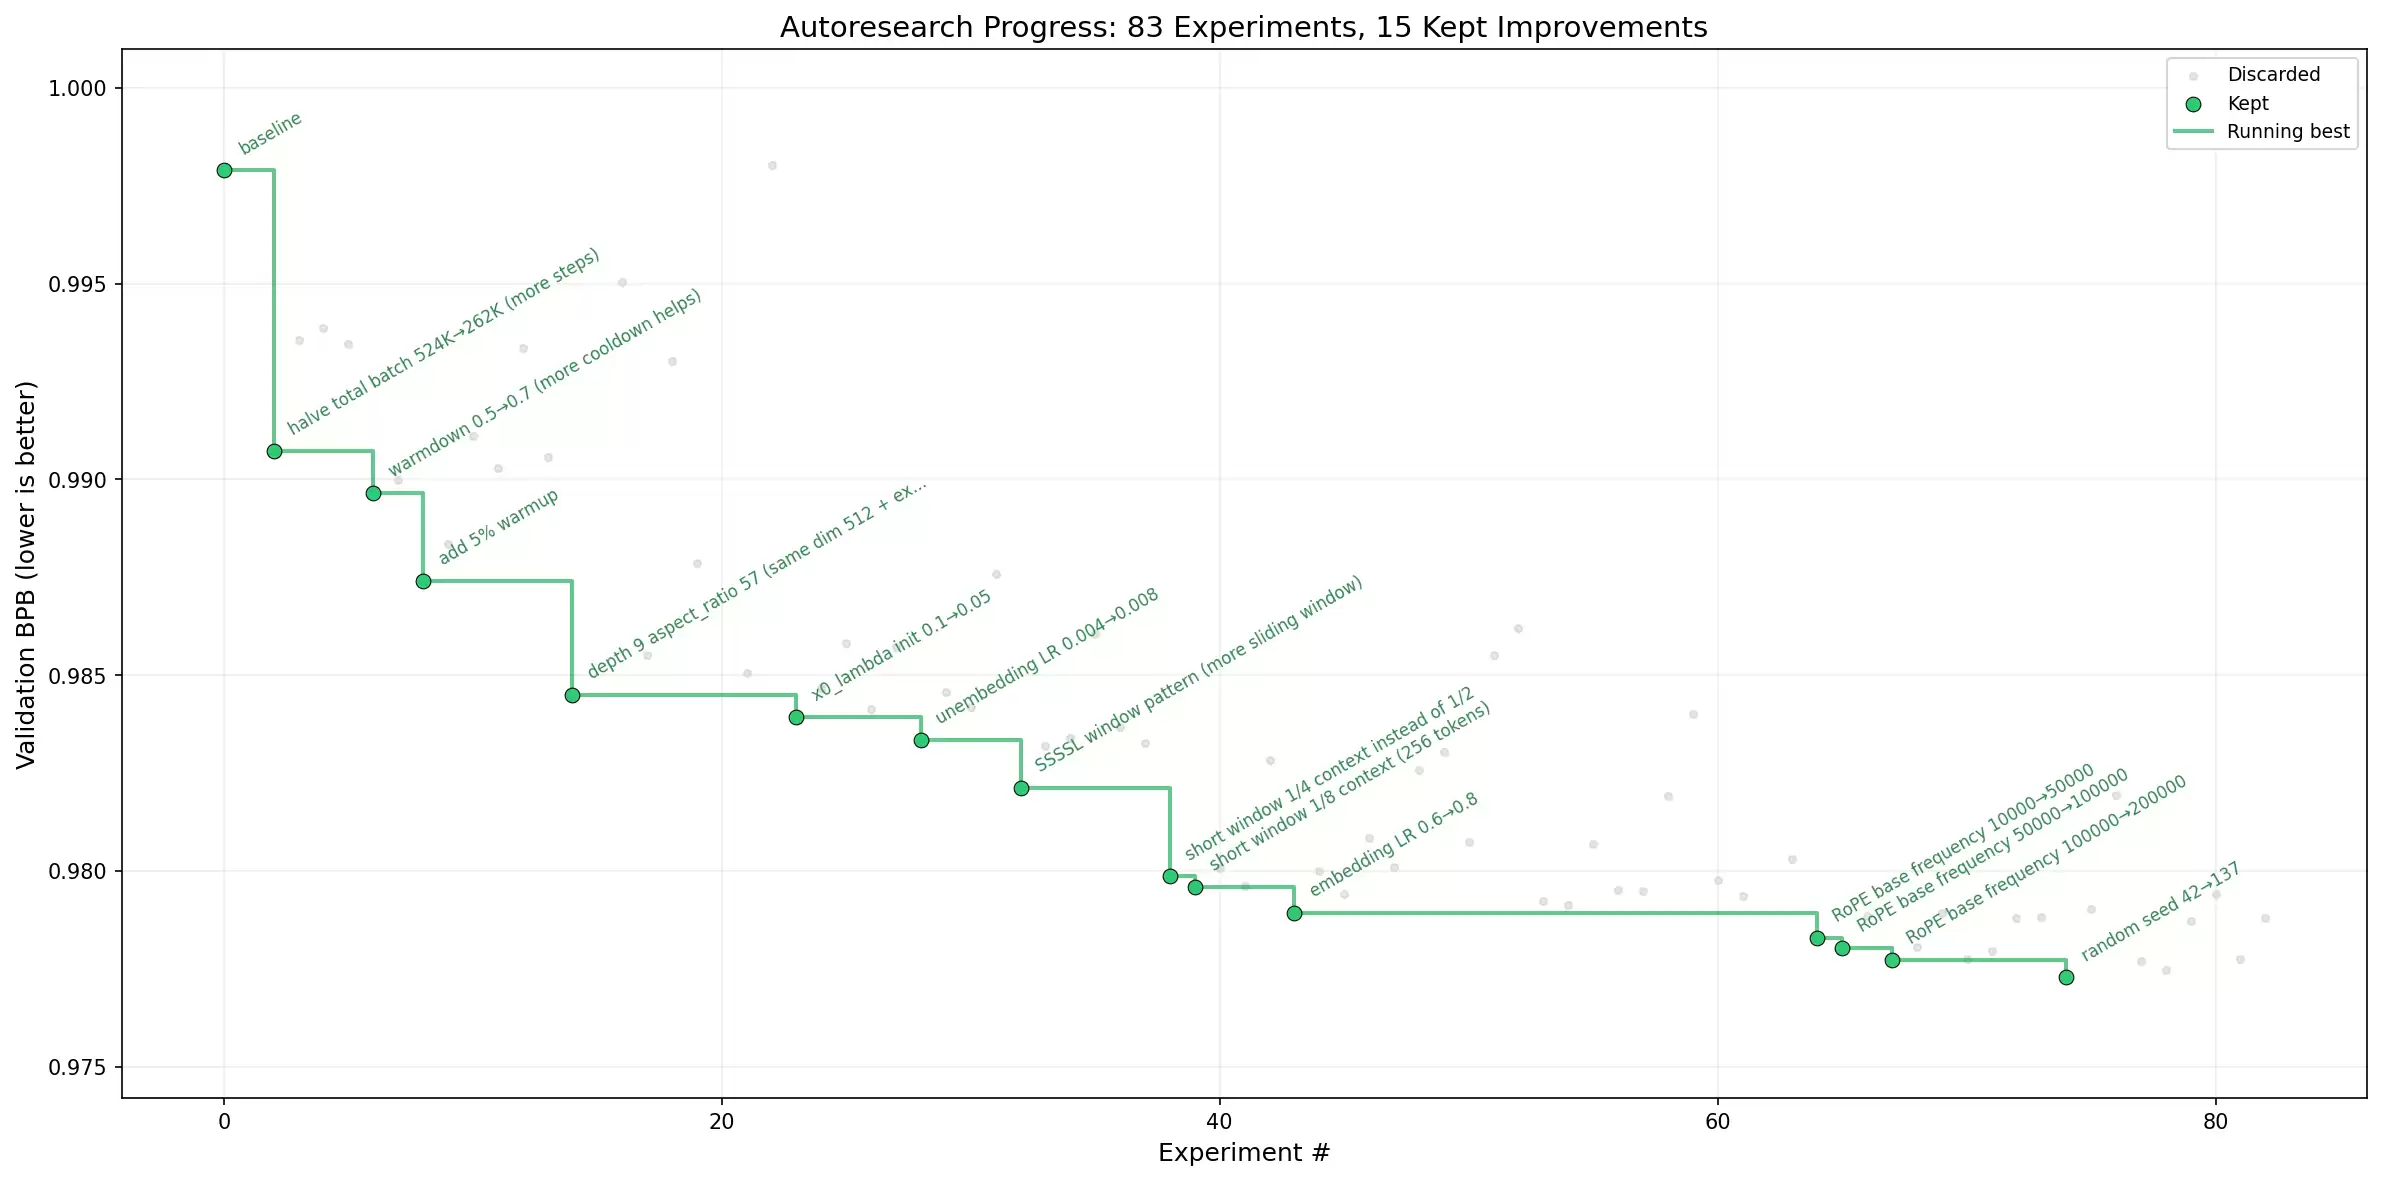
图源:github
安德烈·卡帕西,在圈内也是个传奇人物。他在特斯拉搞过自动驾驶,在OpenAI做过GPT,都留下了硬货。现在他把RSI当成了下一站,而且是全身心投入。更关键的是,他选择用公开透明的方式去推进,这也说明,他是真信这事儿能成。
有个细节挺有意思,他对这个项目出奇地坦诚,定期在推特上更新进展,代码也都开源到了GitHub。当然,他自己也说了,目前的工作还是在GPT-2级别的小模型上做迭代,“暂时还不是什么突破性研究”。但这已经足够带动一大票研究者跟进了。
更重要的是,安德烈·卡帕西最近加入了Anthropic的预训练团队。Anthropic有Claude,卡帕西手里有Auto-Research这套方法论,两边一结合,大模型加上自训练循环。一旦跑通,那就不是GPT-2级别的小打小闹了。
图源:haimagazine
另一家叫Adaption的公司,也推出了一个AutoScientist工具,目标是自动化前沿模型的训练过程。逻辑跟卡帕西的Auto-Research差不多,都是训练智能体去做渐进式的改进。只不过Adaption的野心更大,想直接搞定一整个全尺寸前沿模型的训练闭环。
这两家,其实代表了两种不同的路线。卡帕西是从底层逐块验证,一边开源一边在社区里攒势能;Adaption则是直接冲着商业化的大模型训练场景去的,落地的意愿更强烈。这两条路,谁先跑通,对整个行业的影响会截然不同。
Google CEO泼冷水:我们还没到那一步
关于RSI,圈内的大佬们也是众说纷纭。
Google CEO桑达尔·皮查伊,上个月在一档播客里,措辞相当谨慎地承认了现实。他说,“RSI更像是一个连续体,我们确实都在进步。但如果按照大家描述RSI那种方式,那代表的是下一个量级的加速,会带来很多影响。但我们还没到那一步。”
话虽如此,但这里面的“连续体”描述,其实已经包含了不少让人细思极恐的事情。
今年1月,Anthropic一位主导Claude Code开发的程序员坦言,团队里接近100%的代码,是Claude Code写的。这不是AI辅助工程师写代码,而是AI工具在某种程度上,已经开始替代工程师去写自己的代码。
图源:Anthropic
Anthropic有一份关于Mythos预览版本的内部调查,显示在18位工程师里,有5位认为,如果配套系统再改进一下,这个版本的Mythos就可以替代一个L4工程师。L4是什么水平?是那种能独立承接复杂项目、不需要实时监督的中级程序员。
但缺陷也写得很清楚:“Claude报告的主要弱点包括:管理周期以上的模糊任务、理解组织优先级、品味、验证、指令遵循和认识论。”说白了,它弱的地方,恰恰是自我驱动。而自我驱动,正是RSI的根基。
更有意思的是,Georgetown的安全与新兴技术研究中心(CSET),去年组织了一批专家专门研究RSI。结果一群专家在评估时,出现了明显的分裂。一部分人预期很快就会迎来“超级智能爆炸”,另一部分人则预期进展会更慢,最终会触达某个瓶颈期。
但他们也有一个共识:递归,让未来变得格外难以预测。
为此,METR的研究员Ajeya Cotra写了一篇文章,把RSI的进程拆解成了几个里程碑。这是一个目前来看非常实用的分析框架。
第一级叫“足够”(Adequacy)。就是当人类被完全移除后,系统依然能做研究——哪怕做得不如人类,但它能自己运转起来。
第二级叫“对等”(Parity)。AI独立完成的研究,和人类独立完成的研究,质量相当。
第三级叫“超越”(Supremacy)。AI独立系统的表现,超过了人类与AI协作的系统。
这个分级框架,有点像自动驾驶的L2、L3、L4、L5。Ajeya Cotra的判断是,我们离第一级已经很近了。至于第二级什么时候来,她没给具体时间表。但她给了一个非常明确的推演:一旦第二级到来,后续的加速会远超过往,“一年之内,可能就会冲到第三级”。
为什么这么快?因为到了第二级的那一刻,AI就变成了一个不需要睡觉、不需要开会、不需要对齐KPI的研究团队。它可以24小时不间断地试错、改进、再试错。而人类做研究,哪怕效率再高的人,一天的有效深度工作时间也就那么几个小时,中间还夹着无数打断和沟通成本。一旦这个瓶颈不存在了,加速度是断崖式上升的。
国内没人喊RSI,但DeepSeek们已摸到了边
前面聊了一大堆海外的进展,你可能想问:国内呢?
坦白讲,国内厂商很少公开喊RSI。海外的AI公司能把“递归超级智能”写进公司使命,这种事在国内几乎不可想象。但要让AI自己去改进自己,国内厂商其实已经在不同的路径上,悄悄摸到边了。
最典型的例子是DeepSeek。他们花的钱比OpenAI少一个数量级,但在很多推理任务上已经可以正面硬刚。靠的就是算法效率的极致优化——MoE架构、激活参数的极致压缩、训练策略的工程化打磨。虽然这跟RSI关系不大,但这本质上是一条用更聪明的方法,去替代蛮力堆算力的路。而这,恰好是RSI的核心逻辑之一:让模型在迭代中找到更聪明的那条路径。
百度文心这边,强化学习驱动模型自我优化,已经是常规操作了。虽然没有用RSI这个名字,但做的是同一件事:让模型在特定任务上,通过自反馈循环不断改进。从这个角度看,国内厂商不是没在做RSI,只是他们已经把RSI的某些环节,变成了日常的工程实践,只是不挂这个名罢了。
(图源:gemini生成)
当然,差距也是客观存在的。OpenAI和Anthropic的人才密度,目前国内任何一家都还比不了。这意味着,在RSI的探索上,眼下我们仍然处于跟随状态。
但历史经验告诉我们,国内厂商在“管道路径明确之后”的追赶速度,往往是惊人的。RSI的框架正在被海外大神们拆得越来越清晰,卡帕西的代码也公开在GitHub上。一旦可复现的路径走通了,国内玩家的成本控制能力和落地场景密度,将会是一个被市场严重低估的变量。
但同时,我们也得适当泼点冷水。事实上,AI自己生成的数据,用来训练下一版AI,质量是会往下掉的。RSI的逻辑是,AI生成好的数据,然后用这些数据训练下一代AI,让下一代AI更强。
而实际情况可能恰恰相反。AI生成的数据里,往往会混进它自己的幻觉、偏见、质量退化。这些二手数据被喂给下一版,下一版再产出更差的三手货。循环几代之后,整个系统就塌了。这就像一个不断复印复印件的复印机,印到第十张,脸都糊了。学术界管这个现象叫“模型坍缩”,已经有论文验证过,这个现象是真实存在的。
再者,RSI需要的理想环境,在真实世界里根本不存在。这套系统要想跑起来,两个前提缺一不可:无限算力,以及全球开放协作的研究生态。而现实是,训练一个前沿模型的成本已经到了十亿量级,芯片产能有限、能源有限、优质数据也在变少。出口管制和技术脱钩,正在把AI研究切成几个互不流通的圈子,人和货都流不动。连这些基础条件都凑不齐,就别谈什么RSI了。RSI不只是一个技术问题了,它还需要一个足够开放的世界。而这个前提能不能成立,技术圈还真说了不算。
写在最后
最后说一个有意思的观察。整个行业在过去五年里,先是大规模预训练把人拉进了“参数崇拜”,然后是RLHF(基于人类反馈的强化学习)让人相信“价值观可以微调”,现在则是RSI,在讲一个“机器自己跑完整个研发链条”的故事。每一步,都在让人类往后退一步——不是退出行业,而是退出决策链条。
虽然这种退法不一定是坏事,但它是不可逆的。一旦某个环节被自动化接管了,人的直觉、经验、判断力在那个环节就会慢慢退化。就好比用了GPS之后,你会发现自己的认路能力确实在变差。到那时候,我们连工具是怎么造出来的,都不一定能真正理解了。
本文详细解析Sora在国内的使用现状,指出目前官方未对公众开放注册,提醒用户警惕虚假链接,并提供关注官方动态及替代方案的实用建议。
OpenAI GPT-6 Astra 模型通过 MCP 协议与 SourcePauseTool 控制《传送门》游戏,完成 3336 次工具调用并自主通关。实验耗时约 24 小时,API 成本约 571 美元,展示了多模态 AI 在 3D 解谜领域的突破性进展。
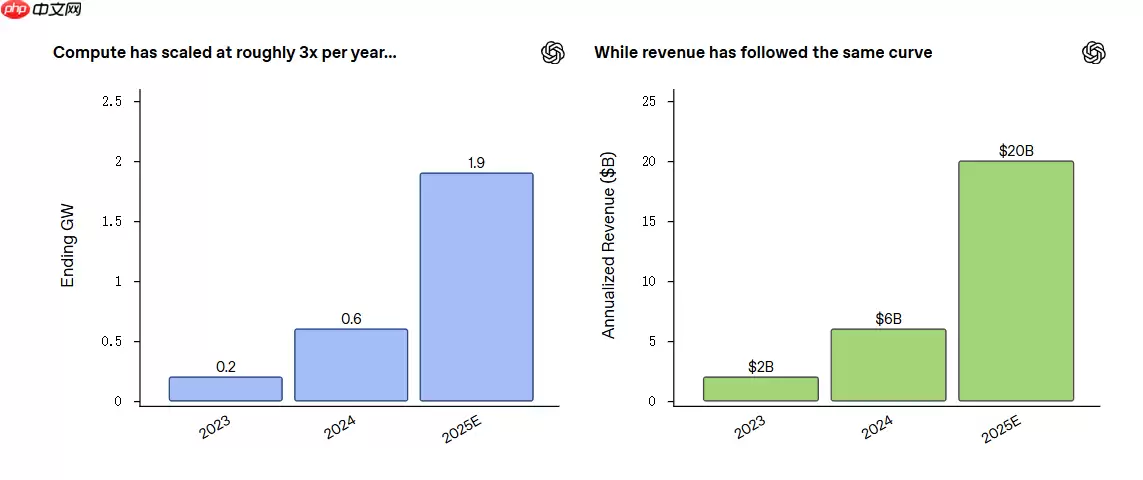
OpenAI算力总量预计2025年达1.9GW,较2023年增长9.5倍,年经常性收入同步增至200亿美元。推理成本已压至每百万token不到1美元,采取训练性能优先、推理效率优先的双轨策略。未来营收将拓展技术授权与按成效付费模式,并优先研发AIAgent与工作流自动化。
Transformer核心作者NoamShazeer离开谷歌加入OpenAI,担任架构研究负责人。他曾参与创办Character.AI,后因谷歌交易回归,如今再次转投。此举折射出行业对Transformer架构局限性的反思,以及下一代模型架构创新的迫切需求。
Transformer论文共同一作、谷歌元老级AI专家NoamShazeer再次离开谷歌,加盟OpenAI。他拥有高达35万余次论文引用,近期专利涉及结构化工具调用、神经架构搜索及混合专家模型等关键方向。OpenAI借此补齐构建超级智能体与底层模型架构的核心能力。
AI传奇人物诺姆·沙泽尔离开谷歌加入OpenAI。作为Transformer架构之父,他因不满谷歌严格的审批流程和“大公司病”,再次出走。选择OpenAI因其快速迭代理念和开放氛围,契合其推动AGI落地的核心诉求。
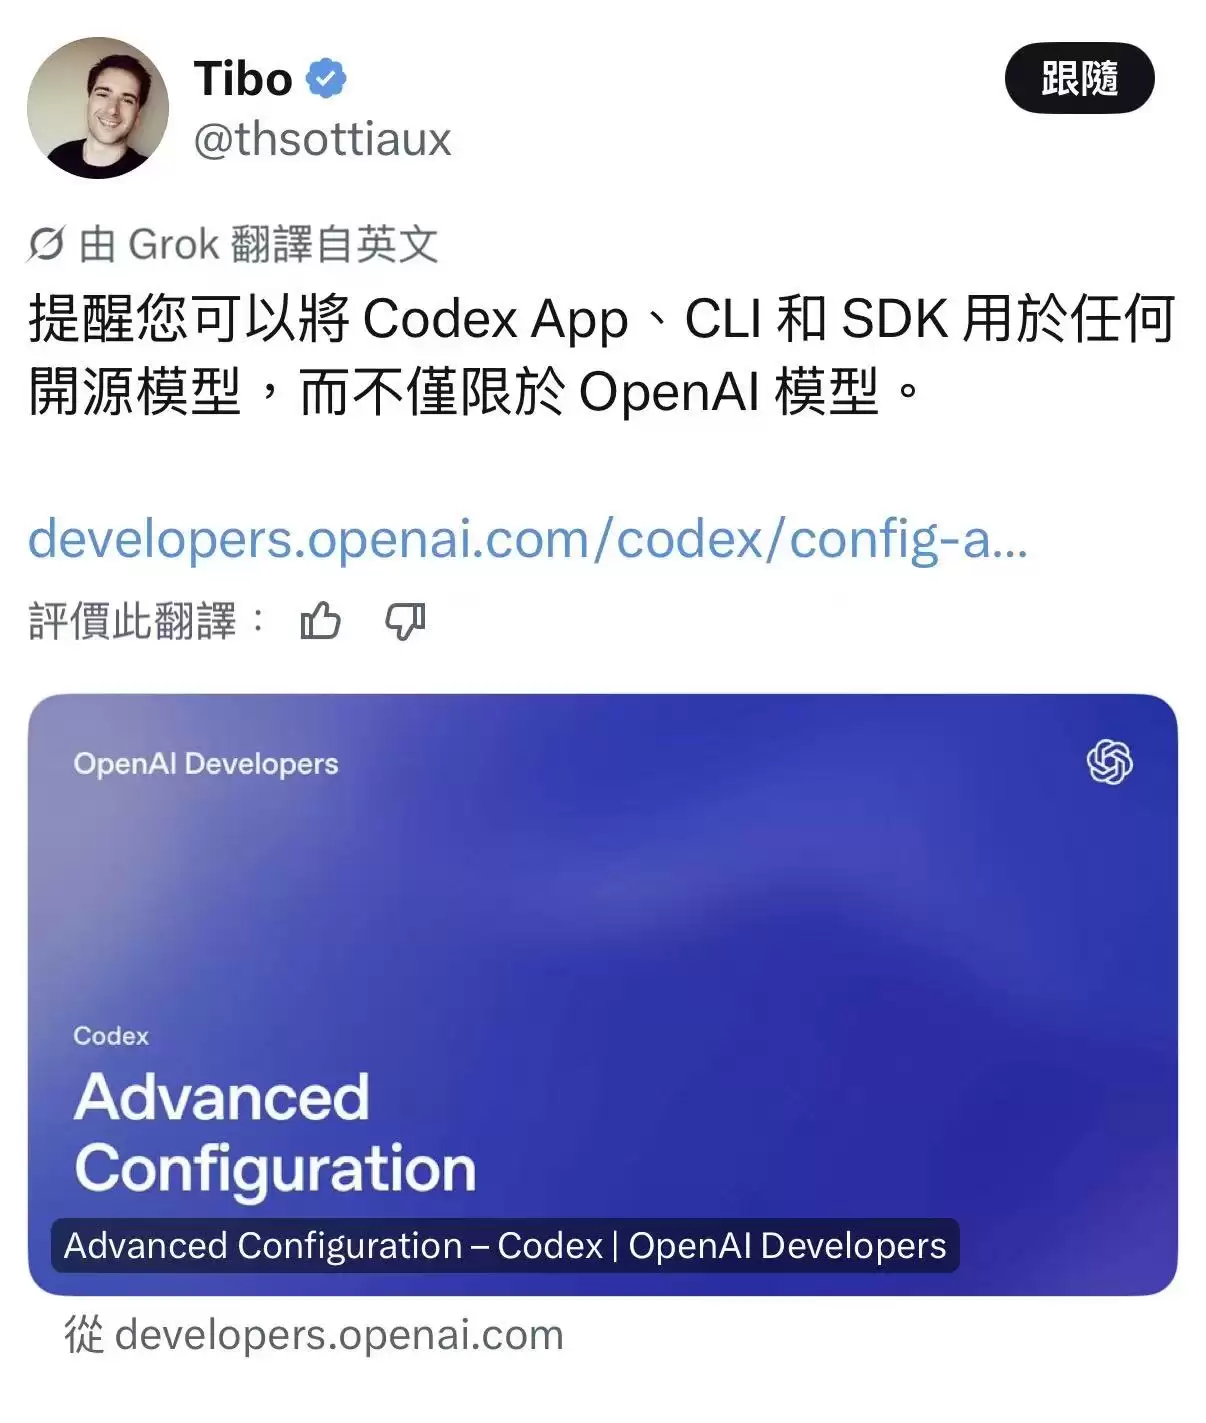
OpenAI的Codex工具开放第三方模型接入,但实际门槛高,仅支持ResponsesAPI协议。DeepSeek等国产模型无法直接接入,需通过本地转接桥,响应速度慢于官方模型,但成本极低。此举为国产模型提供成熟Agent容器机会,但OpenAI仍掌握核心标准。
OpenAI发布LifeSciBench基准测试,为AI制药建立标准化评估工具,推动行业规范。港股创新药板块短期承压,但AI制药从概念验证走向产业落地趋势不变,研发效率成核心竞争维度,板块估值有望修复。
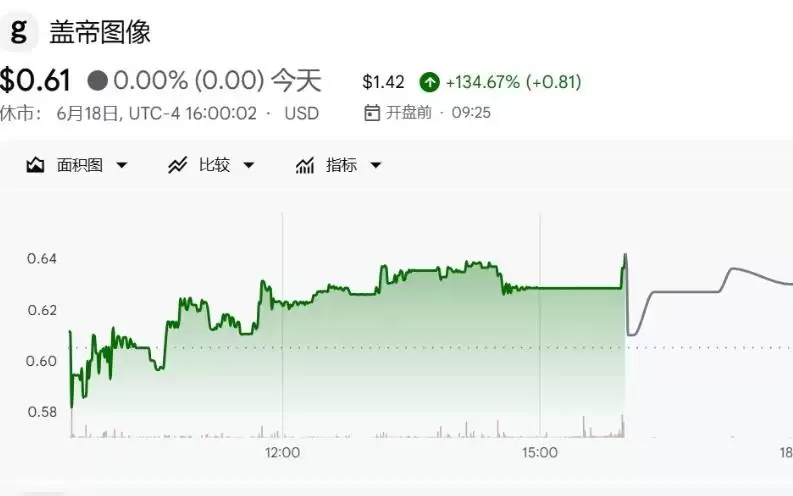
GettyImages与OpenAI签署展示协议,股价盘前暴涨141%,空头回补放大涨幅,市场反应强烈。此次合作标志着双方从对抗转向合作,OpenAI授权版图持续扩张,但公司基本面压力犹存。
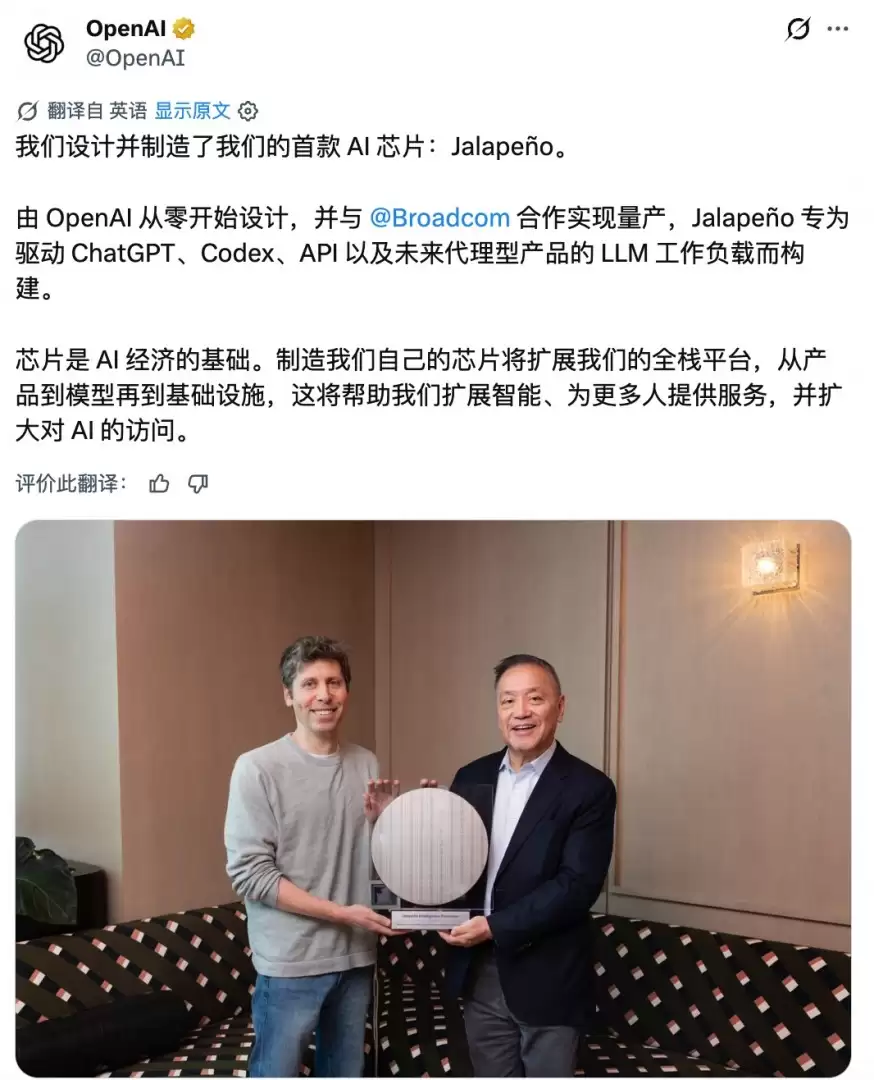
OpenAI联合博通推出首款自研AI芯片Jalapeño,专为大语言模型推理设计,开发周期仅9个月。芯片采用软硬件协同设计,并用AI优化自身架构,每瓦性能大幅领先业界。计划2026年商用,通过全栈布局降低AI使用门槛。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,