

学习如何高效使用pandas读取CSV文件并解决常见问题
快速掌握pandas读取CSV文件的方法及常见问题解答导语:随着大数据时代的到来,数据处理和分析成为各行各业的常见任务。而在Python数据分析领域,pandas库因其强大的数据处理和分析能力而成为众多数据分析师和科学家的首选工具。其中,pandas提供了丰富的方法用于读取和处理各种数据源,而读取CSV文件是其中最常见的任务之一。本文将详细介绍如何使用pan
快速掌握pandas读取CSV文件的方法及常见问题解答
导语:
随着大数据时代的到来,数据处理和分析成为各行各业的常见任务。而在Python数据分析领域,pandas库因其强大的数据处理和分析能力而成为众多数据分析师和科学家的首选工具。其中,pandas提供了丰富的方法用于读取和处理各种数据源,而读取CSV文件是其中最常见的任务之一。本文将详细介绍如何使用pandas库读取CSV文件,并解答一些常见问题。
一、pandas读取CSV文件的基本方法
Pandas提供了read_csv()函数用于读取CSV文件。其基本语法如下:
import pandas as pd
df = pd.read_csv('file_name.csv')
其中,'file_name.csv'为CSV文件的路径和名称。读取后的数据将以DataFrame的形式存储在df变量中。
二、读取CSV文件的参数说明
在读取CSV文件的过程中,可能会遇到一些特殊情况,需要通过参数来进行处理。下面是一些常用的参数说明:
- delimiter参数:指定CSV文件的分隔符,默认为逗号(,)。如果CSV文件的数据使用了其他分隔符,需要通过该参数进行指定。
df = pd.read_csv('file_name.csv', delimiter=';')- header参数:指定CSV文件中作为列名的行,默认为0,表示第一行作为列名。如果CSV文件中没有列名,则可以将该参数设置为None。
df = pd.read_csv('file_name.csv', header=None)- names参数:指定列名。当CSV文件中没有列名时,可以自行指定列名。
df = pd.read_csv('file_name.csv', names=['col1', 'col2', 'col3'])- index_col参数:指定某一列作为行索引。默认为None,表示不指定行索引。
df = pd.read_csv('file_name.csv', index_col='id')- skiprows参数:指定跳过的行数。可以通过该参数指定要跳过的行数,如跳过前两行:
df = pd.read_csv('file_name.csv', skiprows=2)三、处理常见问题
- 如何处理含有中文字符的CSV文件?
在读取含有中文字符的CSV文件之前,需要确保文件的编码方式和系统的编码方式一致。可以使用encoding参数指定CSV文件的编码方式。例如,如下代码指定了CSV文件的编码方式为utf-8:
df = pd.read_csv('file_name.csv', encoding='utf-8')- 如何处理缺失值?
在实际的数据分析中,经常会遇到缺失值的情况。Pandas提供了fillna()方法用于填充缺失值。例如,如下代码将缺失值填充为0:
df.fillna(0, inplace=True)
- 如何处理重复数据?
使用drop_duplicates()方法可以删除DataFrame中的重复数据。例如,如下代码将删除DataFrame中的重复行:
df.drop_duplicates(inplace=True)
- 如何处理数据类型不一致的情况?
当CSV文件中的数据类型不一致时,可以使用dtype参数指定每列的数据类型。例如,如下代码指定第一列的数据类型为整型,第二列的数据类型为浮点型:
df = pd.read_csv('file_name.csv', dtype={'col1': int, 'col2': float})- 如何设置读取的行数限制?
通过nrows参数可以指定读取的行数。例如,如下代码将读取CSV文件的前100行数据:
df = pd.read_csv('file_name.csv', nrows=100)四、常见问题解答
- 是否可以从URL中直接读取CSV文件?
是的,pandas提供了read_csv()方法用于从URL中直接读取CSV文件。 - 是否可以读取压缩文件中的CSV文件?
是的,可以使用read_csv()方法读取压缩文件中的CSV文件,只需要指定压缩文件的路径和名称即可。 - 是否可以将读取的CSV文件保存为Excel文件?
是的,pandas提供了to_excel()方法用于将DataFrame保存为Excel文件。 - 是否可以读取多个CSV文件并合并为一个DataFrame?
可以通过使用concat()方法将多个DataFrame合并为一个DataFrame。
总结:
本文介绍了使用pandas读取CSV文件的基本方法,并解答了一些常见问题。通过掌握这些方法和技巧,可以高效地处理和分析CSV文件中的数据,提高数据处理的效率。同时,在实际应用中,可能会遇到更复杂的情况,需要灵活运用pandas提供的丰富方法来解决问题。希望读者能够借助本文的指导,更好地应对数据分析的挑战。
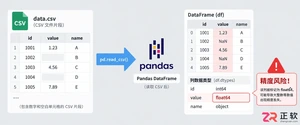
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
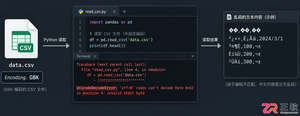
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。

详解 python pandas安装 的完整步骤,包括使用 venv 创建隔离环境、通过 pip 安装依赖及验证导入成功。提供决策图辅助排错,适用于后端开发环境搭建。

详解 python 安装pandas 的正确姿势,包括使用 venv 隔离环境、通过 python -m pip 安装依赖、验证安装结果及处理常见报错,帮助开发者构建稳定的数据处理环境。
蓝海书屋查看阅读时长的五种专业方法 “蓝海书屋的阅读时长到底在哪看?”最近这个问题确实被问得挺多。其实,掌握阅读时长不仅能帮你回顾自己的阅读旅程,更是管理阅读习惯、完成目标的好帮手。下面,咱们就系统梳理一下在蓝海书屋查看阅读时长的五种方式,操作清晰,一目了然。 官方入口在这里,有需要的可以先行访问:
在Go的encoding/csv中,字段数量错误并非直接返回,而是封装在*csv.ParseError内。需通过类型断言确认错误类型,再检查其Err字段是否为csv.ErrFieldCount,以实现精准忽略。仅应忽略该子类错误,其他解析错误如csv.ErrBareQuote需拦截处理。
针对PySpark中列顺序不一致的多个CSV文件,提出两阶段方法:先用Python轻量读取各文件首行,按列名分组;再对每组批量读取并关闭inferSchema,最后用unionByName合并。该方案在保持按列名对齐的同时,将读取次数从100次降至分组数,性能接近单次通配符读取,兼顾正确性与效率。
分块读取CSV大文件,设置chunksize=50000逐块处理,统一列名与数据类型后累积合并,立即按业务主键(如订单号)去重并保留首次出现记录,用csv.writer边处理边写入避免内存膨胀;注意编码回退策略与内存错误处理。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



