

Gensyn研究团队揭示了分布式搜索中真正的效率密码
Gensyn团队提出DEI框架,通过异质化多模型并行进化搜索,在CoreWar领域验证了模型多样性对质量多样性搜索的增益。相比同质化集成与单节点,异质化集成使QD分数提升124%、覆盖率提升28%,生态位新颖性达43%至48%。
这篇由Gensyn研究团队完成的工作,以预印本形式于2026年5月26日上传至arXiv平台,编号为arXiv:2605.27130v1,归属计算机科学·机器学习领域。原论文全文可通过该编号在arXiv上获取。
先讲一个挺直观、但又容易被忽视的判断。
想象一下,你要组建一支寻宝探险队。有两种组队方式:第一种,复制同一个自己,派出四个一模一样的“你”分头行动;第二种,找来四个背景、技能、思维方式完全不同的人,每人负责一片区域。凭直觉你也能猜到,第二种方案更可能发现那些单一视角看不见的宝藏。
这恰恰是Gensyn团队这项研究的核心直觉。他们探讨的是一个叫做“质量多样性搜索”的问题——说白了,就是如何让计算机程序同时找到“多种类型的好解”,而不是仅仅找出“那个最好的解”。他们发现,当你指派不同的大语言模型担任搜索过程中的“变异引擎”时,整体效果远远优于让同一个模型反复运行。这套框架,他们称之为DEI,即“进化推断中的多样性”(Diversity in Evolutionary Inference)。
一、进化算法与AI创作者的相遇
理解这项研究,得先认识一种叫做“进化算法”的计算思路。它模仿自然界的生物进化:先有一批“候选方案”,从中挑出表现好的,对它们进行“变异”产生新方案,再评估、再筛选,如此循环往复,方案质量就像种群演化一样不断提升。
其中,“变异”这个环节至关重要。传统的变异操作依赖人工设计的规则,比如随机修改代码的某些字符。但近年来,大语言模型(像ChatGPT这类AI)被发现是极为高效的“创意变异器”——它们不是机械地胡乱改动,而是能真正理解一段代码的意图,并且以有意义的方式去改写和扩展它。
不过,每个大语言模型都有自己独特的“思维惯性”。一个主要在Python教程上训练出来的模型,会倾向于写出某种特定风格的控制流;一个擅长竞赛编程的模型,会优先尝试另一套策略;而一个被精心微调成“听话”的指令模型,在创作时可能比原始的代码补全模型更保守。这些倾向,既是模型的特点,也意味着每个模型都有自己看不见的“盲区”。
如果在进化搜索中只用一个模型,那么这个模型的盲区就会成为最终结果中永远的空白。
二、“核战争”:他们用来测试的奇特竞技场
研究团队选择了一个名为“Core War”(核心战争)的领域作为实验平台。这是一个诞生于上世纪80年代的编程竞技游戏:两个或多个用特殊汇编语言(Redcode)写的微型程序,被放进一段循环的虚拟内存(叫MARS,即内存数组Redcode模拟器)中,它们相互厮杀,目标就是让对方程序崩溃,同时让自己生存下去。
这个游戏里的策略极其丰富。有些程序像虫群一样不停复制自己向前推进(称为“imp”);有些程序四处轰炸内存,用无效指令覆盖对方代码(称为“dwarf”);有些程序像雷达一样扫描内存,一旦发现对手就精准打击(称为“scanner”);还有一些把自己藏进坚固的“城堡”,外层套上防护(称为“fortress warrior”)。
这个竞技场的好处在于:胜负判断非常清晰,而且程序的“行为特征”完全可以量化。研究团队使用两个维度来描述每个程序的特点:一个是“时间空间积”,即程序的代码长度乘以它在战斗中的平均存活时间,反映程序在“占地面积”和“持久性”之间的取舍;另一个是“内存覆盖率”,指程序在战斗中访问了多大比例的内存空间,反映它探索地盘的积极程度。
三、质量多样性:不只要最强,还要最广
传统的优化算法只追求一件事:找到那个最好的解。但研究团队关注的是一个更丰富的目标——“质量多样性搜索”。打个比方,普通优化算法像是只想找到全国最好的一家餐厅;而质量多样性搜索,则是想绘制一张美食地图,在地图的每个角落(代表不同风格、不同价位)都找到那个区域里最好的餐厅。
具体的实现方式叫做MAP-Elites算法。它把所有可能的“行为特征”空间划分成一个网格,每个格子只保存一个解——那个格子里迄今为止表现最优的。每一轮,算法从现有的格子里取出一个解,对它进行变异,评估新解的行为特征,再把它放进对应的格子。如果那个格子原本空着,就新开一格;如果原来已有解,就比较一下谁更优秀,优胜者留下。
衡量搜索质量有两个核心指标:一个是“覆盖率”,即有多少比例的格子被填满了;另一个是“QD分数”,即所有被占用格子里的解的总适应度之和。QD分数同时奖励广度(覆盖更多格子)和深度(每个格子里的解更强)。
此外,团队还额外评估了一个“泛化能力”指标:取一组由真人玩家编写的Core War程序作为测试集,看看搜索到的最佳程序能击败或战平其中多大比例。这个指标更贴近现实应用——毕竟,一个只会打败自己同门师兄弟的程序,面对外部世界未必管用。
四、数字红皇后:对手越来越强的军备竞赛
在介绍DEI框架之前,还需要理解它所扩展的那个基础框架——“数字红皇后”(Digital Red Queen)。
“红皇后”这个名字来自《爱丽丝梦游仙境》中的意象:在红皇后的国度,你必须不停地奔跑,才能停在原地。在进化生物学中,这描述的是一种军备竞赛现象:捕食者必须持续进化得更快,因为猎物也在持续进化得更快,双方都不得不不断进步,只是为了维持相对的竞争力。
数字红皇后框架把这种军备竞赛引入了MAP-Elites搜索。具体做法是:每轮结束时,把那一轮表现最好的程序(称为“冠军”)保存下来,下一轮中将它们作为对手。随着搜索进行,对手池越来越强,搜索压力也越来越大,推动程序持续进化,跳出局部最优。
这套框架原本只在单个节点、单个模型上运行。Gensyn团队将其扩展成一个分布式的多节点版本,关键在于:每个节点使用不同的大语言模型。
五、DEI的核心机制:异质化的平行认知
DEI框架的工作方式,可以用一场多团队寻宝比赛来理解。四个探险队在同一片地图上行动,每队都有自己独特的专长和直觉。他们独立探索,但每轮结束后,每个队伍会把自己本轮发现的最好宝藏的坐标广播给其他人。其他队伍收到这个消息后,可以做两件事:一是把这个“外来宝藏”放进自己的宝藏库,填补自己还没去过的地方;二是把找到这个宝藏的对手当作下一轮需要超越的“对手标准”。
在DEI中,四个节点分别运行着GPT-5.4-mini、Claude Sonnet 4.6、GPT-5.2和Claude Haiku 4.5这四种不同的大语言模型。每个节点在本地独立运行MAP-Elites搜索:10%的时间,模型直接从头生成一个全新的程序;90%的时间,模型从当前档案库中随机取出一个现有程序,生成它的改进变体。生成的新程序被放入模拟器中与对手池战斗,计算适应度,然后根据其行为特征决定是否进入档案库的某个格子。
每轮结束时,每个节点挑出自己档案库中适应度最高的程序作为“冠军”,通过一套叫GossipSub的异步通信协议广播给其他节点。收到外来冠军的节点,会把这个程序加入自己的对手池(提升竞争压力),同时,如果这个外来冠军占据的行为特征格子在自己档案库里是空的,就直接把它放进去(填补自己的盲区)。
这里的“异步”二字至关重要。不同模型的响应速度差异悬殊——一个运行在普通笔记本上的本地开源模型,每次调用可能需要十几秒;而一个云端的前沿模型可能不到两秒就完成一次回复。如果要求所有节点同步等待最慢的那个,整个系统就会被拖慢。DEI的全异步设计让每个节点各自按自己的速度前进,不需要等任何人,也不设置任何同步屏障。这意味着,即使加入一个速度很慢的节点,它的贡献(比如发现独特行为区域的能力)依然有价值,不会拖累快的节点。
从原论文中的Figure 1可以直观地看到这一机制的效果:在早期轮次,每个节点凭借自己模型的倾向,在档案库的不同区域形成了各自独特的分布——节点1的发现集中在一片区域,节点2的集中在另一片,节点3和节点4各占一隅。随着异步冠军共享的进行,到了下一轮,四个节点的档案库开始彼此渗透,每个节点都获得了来自其他模型的“盲区填充”。
六、实验设计:控制变量,分离“多样性”与“算力”
为了确保实验结论的可靠性,研究团队做了一个关键的设计决策:保持总的LLM调用次数完全一致。
三种实验条件被对比:单节点基线(Solo DRQ)——一个节点、一个模型,每轮运行250次迭代;同质化集成(Homogeneous Ensemble)——四个节点、同一个模型,每节点每轮运行约62次迭代,总共约248次,与单节点相当;异质化集成(Diverse Ensemble)——四个节点、四种不同模型,同样每节点约62次迭代。同质化集成针对四种模型分别跑了一遍,得到四个不同的同质化基线。
这样设计的目的,是把“更多算力带来的提升”和“模型多样性带来的提升”彻底分开。如果异质化集成的表现好于同质化集成,而两者使用的总计算量相同,那么唯一的解释就是多样性本身起了作用,而不是因为用了更多算力。
MARS模拟器的配置在所有条件下保持一致:内存大小8000条指令,每场战斗最多运行80000个周期,每对程序对战20轮,初始位置随机放置。
七、实验结果:数字说话
实验结果从两个层面进行了汇报。
在个体节点层面,原论文中的Table 2展示了每种模型在三种条件下的“峰值泛化能力”和“生态位新颖性”两个指标。泛化能力就是前面说的,对外部真人程序的胜率。生态位新颖性则是衡量从其他节点收到的冠军中,有多大比例落在了自己档案库尚未开发的格子里——这是衡量跨节点交流有没有带来真正新颖信息的指标。
以Claude Sonnet 4.6为例:在单节点条件下,峰值泛化能力是0.775(约77.5%的真人程序被击败或战平);在同质化集成中,这个数字上升到0.825;在异质化集成中,进一步上升到0.850。生态位新颖性方面,同质化集成中平均有34.8%的外来冠军落入新格子,而在异质化集成中,这个比例上升到48.3%。这意味着来自不同模型的冠军,确实在填补本节点模型从未探索过的行为区域。
GPT-5.2的情况更明显:单节点泛化能力0.650,同质化集成0.700,异质化集成0.767。同质化集成中生态位新颖性仅有9.1%,而异质化集成中达到45.4%。Claude Haiku 4.5在单节点和同质化集成之间几乎没有提升(0.650对0.538,同质化集成反而更低),但在异质化集成中跃升到0.700,生态位新颖性达到44.3%,远高于同质化的13.9%。
在合并档案层面,原论文中的Table 3呈现了最终轮次将所有节点档案库合并后(保留每个格子最优解)的覆盖率和QD分数对比。单节点基线的覆盖率是63.0%,QD分数是20.46;同质化集成合并后覆盖率59.0%,QD分数29.85(覆盖率反而低于单节点,但QD分数更高,说明每个格子的解更强,但格子数更少);异质化集成合并后覆盖率80.6%,QD分数45.90——这意味着比单节点整整高出124%的QD分数,以及28%更高的覆盖率。
原论文中的Figure 2展示了各轮次中冠军泛化能力的变化趋势,对四种模型分别绘制了三条曲线。在所有四个子图中,异质化集成的曲线都在终点处处于最高位,同质化集成次之或接近,单节点通常最低。
Figure 3展示了合并档案QD分数随轮次的变化。在相同计算预算下,异质化集成和同质化集成都从第一轮起就超越了单节点,而异质化集成在最终轮次时在覆盖率上领先。同质化集成在某些中间轮次的QD分数峰值上偶尔领先,但到了最后,从Table 3的最终轮结果来看,异质化集成在覆盖率和QD分数两个维度都是最优。
八、为什么多样性真的有效:从直觉到机制
这些数字背后的道理并不复杂,但值得深入说说。
每个大语言模型的训练数据、架构和对齐方式不同,导致它们在生成代码时有不同的“偏好分布”。一个模型可能天然倾向于生成短小精悍、执行速度极快的攻击程序;另一个模型可能偏爱防御型的“城堡”结构;第三个可能擅长生成扫描型程序;第四个可能在某类特定指令组合上有独特技巧。
当只用一个模型时,即使重复调用很多次,它的偏好分布不会改变,它的盲区始终是盲区。当把四个不同的模型放在四个节点上并行探索时,每个模型的偏好分布互相补充,四者的联合覆盖范围远大于任何单一分布。
生态位新颖性指标直接证实了这一点:在同质化集成中,其他节点发来的冠军只有约9%到35%落在本节点的新格子里,因为大家用的是同一个模型,发现的东西自然高度重叠;在异质化集成中,这个比例跃升到43%到48%,说明来自不同模型的发现对彼此来说真的是新信息,真的在填补盲区。
这与强化学习和多智能体推理领域的一系列相关研究不谋而合。DARLING框架同时优化质量奖励和语义多样性信号,发现多样性能提升创意写作和数学竞赛任务的表现;DIVER框架在可验证奖励强化学习中加入序列级多样性内在奖励,提升了推理任务的通过率;多智能体辩论方法通过让多个大模型互相辩论来激发发散思维,解决单模型自我反思容易陷入思维退化的问题。DEI的实验结果与这些研究共同指向同一个方向:主动引入生成多样性,而不仅仅依赖随机采样,能带来可测量的探索增益。
九、局限与未来方向
研究团队在讨论部分相当诚实地指出了研究的边界。目前所有实验都在Core War这一个领域进行,这个领域的好处是有清晰的适应度函数和明确定义的行为特征空间。对于行为特征空间不那么结构化、或者适应度评估代价更高昂的领域,这些发现是否同样成立,还需要进一步验证。团队明确表示,虽然没有理论原因认为这些发现不会推广,但目前的实证结果严格说只限于Core War域内。
此外,从Figure 3可以看出,QD分数曲线在不同条件下都有较大波动,说明结果存在一定的随机性。研究中可用的实验重复次数有限(异质化集成只有n=3次运行,同质化集成n=4次,单节点n=7次),更多的重复实验会进一步增强统计置信度。
团队还提出了几个有意思的后续探索方向:一是“自适应拓扑”——动态连接那些档案库最互补的节点对,让信息流动更有针对性;二是“差异化行为特征轴”——让每个节点跟踪不同维度的行为特征,从而覆盖更高维度的行为空间;三是把这套框架扩展到Core War以外的多智能体协作任务。
十、技术实现:让不同速度的节点和谐共存
对于对技术细节感兴趣的读者,DEI的网络层实现也很值得介绍。
节点间的通信建立在一种叫做Yggdrasil的覆盖网络上,这套网络为每个节点分配一个基于公钥的稳定IPv6地址,并通过分布式生成树路由方案实现NAT穿透——这意味着即使节点在家用路由器或防火墙后面,也不需要手动配置端口转发就能参与协作。这对于分布式协作的普及性来说,是一个相当重要的设计。
连接Yggdrasil网络层和DRQ应用层的,是一个由Gensyn AI开发的开源工具叫做AXL。AXL是一个用Go语言编写的程序,嵌入了Yggdrasil核心,并对外暴露一个本地HTTP接口。应用程序只需与这个本地接口通信,无需直接管理网络套接字。AXL有四层架构:接受应用请求的HTTP API层,将到来的TCP消息分发给对应处理器的入站消息复用层,不需要root权限的用户空间TCP/IP协议栈(基于gVisor),以及管理节点密钥和路由的Yggdrasil核心层。
DEI只使用AXL提供的三个接口:发送消息(POST /send)、接收消息(GET /recv)、以及查询本节点身份和当前对等节点列表(GET /topology)。
实际的消息传播协议采用了GossipSub——这是一种在区块链网络(如以太坊2.0和Filecoin)中广泛使用的、具有攻击弹性的消息传播协议。GossipSub维护每个主题下D个对等节点的“网格”,并向网格成员主动推送完整消息载荷。DEI实验中使用D=3,这意味着消息在N个节点中传播的跳数是O(log N)量级——对于四个节点来说,几乎一跳就能到达所有人。网格之外,节点通过IHA VE控制消息懒惰地宣告自己拥有某条消息,对方如果没有,可以用IWANT请求。每秒一次的心跳触发网格修复操作,确保节点加入或离开时系统能自我调整。
归根结底,这项研究回答的问题听起来很技术,但启示却相当朴素。当你用多个拥有不同“思维习惯”的AI协同工作时,它们能覆盖彼此的盲区,找到任何单一AI都无法独立发现的解决方案——而且这种收益并不需要更多的计算资源,只需要让“多样性”真正发生。在Gensyn的实验中,四个协作的异质AI以与一个单独AI完全相同的调用次数,找到了覆盖率多出28%、综合质量得分多出124%的程序集合。这不是算力的胜利,是认知多样性的胜利。
至于这种思路能否迁移到更广泛的领域——代码生成、数学证明、药物设计,乃至更复杂的开放性问题——目前还是一个开放的问题。但Core War这个古老的编程竞技场,意外地成了一块清晰的试金石。
Q&A
Q1:DEI框架和普通的多个AI并行搜索有什么区别?
A:普通的并行搜索只是把同一个AI模型复制成多份同时跑,多样性只来自随机采样的运气。DEI框架则是故意选用不同家族的大模型(比如GPT系列和Claude系列同时参与),让每个模型的不同“思维习惯”覆盖彼此的盲区。实验证明,在相同的总调用次数下,用不同模型的效果比用同一模型跑多份要好得多,覆盖率高出约28%,综合质量分数高出约124%。
Q2:Core War是什么,为什么要用它来做实验?
A:Core War是一个1980年代发明的编程竞技游戏,玩家用一种叫Redcode的汇编语言写小程序,放进虚拟内存里互相厮杀,目标是让对方程序崩溃。研究团队选它是因为它的规则清晰、胜负判定明确,程序的行为特征可以被量化成两个数字,非常适合用来测试质量多样性搜索的效果。
Q3:DEI框架里节点之间怎么交换信息,速度慢的节点会不会拖累快节点?
A:节点之间通过一种叫GossipSub的协议异步传递每轮的“冠军程序”,不需要等待任何人,各自以自己的速度前进。速度慢的节点(比如本地运行的开源模型)不会拖累快节点,反而因为它有独特的发现视角,依然能为整个系统贡献来自不同分布的新信息。
这篇文章我们继续聊分布式相关的内容。提到分布式系统,就一定绕不开“一致性”,这次我们说说:最终一致性。最终一致性是现在大部分高可用的分布式系统的核心思路。估计有人对最终一致性不太熟,先来个简单介绍:最终一致性指的是系统中的所有分散在不同节点的数据,经过一定时间后,最终能够达到符合业务定义的一致的状态
云计算时代,云原生分布式数据库和数据仓库开始崛起,提供弹性扩展、高可用、分布式等特性。数据库将面临怎样的变革?云原生数据库与数据仓库有哪些独特优势?在日前的DTCC 2020大会上,阿里巴巴集团副总裁、阿里云数据库产品事业部总裁、ACM杰出科学家李飞飞就《云原生分布式数据库与数据仓库系统点亮数据上云
FastCFS 是一款基于块存储的通用分布式文件系统,可以作为MySQL、PostgresSQL、Oracle等数据库和云平台的后端存储。 FastDFS已经很受欢迎了,为何还要研发FastCFS呢?FastDFS是轻量级的对象存储,只能通过专有API访问,专为互联网应用设计,适合存放图片、视频、文
随着微服务架构的流行,客户端发起的一次请求可能需要涉及到多个或 N 个服务,致使我们对服务之间的监控和排查变得更加复杂。举个例子:某条业务线的某个接口调用服务端时快时慢,这时就需要排查各个服务的日志进行分析,调动各个服务的开发人员联动排查,这种排查费时又费力。对于 ToB 的业务有时候还拿不到日志,
SpringCloud ConfigSpringCloud整合了微服务中的整体解决方案:分布式配置中心,分布式锁,分布式任务调度平台,分布式事务,分布式日志收集产生背景:在微服务场景下,若继续采用传统方式管理配置文件,配置文件管理器将变得极为复杂。而且在生产环境中,一旦配置文件发生改变,就需要重新配

1 前言 在现在工作中,为保障服务的高可用,应对单点故障、负载量过大等单机部署带来的问题,生产环境常用多机部署。为解决多机房部署导致的数据不一致问题,我们常会选择用分布式锁。目前其他比较常见的实现方案我列举在下面:基于缓存实现分布式锁(本文主要使用redis实现)基于数据库实现分布式锁基于zooke
简介 Hadoop作为被广泛运用的大数据框架,依靠Hadoop分布式文件系统(HDFS)来存储和管理海量数据。但有时会出现HDFS权限问题,影响数据的访问和处理。本教程将带你了解识别和解决HDFS权限问题的流程,助你维护一个强健且安全的Hadoop生态系统。 HDFS 权限概述 HDFS(Hadoo
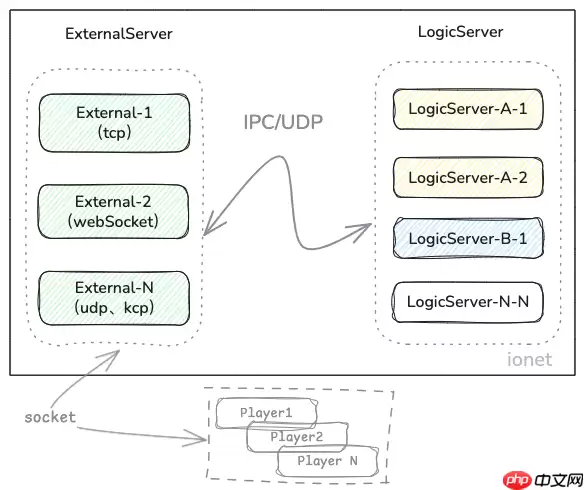
ionet25.3版本发布,基于Aeron构建,实现纳秒级延迟与真零拷贝,无需第三方中间件即可搭建分布式服务器。框架轻量级,15MB启动,支持游戏、物联网、高频交易等场景。采用对外服与逻辑服架构,动态扩缩,类MVC编码,自动生成多前端交互代码。
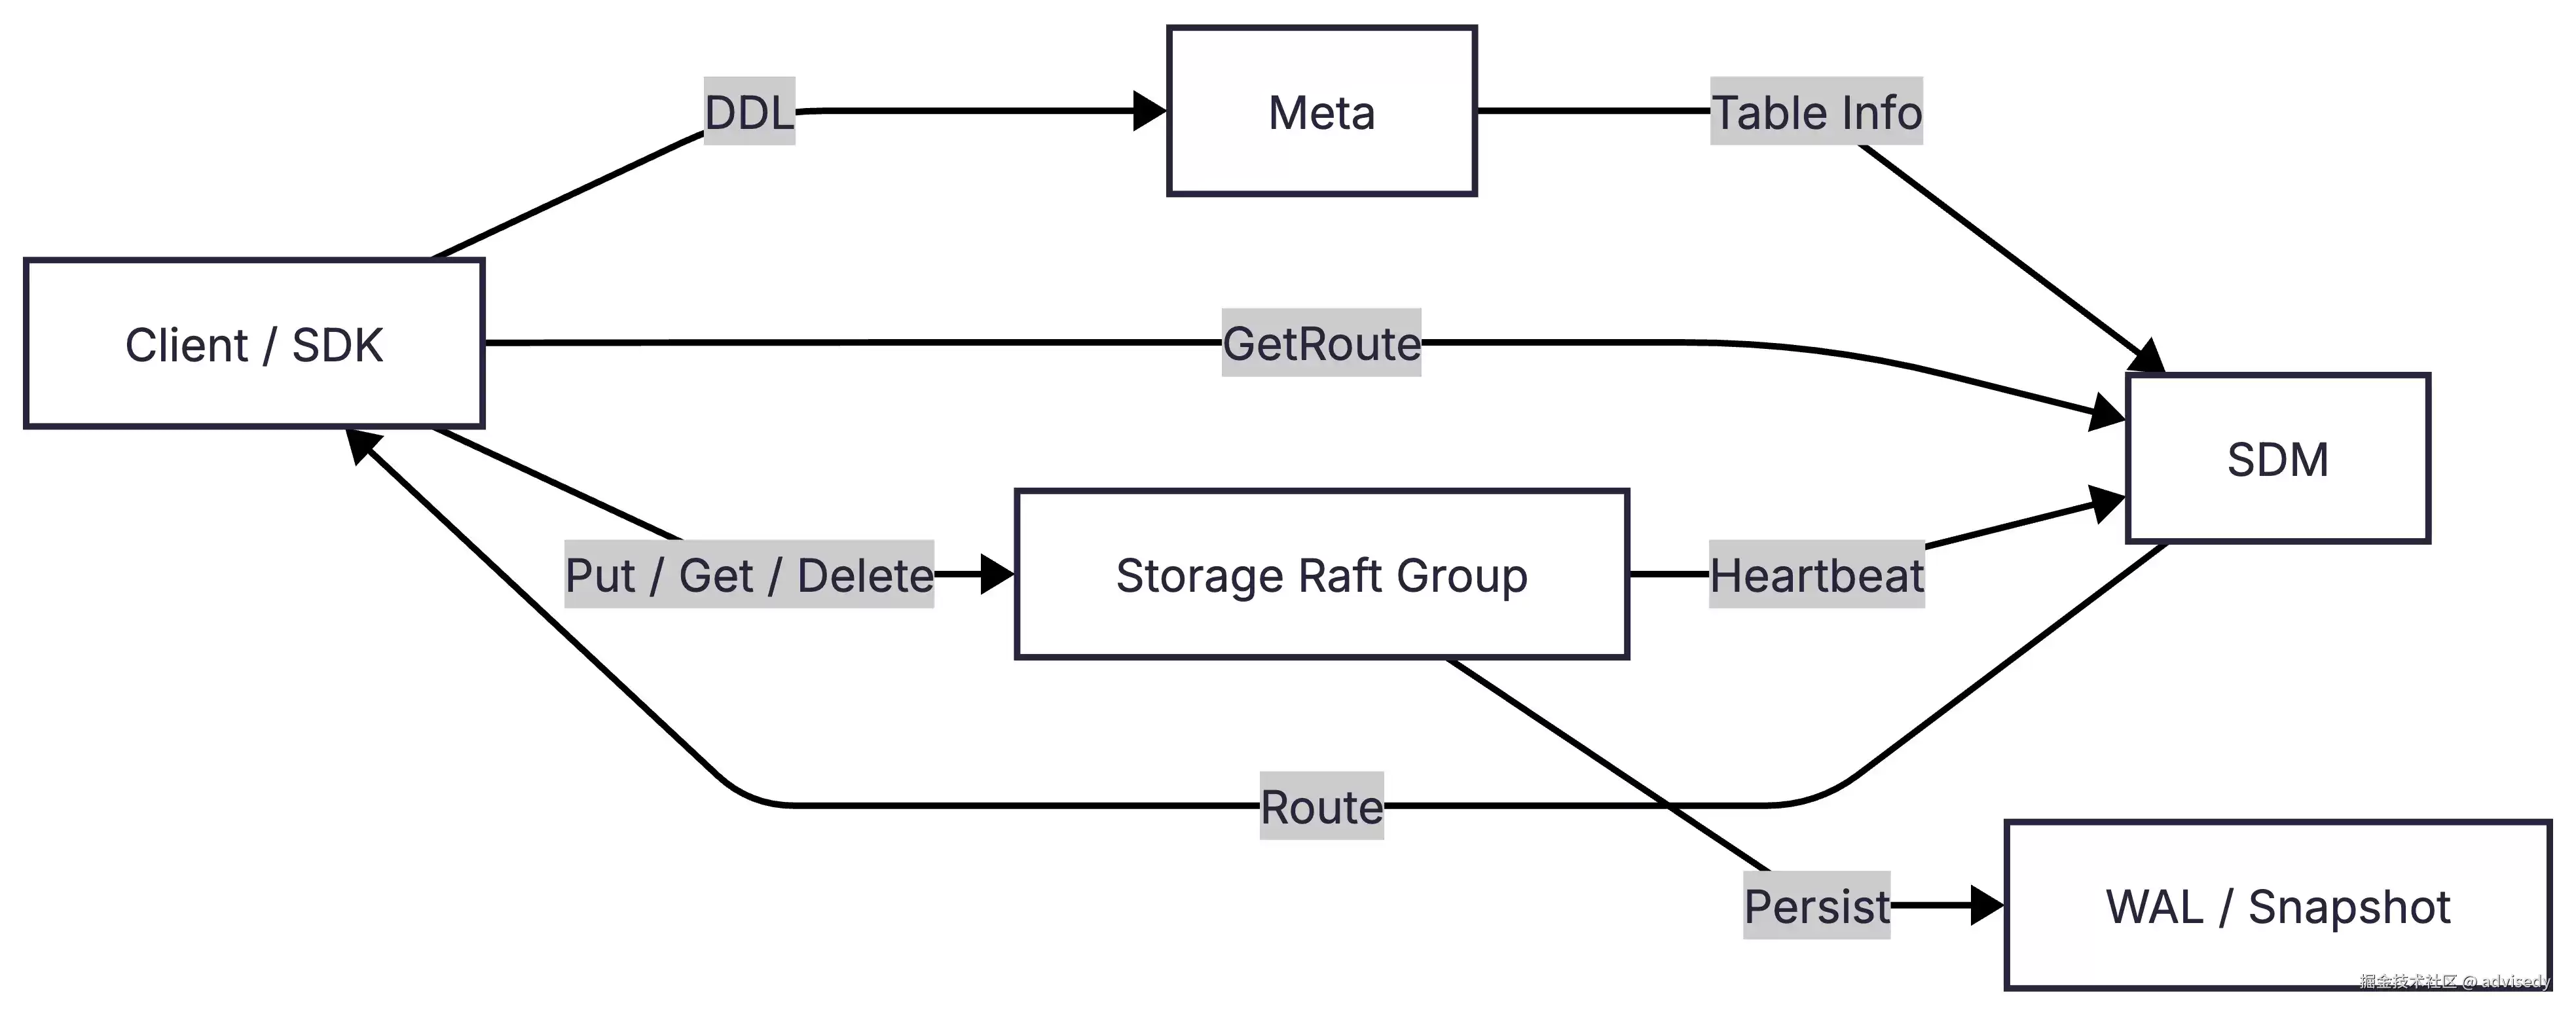
日期: 2026.7.6 写在开头的开头 AdvisKV 是我用 C++17 从零写的一个分布式 KV 存储系统原型,包含 Meta、SDM、Storage、SDK 四个主要模块,覆盖建库建表、路由查询、KV 读写、副本数扩缩容、坏副本替换、Raft、WAL/snapshot 恢复,跑了gtest
Redis配合Lua脚本通过原子性执行实现分布式限流的强一致性,Java仅负责安全调用,不可参与状态判断。生产环境推荐EVALSHA并提前预热脚本。令牌桶限流时,客户端传入时间戳等参数。Java层需正确配置序列化、返回值类型和连接池,否则易破坏一致性。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



