

Python基础指南之列表增加元素四大方式详解
Python列表增加元素有四种方式:append()在末尾添加单个元素(O(1)),insert()在指定位置插入(O(n)),extend()批量追加可迭代对象,切片赋值可在任意位置插入任意数量元素。不同方法适用场景和性能差异显著,需根据需求选择。
一、开篇:加元素而已,能有几种花样?
前面三篇文章我们学完了列表的创建、索引和切片——这些都是围绕“已有元素的访问”展开的。但从这一篇开始,我们要进入修改列表的领域。首当其冲的就是增加元素。
Python列表增加元素有四种方式:append()、insert()、extend(),以及用切片赋值。它们看起来都能“加东西”,但适用场景和性能表现差异很大。选错方式不仅代码难看,甚至可能产生性能问题。
很多教程把这四种方式草草带过,但这确实值得单独用一篇文章来深入讲解——因为你不只是在记住API,而是在建立对Python列表底层行为的直觉。
二、append()——最常用的加元素方式
2.1 基本用法
append() 将一个元素追加到列表的末尾。这是最常用的增加元素方式,没有之一。
fruits = ['苹果', '香蕉']
fruits.append('橘子')
print(fruits)  # ['苹果', '香蕉', '橘子']

# append始终将元素加到最后
fruits.append('葡萄')
print(fruits)  # ['苹果', '香蕉', '橘子', '葡萄']

# append可以添加任何类型的对象
fruits.append(42)
fruits.append([1, 2, 3])    # 注意:整个列表作为一个元素
fruits.append({'key': 'value'})
print(fruits)
# ['苹果', '香蕉', '橘子', '葡萄', 42, [1, 2, 3], {'key': 'value'}]
2.2 append() 的关键理解:只添加一个元素
# 这是很多新手会犯的错误——以为append可以一次加多个元素
nums = [1, 2, 3]

# append([4, 5]) 不是加两个元素,是加一个列表元素
nums.append([4, 5])
print(nums)  # [1, 2, 3, [4, 5]](4个元素,最后一个本身是列表)
print(len(nums))  # 4

# 相比之下,extend([4, 5]) 才是加两个元素
nums2 = [1, 2, 3]
nums2.extend([4, 5])
print(nums2)  # [1, 2, 3, 4, 5](5个元素)
print(len(nums2))  # 5

# 如果把字符串当作参数
chars = []
chars.append('hello')
print(chars)  # ['hello'](一个字符串元素)

chars2 = []
chars2.extend('hello')
print(chars2)  # ['h', 'e', 'l', 'l', 'o'](5个字符元素)
核心记忆:append(x) 等价于 lst[len(lst):] = [x]——总是在末尾添加一个元素。
2.3 append() 的返回值
# ⚠️ 重要:append() 没有返回值(返回None)!
nums = [1, 2, 3]
result = nums.append(4)
print(result)  # None
print(nums)    # [1, 2, 3, 4]

# 这是一个非常常见的错误:
# 误以为 append 返回修改后的列表
# nums = nums.append(5)  # nums 变成了 None!

# 另一个常见错误:在链式调用中使用append
# [1, 2, 3].append(4).append(5)  # AttributeError: 'NoneType' object has no attribute 'append'

# 如果需要链式调用,可以自己写个包装器
def append_and_return(lst, item):
    lst.append(item)
    return lst

result = append_and_return(append_and_return([1, 2], 3), 4)
print(result)  # [1, 2, 3, 4]

# 但更推荐的方式是直接用 + 或列表推导式
result = [1, 2] + [3] + [4]
print(result)  # [1, 2, 3, 4]
2.4 append() 的性能
import time

# append() 的平均时间复杂度是 O(1)
# Python列表采用"过度分配"策略,不是每次append都重新分配内存

n = 1000000
lst = []

start = time.perf_counter()
for i in range(n):
    lst.append(i)
elapsed = time.perf_counter() - start
print(f'append {n} 次耗时: {elapsed:.3f}秒')
print(f'平均每次: {elapsed / n * 1e9:.1f} 纳秒')

# Python确实会在列表容量不足时分配更多空间
# 但这是偶尔发生的,摊销后每次append就是O(1)
三、insert()——在指定位置插入
3.1 基本用法
fruits = ['苹果', '香蕉', '橘子']

# 在索引1处插入元素
fruits.insert(1, '葡萄')
print(fruits)  # ['苹果', '葡萄', '香蕉', '橘子']

# 在开头插入
fruits.insert(0, '西瓜')
print(fruits)  # ['西瓜', '苹果', '葡萄', '香蕉', '橘子']

# 在末尾插入(等价于append)
fruits.insert(len(fruits), '芒果')
print(fruits)  # ['西瓜', '苹果', '葡萄', '香蕉', '橘子', '芒果']

# 用负数索引——在倒数第2个位置前插入
fruits.insert(-1, '柠檬')
print(fruits)  # ['西瓜', '苹果', '葡萄', '香蕉', '橘子', '柠檬', '芒果']
# -1表示在最后一个元素之前插入
# 即"柠檬"被插在倒数第二个位置
3.2 insert() 的索引规则
lst = [10, 20, 30, 40, 50]

# insert(i, x) 的语义:将 x 插入到当前索引 i 的元素之前
# 插入后,x 的索引变为 i,原来的 lst[i:] 都向后移动一位

lst.insert(2, 99)
print(lst)  # [10, 20, 99, 30, 40, 50](99在索引2)

# 索引超出长度——插入到末尾
lst.insert(100, 999)
print(lst)  # [10, 20, 99, 30, 40, 50, 999](插入到末尾)

# 负索引超出范围(小于 -len)——插入到开头
lst.insert(-100, -999)
print(lst)  # [-999, 10, 20, 99, 30, 40, 50, 999](插入到开头)

# 也就是:
# insert(i, x) 当 i > len(lst) → 插到末尾
# insert(i, x) 当 i < -len(lst) → 插到开头
3.3 insert() 的性能
import time

# insert() 的时间复杂度是 O(n)!
# 因为插入位置后面的所有元素都需要向后移动

# 在列表头部插入(最坏情况,需要移动所有元素)
n = 100000
lst = []
start = time.perf_counter()
for i in range(n):
    lst.insert(0, i)  # 每次都在头部插入
t1 = time.perf_counter() - start
print(f'头部插入 {n} 次: {t1:.3f}秒')

# 在列表尾部插入(用append,O(1))
lst = []
start = time.perf_counter()
for i in range(n):
    lst.append(i)
t2 = time.perf_counter() - start
print(f'尾部追加 {n} 次: {t2:.3f}秒')

# 头部插入慢得多!可能相差几百倍到上千倍
print(f'性能差距: {t1 / t2:.0f}倍')
如果需要在列表头部频繁插入元素,那么可以考虑使用 collections.deque(双端队列),它的 appendleft() 是 O(1) 的:
from collections import deque

dq = deque()
dq.appendleft('a')
dq.appendleft('b')
dq.appendleft('c')
print(list(dq))  # ['c', 'b', 'a']
# deque的appendleft和popleft都是O(1)
四、extend()——批量追加
4.1 基本用法
# extend() 将可迭代对象中的每个元素逐个追加到列表末尾
nums = [1, 2, 3]

# 追加另一个列表的所有元素
nums.extend([4, 5, 6])
print(nums)  # [1, 2, 3, 4, 5, 6]

# 追加元组
nums.extend((7, 8))
print(nums)  # [1, 2, 3, 4, 5, 6, 7, 8]

# 追加字符串(每个字符作为一个元素)
nums.extend('abc')
print(nums)  # [1, 2, 3, 4, 5, 6, 7, 8, 'a', 'b', 'c']

# 追加range对象
nums.extend(range(10, 13))
print(nums)  # [1, 2, 3, 4, 5, 6, 7, 8, 'a', 'b', 'c', 10, 11, 12]

# 追加集合
nums.extend({100, 200})
print(nums)  # 集合是无序的,追加顺序不确定

# 追加字典(默认迭代键)
nums.extend({'x': 1, 'y': 2})
print(nums)  # ..., 'x', 'y']

# extend接受任何可迭代对象
def generate_numbers():
    for i in range(3):
        yield i * 10

lst = [1, 2]
lst.extend(generate_numbers())
print(lst)  # [1, 2, 0, 10, 20]
4.2 extend() vs 其他方式
# extend() 和 append() 的区别
lst1 = [1, 2, 3]
lst1.append([4, 5])
print(lst1)  # [1, 2, 3, [4, 5]](4个元素)

lst2 = [1, 2, 3]
lst2.extend([4, 5])
print(lst2)  # [1, 2, 3, 4, 5](5个元素)

# extend() 和 + 运算符的区别
lst3 = [1, 2, 3]
lst4 = lst3 + [4, 5]  # 创建新列表
print(lst3)  # [1, 2, 3](原列表不变)
print(lst4)  # [1, 2, 3, 4, 5](新列表)

lst3.extend([4, 5])  # 原地修改
print(lst3)  # [1, 2, 3, 4, 5](原列表改变)

# extend() 和 += 的区别
lst5 = [1, 2, 3]
lst5 += [4, 5]  # 原地修改(和extend效果相同)
print(lst5)  # [1, 2, 3, 4, 5]

# 但有一个微小区别:
# lst += iterable 调用了 __iadd__,实际上等价于 extend
# lst = lst + iterable 调用了 __add__,创建新列表

# extend() 和切片赋值的区别
lst6 = [1, 2, 3]
lst6[len(lst6):] = [4, 5, 6]  # 等价于extend
print(lst6)  # [1, 2, 3, 4, 5, 6]
4.3 extend() 的性能
import time

n = 100000

# 方式一:用 extend
lst = []
start = time.perf_counter()
lst.extend(range(n))
t1 = time.perf_counter() - start

# 方式二:用循环 + append
lst = []
start = time.perf_counter()
for i in range(n):
    lst.append(i)
t2 = time.perf_counter() - start

# 方式三:用列表推导式
start = time.perf_counter()
lst = [i for i in range(n)]
t3 = time.perf_counter() - start

print(f'extend():     {t1:.4f}秒')
print(f'循环append:   {t2:.4f}秒')
print(f'列表推导式:    {t3:.4f}秒')

# extend()通常比循环append快,因为它在C层面完成循环
# 但列表推导式往往最快
选择建议:如果要追加一个已知的可迭代对象,用 extend();如果只有单个元素,用 append();如果需要从零创建一个列表,用列表推导式。
五、切片赋值——最灵活的增加方式
5.1 在任意位置插入任意数量的元素
nums = [1, 5, 9]

# 在索引1处插入多个元素(插入到索引1的元素之前)
nums[1:1] = [2, 3, 4]
print(nums)  # [1, 2, 3, 4, 5, 9]

# 在开头插入
nums[:0] = [-2, -1, 0]
print(nums)  # [-2, -1, 0, 1, 2, 3, 4, 5, 9]

# 在末尾追加
nums[len(nums):] = [10, 11, 12]
print(nums)  # [-2, -1, 0, 1, 2, 3, 4, 5, 9, 10, 11, 12]

# 在一个位置同时完成"替换+插入"
original = [1, 2, 8, 9]
original[2:2] = [3, 4, 5, 6, 7]
print(original)  # [1, 2, 3, 4, 5, 6, 7, 8, 9]
5.2 切片插入的灵活之处
# 可以用任何可迭代对象(和extend一样)
lst = [1, 6]
lst[1:1] = (2, 3, 4, 5)  # 元组
print(lst)  # [1, 2, 3, 4, 5, 6]

lst[1:1] = '中间'  # 字符串
print(lst)  # [1, '中', '间', 2, 3, 4, 5, 6]

lst[1:1] = range(10, 13)  # range
print(lst)  # [1, 10, 11, 12, '中', '间', 2, 3, 4, 5, 6]

# 可以用生成器
lst[1:1] = (x ** 2 for x in range(3))
print(lst)  # [1, 0, 1, 4, 10, 11, 12, '中', '间', 2, 3, 4, 5, 6]

# 插入空序列等于什么都没做
lst2 = [1, 2, 3]
lst2[1:1] = []
print(lst2)  # [1, 2, 3](没有变化)
六、四种方式的对比总结
6.1 功能对比
# 用同一个例子演示四种方式
goal = [1, 2, 3, 4, 5]

# 方式一:append —— 只加一个元素到末尾
result1 = [1, 2, 3]
result1.append(4)
result1.append(5)
print(f'append:  {result1}')

# 方式二:insert —— 在指定位置插入一个元素
result2 = [1, 3, 4, 5]
result2.insert(1, 2)  # 在索引1插入2
print(f'insert:  {result2}')

# 方式三:extend —— 批量追加到末尾
result3 = [1, 2]
result3.extend([3, 4, 5])
print(f'extend:  {result3}')

# 方式四:切片赋值 —— 在任意位置插入任意数量元素
result4 = [1, 5]
result4[1:1] = [2, 3, 4]
print(f'切片:    {result4}')
6.2 全面的对比表
# 对比表格
summary = '''
| 方法         | 添加位置     | 添加数量    | 时间复杂度 | 返回值  |
|-------------|-------------|------------|-----------|--------|
| append(x)   | 末尾         | 1个(x本身) | O(1)     | None   |
| insert(i,x) | 指定索引i之前 | 1个(x本身) | O(n)     | None   |
| extend(it)  | 末尾         | N个(展开)  | O(k)     | None   |
| lst[a:a]=it | 指定位置     | 任意       | O(n)     | None   |
'''

print(summary)
6.3 性能对比
import time

n = 100000

# 场景一:在尾部追加(append vs extend)
lst = []
start = time.perf_counter()
for i in range(n):
    lst.append(i)
t_append = time.perf_counter() - start

lst = []
start = time.perf_counter()
lst.extend(range(n))
t_extend = time.perf_counter() - start

print(f'尾部追加 {n} 次:')
print(f'  append循环: {t_append:.3f}秒')
print(f'  extend一次性: {t_extend:.3f}秒')
print(f'  extend比循环快 {t_append / t_extend:.1f} 倍')
print()

# 场景二:在头部插入 vs 使用deque
from collections import deque

lst = []
start = time.perf_counter()
for i in range(10000):
    lst.insert(0, i)
t_insert = time.perf_counter() - start

dq = deque()
start = time.perf_counter()
for i in range(10000):
    dq.appendleft(i)
t_deque = time.perf_counter() - start

print(f'头部插入 10000 次:')
print(f'  list.insert(0): {t_insert:.3f}秒')
print(f'  deque.appendleft: {t_deque:.3f}秒')
print(f'  deque快 {t_insert / t_deque:.0f} 倍')
七、实战案例
7.1 用四种方式构建同一个列表
# 需求:创建 [0, 1, 4, 9, 16, 25](0-5的平方)

# append 方式
squares1 = []
for i in range(6):
    squares1.append(i ** 2)
print(squares1)  # [0, 1, 4, 9, 16, 25]

# extend 方式
squares2 = []
squares2.extend(i ** 2 for i in range(6))
print(squares2)  # [0, 1, 4, 9, 16, 25]

# insert 方式(效率低,不推荐)
squares3 = []
for i in range(6):
    squares3.insert(len(squares3), i ** 2)  # 用insert模拟append,多此一举
print(squares3)  # [0, 1, 4, 9, 16, 25]

# 切片赋值
squares4 = list(range(6))
squares4[:] = [i ** 2 for i in range(6)]
print(squares4)  # [0, 1, 4, 9, 16, 25]

# 最佳实践:列表推导式
squares5 = [i ** 2 for i in range(6)]
print(squares5)  # [0, 1, 4, 9, 16, 25]
7.2 累积收集——Builder模式
class ListBuilder:
    """用append模式逐步构建列表——类似StringBuilder"""
    def __init__(self):
        self._items = []

    def add(self, item):
        self._items.append(item)
        return self  # 返回self支持链式调用

    def add_all(self, items):
        self._items.extend(items)
        return self

    def build(self):
        return self._items[:]  # 返回副本


# 使用Builder模式构建复杂列表
result = (ListBuilder()
    .add('表头')
    .add_all(range(1, 5))
    .add('表尾')
    .build()
)
print(result)  # ['表头', 1, 2, 3, 4, '表尾']


# 另一种模式:收集器函数
def collect(initial, *adders):
    """接受多个添加器,逐个执行"""
    result = list(initial)
    for adder in adders:
        if isinstance(adder, list):
            result.extend(adder)
        elif callable(adder):
            result.extend(adder())
        else:
            result.append(adder)
    return result

def even_numbers():
    return [2, 4, 6, 8, 10]

result = collect([1], [3, 5], even_numbers, 12)
print(result)  # [1, 3, 5, 2, 4, 6, 8, 10, 12]
7.3 数据库查询结果累积
def query_users(db_connection, conditions):
    """模拟数据库查询——用extend累积分页结果"""
    all_results = []

    page = 1
    page_size = 100
    while True:
        # 模拟分页查询
        # results = db_connection.execute(
        #     'SELECT * FROM users WHERE ... LIMIT ? OFFSET ?',
        #     (page_size, (page - 1) * page_size)
        # ).fetchall()

        # 模拟数据
        start = (page - 1) * page_size + 1
        end = start + page_size
        results = [f'用户{i}' for i in range(start, min(end, start + 1000))]

        if not results:
            break

        all_results.extend(results)  # 追加当前页的结果
        page += 1

        if page > 3:  # 模拟限制
            break

    return all_results

users = query_users(None, {})
print(f'共查询到 {len(users)} 个用户')
八、常见错误与最佳实践
# 错误一:append和extend混淆
lst = [1, 2, 3]
lst.append([4, 5])  # 加了整个列表
print(lst)  # [1, 2, 3, [4, 5]](可能不是你想要的结果!)

# 错误二:insert在循环中构建列表
# 不推荐:O(n^2)的构建方式
result = []
for i in range(1000):
    result.insert(0, i)  # 每次insert都是O(n)

# 推荐:先append,最后反转
result = []
for i in range(1000):
    result.append(i)
result.reverse()  # O(n)

# 错误三:忘记append返回None
# nums = [1, 2].append(3)  # nums变成None!
# 正确做法:
nums = [1, 2]
nums.append(3)

# 错误四:试图修改不可变序列后用append
# tu = (1, 2, 3)
# tu.append(4)  # AttributeError: 'tuple' object has no attribute 'append'

# 错误五:在多线程中不加锁使用append
# 虽然append本身是线程安全的(GIL保护),但复合操作可能有问题
import threading
shared_list = []
lock = threading.Lock()

def safe_add(item):
    with lock:
        shared_list.append(item)

# 最佳实践总结:
# 1. 添加单个元素到末尾 → append()
# 2. 添加多个元素到末尾 → extend() 或 +=
# 3. 在指定位置插入一个元素 → insert()
# 4. 在指定位置插入多个元素 → 切片赋值
# 5. 频繁头部插入 → 用collections.deque
# 6. 从零构建列表 → 列表推导式
九、本篇小结
列表增加元素的四种方式各有各的最佳使用场景:
- append(x):添加单个元素到末尾——最常用,O(1)
- insert(i, x):在指定位置插入一个元素——灵活但慢,O(n)
- extend(iterable):批量追加可迭代对象的所有元素——高效,O(k)
- 切片赋值
lst[a:a] = iterable:在任意位置插入任意数量——最灵活
选型指南:
- 末尾加一个 →
append() - 末尾加一堆 →
extend() - 中间插一个 →
insert() - 中间插一堆 → 切片赋值
- 频繁头部插入 → 换用
collections.deque
这四种方式全部返回None(原地修改列表),这个设计让Python列表的API保持了一致性。下一篇我们将学习列表删除元素的六种方式——删除比增加更复杂,坑也更多。
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
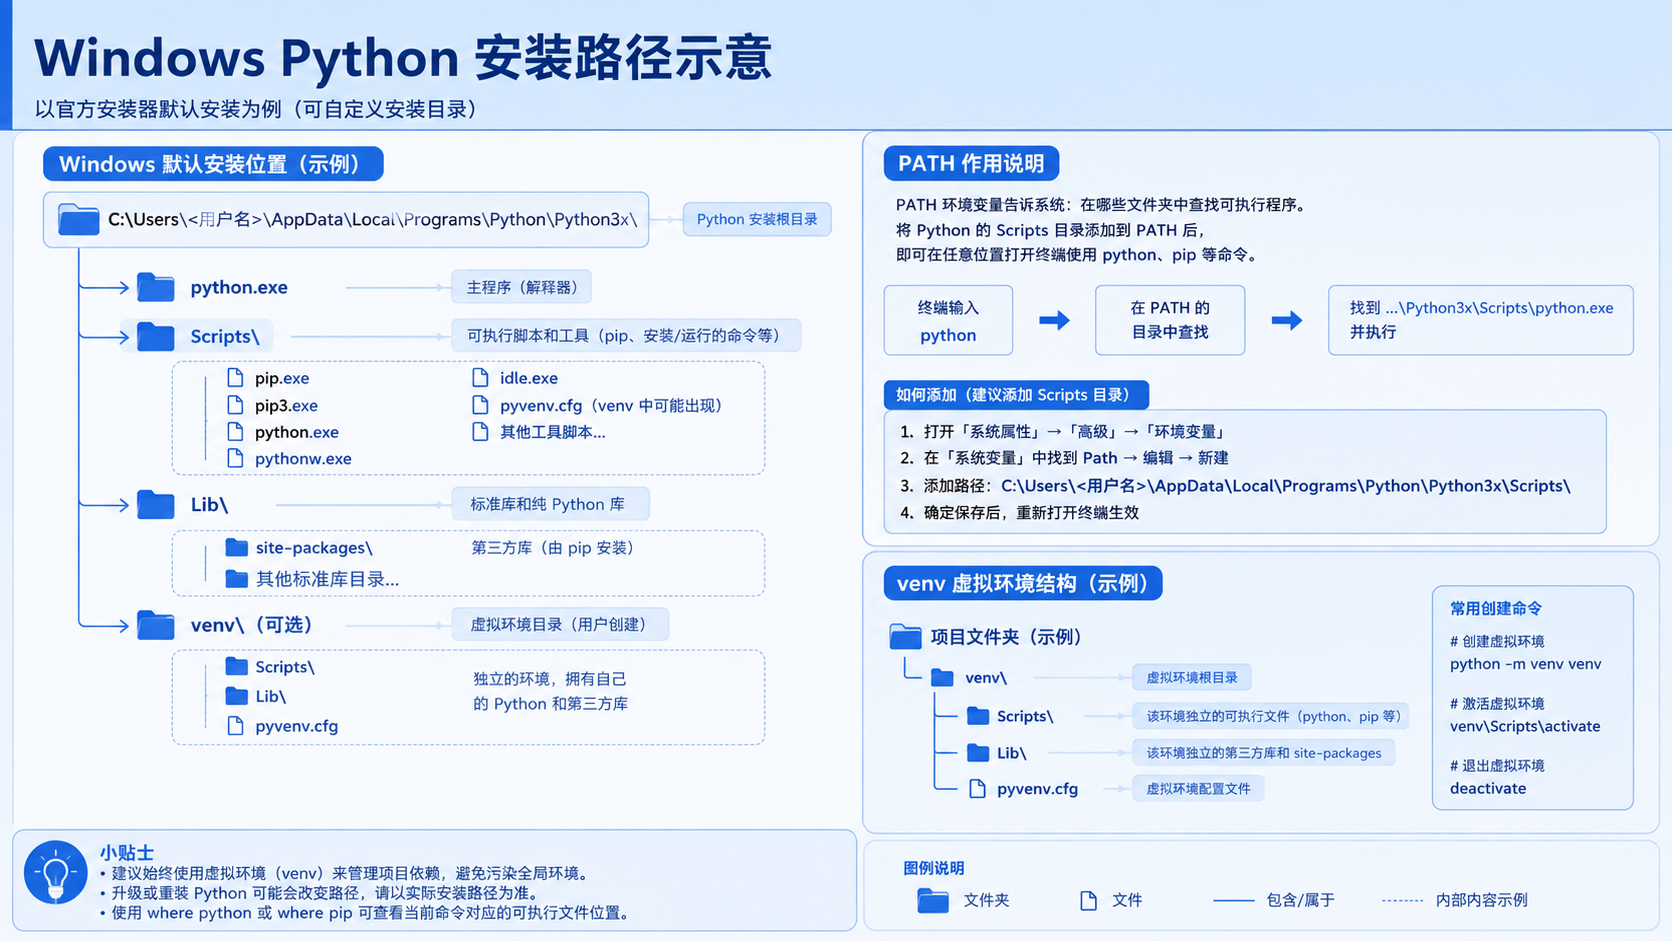
面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。
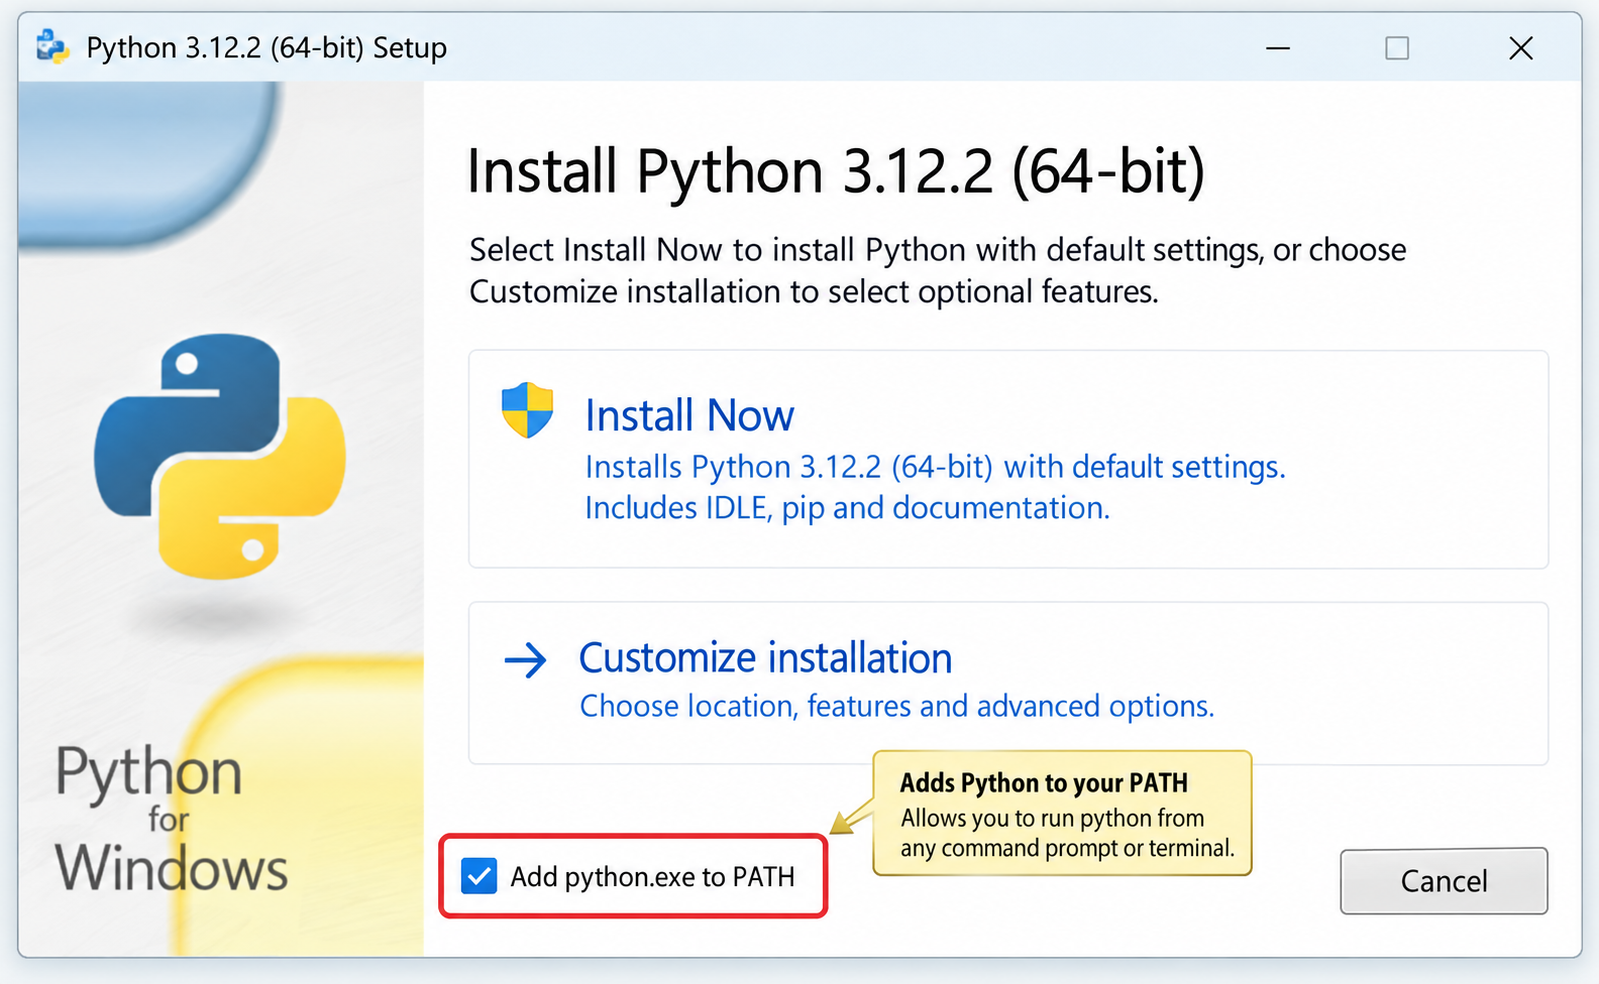
针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。
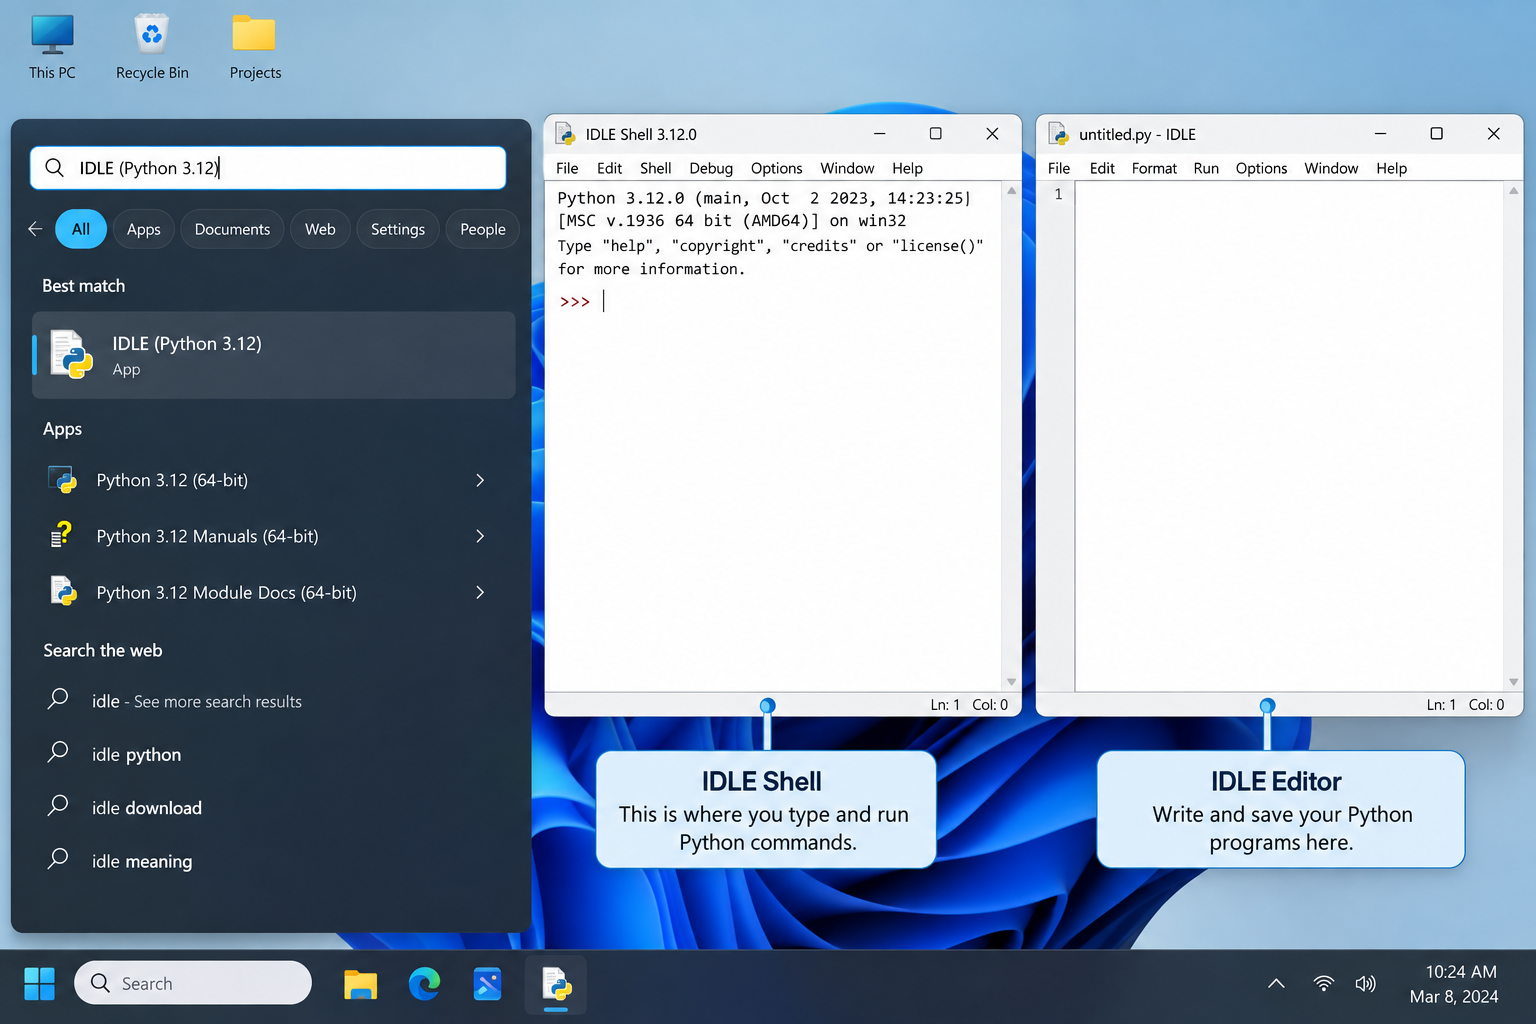
刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

了解Python编程领域中最好的就业行业导语:近年来,Python作为一种易学易用的编程语言,越来越受到企业和开发者的青睐。在Python编程领域中,有许多就业机会,涵盖了各个行业。本文将介绍一些Python编程领域中最好的就业行业,并提供相应的代码示例。数据科学和机器学习数据科学和机器学习是Python编程领域中最热门的行业之一。Python在数据科学和机
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
本文介绍如何使用Python的sorted函数对字典按值进行升序和降序排序,结合具体代码示例和应用场景,帮助读者理解排序逻辑及其在数据处理中的实际价值。
深入讲解Python中使用re.sub进行正则匹配与替换的技巧,涵盖基础语法、分组引用及回调函数应用,帮助开发者解决复杂字符串修改需求,提升代码效率与可维护性。
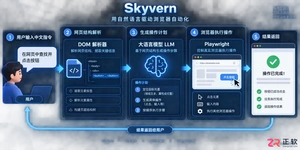
Skyvern是一款基于大语言模型的开源浏览器自动化框架,目前仅提供英文界面且无官方中文版。本文指导用户通过GitHub获取源码,使用Docker快速部署本地环境,并解释其如何通过DOM树解析与自然语言指令实现网页自动操作,同时提供针对中文用户的配置建议与替代方案。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。