

Python使用OpenAI调用Llama模型的通用教程(Llama2/Llama3/Llama3.1)
Llama模型可通过Python的openai库调用,无需专用SDK。初始化客户端后,扩展参数需放入extra_body。其对温度敏感,结构化任务应低温并开启repetition_penalty防重复。同一代码兼容Llama2/3/3.1,支持普通与流式调用。
说起目前企业私有化部署最火的模型,Llama系列绝对占有一席之地。Meta开源的Llama 2、Llama 3、Llama 3.1,凭借免费开源、商用友好、推理高效这几个硬指标,成了不少团队私有化部署的首选方案。
大多数本地部署的Llama模型都会使用vLLM或SGLang这类推理框架,而且这些框架原生兼容OpenAI的接口规范。这意味着什么呢?你完全不需要去找Meta专用的SDK,直接用Python的openai库就能把Llama系列模型调得服服帖帖。
这篇文章会带你从零开始:环境怎么装、客户端怎么初始化、普通调用和流式调用怎么实现、Llama特有的参数怎么调、以及常见报错怎么解决。所有代码都是可以直接上生产环境的。
一、环境依赖安装
准备工作其实很简单,就装一个openai库就够用了:
pip install openai二、Llama调用核心知识点(必看)
在动手写代码之前,有几个关于Llama系列的关键点得先搞清楚:
- Llama全系没有思考链,所以调用时不需要enable_thinking这个参数,这也是它和Qwen3.6最大的区别之一。
top_k和repetition_penalty这些属于vLLM的扩展参数,必须放到extra_body里才能生效。- Llama对temperature参数特别敏感——低温度下极度严谨,高温度下则极度发散,调参的时候要格外小心。
- 模型名称必须和部署时的名称完全一致,比如
Llama3-8B或Llama3.1-70B-Instruct,一字不差才行。
三、初始化客户端(通用所有Llama模型)
不管用的是哪个版本的Llama,客户端的初始化方式都是一样的:
from openai import OpenAI

client = OpenAI(
    base_url="http://你的IP:8888/v1",
    api_key="你的部署密钥"
)
四、完整实战代码
1. 普通非流式调用(结构化、JSON、问答首选)
这种调用方式特别适合做批量处理、结构化输出、数据解析或知识库问答场景:
from openai import OpenAI

client = OpenAI(
    base_url="http://你的IP:8888/v1",
    api_key="你的部署密钥"
)

def llama_chat(question):
    response = client.chat.completions.create(
        model="Llama3.1-8B-Instruct",
        messages=[
            {"role":"system","content":"你是专业助手,回答准确、简洁、严格遵守用户要求"},
            {"role":"user","content": question}
        ],
        max_tokens=8192,
        temperature=0.1,
        top_p=0.3,
        frequency_penalty=0.05,
        presence_penalty=0.0,
        stream=False,
        extra_body={
            "top_k": 30,
            "repetition_penalty": 1.05
        }
    )
    return response.choices[0].message.content

if __name__ == "__main__":
    print(llama_chat("Python列表嵌套字典如何转为JSON字符串?"))
2. 流式输出调用(长文本、前端打字机效果)
如果要做长文本生成,强烈建议用流式方式,这样可以有效避免超时和卡顿:
from openai import OpenAI

client = OpenAI(
    base_url="http://你的IP:8888/v1",
    api_key="你的部署密钥"
)

def llama_stream_chat(question):
    stream = client.chat.completions.create(
        model="Llama3.1-8B-Instruct",
        messages=[
            {"role":"system","content":"严格按照用户要求输出,无多余解释"},
            {"role":"user","content": question}
        ],
        max_tokens=8192,
        temperature=0.1,
        top_p=0.3,
        stream=True,
        extra_body={
            "top_k": 30,
            "repetition_penalty": 1.05
        }
    )

    full_text = ""
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            text = chunk.choices[0].delta.content
            full_text += text
            print(text, end="", flush=True)
    return full_text

if __name__ == "__main__":
    llama_stream_chat("详细讲解大模型vLLM部署优势")
五、Llama模型专属参数调优详解
1. 标准参数(外层直接写)
temperature(Llama最重要的参数)
- 0.1 ~ 0.3:极度严谨,适合JSON、结构化、数据提取、固定格式
- 0.6 ~ 0.8:通用问答、总结、文案
- ≥1.0:高度发散,适合创意写作
top_p
- 结构化场景:0.3
- 通用场景:0.7~0.8
max_tokens
- 日常问答:2048
- 长文本、代码、文档:8192
frequency_penalty:用来抑制重复话术,一般固定在0.05就行。
2. extra_body扩展参数(vLLM专属)
top_k=30:收紧词汇范围,让Llama更听话、不乱输出。
repetition_penalty=1.05:Llama特别容易循环重复,所以必须轻开重复惩罚。
六、两套万能生产参数模板
模板1:结构化、严谨输出(JSON / 数据处理 / 规范任务)
temperature=0.1,
top_p=0.3,
max_tokens=8192,
frequency_penalty=0.05,
stream=False,
extra_body={
    "top_k":30,
    "repetition_penalty":1.05
}
模板2:通用问答、文本创作、总结
temperature=0.7,
top_p=0.8,
max_tokens=8192,
stream=True,
extra_body={
    "top_k":40,
    "repetition_penalty":1.03
}
七、Llama模型常见问题与解决方案
1. 模型容易重复、循环话术
原因:Llama原生的重复率确实比千问、DeepSeek要高一些。解决方法就是开启repetition_penalty=1.05。
2. 稍微高温度就乱跑
解决方案:结构化任务务必把温度控制在0.1。
3. top_k参数报错
解决方案:把它放到extra_body里,不要写在外层。
4. 流式无输出
原因:代码里没有做空值判断。解决方法:增加if chunk.choices and chunk.choices[0].delta.content这个判断条件。
八、Llama vs Qwen3 vs DeepSeek 调用区别
- Llama:无思考链、容易重复、对温度敏感
- Qwen3.6:有思考链,必须关闭才能得到纯净输出
- DeepSeek:代码能力强、稳定、重复率低
这三套模型的调用代码是完全一致的,只需要改模型名,再根据各自特点微调一下参数,就能无缝切换。
九、总结
- Llama全系模型都可以用openai库调用,根本不需要特殊SDK;
- 扩展参数必须放在extra_body里,否则会报错;
- Llama对温度非常敏感,结构化任务必须用低温;
- 必须开启repetition_penalty来抑制重复;
- 同一套代码通用于Llama 2、Llama 3、Llama 3.1所有版本。
本文详细解析Sora在国内的使用现状,指出目前官方未对公众开放注册,提醒用户警惕虚假链接,并提供关注官方动态及替代方案的实用建议。
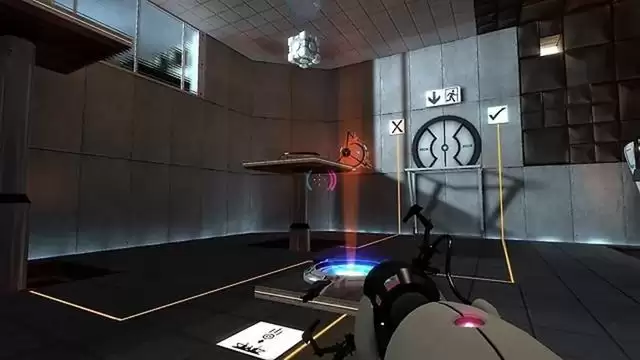
OpenAI GPT-6 Astra 模型通过 MCP 协议与 SourcePauseTool 控制《传送门》游戏,完成 3336 次工具调用并自主通关。实验耗时约 24 小时,API 成本约 571 美元,展示了多模态 AI 在 3D 解谜领域的突破性进展。
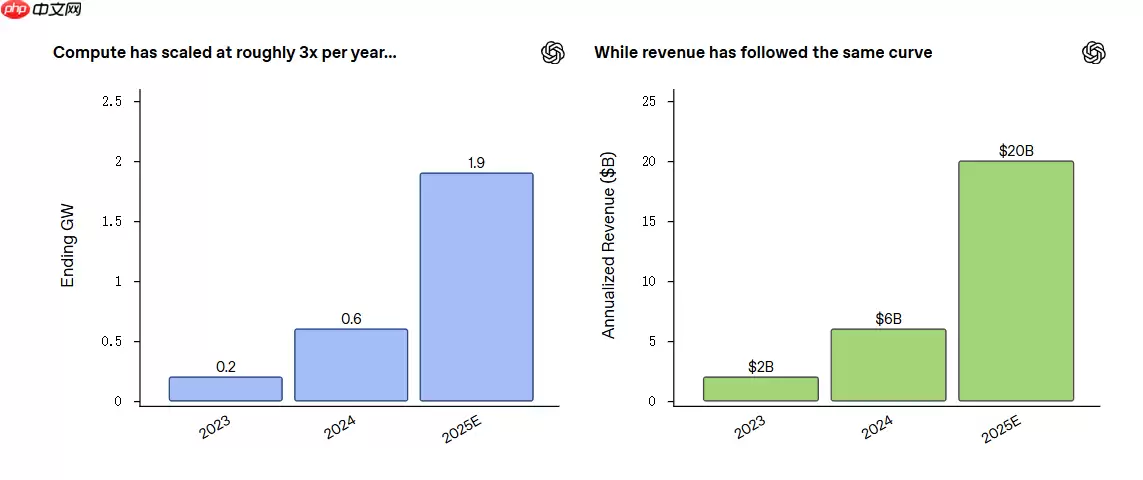
OpenAI算力总量预计2025年达1.9GW,较2023年增长9.5倍,年经常性收入同步增至200亿美元。推理成本已压至每百万token不到1美元,采取训练性能优先、推理效率优先的双轨策略。未来营收将拓展技术授权与按成效付费模式,并优先研发AIAgent与工作流自动化。
Transformer核心作者NoamShazeer离开谷歌加入OpenAI,担任架构研究负责人。他曾参与创办Character.AI,后因谷歌交易回归,如今再次转投。此举折射出行业对Transformer架构局限性的反思,以及下一代模型架构创新的迫切需求。
Transformer论文共同一作、谷歌元老级AI专家NoamShazeer再次离开谷歌,加盟OpenAI。他拥有高达35万余次论文引用,近期专利涉及结构化工具调用、神经架构搜索及混合专家模型等关键方向。OpenAI借此补齐构建超级智能体与底层模型架构的核心能力。
AI传奇人物诺姆·沙泽尔离开谷歌加入OpenAI。作为Transformer架构之父,他因不满谷歌严格的审批流程和“大公司病”,再次出走。选择OpenAI因其快速迭代理念和开放氛围,契合其推动AGI落地的核心诉求。
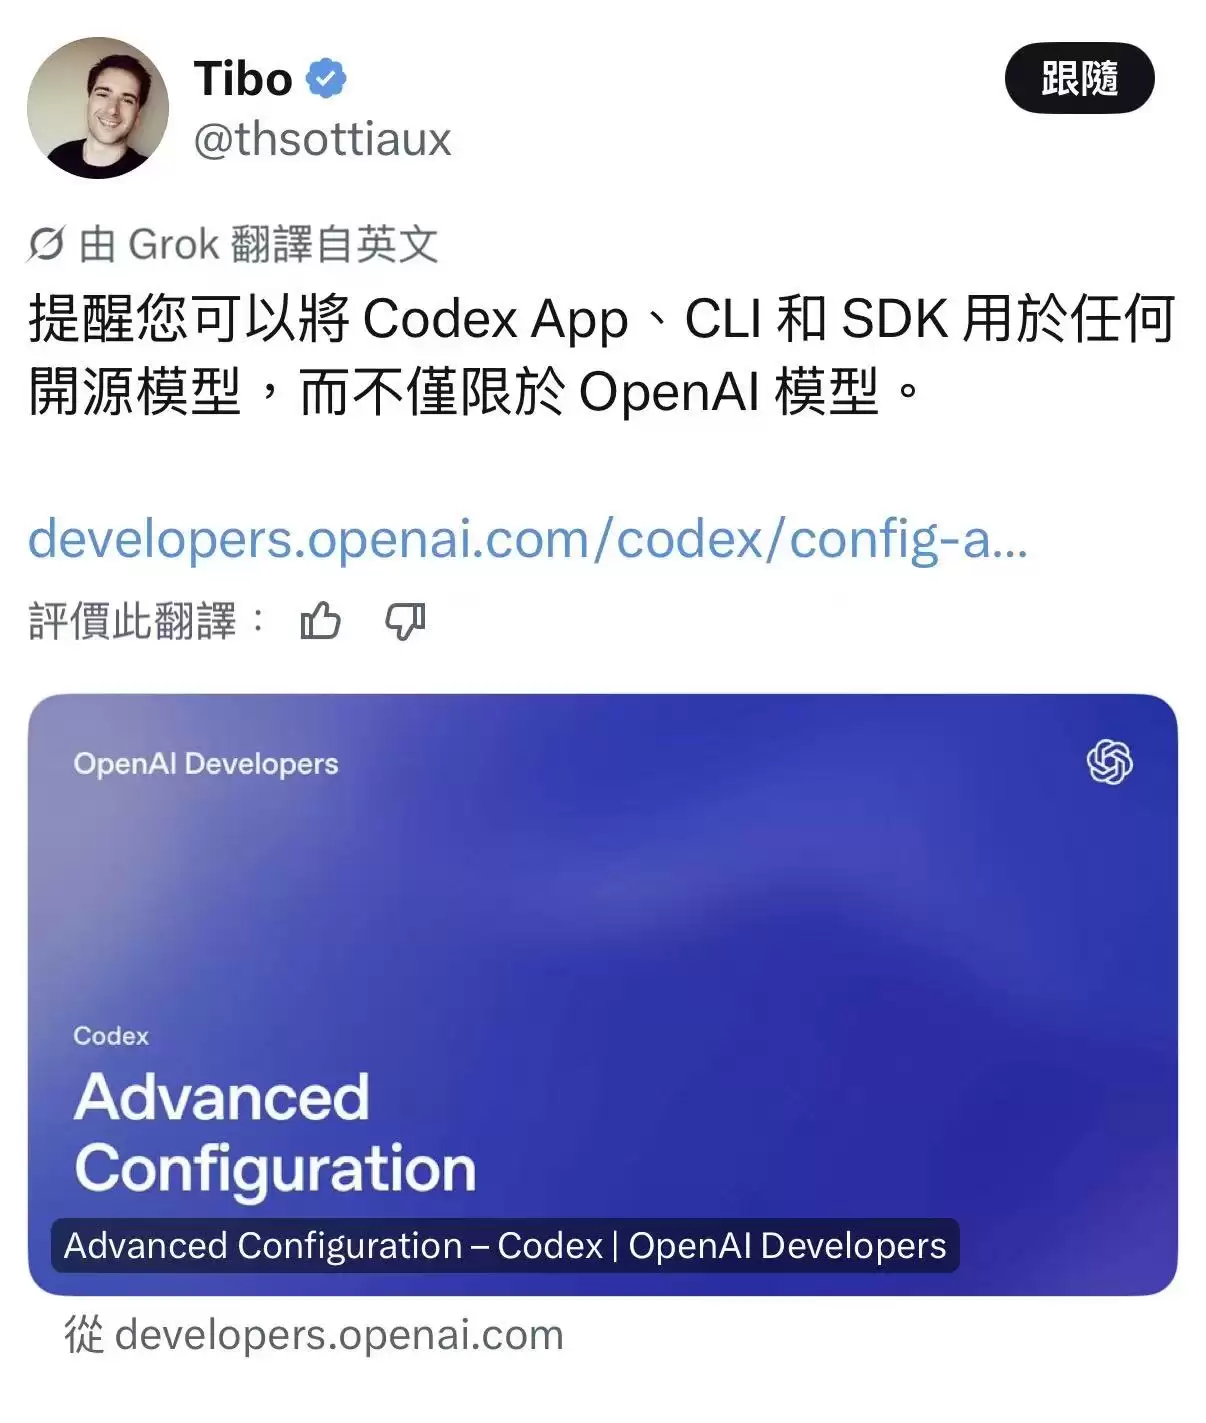
OpenAI的Codex工具开放第三方模型接入,但实际门槛高,仅支持ResponsesAPI协议。DeepSeek等国产模型无法直接接入,需通过本地转接桥,响应速度慢于官方模型,但成本极低。此举为国产模型提供成熟Agent容器机会,但OpenAI仍掌握核心标准。
OpenAI发布LifeSciBench基准测试,为AI制药建立标准化评估工具,推动行业规范。港股创新药板块短期承压,但AI制药从概念验证走向产业落地趋势不变,研发效率成核心竞争维度,板块估值有望修复。
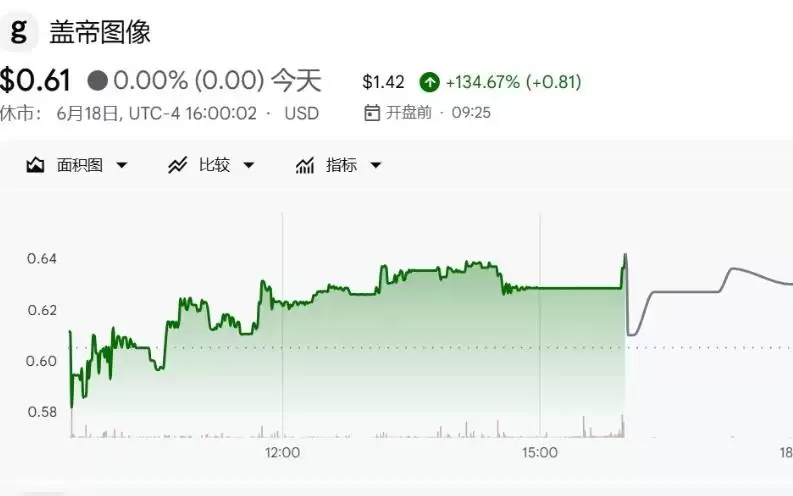
GettyImages与OpenAI签署展示协议,股价盘前暴涨141%,空头回补放大涨幅,市场反应强烈。此次合作标志着双方从对抗转向合作,OpenAI授权版图持续扩张,但公司基本面压力犹存。
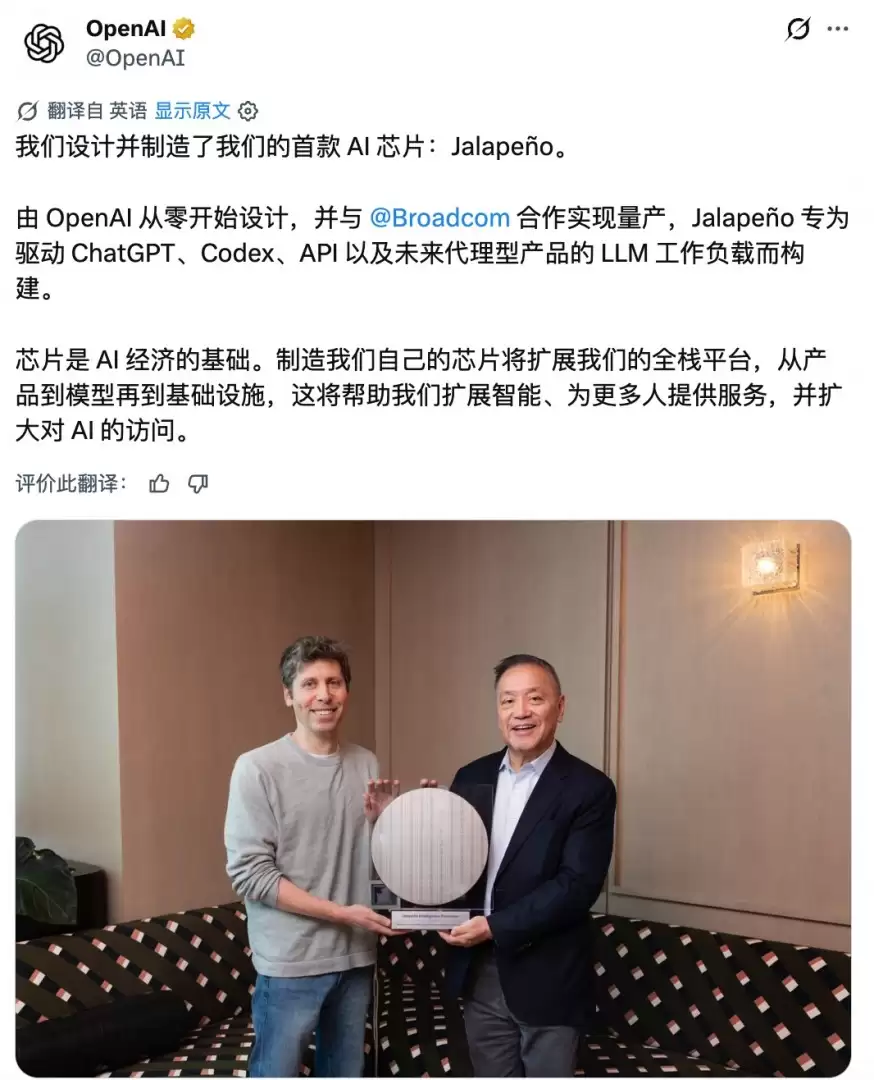
OpenAI联合博通推出首款自研AI芯片Jalapeño,专为大语言模型推理设计,开发周期仅9个月。芯片采用软硬件协同设计,并用AI优化自身架构,每瓦性能大幅领先业界。计划2026年商用,通过全栈布局降低AI使用门槛。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。