

Python在Ubuntu上如何进行性能优化
在Ubuntu环境下,Python性能优化可从七个方面入手:性能分析定位瓶颈、选择PyPy或Numba等更快解释器、优化代码逻辑与数据结构、利用多进程或多线程处理并行任务、使用NumPy等高性能库、通过缓存避免重复计算、以及进行系统级配置如使用SSD和增加内存。
Python性能优化一直是开发者关心的现实问题。在Ubuntu环境下,从代码级到系统级的调优手段多种多样,但很多人在实践中容易陷入“盲目优化”的误区。下面从七个切实可行的角度展开,帮助你系统性地提升Python程序运行效率。
1. 性能分析与瓶颈定位
优化之前,先得搞清楚瓶颈到底在哪。用工具说话,而不是靠直觉判断。常用的工具包括:
- cProfile:Python内置的性能分析器,可以生成函数级别的执行时间报告。运行
python -m cProfile -o output.prof your_script.py,然后用pstats模块或者snakeviz可视化工具查看热点函数,直击最耗时的部分。 - line_profiler:如果嫌函数级别不够精细,这工具能逐行分析代码性能。安装
pip install line_profiler,用kernprof -l -v your_script.py运行,每一行的耗时都清清楚楚。 - memory_profiler:内存泄漏或高占用怎么查?用
pip install memory_profiler,在函数上加@profile装饰器,然后执行python -m memory_profiler your_script.py,内存使用情况一目了然。
2. 选择更快的解释器
CPython虽然是标准解释器,但有些场景下换一个解释器效果立竿见影:
- PyPy:兼容CPython的JIT(即时编译)解释器,对循环、数值计算这类场景优化非常明显,通常比CPython快2到10倍。安装很简单:
sudo apt update && sudo apt install pypy3,然后直接用pypy3 your_script.py运行。 - Numba:专为数值计算设计的JIT编译器,尤其适合NumPy数组操作。只需要在函数前加上
@jit(nopython=True)装饰器,比如from numba import jit; @jit(nopython=True) def func(): ...,就能获得巨大的速度提升。
3. 代码逻辑优化
很多时候性能瓶颈并非来自硬件或解释器,而是代码本身写得不够“Pythonic”。
- 算法与数据结构:选对算法比什么都重要。比如用快速排序代替冒泡排序;优先使用
map()、filter()这类内置函数,它们比手写的循环快得多;做成员检查时,用集合set代替列表list——集合的哈希查找是O(1),列表是O(n),数据量一大差距就出来了。 - 减少全局变量:全局变量每次访问都要通过命名空间查找,速度远慢于局部变量。把频繁使用的全局变量在函数内部赋值给局部变量,比如
local_var = global_var,效果立竿见影。 - 使用生成器:处理大数据集时,生成器表达式
(x for x in range(1000000))比列表推导式[x for x in range(1000000)]节省内存——生成器按需产生数据,不会一次性把所有内容加载到内存里。 - 避免不必要的操作:减少类型转换(比如尽量保持整数而非浮点数)、合并多次循环(避免反复遍历同一数据)、用
join()拼接字符串(''.join(['a', 'b', 'c'])比用+高效得多)。
4. 并行与并发处理
单线程跑不过来了?那就要考虑并行或者并发。根据任务类型选择不同的方案:
- 多进程:针对CPU密集型任务(数值计算、图像处理等),用
multiprocessing模块充分利用多核CPU。示例:from multiprocessing import Pool; with Pool(4) as p: results = p.map(square, range(10))。 - 多线程:针对I/O密集型任务(文件读写、网络请求等),用
threading模块。注意Python的GIL会限制多线程在CPU密集场景下的效果,但I/O等待时GIL会释放,所以多线程在I/O密集时很有用。典型写法:import threading; def worker(): ...; threads = [threading.Thread(target=worker) for _ in range(5)]; [t.start() for t in threads]; [t.join() for t in threads]。 - 异步编程:针对高并发I/O场景(比如大量HTTP请求、数据库操作),用
asyncio库。它用单线程实现事件循环,避免线程切换开销。例如:import asyncio; async def worker(): await asyncio.sleep(1); async def main(): await asyncio.gather(*[worker() for _ in range(10)]); asyncio.run(main())。
5. 使用高性能库
别自己造轮子——Python生态里有大量经过C优化的库,直接用它们能省下大量时间:
- NumPy:用NumPy替代原生列表做数值计算。它的数组操作基于C实现,速度极快。比如
import numpy as np; result = np.sum(np.arange(1000000)**2)比原生Python循环快数十倍。 - Pandas:数据处理可以靠Pandas的DataFrame和Series,数据筛选、聚合等操作经过高度优化,比自己用字典或列表手动处理高效得多。
- Cython:如果还不够快,可以用Cython把Python代码编译成C。创建一个
.pyx文件,编写类似def sum_of_squares(int n): cdef int i, result = 0; for i in range(n): result += i*i; return result的代码,再用setup.py编译,性能能提升一个数量级。
6. 缓存机制
重复计算是性能的隐形杀手。把已经算过的结果缓存起来,能节省大量时间:
- 函数结果缓存:对经常被重复调用的函数,使用
functools.lru_cache装饰器。比如计算斐波那契数列:from functools import lru_cache; @lru_cache(maxsize=None) def fibonacci(n): return n if n < 2 else fibonacci(n-1)+fibonacci(n-2),第一次计算后结果会被缓存,后续直接返回。 - 内存缓存:对于频繁访问的数据(比如配置文件、数据库查询结果),可以用
functools.lru_cache或者第三方库cachetools来缓存,减少耗时的I/O操作。
7. 系统级优化
代码层面优化到极致后,别忘了系统本身的配置也至关重要:
- 使用SSD:把系统盘换成固态硬盘,文件读写速度能大幅提升,I/O瓶颈往往就是这样解决的。
- 增加内存:如果程序内存占用高,物理内存够大就能避免频繁使用交换空间(swap),否则系统会把大量时间花在磁盘和内存之间的数据交换上。
- 调整文件系统:采用
ext4或XFS这类成熟的文件系统,它们支持更快的写入和读取。还可以用tune2fs调整参数,比如增大inode缓存。 - 合理配置交换空间:根据物理内存大小设置合适的swap大小。比如内存8GB,可以设置2到4GB的交换空间,在内存不足时防止程序因OOM(内存溢出)而崩溃。
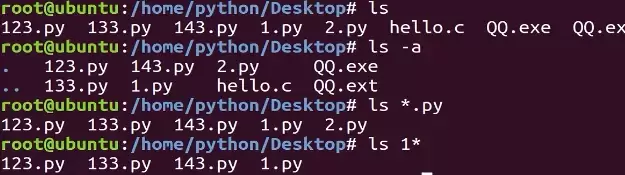
本教程指导Ubuntu新手打开终端,通过pwd、ls、cd、mkdir和touch命令完成基础文件目录操作。适用于桌面版、虚拟机及WSL环境,提供从查看路径到创建测试文件的完整验证步骤,帮助读者建立命令行操作的安全意识与正确习惯。
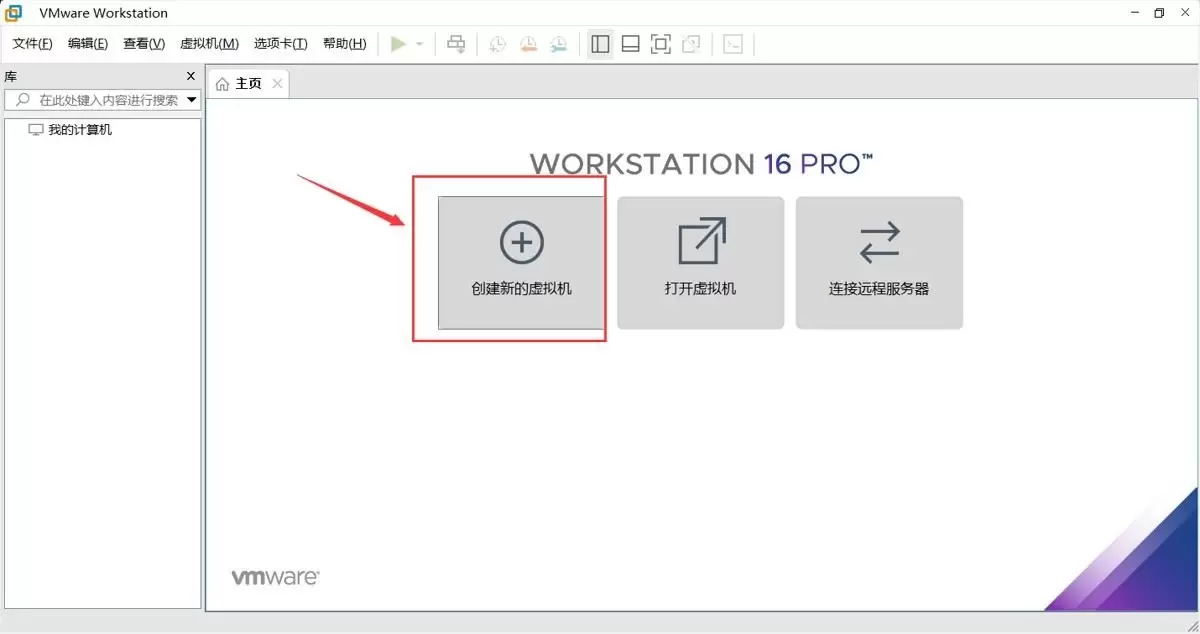
本文提供在VMware中安装Ubuntu并验证启动的完整流程。适用于首次练习Linux或搭建开发环境的用户。按步骤完成虚拟机创建、ISO挂载、硬件分配与安装后,可通过终端命令确认版本、内核与网络状态,确保系统可正常使用。
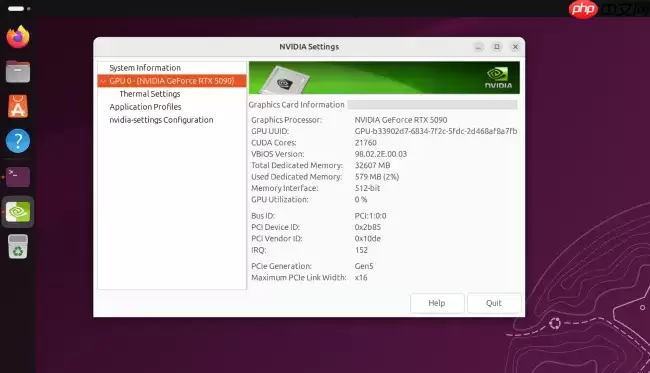
Ubuntu26.04LTS针对英伟达显卡在Wayland+GNOME环境进行性能调优,通过修改gbm_surface_lock_front_buffer函数,将帧渲染等待时间从毫秒级降至微秒级,显著提升UI响应和画面流畅度。该补丁已作为发行版专属补丁集成,确保LTS用户无需等待上游整合即可获得优化体验。
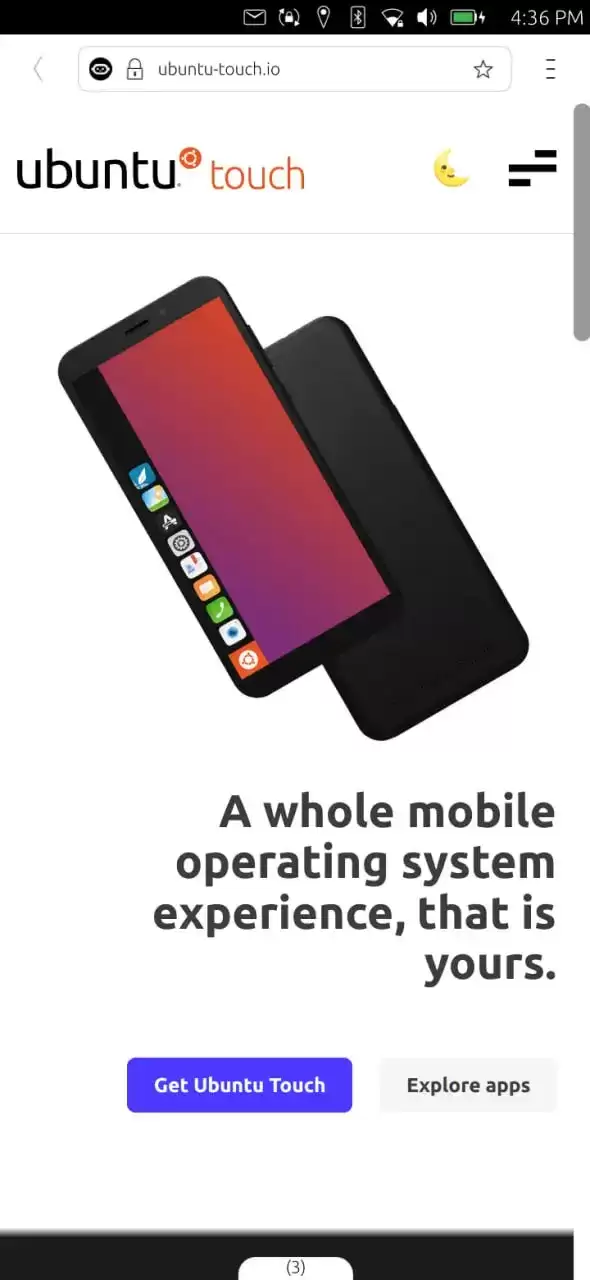
UbuntuTouch24.04-2.0Beta发布,底层升级至Ubuntu24.04,浏览器引擎从Chromium87跃升至134,网页兼容性显著提升;新增屏幕刘海区域自动适配、截图编辑器、网络指示器改进、移动数据可靠性增强、数据加密稳定,并新增NothingPhone(1)等设备支持。
ufw status仅显示高层策略和显式添加的规则(如“80 ALLOW Anywhere”),不反映默认策略绕过、IPv6独立规则、Docker等直写nftables的bypass规则,也无法体现本地回环流量不受管控等底层细节。Ubuntu 默认用 ufw 管理防火墙,但规则实际由 nftable
锁屏背景和桌面壁纸之所以不同,是因为GNOME默认会复制桌面壁纸,然后强制叠加高斯模糊和亮度调整效果,这个效果是由lockDialogGroup的CSS来控制的。要是想去除模糊,建议使用Control Blur Effect On Lock Screen扩展,把Adjust Sigma设置为0就行。
Ubuntu Swapper(一般就是指Ubuntu的交换分区或者交换文件)在服务器上的应用成效,是由多个因素共同决定的,像服务器的硬件配置情况、工作负载的类型以及交换空间的大小和具体配置等。下面为大家带来一些有关Ubuntu Swapper在服务器上应用效果的一般性评价:正面效果内存管理:交换空间
根本原因是纯命令行tty默认不支持UTF-8及中文字体渲染,locale设置仅影响字符解析逻辑,不解决字体绘制问题;图形终端自带UTF-8渲染,而tty需借助fbterm等工具实现中文显示。为什么终端里中文显示为问号或方块 纯命令行(tty,例如通过Ctrl+Alt+F3进入的界面)默认不会加载UT
通过分析Tomcat日志来提升Ubuntu服务器性能是一个很好的方法。以下是一些步骤和建议,帮助你通过Tomcat日志来优化服务器性能:1. 收集日志首先,得保证你的Tomcat服务器有详细的日志记录配置。在conf/logging.properties文件里,你可以对日志级别和输出格式进行调整。o
直接修改PS1是最为可控且轻量的方法。因为GNOME Terminal主题难以区分提示符、命令输入与输出,而PS1搭配ANSI转义码能够精准地为各个字段上色,并且需要用[ ]进行包裹,以防止光标出现错位的情况。直接改 PS1 是最可控、最轻量的方式,不需要装框架或改终端全局配色。 为什么不用改 GN




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。