

深入解析使用Scrapy爬取马蜂窝数据的问题
随着互联网的不断发展,数据的获取和处理变得越来越重要。爬虫技术就是其中的一项重要技术。而Scrapy作为比较流行的Python爬虫框架,能够帮助我们更加便捷地实现数据爬取,并且还具有高效、稳定、可扩展等优点。接下来,我们以爬取马蜂窝网站为例,来解析Scrapy爬虫技术的相关问题。1.如何规避反爬虫机制?在网站数据爬取过程中,往往会遇到反爬虫机制的限制。这里介
随着互联网的不断发展,数据的获取和处理变得越来越重要。爬虫技术就是其中的一项重要技术。而Scrapy作为比较流行的Python爬虫框架,能够帮助我们更加便捷地实现数据爬取,并且还具有高效、稳定、可扩展等优点。接下来,我们以爬取马蜂窝网站为例,来解析Scrapy爬虫技术的相关问题。
1.如何规避反爬虫机制?
在网站数据爬取过程中,往往会遇到反爬虫机制的限制。这里介绍几种避免反爬虫机制的方法:
(1)设置请求头信息:在爬虫代码中添加请求头信息,伪装成普通用户进行数据请求。比如User-Agent请求头信息。
(2)设置请求延时:合理设置请求延时,避免过快地频繁请求数据。
(3)使用代理IP:使用代理IP访问目标站点,可以有效地规避反爬虫机制。
2.如何解析网页数据?
解析网页数据是Scrapy爬虫技术中的关键步骤。Scrapy内置了xpath和css选择器两种解析方式。
(1)XPath:XPath是一种基于XML的查询语言。Scrapy利用XPath解析器可以方便地提取文本、属性等内容。
举个例子,若要获取马蜂窝首页上所有的旅游目的地名称及链接,可以利用以下代码:
def start_requests(self):
    yield scrapy.Request(url=self.url, callback=self.parse, headers=self.headers)

def parse(self, response):
    sel = Selector(response)
    items = sel.xpath('//div[@class="hot-list cf"]/div[@class="hot-list-item"]/a')
    for item in items:
        destination = item.xpath('./text()').extract()[0]
        link = item.xpath('./@href').extract()[0]
        yield {
            'destination': destination,
            'link': link
        }
(2)CSS选择器:CSS选择器是一种更加直观的选择器方法。Scrapy利用css选择器可以方便地提取标签、属性等内容。
同样以获取马蜂窝首页上的旅游目的地名称及链接为例,使用CSS选择器的代码如下:
def start_requests(self):
    yield scrapy.Request(url=self.url, callback=self.parse, headers=self.headers)

def parse(self, response):
    items = response.css('.hot-list-item > a')
    for item in items:
        destination = item.css('::text').extract_first()
        link = item.css('::attr(href)').extract_first()
        yield {
            'destination': destination,
            'link': link
        }
3.如何实现数据持久化?
在对网站数据进行爬取的过程中,我们通常会将数据保存下来以便后续的分析和使用。而对于数据的持久化存储,常见的有文件存储和数据库存储两种方式。
(1)文件存储:使用Python内置的文件操作函数,将爬取到的数据保存到本地文件中。
比如在Scrapy中使用以下代码将数据保存到.csv文件中:
import csv

def process_item(self, item, spider):
    with open('data.csv', 'a', newline='') as f:
        writer = csv.writer(f)
        writer.writerow([item['destination'], item['link']])
    return item
(2)数据库存储:使用Python中常用的关系型数据库MySQL、SQLite等存储数据,实现数据的持久化存储。
比如在Scrapy中使用以下代码将数据保存到MySQL数据库中:
import pymysql

def __init__(self, db_settings):
        self.host = db_settings['HOST']
        self.port = db_settings['PORT']
        self.user = db_settings['USER']
        self.password = db_settings['PASSWORD']
        self.db = db_settings['DB']
        try:
            self.conn = pymysql.connect(
                host=self.host,
                port=self.port,
                user=self.user,
                password=self.password,
                db=self.db,
                charset='utf8'
            )
            self.cursor = self.conn.cursor()
        except Exception as e:
            print(e)

def process_item(self, item, spider):
    sql = "INSERT INTO destination(name, link) VALUES(%s, %s)"
    self.cursor.execute(sql, (item['destination'], item['link']))
    self.conn.commit()
    return item
总结
通过以上三个问题的解析,我们可以看出Scrapy是一个功能强大、易于使用的爬虫框架,可以帮助我们轻松地实现数据爬取、数据解析和数据持久化等功能。当然,在实际的应用过程中,还会遇到各种问题和挑战,需要我们不断的学习和改进。
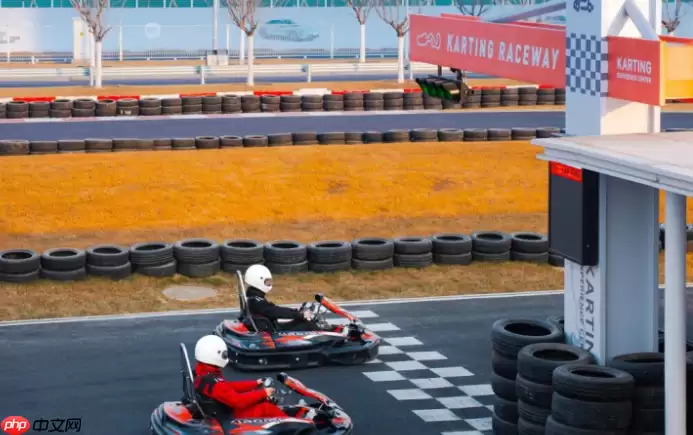
暑期亲子游需求升级,家长更青睐高性价比自驾与工业研学、博物馆夜游、户外探索等“成长型体验”,注重孩子深度参与和知识收获,新兴主题搜索热度飙升35%,文旅产品正围绕儿童需求系统化定制。
都说“工欲善其事,必先利其器”,做旅行规划,选对工具能省下不少心力。市面上各类旅行App各有看家本领,有的主打信息参考,有的强在预订效率,还有的在服务体验上做文章。这里梳理了十款主流应用,从功能侧重到适用场景,希望能帮你快速锁定最适合的那一款。 1、《马蜂窝》 以真实的游记和深度的目的地点评见长,说
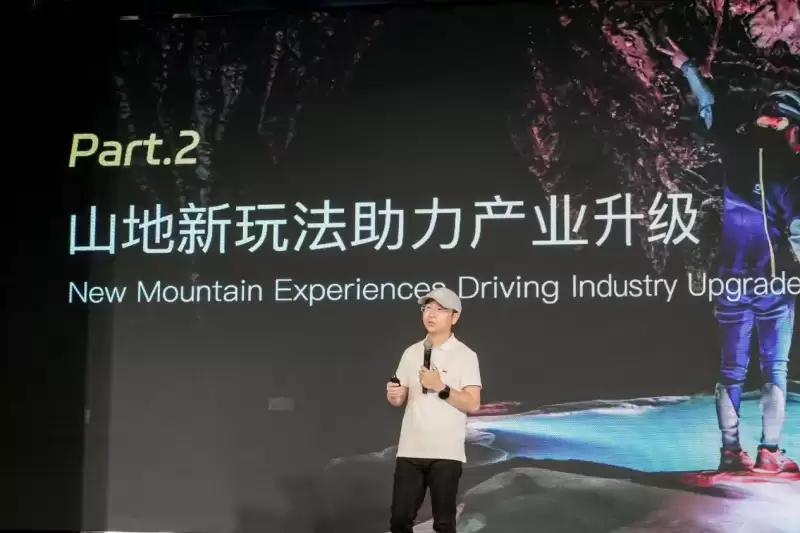
马蜂窝与安顺市文体广电旅游局联合发布《2026安顺山地户外新玩法宝典》,推出黄鹤营洞、莲花古洞、罗秧河三大标杆项目。这些项目采用“轻开发、重体验”模式,聚焦自然奇观与互动探险,旨在以独特体验重新定义山地旅游,推动安顺成为全国山地新玩法策源地。
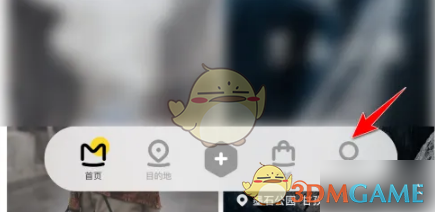
马蜂窝如何添加通讯录好友?1、打开马蜂窝App,在首页界面,点击右下角“我的”进入个人页面。2、在“我的”页面中,选择“关注”选项,进入关注管理界面。3、找到并点击“通讯录好友”一栏中的“来看看谁在马蜂窝”按钮。4、系统会列出可匹配的好友列表,点击“全部关注”即可一键添加通讯录中已使用马蜂窝的好友。
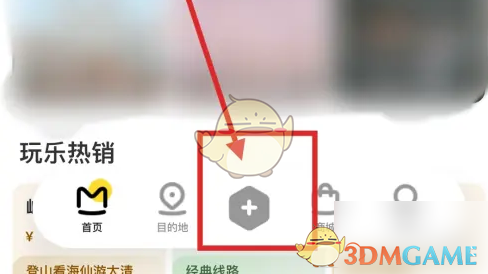
如何在马蜂窝发布旅游攻略?1、打开马蜂窝手机应用,进入首页后点击底部中间的加号图标,2、在弹出选项中选择“发图文/视频”功能并进入,3、编辑你的旅行内容,完成后点击“发布”,即可将攻略成功分享至马蜂窝平台。
Scrapy架构设计的亮点包括:1.基于Twisted的异步机制提升并发效率;2.中间件机制灵活处理Request和Response;3.组件可扩展性强,支持自定义Spider、Pipeline等;4.清晰的组件划分便于理解和维护。

如何使用Scrapy抓取JD商家的商品数据Scrapy是一个功能强大的Python网络爬虫框架,它可以让我们简单方便地编写代码,从而抓取网页数据。本文将介绍如何使用Scrapy抓取JD商家的商品数据。准备工作在开始编写代码之前,我们需要进行一些准备工作。1.安装Scrapy我们需要在本地安装Scrapy,如果你还没有安装Scrapy,可以在命令行中输入以下
Scrapy框架爬取Twitter数据的实现随着互联网的发展,社交媒体已成为人们广泛使用的平台之一。而Twitter作为全球最大的社交网络之一,每天都有海量的信息产生。因此,如何利用现有的技术手段有效地获取并分析Twitter上的数据就变得尤为重要。Scrapy是一个Python的开源框架,专门用于抓取和提取特定网站上的数据。相对于其他类似框架,Scrapy
Scrapy是一个基于Python的Web爬虫框架,它能够快速地从互联网上爬取数据,并提供简单易用的API和工具进行数据处理和分析。在这篇文章中,我们将讨论Scrapy在Twitter数据爬取与分析中的实际应用案例。Twitter是一个社交媒体平台,有着海量的用户和数据资源。研究人员、社交媒体分析者和数据科学家们可以从中获取大量的数据,并通过数据挖掘和分析来
近年来,随着电商市场的蓬勃发展,天猫成为了中国最大的电商平台之一。对于公司而言,想要了解目标市场,了解自身产品的销售状况,获取竞争对手的销售状况等信息是十分重要的。在这种情况下,爬取天猫数据成为了企业常用的方式之一。本文将介绍如何使用Scrapy爬虫框架爬取天猫数据,并对数据进行简要分析。一、Scrapy爬虫的基本使用Scrapy是一个用于Web数据抓取的P





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



