

TensorFlow模型推理如何提速_使用tf.function装饰器编译图运算
tf.function将函数编译为静态计算图,跳过Python解释器并融合算子以加速推理,但首次调用迹化较慢,需多次调用同一签名才有效。适合输入结构固定、shape稳定的前向推理,应使用input_signature约束shape并避免频繁变化。预热后实测吞吐和延迟,CPU提速更明显,但内存占用增加。
先说几个大的判断:TensorFlow 默认的 eager 模式确实好用,对调试友好,但推理场景里,每行 Python 代码都要实时执行、做类型检查、记录梯度,这些开销算下来并不小。而 tf.function 的作用,就是把你的函数"编译"成一张静态计算图——跳过 Python 解释器、融合算子、做图级优化(比如常量折叠、冗余节点剔除),推理时直接跑优化后的成品图,效率自然就上去了。
不过需要留意的是:提速有一个关键前提——得是多次调用同一签名的函数才有效。首次调用需要进行"迹化"(tracing),这个过程甚至可能比 eager 模式还慢。真正的红利,从第二次调用才开始兑现。
- 适合场景:
model(x)这类输入结构固定的前向推理,尤其是 batch size 稳定、输入 shape 可预知的情况。 - 不适合场景:输入 shape 频繁变化(比如 NLP 里变长序列没做 padding),或者函数内含大量 Python 控制流(例如
if len(x) > 0),且分支逻辑差异很大。 - 另外要特别提醒一点:编译后的函数无法用
print或pdb调试,报错堆栈会指向 trace 生成阶段,而不是原始的 Python 行号,排查起来会比较头疼。
怎么加 tf.function 才不踩坑
不是简单地套个装饰器就完事了。最常见的一个错误,是把整个模型的 call 方法直接包进去,结果要么触发重复 trace,要么泄漏了一些隐式状态。
- 推荐做法:只装饰最外层的推理函数,并且确保输入参数是
tf.Tensor,或者至少是能被自动转为 tensor 的类型(尽量避免传 Python 的 list 或 dict)。 - 别在
tf.function内部读写 Python 对象(比如全局 list.append),这些操作不会被图追踪,运行时的行为是完全不可预测的。 - 如果模型有
training=True/False参数,必须显式设为常量,或者用tf.TensorSpec提前声明。否则,不同的 training 值会触发多个 trace,白白浪费资源。 - 一个正确的示例写法:
@tf.functiondef infer(x): return model(x, training=False)
输入 shape 不固定怎么办
当 batch size 或序列长度频繁变化时,tf.function 默认会对每个新 shape 重新 trace,内存和时间都会爆炸。这时候需要主动去约束输入规格。
- 用
input_signature强制统一 shape 模板,比如让第二维设为None:@tf.function(input_signature=[ tf.TensorSpec(shape=[None, None], dtype=tf.int32)])
- 对于图像类任务,提前 resize 到固定尺寸,比依赖
None来得更稳;NLP 任务务必要 pad 到 max_len。 - 避免在函数内做 shape 推断(比如
x.shape[0]),改用tf.shape(x)[0]。前者是 Python int,后者是 runtime tensor,能被正确地接入计算图。 - trace 失败时常见的报错信息有
Cannot compute output shape或Input tensor must ha ve known rank,基本都是在提示 shape 信息没传够。
提速效果到底看哪里
别只盯着单次 time.time() 看,那测的是 trace + 执行的合计耗时。真正有价值的指标,是 warmup 之后的稳定吞吐(samples/sec)和 P99 延迟。
- 实测建议:先调用 3–5 次函数进行预热,然后用
timeit或tf.timestamp()去测 100 次以上的平均耗时。 - 对比基线必须是同一环境下的 eager mode,并且模型已经
build完成、权重加载完毕。 - GPU 上的提速通常在 1.5–3 倍;CPU 上效果会更明显(尤其是小模型)。但如果模型本身的计算量很小,Python 开销占比不高,那么提速幅度也比较有限。
- 容易忽略的一点是:
tf.function编译后内存占用会更高——每个 trace 都会缓存一份图,shape 变化越多,图实例就越多,显存或内存自然会吃紧。
说到底,真正卡住性能的,往往不是算子本身,而是 trace 策略和输入规整程度。与其反复调 tf.function 的参数,不如先把输入 pipeline 的 shape 和 dtype 稳下来。
Reddit 用户“PresentSpecific5666”昨天发了一篇长文,对着5年前那台Pixel 6一顿猛批,最后撂下一句话:以后再也不会买谷歌的手机了。免费机子?不存在的,免费也不值得用。 先说个背景。这位老哥和妻子当年是在Sprint并入T-Mobile时,一人免费领了一台Pixel 6。
8月14日消息,谷歌已于本周正式推出年度旗舰 Pixel 11 系列,阵容一共包括 Pixel 11 标准版、Pixel 11 Pro、Pixel 11 Pro XL 以及 Pixel 11 Pro Fold 四款机型。这一代产品率先搭载谷歌自研的 Tensor G6 芯片,不过这颗芯片具体采用了怎
8 月 14 日消息,Google(谷歌)硬件副总裁彭昱钧昨日确认,本周早些时候发布的 Pixel 11 系列智能手机所搭载的 Tensor G6 芯片采用台积电最新改良 3nm 制程。这意味着此前“Tensor G6 移动端首发台积电 2nm”的传闻不实。谷歌给 Tensor G6 的定位很明确:
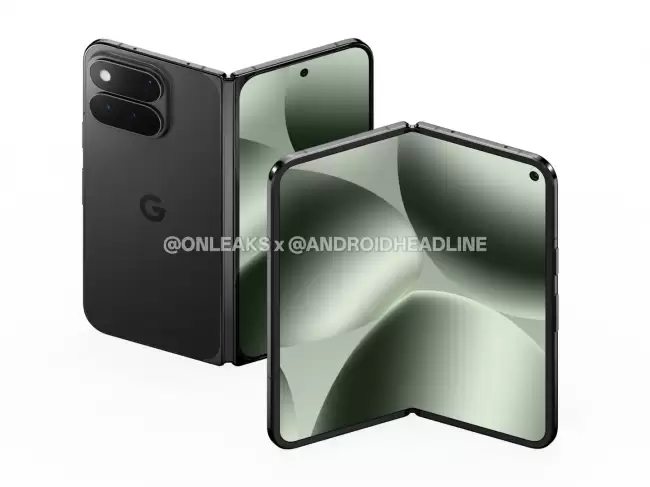
谷歌Pixel11ProFold通过FCC认证,文件出现联发科关键词,暗示TensorG6芯片或放弃三星Exynos基带,改用联发科M90基带以降低功耗,此前传闻得到证实。
台积电2nm制程量产,谷歌为首发客户,Pixel11系列8月12日发布,搭载TensorG6芯片,早于苹果约一个月。苹果A20芯片9月登场,高通、联发科也将推出2nm芯片,2nm工艺竞争全面升温。
谷歌自研Tensor芯片问世近五年,在AI任务上实现目标,但续航、温控和性能短板明显。超七成受访者认为应放弃,主要因其未兑现技术承诺,且性能不及骁龙与苹果A系列。不过,短期谷歌并未放弃,下一代TensorG6将继续搭载。
谷歌Pixel 11系列旗舰机型将于8月12日发布,这已经是板上钉钉的事。而主打中端市场的Pixel 11a,则要等到明年春季才姗姗来迟。不过,最近有知情人士提前曝光了Pixel 11a的核心配置,这应该是目前关于该机最全面的一次参数泄露了。 谷歌Pixel 11系列CAD渲染图 具体来看,Pixe
一项针对一千七百多位用户的调查结果显示,大约百分之六十九点二的受访用户认为谷歌应终止自研Tensor处理器研发项目,主要原因在于其性能、续航和发热表现均不佳,而支持继续开发的仅占百分之三十一。
在TensorFlow中,通过构造多维散列索引实现top-k原位更新:先广播索引至所有空间维度,再转为三维坐标,最后用tf.tensor_scatter_nd_update定点更新,避免拼接重排序,节省内存,支持图模式与反向传播,适用于高效稀疏梯度更新。
谷歌Pixel11ProFold折叠屏手机通过FCC认证,文件中出现“MediaTek”关键词,暗示TensorG6芯片可能改用联发科M90基带以降低功耗,与先前传闻吻合。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



