

本地私有化部署DeepSeek模型的详细教程
从环境准备到API部署,详细介绍了本地私有化部署DeepSeek模型的完整流程,包括硬件与软件要求、虚拟环境创建、依赖安装、模型下载与推理测试,以及FastAPI服务搭建、量化优化和分布式推理等性能提升方法,同时强调了数据安全与资源管理。
一、引言
DeepSeek 模型的能力毋庸置疑,但要把这份能力真正攥在自己手里,本地私有化部署几乎是唯一靠谱的路径。毕竟,数据安全和定制化配置,才是企业级应用的基石。这篇指南会一路带你走完整个流程,从环境准备到上线运行,把每一步的关键细节都交代清楚。
二、环境准备
(一)硬件要求
要在本地跑起模型,硬件条件是硬门槛。核心配件的要求如下:
- CPU: 多核处理器是标配,Intel Xeon 或 AMD EPYC 系列可以考虑。至少 4 核起步,否则光加载模型都能卡半天。
- GPU: 如果追求高效推理,NVIDIA GPU 是首选——GeForce RTX 30 系列或更高规格的 A100 都可以。显存至少 8GB,越大越好,这直接决定了你能跑多大规模的模型。
- 内存: 最低 16GB,如果部署的模型体量较大,建议直接上 32GB 或更多。
- 存储: 模型文件本身就很占地方,几十 GB 到上百 GB 都很常见,务必提前预留足够的磁盘空间。
(二)软件要求
硬件到位之后,软件环境也得配套。操作系统推荐 Linux,比如 Ubuntu 20.04 或更高版本——性能和兼容性确实比 Windows 更优。如果用 Windows 10/11 也不是不行,但可能会遇到一些额外坑。
接着说几个必备组件:Python 3.8 或更高版本是基础;如果配置了 NVIDIA GPU,CUDA 工具包和 cuDNN 库一定要按对应的版本来安装,否则 GPU 等于摆设。
(三)创建虚拟环境
强烈建议先创建一个独立的虚拟环境,避免和系统其他 Python 项目产生依赖冲突。命令很简单:
# 创建虚拟环境
python -m venv deepseek_env

# 激活虚拟环境(Linux/Mac)
source deepseek_env/bin/activate

# 激活虚拟环境(Windows)
deepseek_env\Scripts\activate
三、安装依赖库
激活环境后,接着安装核心依赖,包括 PyTorch 和 Transformers 库。注意 PyTorch 的安装命令取决于你使用的是 CUDA 版本还是纯 CPU 版本:
# 安装 PyTorch(以 CUDA 11.8 为例)
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118

# 若不使用 GPU
pip install torch torchvision torchaudio

# 安装 Transformers 库
pip install transformers

# 其他可能需要的库
pip install sentencepiece accelerate
四、获取 DeepSeek 模型
(一)下载模型文件
模型可以从 Hugging Face 官方模型库下载。根据需求选择版本,比如 deepseek-llm-7b 或 deepseek-llm-67b。有两种方式可以下载:一种是用 Python 脚本直接拉取并保存到本地:
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "deepseek-ai/deepseek-llm-7b"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)

# 保存到本地
model.sa ve_pretrained("./local_deepseek_model")
tokenizer.sa ve_pretrained("./local_deepseek_model")
另一种是用 git lfs 命令行工具直接克隆仓库——如果网络够稳定,这种方式更省事:
git lfs install
git clone https://huggingface.co/deepseek-ai/deepseek-llm-7b
(二)模型文件结构
下载完成后,看看文件夹里都有些什么:核心是 config.json(模型架构配置文件)、pytorch_model.bin(模型权重)、以及 tokenizer.json 和 tokenizer_config.json 等分词器相关文件。这些一个都不能少。
五、模型推理测试
模型部署到位后,最好先跑个简单的推理测试,确认一切正常。用下面这段代码就够:
from transformers import AutoTokenizer, AutoModelForCausalLM

model_path = "./local_deepseek_model"
tokenizer = AutoTokenizer.from_pretrained(model_path)
model = AutoModelForCausalLM.from_pretrained(model_path)

input_text = "今天天气怎么样?"
input_ids = tokenizer.encode(input_text, return_tensors="pt")
output = model.generate(input_ids, max_length=100, num_return_sequences=1)
output_text = tokenizer.decode(output[0], skip_special_tokens=True)

print("输入:", input_text)
print("输出:", output_text)
六、使用 API 进行部署
(一)使用 FastAPI 搭建推理 API
测试通过后,就可以考虑把模型包装成 API 服务了。FastAPI 是 Python 生态里最合适的选择之一——速度快、代码简洁。下面是一个典型的推理 API 搭建示例:
from fastapi import FastAPI
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch

app = FastAPI()

model_path = "./local_deepseek_model"
tokenizer = AutoTokenizer.from_pretrained(model_path)
model = AutoModelForCausalLM.from_pretrained(model_path)

if torch.cuda.is_a vailable():
    model = model.cuda()

@app.post("/generate")
async def generate_text(input_text: str):
    input_ids = tokenizer.encode(input_text, return_tensors="pt")
    if torch.cuda.is_a vailable():
        input_ids = input_ids.cuda()
    output = model.generate(input_ids, max_length=100, num_return_sequences=1)
    output_text = tokenizer.decode(output[0], skip_special_tokens=True)
    return {"input": input_text, "output": output_text}
(二)运行 API 服务
把上面的代码保存为 main.py,然后在命令行启动:
uvicorn main:app --host 0.0.0.0 --port 8000
其中 --host 0.0.0.0 表示允许任何 IP 访问,--port 8000 是监听端口号。如果只想本机访问,可以改成 127.0.0.1。
(三)测试 API
用 curl 命令就可以快速测试接口是否正常:
curl -X POST "http://localhost:8000/generate" \
-H "Content-Type: application/json" \
-d '{"input_text": "今天天气怎么样?"}'
如果返回了 JSON 响应,就说明 API 服务已经跑通了。
七、性能优化
(一)量化模型
模型跑起来之后,如果想进一步压榨性能,可以尝试量化。简单来说,就是把模型参数从 32 位精度降到 8 位整数,内存占用和推理时间都能显著降低。用 optimum 库可以轻松实现:
from transformers import AutoTokenizer, AutoModelForCausalLM
from optimum.onnxruntime import ORTQuantizer, ORTModelForCausalLM
from optimum.onnxruntime.configuration import AutoQuantizationConfig

model_path = "./local_deepseek_model"
tokenizer = AutoTokenizer.from_pretrained(model_path)
model = AutoModelForCausalLM.from_pretrained(model_path)

qconfig = AutoQuantizationConfig.a vx512_vnni(is_static=False, per_channel=True)
quantizer = ORTQuantizer.from_pretrained(model)

quantized_model_path = "./local_deepseek_model_quantized"
quantizer.quantize(sa ve_dir=quantized_model_path, quantization_config=qconfig)
(二)使用分布式推理
如果手上有多个 GPU 或多台机器,分布式推理就是解锁下一阶段性能的关键。利用 torch.distributed 模块可以轻松实现——不过门槛相对高一些,适合有经验的团队尝试。下面是一个简单的示例框架:
import torch
import torch.distributed as dist
import torch.multiprocessing as mp
from transformers import AutoTokenizer, AutoModelForCausalLM

def setup(rank, world_size):
    os.environ['MASTER_ADDR'] = 'localhost'
    os.environ['MASTER_PORT'] = '12355'
    dist.init_process_group("nccl", rank=rank, world_size=world_size)

def cleanup():
    dist.destroy_process_group()

def inference(rank, world_size):
    setup(rank, world_size)
    # ...(加载模型、推理、输出)
    cleanup()

if __name__ == "__main__":
    world_size = torch.cuda.device_count()
    mp.spawn(inference, args=(world_size,), nprocs=world_size, join=True)
八、安全与管理
(一)数据安全
本地部署的最大优势就是数据不外传,但内部安全同样不能忽视。API 通信一定要用 HTTPS 协议,同时严格控制访问权限,敏感数据最好加密存储或脱敏处理。
(二)模型更新与维护
定期关注 DeepSeek 官方更新,及时把新版本拉下来替换本地模型。同时,部署监控系统(比如 Prometheus + Grafana)随时跟踪模型的运行状态,可以帮你第一时间发现问题。
(三)资源管理
服务器资源是有限的。CPU、内存、GPU 利用率都需要心里有数,避免因突发请求导致服务崩溃。一旦监控到资源告警,及时扩容或限流。
九、总结
以上就是 DeepSeek 模型本地私有化部署的完整流程。从环境准备、模型获取、推理测试,到 API 搭建和性能优化,每一个环节都没有捷径可走。当然,实际部署中难免会遇到具体环境带来的差异——比如不同操作系统下的路径格式、CUDA 版本的适配问题等等。但也正是这些细节,才让“私有化部署”这件事真正体现出价值。
需要提醒的是,以上代码和步骤仅供参考,实际部署请务必根据自身的软硬件环境进行调整。同时也别忘了,任何时候都要遵守相关法律法规和模型的使用条款。
本地部署DeepSeek使用Ollama和DeepSeek-R1模型,搭配Enchanted界面工具。通过Ollama命令下载模型,注意电脑配置:70b版本要求高,推荐1.5b或32b版本。Enchanted提供macOS原生界面,配置简便,适合快速体验。
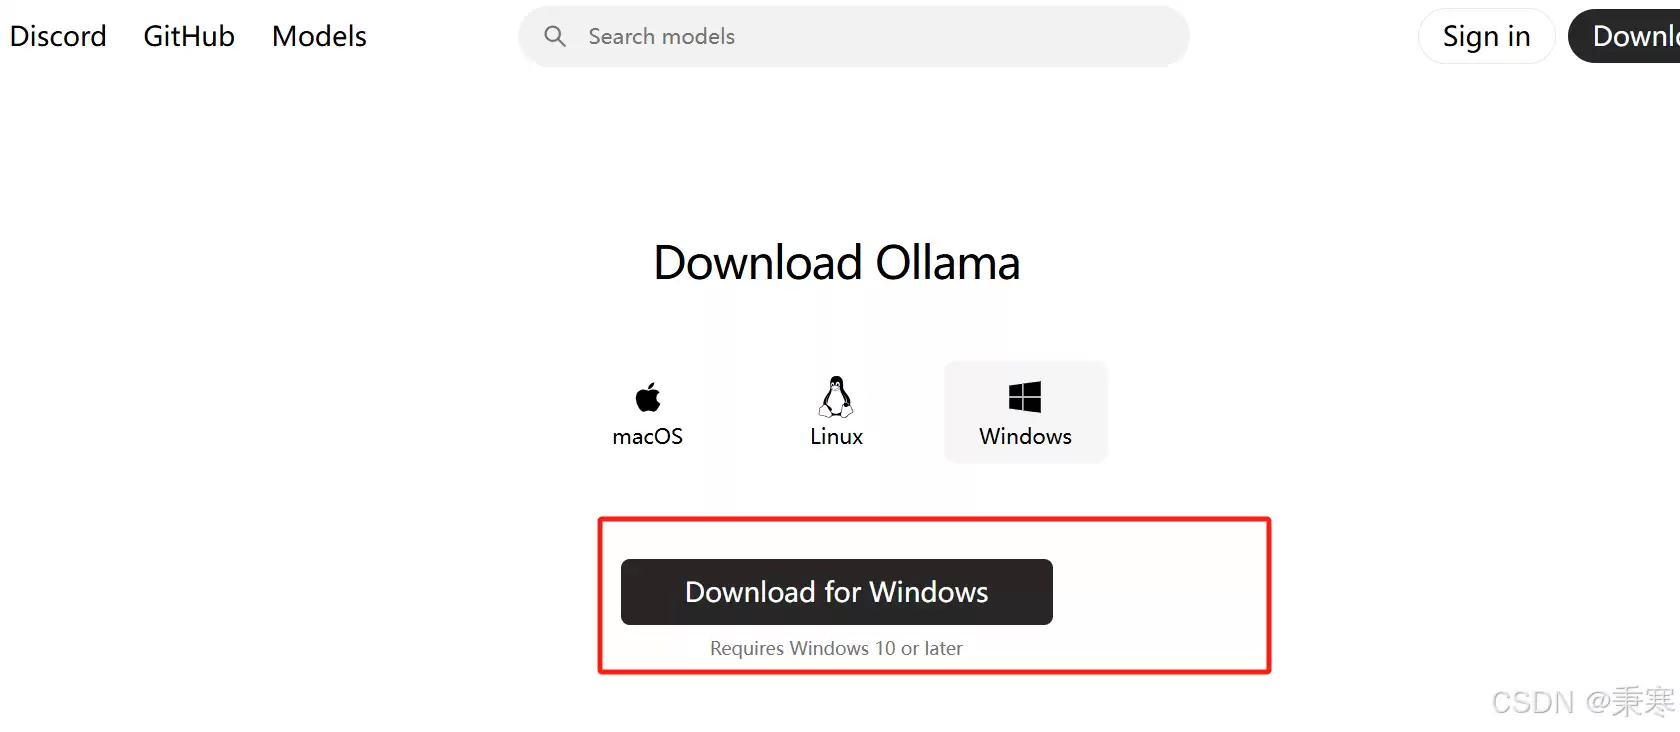
第一步:找到网站,下载 首先,当然是访问Ollama官网,根据自己的电脑操作系统,选择对应的安装版本进行下载。整个过程非常直接。 这里以Windows版本为例,文件体积并不大,下载速度通常也很快,几分钟内就能搞定。 第二步:安装 运行下载好的安装程序,流程就是典型的“下一步”操作。安装完成后,通常会
给出LiteLLM1.109.0五项迁移配置,说明fallback列表、local缓存、router_settings硬限流、Gemini参数和Lens独立部署,并区分LTS/旧补丁/RC。
agent-desktop 1.3.1让已经启动的沙箱在启动器退出后继续运行,并更新rustix至1.1.6。对通过JSON快照操作桌面的用户而言,沙箱存活、平台权限与ref有效性需要分别判断,不能用其中一项正常代替整项任务的验收。
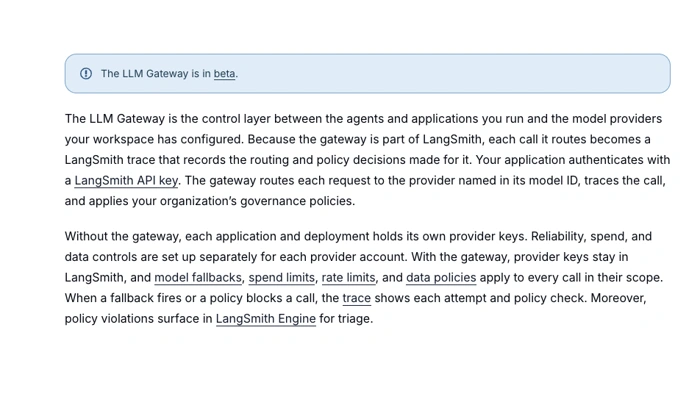
langchain-core 1.8.1新增的langsmith_gateway用于上下文级LangSmith Gateway覆盖。它并非一次模型调用的临时请求参数:路由在模型构造时解析,因而生效位置、集成支持和配置优先级都需要一起理解。
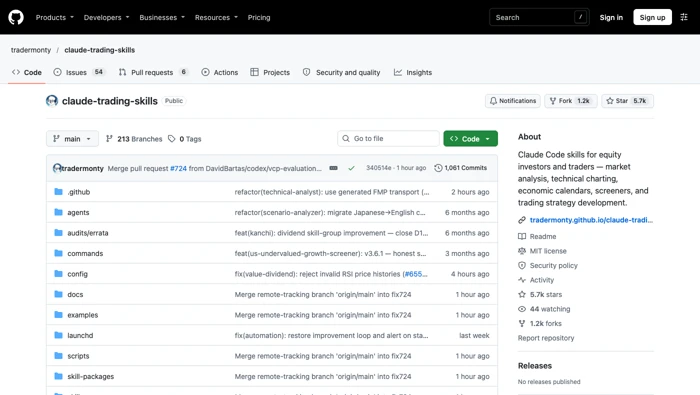
Claude Trading Skills分别记录覆盖完整性、数据来源和规则确认;维护者自动扫描标记的not_verified不能等同完整安全验证或已发生密钥泄露,相关Skill代码未在该审查提交中修改。

llama.cpp预发布b12420、b12424、b12426、b12428分别带来模型与模板层面的变化。文本模型、文本转语音、语音识别和Jinja渲染不是一项能力;按任务对应构建,可以避免把某个新增支持误认为适用于所有模型的通用升级。
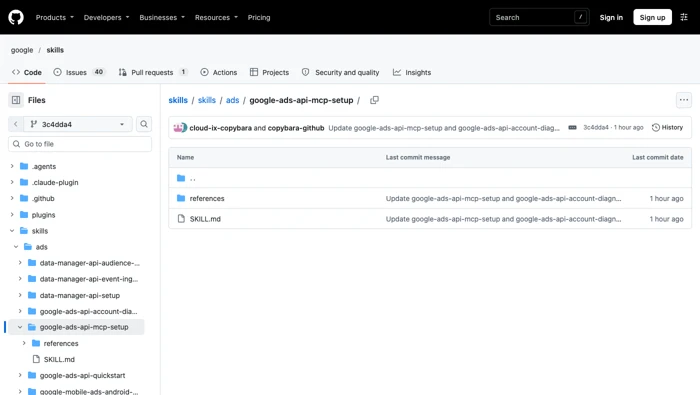
Google Ads设置与Quickstart Skills 1.1.1、账号诊断1.0.3明确MCP有限写入、只读配置和结构化search参数,安装前提为Python3.10+与pipx。
LangChain四个模型集成包共同移除Python3.10支持并加入Gateway路由,需区分独立包版本与各自修复。
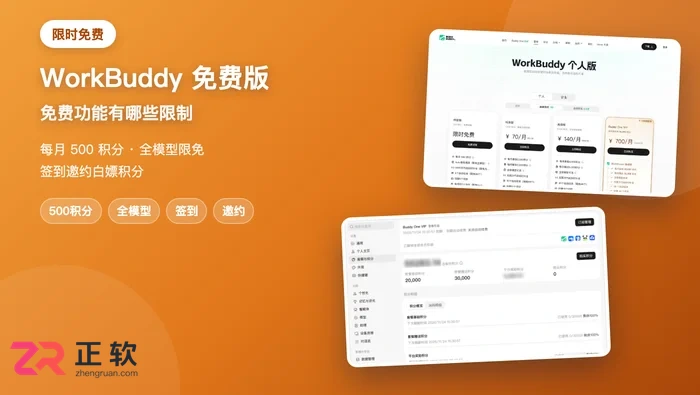
WorkBuddy 免费版能用:体验版限时免费,每月 500 积分,限免期间享全模型调度、无限代码补全、99 个自动任务额度、每项目 5 人协作,另有 3 个自动任务、5 个项目、5GB 资料库、10 个云服务应用的数量限制。本文含官网定价页截图、积分消耗规律和免费补积分方法。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



